En bref : les données « on-chain » sont stockées directement sur la blockchain, ce qui les rend permanentes, transparentes et vérifiables par tout le monde. Les données « off-chain » sont stockées en dehors de la blockchain, généralement sur des serveurs traditionnels, des réseaux de stockage décentralisés tels que IPFS, ou dans des bases de données privées. La plupart des applications concrètes combinent ces deux approches : elles conservent les informations critiques sur la blockchain tout en stockant les données plus volumineuses ou moins essentielles hors de la blockchain, afin de réduire les coûts et d’améliorer les performances.
L'explication simple
Chaque blockchain dispose d'un espace limité. Stocker des données sur la blockchain implique de les inscrire dans une transaction ou dans l'état d'un contrat intelligent, qui sont ensuite enregistrés de manière permanente sur tous les nœuds du réseau. Cela rend les données inviolables et accessibles à tous, mais cela a un coût. Sur Ethereum, le stockage de seulement 32 octets de données peut coûter plusieurs dollars, en fonction du prix du « gas ». Stocker une image ou un document entier sur la blockchain reviendrait à un coût prohibitif.
C’est là qu’interviennent les données hors chaîne. Au lieu de stocker une image complète sur la blockchain, un développeur peut stocker l’image sur IPFS (un réseau décentralisé de stockage de fichiers), puis ne stocker sur la chaîne que le hachage du contenu IPFS . L’enregistrement sur la blockchain atteste de ce que devraient être les données, tandis que le stockage hors chaîne les conserve effectivement. Cette approche hybride vous offre la vérifiabilité de la blockchain et l’évolutivité des systèmes de stockage traditionnels ou décentralisés.
Considérez cela comme un acte de propriété. L'acte lui-même (un petit document essentiel attestant de la propriété) est enregistré au greffe du comté. Mais la maison proprement dite, les plans, les rapports d'inspection et les photos se trouvent tous ailleurs. L'acte renvoie à la propriété. La blockchain fonctionne de la même manière : elle stocke les preuves essentielles et les références, tandis que les ensembles de données plus volumineux sont stockés hors chaîne.
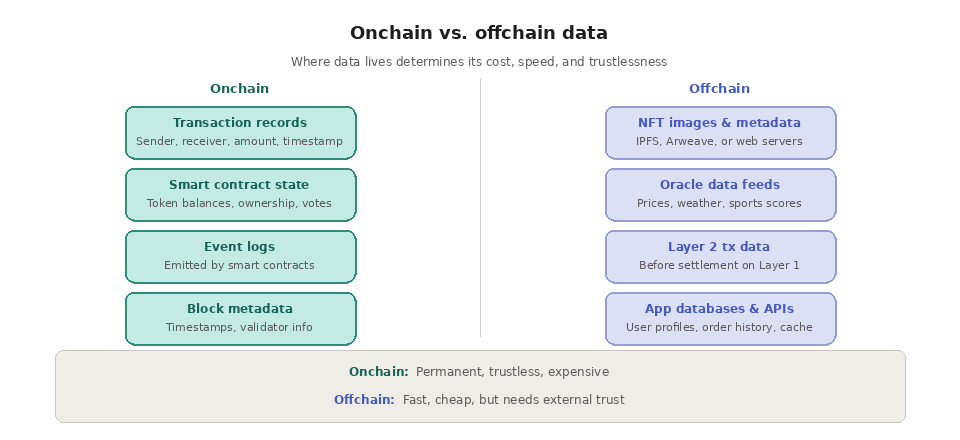
Qu'est-ce qui est considéré comme des données « on-chain » ?
Les données « on-chain » englobent tout ce qui est enregistré de manière permanente dans l'état de la blockchain ou dans l'historique des transactions. Cela comprend les enregistrements de transactions (expéditeur, destinataire, montant, horodatage), le code des contrats intelligents et leurs variables d'état (soldes des jetons, registres de propriété, votes de gouvernance), les journaux d'événements générés par les contrats intelligents, ainsi que les métadonnées des blocs, telles que les horodatages et les informations relatives aux validateurs.
Lorsqu'un utilisateur échange des jetons sur une bourse décentralisée, l'intégralité de la transaction, y compris les montants, les adresses concernées et les modifications d'état qui en découlent, est enregistrée sur la blockchain. Lorsqu'un NFT est créé, l'identifiant du jeton, l'adresse du propriétaire et l'URI des métadonnées sont tous stockés dans l'état sur la blockchain du contrat intelligent. Une fois confirmées, ces données sont « immutable », ce qui signifie que personne ne peut les modifier rétroactivement.
Ce sont les données sur la chaîne qui confèrent à la blockchain sa principale valeur ajoutée : la vérification sans tiers de confiance. Toute personne exploitant un nœud ou interrogeant une interface RPC ( endpoint ) peut vérifier de manière indépendante n’importe quelle donnée sur la chaîne sans avoir à faire appel à un tiers. Il s’agit de la seule source de vérité pour le réseau.
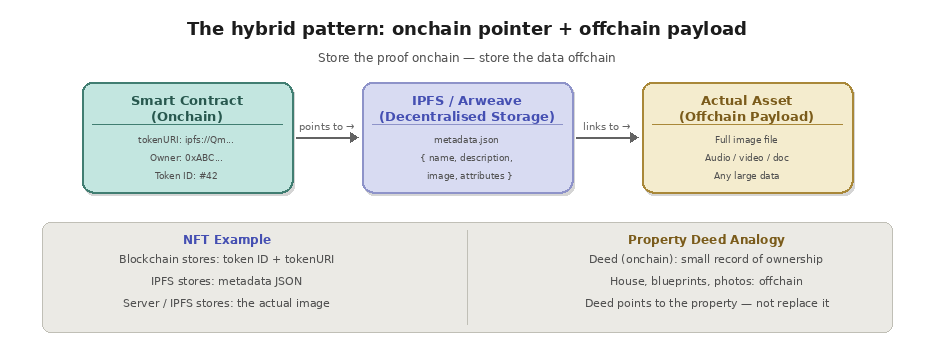
Qu'est-ce qui est considéré comme des données hors chaîne ?
Les données hors chaîne désignent tout ce qui existe en dehors de la blockchain mais qui est référencé par une activité sur la chaîne ou qui s'y rapporte. Cela inclut les images NFT et les fichiers de métadonnées stockés sur des serveurs « IPFS s » ou centralisés, les grands ensembles de données utilisés par les dapps (profils utilisateur, historiques de commandes, analyses), les flux de données « oracle » qui intègrent des informations du monde réel (prix, météo, résultats sportifs) dans la blockchain, les données de transaction de la couche 2 avant leur regroupement et leur règlement sur la couche 1, ainsi que les interfaces utilisateur et les API qui interagissent avec les contrats intelligents.
La méthode la plus courante consiste à stocker sur la blockchain un hachage de contenu ou une URI renvoyant vers des données hors chaîne. Par exemple, la plupart des contrats intelligents NFT stockent une URI de jeton qui renvoie vers un fichier de métadonnées au format JSON hébergé sur IPFS ou sur un serveur web. Ce fichier JSON contient l'URL de l'image, sa description et ses attributs. La blockchain connaît ce pointeur. Le système hors chaîne contient la charge utile.
Les oracles tels que Chainlink constituent un pont essentiel entre les mondes « on-chain » et « off-chain ». Les contrats intelligents ne peuvent pas accéder nativement à des données externes. Ils ne peuvent pas consulter le cours d'une action, vérifier un événement météorologique ou confirmer une expédition dans le monde réel. Les oracles récupèrent ces données « off-chain » et les transmettent « on-chain » de manière vérifiable, permettant ainsi aux contrats intelligents de réagir aux événements du monde réel.
Les compromis
Le choix entre le stockage « on-chain » et « off-chain » dépend des critères de coût, de rapidité, de permanence et de confiance. Le stockage « on-chain » est coûteux, mais permanent et ne nécessite aucune confiance. Le stockage hors chaîne est bon marché et rapide, mais implique une dépendance vis-à-vis de systèmes externes. Si l’image d’un NFT est stockée sur un serveur centralisé et que ce serveur tombe en panne, le NFT existe toujours sur la chaîne, mais l’œuvre d’art qu’il représente devient inaccessible. Si l’image se trouve sur IPFS et que personne ne la « pinne », la même chose peut se produire.
Les protocoles de stockage décentralisés tels qu’ IPFS et Arweave visent à résoudre ce problème en répartissant les fichiers sur un réseau de nœuds plutôt qu’en s’appuyant sur un seul serveur. IPFS utilise un stockage à adressage par contenu, ce qui signifie que les fichiers sont référencés par leur hachage cryptographique plutôt que par l’emplacement d’un serveur. Tant qu’au moins un nœud du réseau « épingle » le fichier, celui-ci reste accessible. Arweave va encore plus loin en encourageant le stockage permanent grâce à un modèle de paiement unique.
Pour les développeurs qui créent des applications de production, l'architecture consiste généralement à conserver sur la chaîne tous les états critiques sur le plan financier (soldes, propriété, autorisations), à stocker les actifs volumineux sur des solutions de stockage décentralisées telles que IPFS, à mettre en cache les données fréquemment consultées dans des bases de données hors chaîne pour optimiser les performances, et à utiliser des indexeurs et des pipelines de données pour permettre l'interrogation des données sur la chaîne.
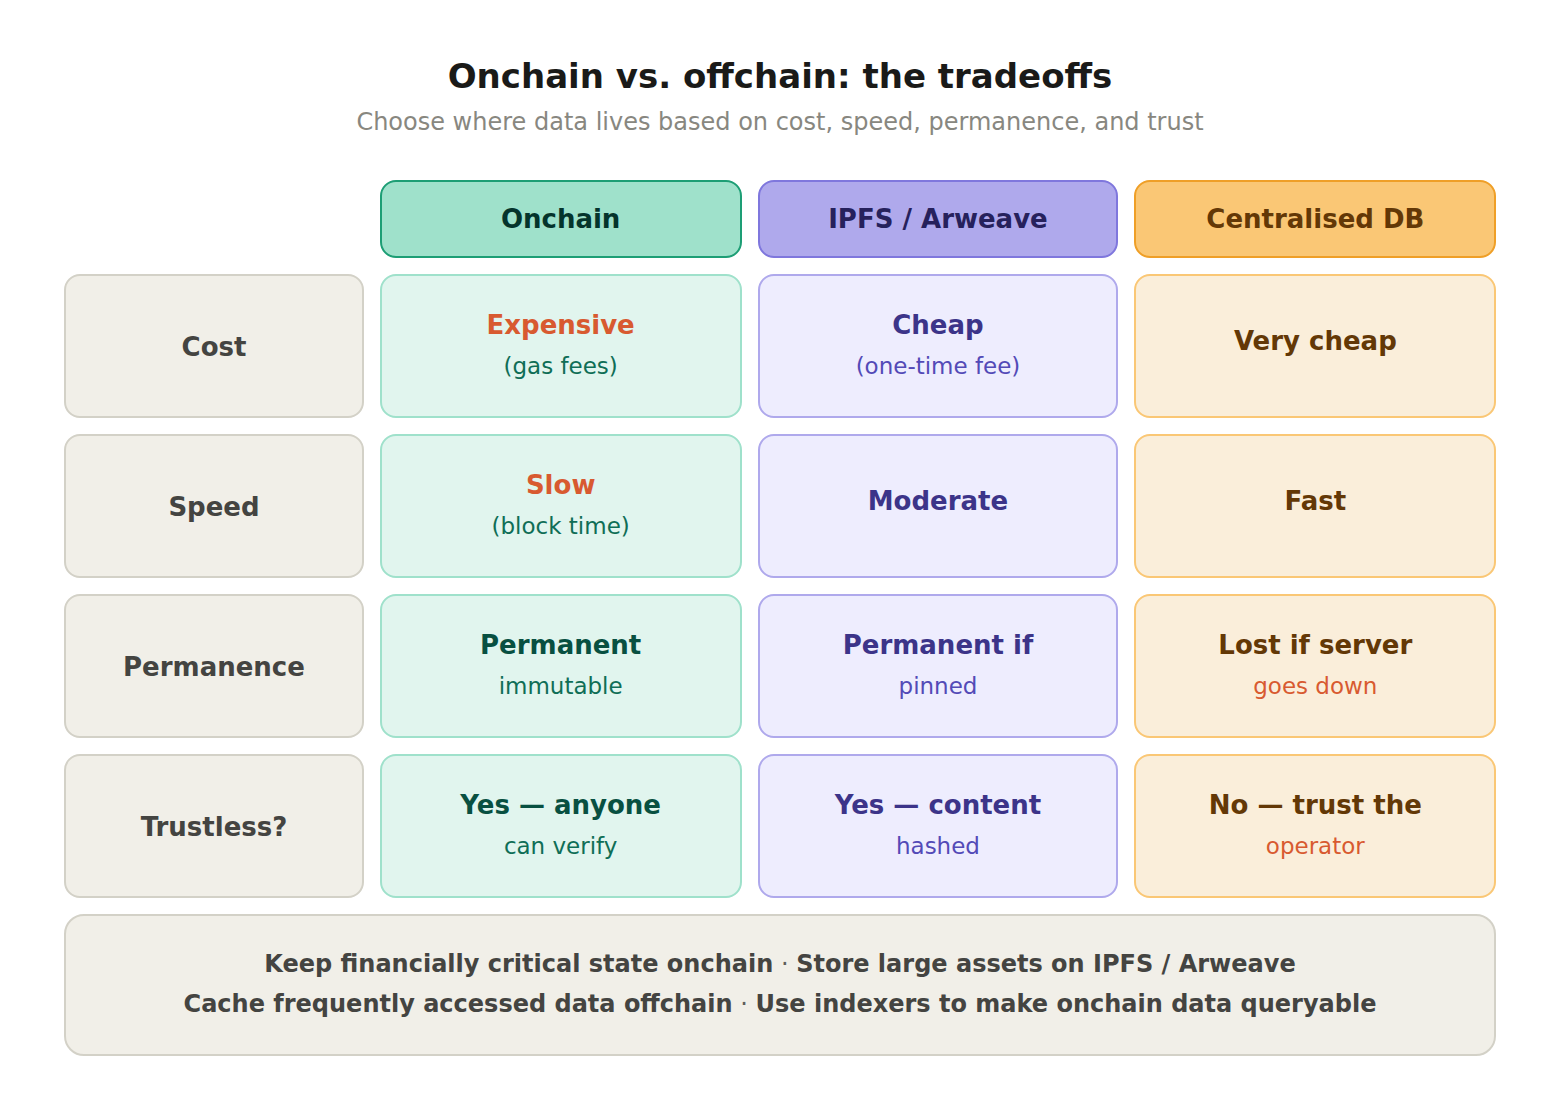
Quelle est la différence entre les données « on-chain » et « off-chain » ?
Les données « on-chain » et « off-chain » se distinguent par leur emplacement de stockage et les garanties qu'elles offrent. Les données « on-chain » sont inscrites dans le registre d'une blockchain et validées par chaque nœud, tandis que les données « off-chain » sont stockées dans des systèmes externes auxquels la chaîne se contente de faire référence. Le tableau ci-dessous les compare selon les caractéristiques les plus importantes.
Attribut | Données sur la chaîne | Données hors chaîne |
|---|---|---|
Lieu | Stockées dans des blocs et dans l'état du contrat | Serveurs, IPFS ou bases de données |
Coût | Élevé, payé en essence par octet | Tarifs de stockage bas et standard |
Vitesse | Limité par la durée des blocs | Lectures et écritures instantanées, rapides et « near » |
Quand faut-il stocker les données sur la blockchain et quand hors chaîne ?
La règle générale est simple : conservez sur la chaîne tout ce qui doit être « trustless », définitif et vérifiable publiquement, et transférez tout le reste hors chaîne afin de réduire les coûts et de gagner en rapidité. Le tableau ci-dessous met en correspondance les types de données courants avec la couche de stockage qui leur convient le mieux.
Type de données | Lieu recommandé | Pourquoi ? |
|---|---|---|
Soldes et propriété des jetons | Sur la chaîne | Doit être « trustless » et définitif |
Logique des contrats intelligents | Sur la chaîne | L'exécution doit pouvoir être vérifiée |
Fichiers multimédias NFT et métadonnées | Offchain (IPFS) | Trop volumineux et trop coûteux pour être stocké sur la blockchain |
La logique qui assure le respect de ces règles est intégrée dans des contrats intelligents, et la partie hors chaîne repose généralement sur l'indexation de la blockchain pour transformer les événements bruts de la chaîne en enregistrements rapides et consultables. Si vous cherchez à déterminer comment lire l'état à grande échelle, découvrez comment les équipes abordent l'interrogation des données de la blockchain.
Les transactions de couche 2 et les transactions « rollup » s'effectuent-elles sur la chaîne ou hors chaîne ?
Les transactions de couche 2 commencent hors chaîne et passent sur la chaîne une fois qu’elles sont finalisées. Une blockchain de couche 2 exécute les transactions sur une couche distincte pour gagner en rapidité, puis un « rollup » regroupe un grand nombre d’entre elles et renvoie les données compressées ainsi qu’une preuve vers la couche 1. L’exécution se fait donc hors chaîne, mais les données finales et la sécurité reposent sur la chaîne. Les deux principaux modèles, les « rollups » optimistes et les « rollups ZK », diffèrent dans la manière dont ils prouvent la validité du travail hors chaîne regroupé.
Comment les oracles relient-ils les données hors chaîne à la blockchain ?
Les contrats intelligents ne peuvent pas accéder à Internet de manière autonome ; ils s'appuient donc sur des oracles pour intégrer des informations hors chaîne dans la chaîne. Un réseau d’oracles récupère des données externes, telles que les cours des actifs ou les résultats d’événements, parvient à un accord sur la valeur, puis l’inscrit dans un contrat que d’autres contrats peuvent lire. C’est ainsi qu’un protocole DeFi peut réagir à un cours du marché ou qu’un contrat d’assurance peut répondre à un événement du monde réel, tout en conservant sur la chaîne la valeur finale sur laquelle l’action est fondée, et en la rendant vérifiable.
Foire aux questions
Les données hors chaîne sont-elles sécurisées ?
C'est possible, mais les garanties ne sont pas les mêmes. Les données hors chaîne héritent de la sécurité de l'endroit où elles sont stockées ; ainsi, un serveur centralisé constitue un point de défaillance unique, tandis que les réseaux à adressage par contenu, tels que IPFS ou Arweave, répartissent les copies sur de nombreux nœuds. Le stockage sur la chaîne d'un hachage cryptographique des données hors chaîne permet à quiconque de vérifier que la charge utile hors chaîne n'a pas été altérée.
Que devient un NFT si son image hors chaîne n'est plus accessible ?
Le token lui-même existe toujours sur la blockchain, mais l'œuvre d'art à laquelle il renvoie peut devenir inaccessible si l'hébergeur disparaît et que personne ne « fixe » le fichier. C'est pourquoi les projets sérieux stockent les médias NFT sur IPFS ou Arweave et conservent le hachage du contenu sur la blockchain plutôt qu'une URL web fragile.
Les contrats intelligents peuvent-ils lire directement des données hors chaîne ?
Non. Les contrats intelligents sont déterministes et isolés du monde extérieur ; ils ne peuvent donc pas effectuer d'appels réseau. Ils dépendent d'oracles pour que les données hors chaîne soient transmises sur la chaîne sous une forme vérifiable avant de pouvoir les utiliser.
IPFS , est-ce que ça se passe sur la chaîne ou hors chaîne ?
IPFS est hors chaîne. Il s'agit d'un réseau de stockage décentralisé qui héberge des fichiers en dehors de la blockchain, tandis que celle-ci ne stocke généralement que le hachage du contenu IPFS qui renvoie vers ces fichiers.
Comment accéder aux données historiques de la blockchain ?
L'état actuel est facile à consulter depuis n'importe quel nœud, mais l'historique complet nécessite souvent des nœuds d'archivage ou un pipeline de réintégration. Consultez la section « Accès aux données historiques de la blockchain » pour découvrir les approches courantes et leurs avantages et inconvénients.
Le rôle d'Quicknode
Travailler à la fois avec des données sur la chaîne et hors chaîne nécessite une infrastructure fiable. L'API Core de Quicknode vous offre un accès RPC à faible latence à plus de 80 chaînes pour lire et écrire des données sur la chaîne. Quicknode Streams QuicknodeElle vous permet de capturer des événements de blockchain en temps réel et de les acheminer vers des destinations hors chaîne telles que webhooks, des bases de données PostgreSQL ou des compartiments S3, facilitant ainsi la création de pipelines de données qui font le lien entre les mondes on-chain et off-chain. Pour le stockage décentralisé, le IPFS et ses passerelles dédiées vous permettent de stocker et de récupérer du contenu hors chaîne sans avoir à gérer vos propres nœuds IPFS .
Pour en savoir plus
Comment stocker des données avec IPFS sur Ethereum - Quicknode Guide
IPFS Passerelles et « pinning » - Quicknode
Premiers pas avec Streams - Quicknode Docs
Présentation des produits Quicknode
