Réponses>En savoir plus sur l'indexation et les données de la blockchain>Pourquoi il est difficile d'interroger les données de la blockchain
Pourquoi il est difficile d'interroger les données de la blockchain
// Tags
les défis liés aux données de la blockchain
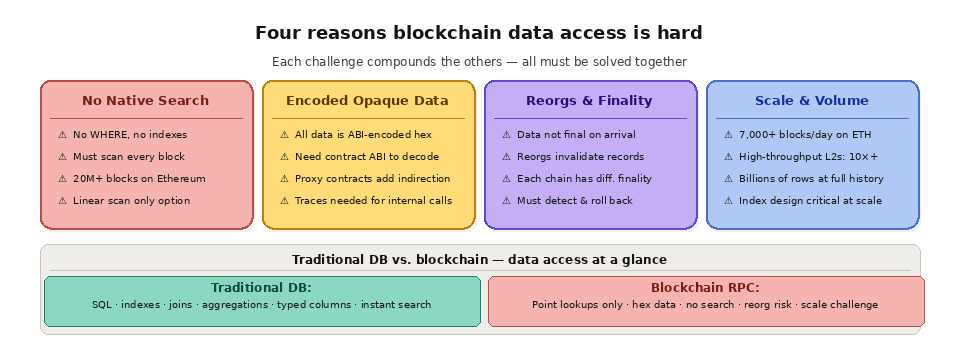
En bref : les blockchains sont optimisées pour la sécurité et l’immuabilité, et non pour la récupération de données. Elles ne disposent d’aucune fonction de recherche intégrée, d’aucune requête SQL, d’aucun index, ni d’aucun moyen de filtrer ou d’agréger des données entre les blocs à l’aide de méthodes RPC standard. Même une requête simple telle que « afficher tous les transferts depuis ce portefeuille » nécessite de parcourir séquentiellement des millions de blocs. Si l’on ajoute à cela les réorganisations de la chaîne, les différents modèles de finalité, les formats de données encodés et les volumes de données colossaux, on comprend aisément pourquoi l’accès aux données de la blockchain représente un défi technique majeur.
L'explication simple
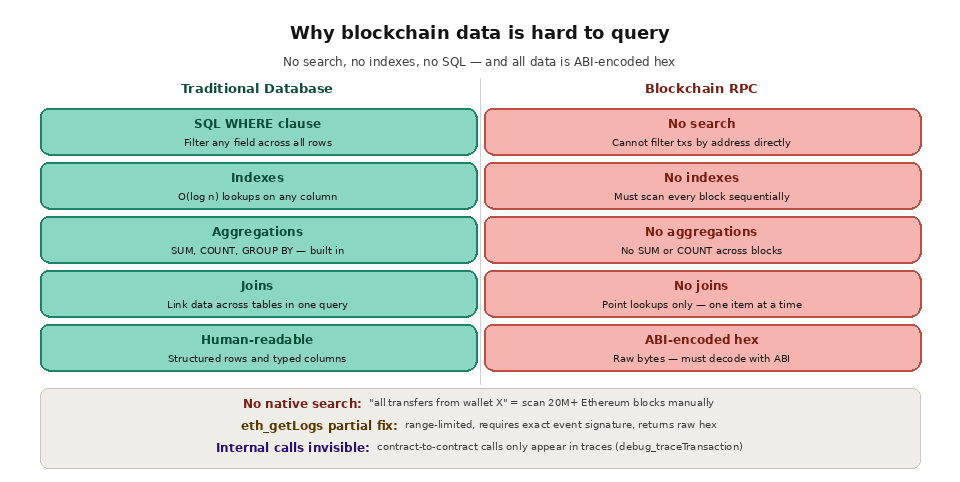
Si vous avez déjà utilisé une base de données traditionnelle, vous savez à quel point il est facile de poser des questions sur vos données. Une seule requête SQL peut renvoyer toutes les commandes des 30 derniers jours, regroupées par client, triées par montant total et filtrées pour n'inclure que les montants supérieurs à 100 $. Le moteur de base de données se charge du gros du travail, car les bases de données relationnelles sont conçues dès le départ pour permettre des requêtes flexibles et efficaces. Elles gèrent des index, prennent en charge les jointures, permettent les agrégations et optimisent automatiquement les plans d'exécution des requêtes.
Les blockchains sont conçues dans un but tout à fait opposé. Leur fonction première est d’enregistrer des transactions dans un registre décentralisé et inviolable, que des milliers de nœuds indépendants peuvent vérifier et valider. Chaque choix de conception dans l’architecture d’une blockchain privilégie le consensus, la sécurité et l’immuabilité. La récupération des données est, au mieux, une considération secondaire. Il en résulte une structure de données incroyablement puissante pour l’usage auquel elle est destinée, mais frustrante à interroger pour toute requête allant au-delà de simples recherches ponctuelles.
Pas de fonction de recherche ni de filtrage intégrée
Le principal défi réside dans le fait que les blockchains ne disposent d’aucune fonctionnalité de recherche. Il n’existe pas de commande « find ». Il n’y a pas d’équivalent à la clause WHERE du langage SQL. L’interface RPC propose quelques méthodes de bas niveau : récupérer un bloc par numéro, récupérer une transaction par hachage, récupérer le solde d’un compte à un bloc spécifique. Il s’agit dans tous les cas de recherches ponctuelles pour lesquelles il faut déjà savoir exactement ce que l’on cherche.
Si vous souhaitez retrouver toutes les transactions associées à une adresse de portefeuille spécifique, vous ne pouvez pas poser cette question directement à la blockchain. Vous devez commencer par le bloc de genèse, récupérer chaque bloc dans l’ordre, extraire toutes les transactions de chaque bloc, vérifier les champs « de » et « à » de chaque transaction, puis rassembler les correspondances. Sur Ethereum, cela implique de parcourir plus de 20 millions de blocs, chacun contenant entre zéro et plusieurs centaines de transactions. Sur Solana, les chiffres sont encore plus vertigineux, avec des milliards d’emplacements et de transactions dans l’historique de la chaîne. Sans index pré-construit, ce balayage linéaire est le seul moyen de répondre à la question.
La méthode « eth_getLogs » apporte une solution partielle en vous permettant d’interroger les journaux d’événements dans une plage de blocs filtrée par adresse de contrat et par sujet. Cependant, elle impose des limites strictes quant à la plage de blocs (généralement quelques milliers de blocs par requête), nécessite de connaître la signature exacte de l’événement recherché et renvoie des données brutes encodées en ABI que votre application doit décoder. Pour obtenir une vue d’ensemble complète de l’activité sur plusieurs contrats, types d’événements et longues périodes, il faut assembler dans le code de votre application des centaines, voire des milliers de requêtes de journaux paginées.
Formats de données codés et opaques
Par défaut, les données de la blockchain ne sont pas lisibles par l'utilisateur. Les données d'entrée des transactions, les paramètres du journal des événements et les valeurs stockées dans les contrats sont encodées selon l'ABI sous forme de chaînes d'octets en base hexadécimale. Pour comprendre une transaction, votre application a besoin de l'ABI du contrat afin de décoder l'appel de fonction et ses paramètres. Pour interpréter un journal d'événements, vous avez besoin de l'ABI pour associer les hachages des sujets à leurs noms respectifs et décoder les champs de données en valeurs typées.
Pour compliquer encore davantage les choses, tous les contrats ne publient pas leur ABI. Les contrats non vérifiés sur les explorateurs de blockchain ne fournissent aucune information de décodage, ce qui rend leurs transactions et leurs événements opaques pour les observateurs externes. Même avec une ABI vérifiée, les contrats proxy (qui délèguent les appels à des contrats d’implémentation) exigent que votre application résolve la relation de proxy avant de pouvoir décoder les appels de fonction sous-jacents. Ces couches d’indirection rendent le traitement automatisé et à large spectre des données de blockchain nettement plus complexe que l’utilisation d’une API REST bien documentée.
Les transactions internes ajoutent une couche supplémentaire d’opacité. Lorsqu’un contrat intelligent en appelle un autre, cet appel interne n’apparaît pas dans la liste des transactions du bloc. Il n’apparaît que dans les traces d’exécution (accessibles via les méthodes `debug_traceTransaction` ou `trace_block`), dont la génération est coûteuse en termes de calcul et qui ne sont pas disponibles sur tous les types de nœuds. Un simple échange de jetons sur un DEX peut impliquer une douzaine d’appels internes entre contrats, chacun transférant des jetons, mettant à jour l’état et émettant des événements. Pour obtenir une vue d’ensemble complète de ce qui s’est passé, il faut disposer de données de trace, ce qui augmente considérablement le volume de données et la complexité du traitement.
Réorganisations de la chaîne et finalité
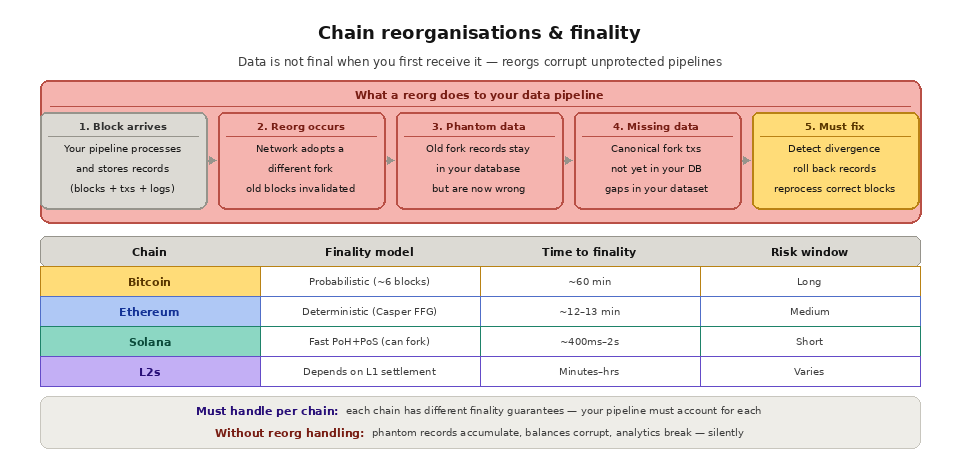
Les données de la blockchain ne sont pas toujours définitives au moment où vous les recevez. Des réorganisations de la chaîne (ou « reorgs ») se produisent lorsque le réseau suit temporairement une branche de la chaîne, puis bascule vers une autre branche qui devient canonique. Lorsqu’une réorganisation se produit, les blocs que votre application a déjà traités deviennent invalides. Les transactions qui semblaient confirmées peuvent ne plus exister dans la chaîne canonique, ou apparaître dans un bloc différent, à une position différente.
Pour les pipelines de données et les indexeurs, les réorganisations sont un véritable cauchemar. Tous les enregistrements issus de blocs réorganisés doivent être détectés, annulés et remplacés par les données provenant des blocs corrects. Si votre système ne gère pas les réorganisations, votre base de données accumulera des enregistrements fantômes (données issues de branches abandonnées) et passera à côté d'enregistrements légitimes (données issues de la branche canonique), ce qui entraînera des soldes erronés, des transferts en double et des analyses corrompues.
Les différentes chaînes présentent des caractéristiques de finalité variées, ce qui complique encore davantage le problème. Bitcoin Les transactions sont considérées comme définitivement validées de manière probabiliste après environ six confirmations (soit environ 60 minutes). Ethereum La finalité est atteinte après deux époques (environ 12 à 13 minutes). Les chaînes de couche 2 telles que Arbitrum et Base disposent de leurs propres mécanismes de finalité, qui dépendent du moment où les données sont transmises à la chaîne de couche 1 Ethereum . Solana Permet une finalité rapide, mais peut néanmoins être confrontée à des sauts de slot et à la résolution de fourches. Votre pipeline de données doit tenir compte du modèle de finalité spécifique de chaque chaîne qu’il traite.
Évolutivité et performances
Le volume des données de la blockchain est colossal et ne cesse de croître. Ethereum génère environ 7 000 blocs par jour, chacun contenant des centaines de transactions et des milliers d'enregistrements d'événements. Les chaînes à haut débit telles que Solana, Base et Arbitrum produisent des données dont le volume est supérieur de plusieurs ordres de grandeur. L'acquisition, le décodage et le stockage de toutes ces données en temps réel, tout en conservant un index historique complet, nécessitent d'importantes ressources de calcul et de stockage.
Les performances se dégradent de manière subtile à mesure que l'échelle augmente. Les tables de base de données comportant des milliards de lignes nécessitent une conception minutieuse des index, des stratégies de partitionnement et une optimisation des requêtes pour maintenir des temps de réponse acceptables. Les écritures simultanées issues de l'ingestion en temps réel entrent en concurrence avec les lectures provenant des requêtes des utilisateurs. Les coûts de stockage s'accumulent à mesure que l'on ajoute davantage de chaînes, davantage d'ensembles de données (traces, journaux, différences d'état) et davantage de profondeur historique. Ce qui commence comme un pipeline de données gérable à 100 blocs par jour devient un défi infrastructurel à 100 000 blocs par jour répartis sur 10 chaînes.
Quels sont les principaux moyens d'interroger les données de la blockchain ?
Il n'existe pas d'outil unique permettant de consulter les données de la blockchain. Les équipes choisissent parmi plusieurs approches selon qu'elles ont besoin d'une recherche rapide d'une donnée ponctuelle, d'un flux en temps réel ou d'analyses historiques approfondies. Le tableau ci-dessous résume les méthodes couramment utilisées.
Approche
Comment ça marche ?
Idéal pour
Appels RPC directs
Récupérer un bloc, une transaction ou un solde à l'aide d'une clé
Recherches ponctuelles et état en temps réel
Journaux d'événements (eth_getLogs)
Filtrer les journaux par adresse et par sujet dans une plage d'adresses
Suivi d'événements spécifiques liés aux contrats
Indexeurs
Décoder et stocker les données de la blockchain dans une base de données consultable
Recherche, jointures et agrégation
Pipelines de streaming
Transférez les données récentes et historiques vers votre propre boutique
Ingestion continue à grande échelle
Plateformes SQL et d'analyse
Interroger des tables pré-indexées à l'aide de requêtes SQL standard
Tableaux de bord et analyses ad hoc
La plupart des stacks s de production combinent plusieurs de ces éléments. Elles utilisent des requêtes RPC pour les lectures en temps réel et une couche distincte d'indexation ou de streaming pour tout ce qui nécessite une recherche ou un historique. Pour comprendre le fonctionnement de la couche la plus basse, découvrez ce que fait réellement une endpoint RPC.
Pourquoi ne peut-on pas utiliser directement SQL sur une blockchain ?
Une blockchain stocke les données sous la forme d’une séquence de blocs liés cryptographiquement, et non sous forme de tables indexées ; il n’y a donc pas de planificateur de requêtes, pas de clause WHERE, et aucun moyen de demander « tous les swaps supérieurs à 1 000 $ de la semaine dernière » en une seule requête. Pour atteindre ce niveau d’accès, il faut d’abord extraire et décoder les données brutes, puis les charger dans un système prenant en charge les requêtes structurées. Ces étapes d’extraction, de décodage et de chargement correspondent exactement à ce que réalise l’indexation de la blockchain.
Faut-il utiliser un nœud RPC ou un indexeur pour interroger les données ?
Les nœuds RPC et les indexeurs répondent à des besoins différents. Un nœud RPC est idéal pour les requêtes directes et l'envoi de transactions, tandis qu'un indexeur est conçu pour la recherche, le filtrage et l'agrégation, des opérations que les nœuds « bruts » ne peuvent pas effectuer. La comparaison ci-dessous montre à quoi sert chacun d'entre eux.
Facteur
Nœud RPC
Indexeur
Style de requête
Recherches ponctuelles par clé
Recherche et filtres flexibles
Agrégation
Non pris en charge
Intégré
Profondeur historique
Nécessite un nœud d'archivage
Stocké une seule fois, consulté rapidement
Temps nécessaire à la mise en place
Low, appelle un endpoint
Higher : construire ou acheter un gazoduc
Utilisation optimale
État en temps réel et transactions
Analyses et requêtes complexes
Pour une analyse plus détaillée des cas dans lesquels chacune de ces approches s'avère la plus performante, consultez l'article « RPC vs indexation ».
Comment interroger les données historiques de la blockchain ?
L'état récent peut être consulté à partir de n'importe quel nœud complet, mais l'état plus ancien et l'historique complet des transactions nécessitent généralement un nœud d'archivage ou un pipeline de réintégration. La distinction entre les données actuelles et passées détermine l'architecture dans son ensemble ; ce sujet est abordé dans les sections « Données blockchain en temps réel vs données historiques » et « Nœud complet vs nœud d'archivage ». Pour des recherches approfondies ponctuelles, un pipeline d'endpoint d'archivage convient ; pour des analyses répétées, il est bien plus efficace d'indexer l'historique une seule fois.
Foire aux questions
Peut-on interroger une blockchain comme une base de données classique ?
Pas directement. Les méthodes RPC standard ne prennent en charge que les recherches ponctuelles par numéro de bloc, hachage de transaction ou adresse. Pour effectuer des requêtes de type base de données avec filtrage et agrégation, vous devez d'abord indexer les données dans un système qui prend en charge ces fonctionnalités.
Quel est le moyen le plus rapide d'obtenir toutes les transactions d'un portefeuille ?
Utilisez un indexeur ou une API de données prête à l'emploi. Parcourir la chaîne bloc par bloc à l'aide d'appels RPC bruts est trop lent pour cela, alors qu'un ensemble de données indexé permet d'obtenir l'historique complet d'un portefeuille en une seule requête.
Pourquoi les données de blockchain décodées nécessitent-elles une ABI ?
Les entrées de transaction et les journaux d'événements sont stockés sous forme d'hexadécimal codé selon l'ABI. L'ABI du contrat est le schéma qui permet de relier ces octets aux noms de fonctions, aux noms d'événements et aux valeurs typées ; sans lui, les données restent donc opaques.
Quel est l'impact des réorganisations sur les requêtes sur la blockchain ?
Une réorganisation peut invalider les données que vous avez déjà lues ; par conséquent, les résultats des requêtes near situés à l'extrémité de la chaîne ne sont pas définitifs. Les pipelines robustes attendent que ces données soient définitives ou envoient des mises à jour correctives lorsque la chaîne canonique change.
Faut-il faire tourner son propre nœud pour consulter les données de la blockchain ?
Non. Les fournisseurs de RPC gérés, les services de streaming et les plateformes d'analyse vous permettent de consulter et d'interroger les données de la blockchain sans avoir à gérer vous-même de nœuds ou d'indexeurs.
Comment « Quicknode » simplifie l'accès aux données de la blockchain
QuicknodeLa suite de produits de [nom de l'entreprise] est conçue pour répondre directement à chacun de ces défis. L'API Core offre un accès RPC rapide et fiable pour la recherche de points et la soumission de transactions, grâce à des méthodes API améliorées qui regroupent les requêtes courantes en plusieurs étapes en un seul appel. L'accès aux archives est inclus dans toutes les formules ; ainsi, les requêtes d'état historique fonctionnent sans infrastructure distincte ni coût supplémentaire.
Quicknode Streams élimine complètement les difficultés liées à l’ingestion de données. Au lieu de créer et de maintenir des scripts personnalisés qui interrogent les points de terminaison RPC, gèrent la pagination, gèrent les tentatives de connexion et détectent les réorganisations, vous configurez un flux (Stream) qui transmet exactement les données de la blockchain dont vous avez besoin vers votre base de données ou votre entrepôt de données. « Streams » fournit les données dans l’ordre de finalité avec des garanties « exactly-once », gère automatiquement les réorganisations de la chaîne en envoyant des charges utiles de correction, et prend en charge à la fois le streaming en temps réel et le remplissage historique via le même pipeline. Des filtres basés sur JavaScript s’exécutent sur l’infrastructure d’ Quicknode pour décoder, transformer et structurer les données avant leur transmission, afin que votre destination reçoive des enregistrements propres et structurés, prêts à être interrogés.
Pour les équipes qui souhaitent disposer de données blockchain indexées sans avoir à mettre en place le moindre pipeline, la Marketplace d'Quicknode propose des intégrations avec des protocoles d'indexation et des services de données partenaires qui fournissent des ensembles de données prêts à l'emploi et consultables pour des cas d'utilisation courants.