Tout savoir sur les données blockchain en temps réel et historiques | Quicknode
Rendement de l'USDC avec couverture intégréeQuicknode Earn propose désormais un rendement en USDC avec une couverture intégrée contre les risques liés au protocole, garantie par OpenCover. Six coffres-forts couverts sont disponibles sur Base.
Réponses>En savoir plus sur le streaming de données blockchain>Données blockchain en temps réel vs données historiques
Données de la blockchain en temps réel vs données historiques
// Tags
données de la blockchain en temps réeldonnées historiques de la blockchain
En bref : les données blockchain en temps réel correspondent aux informations issues de la pointe de la chaîne, des blocs les plus récents et des transactions en cours. Les données historiques de la blockchain englobent tout ce qui a précédé, depuis le bloc de genèse jusqu'au passé récent. Les applications ont besoin des deux : les données en temps réel alimentent les tableaux de bord en direct, la surveillance des transactions et les notifications instantanées, tandis que les données historiques servent à l'analyse, à l'audit, au remplissage des bases de données et à l'entraînement des modèles. Le défi en matière d'infrastructure réside dans le fait que l'accès efficace à chaque type de données nécessite des outils différents, et que les meilleures architectures unifient les deux en un seul pipeline.
L'explication simple
Considérez une blockchain comme un registre qui ne cesse de s'allonger. À tout moment, la dernière entrée est enregistrée à l'extrémité du registre. Tout ce qui se trouve en amont fait désormais partie de l'historique. La distinction entre les données en temps réel et les données historiques ne porte pas sur les données elles-mêmes (les blocs restent des blocs, les transactions restent des transactions), mais sur le moment et la manière dont votre application doit y accéder.
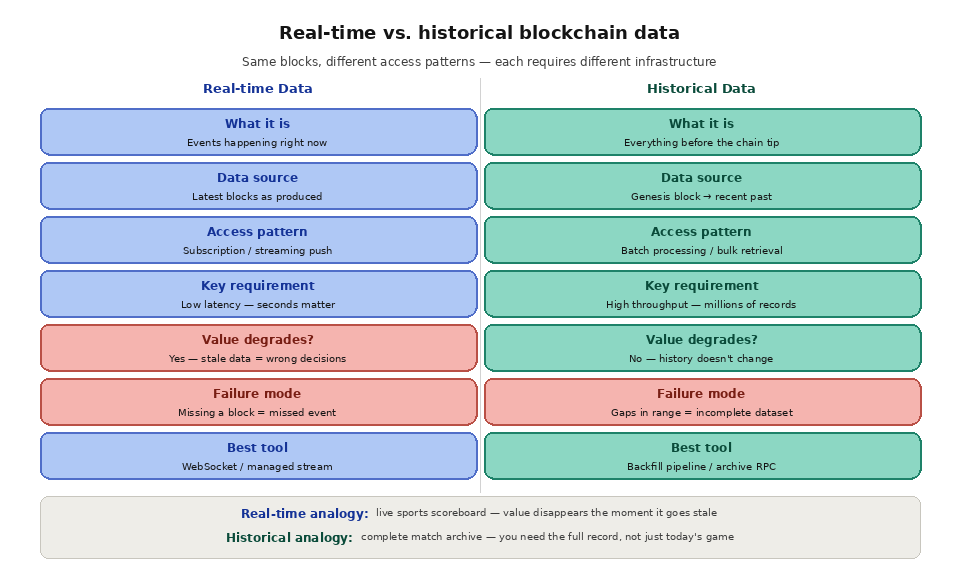
Les données en temps réel correspondent à ce qui se passe actuellement. Un nouveau bloc vient d’être généré. Un transfert de jetons vient d’être effectué. Un événement de contrat intelligent vient de se déclencher. Votre application doit être informée de ces événements le plus rapidement possible, idéalement dans les secondes qui suivent la finalisation du bloc. L’accès aux données en temps réel est sensible à la latence. La valeur de l’information diminue à chaque seconde de retard. Un bot de trading qui prend connaissance d’une variation de prix 30 secondes après qu’elle s’est produite est fortement désavantagé par rapport à un autre qui en est informé en 2 secondes.
Les données historiques correspondent à ce qui s'est déjà produit. Un utilisateur souhaite consulter l'historique complet de ses transactions de l'année écoulée. Une plateforme d'analyse doit calculer le volume total des transactions effectuées sur un DEX depuis son lancement. Un service d'equipe de conformité doit retracer les flux de fonds sur six mois d'activité. L'accès aux données historiques est sensible au débit. Le défi ne réside pas dans la vitesse à laquelle on obtient un enregistrement unique, mais dans l'efficacité avec laquelle on peut récupérer, traiter et stocker des millions, voire des milliards d'enregistrements couvrant des milliers, voire des millions de blocs.
Différents modèles d'accès
Les modes d'accès aux données en temps réel et aux données historiques sont fondamentalement différents, ce qui explique pourquoi ils nécessitent généralement des approches différentes en matière d'infrastructure.
L'accès aux données en temps réel fonctionne selon un modèle d'abonnement. Votre application demande : « prévenez-moi chaque fois qu'un nouveau bloc est produit » ou « prévenez-moi chaque fois que ce contrat émet un événement Transfer ». Les données arrivent sous forme de flux continu, un bloc à la fois, dans l'ordre où la chaîne les produit. Votre application traite chaque bloc dès son arrivée et met à jour son état en conséquence. Les exigences clés sont une faible latence (délai minimal entre la production et la transmission du bloc), la fiabilité (ne jamais manquer un bloc) et l'ordre (les blocs arrivent dans le bon ordre, sans lacunes).
L'accès aux données historiques suit un modèle de traitement par lots. Votre application demande : « Donnez-moi tous les blocs compris entre le numéro 10 000 000 et le numéro 20 000 000 » ou « Récupérez tous les événements de transfert ERC-20 du contrat USDC depuis son déploiement ». Les données arrivent en masse, pouvant représenter des millions d’enregistrements, et votre application les traite par grands lots avant de les charger dans une base de données ou un entrepôt de données. Les exigences clés sont le débit (traiter autant de blocs par seconde que possible), l’exhaustivité (aucun bloc manquant ni lacune) et la rentabilité (réduire au minimum la puissance de calcul et la bande passante nécessaires pour récupérer des téraoctets de données).
Ces différentes exigences expliquent pourquoi une approche unique répond rarement de manière satisfaisante à ces deux besoins. Les abonnements WebSocket fonctionnent pour les données en temps réel, mais ne permettent pas de récupérer les blocs historiques. L'interrogation RPC séquentielle permet techniquement de récupérer des données historiques, mais elle est extrêmement lente et coûteuse à grande échelle. Des pipelines de données spécialement conçus, qui gèrent à la fois le streaming en temps réel et le remplissage historique via la même interface, résolvent ce problème d'incompatibilité architecturale.
Pourquoi les applications ont besoin des deux
Presque toutes les applications blockchain en production nécessitent à la fois des données en temps réel et des données historiques, souvent simultanément. Un tableau de bord DeFi a besoin de données historiques pour afficher des graphiques représentant le cours d’un token au cours des 90 derniers jours, l’évolution de la TVL d’un pool au cours de l’année écoulée et l’historique complet des positions d’un utilisateur. Il a simultanément besoin de données en temps réel pour mettre à jour le cours actuel, afficher les transactions en direct au fur et à mesure qu’elles se produisent et alerter l’utilisateur lorsque sa position s’approche d’un seuil de liquidation. Si le tableau de bord ne disposait que de données en temps réel, il s'afficherait avec un écran vierge à chaque chargement. S'il ne disposait que de données historiques, les chiffres seraient toujours obsolètes.
Un indexeur de blockchain a besoin de données historiques pour constituer sa base de données initiale, en traitant chaque bloc depuis le bloc de genèse (ou depuis le bloc de déploiement du contrat) jusqu'à aujourd'hui. Une fois le « backfill » terminé, il a besoin de données en temps réel pour maintenir la base de données à jour, en traitant chaque nouveau bloc au fur et à mesure de sa production. La transition entre le « backfill » historique et le flux en temps réel doit être transparente, sans aucun écart entre le dernier bloc historique traité et le premier bloc en temps réel reçu. Tout écart entraîne des données manquantes. Tout chevauchement entraîne des données en double.
Une place de marché NFT a besoin de données historiques pour afficher l'historique des propriétaires, les prix de vente antérieurs et la provenance de chaque token. Elle a besoin de données en temps réel pour afficher les nouvelles annonces dès leur création, mettre à jour les prix lorsque des enchères reçoivent des offres et confirmer les transferts une fois les ventes conclues. Les traders s'appuient sur les données historiques pour l'évaluation et sur les données en temps réel pour l'exécution des transactions.
Un système de surveillance de la conformité a besoin de données historiques pour mener des enquêtes rétrospectives lorsqu'une activité suspecte est signalée. Il a besoin de données en temps réel pour détecter les schémas suspects au fur et à mesure qu'ils se produisent et générer des alertes en quelques minutes plutôt qu'en plusieurs jours. Le système doit être capable de basculer d'un mode à l'autre, en diffusant les nouvelles activités en temps réel tout en interrogeant simultanément des mois d'enregistrements historiques pour replacer les événements dans leur contexte.
Le défi architectural
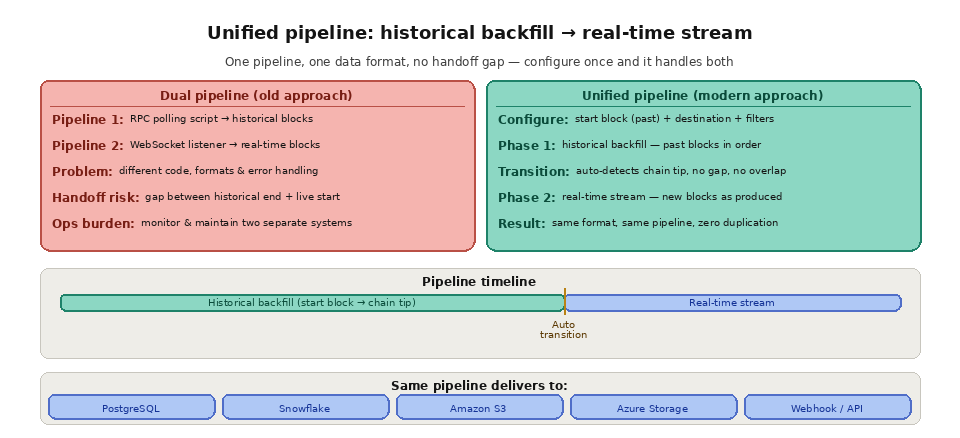
L’approche traditionnelle pour gérer ces deux types de données consiste à mettre en place deux systèmes distincts : un pipeline de réactualisation historique (généralement un script qui parcourt les blocs via RPC) et un écouteur en temps réel (généralement un abonnement WebSocket ou une boucle d’interrogation). Cette architecture à double pipeline engendre plusieurs problèmes. Les deux systèmes utilisent un code différent, une gestion des erreurs différente, des formats de données différents et des mécanismes de diffusion différents. Les maintenir synchronisés lors du passage du mode historique au mode temps réel est source d'erreurs. La maintenance et la surveillance de deux pipelines distincts doublent la charge opérationnelle.
Un pipeline de données unifié, capable de traiter à la fois les données historiques et celles en temps réel via une interface unique, élimine ces problèmes. Il suffit de configurer un seul pipeline avec un bloc de départ (dans le passé pour les données historiques, ou « dernier » pour les données en temps réel uniquement), et le système fournit les données à partir de ce point de départ, en passant de manière transparente du remplissage historique au flux en temps réel dès qu’il rattrape l’extrémité de la chaîne. Même format de données, même mécanisme de diffusion, même gestion des erreurs, même surveillance. Le pipeline ne se soucie pas de savoir si le bloc qu’il traite a été produit il y a trois ans ou il y a trois secondes.
Quelle est la différence entre les données de la blockchain en temps réel et les données historiques ?
Les données sont les mêmes blocs et les mêmes transactions ; ce qui diffère, c'est le moment où vous en avez besoin et la manière dont vous les récupérez. Les données en temps réel sont lues à l'extrémité de la chaîne via un abonnement, elles sont donc optimisées pour une faible latence. Les données historiques sont lues en masse à partir de blocs antérieurs, elles sont donc optimisées pour le débit et le coût. C'est pourquoi, pour interroger efficacement les données de la blockchain, il faut généralement choisir un outil différent pour chaque tâche. Le tableau ci-dessous résume ces différences.
Dimension
Données en temps réel
Données historiques
Définition
L'état actuel de la blockchain et les transactions en cours
Tout, depuis la Genèse jusqu'au passé récent
Modèle d'accès
Abonnement, un bloc à la fois
Par lots, plusieurs blocs à la fois
Sensible à
Latence
Débit et coût
Outil classique
Streams ou les abonnements WebSocket
Remplissages, nœuds d'archivage, indexeurs
Pouvoirs
Tableaux de bord en temps réel, alertes, surveillance
Analyses, audits, apprentissage des modèles
Fraîcheur
Il y a quelques secondes à peine
De quelques minutes à plusieurs années
Comment accéder aux données historiques de la blockchain ?
Il existe trois méthodes courantes pour consulter les données historiques. Vous pouvez interroger un nœud d’archivage, qui conserve l’état complet à chaque hauteur de bloc et répond aux requêtes ponctuelles pour n’importe quel moment de l’historique. Vous pouvez lancer une opération de « backfill », qui parcourt une plage de blocs et exporte les résultats en masse. Vous pouvez également utiliser un indexeur qui a déjà traité et stocké les données dans une base de données consultable. Chacune de ces méthodes présente des compromis différents en termes d’effort de configuration, de vitesse et de coût ; le choix approprié dépend de la quantité d’historique dont vous avez besoin et de la fréquence à laquelle vous en avez besoin. Pour une analyse plus approfondie des options et de leurs compromis, consultez la section « Accéder aux données historiques de la blockchain ».
Quelles applications nécessitent des données en temps réel et lesquelles ont besoin de données historiques ?
La plupart des applications de production ont besoin des deux, mais l'équilibre varie selon le cas d'utilisation. Les fonctionnalités sensibles à la latence privilégient le temps réel, tandis que les fonctionnalités analytiques et d'audit privilégient les données historiques. Le tableau ci-dessous met en correspondance les charges de travail courantes avec leurs besoins principaux en matière de données ; vous trouverez d'autres modèles dans ces cas d'utilisation de la blockchain en streaming.
Cas d'utilisation
Besoin de données primaires
Pourquoi ?
Bot de trading
En temps réel
Réagit aux variations de prix en quelques secondes
Rapport fiscal ou d'audit
Historique
Reconstitue l'historique complet des activités
Indexeur de blockchain
Les deux
Historique des remblais, puis streams nouveaux blocs
Alertes de liquidation
En temps réel
Il faut vendre avant que la position ne soit liquidée
Analyse du volume de la DEX
Historique
Regroupe des millions de transactions passées
Provenance des NFT
Les deux
Affiche l'historique des propriétaires ainsi que les annonces en cours
Comment regrouper les données en temps réel et les données historiques au sein d'un même pipeline ?
L'architecture la plus épurée consiste à configurer un pipeline unique dont le point de départ se situe dans le passé, qui traite les données dans l'ordre, puis passe automatiquement à la diffusion en temps réel une fois qu'il atteint l'extrémité de la chaîne. Cela élimine le transfert fragile entre un script de rattrapage et un écouteur en temps réel distinct. Si vous vous interrogez sur la manière dont les données doivent arriver, le choix entre l'interrogation (polling) et le streaming détermine en grande partie la difficulté à mettre en place ce transfert par vous-même, et un service géré comme Quicknode Streams gère pour vous l’ordre des données, les lacunes et les réorganisations.
Foire aux questions
Les données en temps réel ont-elles plus de valeur que les données historiques ?
Aucune des deux n'a une valeur supérieure en soi ; elles remplissent des fonctions différentes. Les données en temps réel alimentent les fonctionnalités pour lesquelles la fraîcheur est primordiale, comme les alertes et l'exécution des ordres, tandis que les données historiques servent à l'analyse, aux audits et à toute vue nécessitant un contexte historique. La plupart des applications sérieuses s'appuient sur les deux à la fois.
Jusqu'à quand puis-je remonter pour consulter les données historiques de la blockchain ?
Avec l'infrastructure adéquate, vous pouvez remonter jusqu'au bloc de genèse. Pour obtenir l'état complet à n'importe quel moment de l'histoire, il faut un nœud d'archivage plutôt qu'un nœud complet élagué ; c'est pourquoi la distinction entre un nœud complet et un nœud d'archivage est importante lorsque vous prévoyez d'accéder à des données historiques.
Un même pipeline peut-il prendre en charge à la fois les données en temps réel et les données historiques ?
Oui. Un pipeline de streaming unifié peut partir d'un bloc antérieur, remonter dans le temps, puis se poursuivre avec les données en temps réel sans interruption ni recours à un deuxième système. C'est là l'idée centrale qui sous-tend le streaming de données sur la blockchain, qui fournit des données ordonnées, que le bloc soit ancien ou tout récent.
Quel est le moyen le plus rapide de compléter les données historiques ?
Les scripts RPC séquentiels sont simples, mais lents et coûteux à grande échelle. Les outils de « backfill » spécialement conçus, qui exportent en masse des plages de blocs vers une base de données ou un entrepôt de données, sont généralement bien plus rapides et moins coûteux, car ils sont optimisés pour le débit plutôt que pour le traitement d'une requête à la fois.
Ai-je besoin d'un indexeur pour les requêtes historiques ?
Pas toujours. Pour des recherches ponctuelles, un nœud d'archivage ou un « backfill » suffit. Mais si vous effectuez fréquemment des requêtes complexes portant sur de larges plages de données, l'indexation de la blockchain pré-traite les données pour en faire un magasin consultable, ce qui permet à chaque requête d'être traitée rapidement, au lieu d'être recalculée à partir des blocs bruts.
Comment « Quicknode » gère ces deux aspects
Quicknode Streams fournit un pipeline unifié pour les données blockchain en temps réel et historiques. Un seul flux peut être configuré pour démarrer à partir de n'importe quel bloc historique et traiter les données en aval, en les transmettant dans l'ordre de finalité vers votre destination (PostgreSQL, Snowflake, Amazon S3, Azure Storage, webhooks, etc.). Une fois que le flux atteint la pointe de la chaîne, il passe automatiquement à l'mode en temps réel et continue de transmettre les nouveaux blocs au fur et à mesure de leur production. Il n'y a ni interruption, ni logique de transfert, ni deuxième pipeline à gérer.
Pour les requêtes ponctuelles en temps réel, l’API Core de Quicknode offre un accès RPC distribué à l’échelle mondiale avec prise en charge des archives sur tous les forfaits, ce qui signifie que votre application peut interroger l’état actuel de la chaîne ou n’importe quel état historique à n’importe quelle hauteur de bloc via une seule endpoint. Les méthodes API améliorées regroupent les requêtes courantes en plusieurs étapes en un seul appel, réduisant ainsi la latence pour les lectures en temps réel. Pour les remplissages historiques en particulier, Quicknode propose des modèles de remplissage en un clic avec des ensembles de données préconfigurés sur plus de 20 chaînes, des estimations transparentes en termes de coûts et de délais, ainsi que des vitesses de livraison jusqu’à 7 fois plus rapides que les scripts basés sur RPC.