Réponses>En savoir plus sur l'indexation et les données de la blockchain>Qu'est-ce que l'indexation blockchain ?
Qu'est-ce que l'indexation blockchain ?
// Tags
indexation de la blockchainindexeur de blockchain
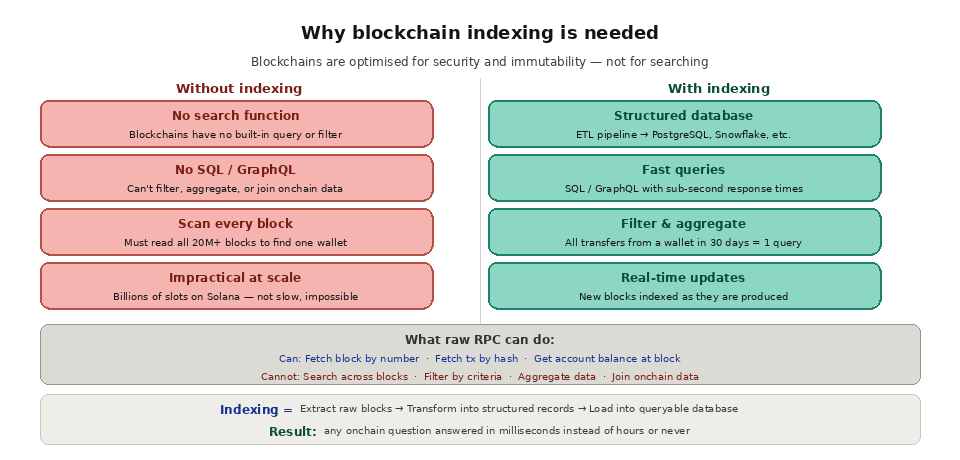
En bref : l’indexation de la blockchain consiste à extraire des données brutes d’une blockchain, à les transformer en un format structuré, puis à les stocker dans une base de données optimisée pour des requêtes rapides. Les blockchains sont conçues pour garantir la sécurité et l’immuabilité, et non pour permettre des recherches. Sans indexation, répondre à des questions même simples telles que « affiche-moi tous les transferts provenant de ce portefeuille » nécessite de parcourir chaque bloc depuis la genèse, ce qui est irréalisable à grande échelle. Les indexeurs résolvent ce problème en créant des bases de données consultables qui rendent les données de la chaîne accessibles aux applications en temps réel.
L'explication simple
Les blockchains sont des registres à ajout seul. Elles excellent dans l'enregistrement des transactions selon un ordre inviolable, mais elles sont très peu efficaces pour répondre à des questions concernant ces transactions. Il n'existe pas de fonction de « recherche » intégrée. Il n'y a pas de requêtes SQL. Il est impossible de demander « trouve tous les transferts ERC-20 impliquant cette adresse au cours des 30 derniers jours » en utilisant uniquement les méthodes RPC standard.
Les outils bruts disponibles via les points de terminaison RPC sont, par conception, rudimentaires. Vous pouvez récupérer un bloc spécifique par son numéro. Vous pouvez récupérer une transaction spécifique par son hachage. Vous pouvez obtenir le solde d’un compte à un bloc spécifique. Mais vous ne pouvez pas effectuer de recherche sur l’ensemble des blocs, filtrer selon des critères, agréger des données ou joindre des informations provenant de différentes parties de la chaîne. Pour trouver toutes les transactions provenant d’un portefeuille spécifique, il faudrait récupérer tous les blocs jamais créés, extraire chaque transaction de chaque bloc, vérifier si l’expéditeur ou le destinataire correspond à l’adresse cible, puis rassembler les correspondances. Sur Ethereum, cela implique de parcourir plus de 20 millions de blocs. Sur Solana, cela implique de parcourir des milliards d’emplacements. Sans indexation, ce n’est pas simplement lent : c’est impossible à réaliser dans un délai raisonnable.
L'indexation de la blockchain résout ce problème grâce à un processus qui lit en continu les nouveaux blocs à partir d'un nœud, décode les données brutes (transactions, journaux d'événements, changements d'état, traces), les transforme en enregistrements structurés, puis écrit ces enregistrements dans une base de données dotée d'index appropriés. Une fois les données stockées dans la base de données, votre application peut les interroger à l'aide d'outils courants tels que SQL ou GraphQL, avec des temps de réponse inférieurs à une seconde.
Comment fonctionne l'indexation ?
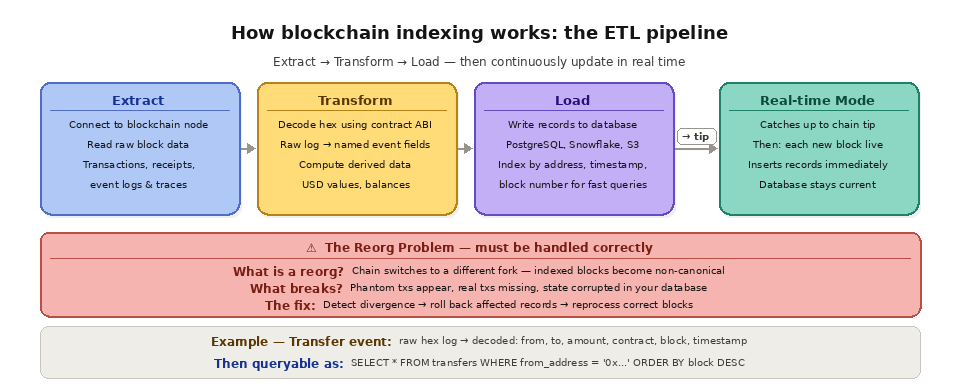
Le pipeline d'indexation suit un modèle « Extract, Transform, Load » (ETL). Au cours de la phase d'extraction, l'indexeur se connecte à un nœud de la blockchain et lit les données brutes des blocs. Celles-ci comprennent les en-têtes de blocs, les transactions, les reçus de transaction (qui contiennent les journaux d'événements) et, éventuellement, les données de traçabilité (qui enregistrent les appels internes entre contrats). L'indexeur traite les blocs de manière séquentielle, en partant d'un bloc de départ configuré et en remontant l'historique de la chaîne.
Au cours de la phase de transformation, l’indexeur décode les données brutes pour leur donner une structure significative. Les journaux d’événements bruts, par exemple, sont encodés sous forme de chaînes hexadécimales comprenant des hachages de sujet et des champs de données. L’indexeur utilise l’ABI (Application Binary Interface) du contrat intelligent pour les décoder en événements lisibles par l’homme, dotés de paramètres nommés et de types de données appropriés. Un journal d’événements de transfert brut devient ainsi un enregistrement structuré comportant une adresse « d’origine », une adresse « de destination », un montant en jetons et une adresse de contrat. La phase de transformation permet également de calculer des données dérivées, comme la valeur en dollars américains au moment du transfert, l’agrégation des volumes par jeton ou le suivi des soldes courants.
Au cours de la phase de chargement, les enregistrements structurés sont écrits dans une base de données, qu’il s’agisse de PostgreSQL, MongoDB, Snowflake, Elasticsearch ou d’un autre système de stockage. La base de données crée des index sur les champs que les applications interrogeront (tels que les adresses de portefeuille, les contrats de jetons, les horodatages et les numéros de blocs), ce qui permet des recherches rapides et des requêtes complexes sur l’ensemble du jeu de données.
Une fois que l'indexeur a rattrapé la pointe de la chaîne, il passe en mode d'mode en temps réel, traitant chaque nouveau bloc au fur et à mesure de sa création et insérant immédiatement les enregistrements correspondants. Cela permet à la base de données de rester à jour par rapport à l'état actuel de la chaîne.
Le problème de la réorganisation
L'un des aspects les plus complexes de l'indexation de la blockchain réside dans la gestion des réorganisations de la chaîne. Une réorganisation se produit lorsque la chaîne canonique de la blockchain change, généralement parce que des blocs concurrents ont été générés à la même hauteur et que le réseau finit par converger vers une bifurcation différente de celle que votre indexeur avait initialement traitée. Lorsque cela se produit, les blocs que votre indexeur a déjà traités ne sont plus canoniques, et tous les enregistrements dérivés de ces blocs sont erronés.
Un indexeur robuste doit détecter les réorganisations, annuler les enregistrements concernés et retraiter les blocs concernés. Si les réorganisations ne sont pas gérées correctement, cela entraîne l'apparition de transactions fantômes dans votre base de données (des transactions présentes dans l'ancienne branche mais pas dans la nouvelle), de transactions manquantes (des transactions présentes dans la nouvelle branche mais absentes de l'ancienne) et un état incorrect. Pour les applications financières, ce type de corruption des données est inacceptable.
La gestion des réorganisations ajoute une complexité considérable au pipeline d'indexation. L'indexeur doit suivre les blocs qui ont été traités, comparer la chaîne qu'il observe avec celle qu'il a déjà stockée, détecter les divergences et exécuter les annulations de manière propre. C'est l'une des principales raisons pour lesquelles les équipes préfèrent les solutions d'indexation gérées plutôt que de développer des indexeurs personnalisés à partir de zéro.
Approches d'indexation
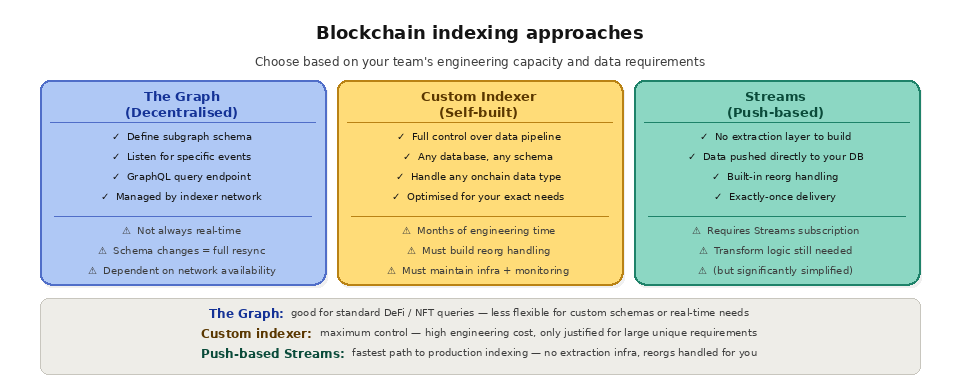
The Graph est le protocole d’indexation décentralisé le plus largement adopté. Les développeurs créent des « sous-graphes », qui sont des fichiers de configuration définissant les contrats intelligents à surveiller, les événements à détecter et la manière de mapper les données d’événements dans un schéma interrogeable. Des opérateurs de nœuds indépendants, appelés « indexeurs », gèrent l’infrastructure de traitement et traitent les requêtes via des points de terminaison GraphQL. The Graph fonctionne bien pour des cas d’utilisation classiques tels que l’interrogation des données des protocoles DeFi, l’historique de propriété des NFT et l’activité de gouvernance des DAO. Ses limites incluent la latence (les mises à jour des sous-graphes ne se font pas toujours en temps réel), le manque de flexibilité du schéma (modifier son schéma nécessite souvent un redéploiement et une resynchronisation) et la dépendance à la disponibilité du réseau décentralisé.
Les indexeurs personnalisés offrent aux équipes un contrôle total sur leur pipeline de données, mais nécessitent un investissement technique important. La mise en place d’un indexeur personnalisé prêt pour la production implique de développer la logique d’ingestion des blocs, le décodage des événements, la conception du schéma de base de données, la gestion des réorganisations, la récupération en cas d’erreur, la surveillance et la mise à l’échelle de l’infrastructure. Pour les applications à grande échelle présentant des exigences spécifiques en matière de données, cet investissement peut s’avérer rentable, mais pour la plupart des équipes, il représente plusieurs mois de travail d’ingénierie qui pourraient être consacrés à leur produit principal.
Le streaming « push » constitue une approche plus récente qui simplifie l'indexation en transmettant directement à votre système de stockage des données filtrées issues de la blockchain, ce qui vous évite d'avoir à créer et à gérer vous-même la couche d'extraction. Au lieu que votre indexeur récupère les données depuis un nœud, un service de streaming transmet exactement les données dont vous avez besoin vers votre base de données, votre webhook ou votre entrepôt de données.
Comment « Quicknode » optimise l'indexation de la blockchain
Quicknode Streams est spécialement conçu pour l'indexation des données de blockchain. Streams propose un pipeline de données de type « push » qui achemine des données de blockchain brutes ou filtrées directement vers la destination de votre choix, notamment PostgreSQL, Snowflake, Amazon S3, Azure Storage et webhooks. Au lieu de mettre en place et de gérer une infrastructure de sondage RPC pour extraire les données de la chaîne, il vous suffit de configurer un « Stream » en indiquant le réseau souhaité, l'ensemble de données (blocs, transactions, reçus, traces) et, si vous le souhaitez, des filtres JavaScript ; Quicknode se charge du reste.
Streams fournit les données dans l'ordre de finalité avec des garanties de livraison « exactly-once », ce qui signifie que votre base de données reste cohérente avec la chaîne canonique sans que votre code ait à gérer l'ordre des blocs ou la déduplication. La gestion intégrée des réorganisations détecte automatiquement les réorganisations de la chaîne et envoie des charges utiles de correction, afin que vos données indexées reflètent toujours l'état réel de la chaîne. Pour les données historiques, la fonctionnalité de « backfill » d’ Streams vous permet d’alimenter votre base de données avec n’importe quelle plage de blocs passés, avec une synchronisation jusqu’à sept fois plus rapide que les pipelines d’indexation traditionnels basés sur RPC, tout en offrant les mêmes garanties de filtrage et de livraison que le streaming en temps réel.
Quicknode publie également un guide détaillé sur la création d’un indexeur blockchain avec Streams, qui explique comment créer un indexeur complet de transferts ERC-20 s’appuyant sur PostgreSQL et doté d’une API REST, de la configuration à l’exécution des requêtes. Pour les équipes qui ont besoin d’un traitement des données encore plus sophistiqué, Streams s’intègre à Quicknode Functions afin de permettre des transformations, un enrichissement et une automatisation « sans serveur » (serverless) en amont du pipeline de données en continu.
Quelle est la différence entre l'indexation et le RPC brut ?
Le RPC brut et l'indexation permettent de répondre à différents types de questions. Le RPC est conçu pour les requêtes ponctuelles et les écritures : récupérer ce bloc, lire ce solde, envoyer cette transaction. L'indexation est quant à elle destinée à la recherche et à l'analyse : tous les transferts d'un portefeuille, le volume total par jeton, l'historique des propriétaires d'une collection. Le tableau ci-dessous compare ces deux approches afin que vous puissiez choisir l'outil le mieux adapté à chaque tâche.
Dimension
RPC brut
Base de données indexée
Spécialisé dans
Lecture des points et envoi des transactions
Recherche, filtrage et agrégation
Langage de requête
Méthodes JSON-RPC
SQL ou GraphQL
Numérisations historiques
Lentement, bloc par bloc
Rapide, pré-traité et indexé
Temps nécessaire à la mise en place
Se connecter à un endpoint
Créer ou configurer un pipeline
Latence typique
Aller-retour par appel
En moins d'une seconde sur de grands ensembles de données
Quels types de requêtes l'indexation permet-elle d'effectuer ?
Une fois les données indexées dans une base de données structurée, les requêtes qui s’avèrent impossibles à réaliser directement sur la blockchain brute (RPC) deviennent alors très simples. Vous pouvez répertorier toutes les transactions associées à une adresse, retracer l’historique complet de propriété d’un NFT, agréger le volume de transactions par jeton et par jour, classer les portefeuilles en fonction de leurs avoirs, ou croiser des événements provenant de plusieurs contrats. Ce sont précisément ces requêtes qui alimentent les tableaux de bord, les explorateurs et les outils d’analyse. Pour comprendre pourquoi ces requêtes sont si difficiles à réaliser sans indexation, consultez la section « Interrogation des données de la blockchain ».
Comment l'indexation et la diffusion en continu fonctionnent-elles ensemble ?
Le streaming et l'indexation constituent des couches complémentaires. Le streaming est le mécanisme de diffusion qui transmet les nouveaux blocs et événements à votre infrastructure au fur et à mesure qu'ils se produisent, tandis que l'indexation consiste à organiser ces données entrantes dans un référentiel consultable. Une architecture moderne courante utilise un pipeline de streaming pour alimenter une base de données indexée en enregistrements, supprimant ainsi complètement la couche de polling, souvent peu fiable. Consultez les articles « Qu'est-ce que le streaming de données blockchain ? » et « Polling vs streaming » pour comprendre comment les données parviennent à l'indexeur.
Comment les indexeurs complètent-ils les données historiques ?
Le « backfilling » est le processus qui consiste à alimenter votre base de données avec des blocs historiques avant de passer aux données en temps réel. Un bon pipeline commence à partir d’un bloc historique choisi, traite la chaîne en progressant vers l’avant, puis effectue une transition transparente vers le temps réel une fois qu’il atteint la pointe de la chaîne, de sorte que les enregistrements historiques et en temps réel partagent un même schéma. Lorsqu’il est bien exécuté, le backfilling est bien plus rapide que de réanalyser la chaîne via un RPC brut. Découvrez comment accéder aux données historiquesde la blockchain et comparez les données en temps réel et historiques pour comprendre les compromis impliqués.
Foire aux questions
Pourquoi ne puis-je pas simplement utiliser le RPC au lieu de l'indexation ?
Le RPC est idéal pour récupérer un bloc, une transaction ou un solde spécifiques, mais il ne permet pas d'effectuer des recherches, des filtrages ou des agrégations sur l'ensemble de la chaîne. Répondre à une question telle que « tous les virements effectués depuis ce portefeuille » via le RPC impliquerait de parcourir des millions de blocs un par un, ce qui est irréalisable. L'indexation permet de pré-traiter ces données dans une base de données afin que la même question puisse être traitée en une seule requête.
Qu'est-ce qu'un sous-graphe ?
Un sous-graphe est une configuration utilisée par The Graph qui définit les contrats et les événements à indexer, ainsi que la manière de les mapper dans un schéma GraphQL interrogeable. Il s'agit d'une méthode courante pour créer un index, particulièrement adaptée aux données standard issues de la DeFi, des NFT et de la gouvernance, même si elle peut présenter des compromis en termes de latence en temps réel et de flexibilité du schéma par rapport aux pipelines personnalisés ou basés sur le streaming.
Comment les indexeurs gèrent-ils les réorganisations de la chaîne ?
Un indexeur robuste détecte les modifications de la chaîne canonique, annule les enregistrements dérivés des blocs orphelins et traite à nouveau les enregistrements corrects. Sans cela, votre base de données accumule des transactions fantômes ou manquantes. Les pipelines gérés gèrent automatiquement les réorganisations en envoyant des charges utiles de correction. Pour plus d'informations, consultez la section « Qu'est-ce qu'une réorganisation de blockchain ? ».
Dois-je développer mon propre indexeur ou recourir à un service géré ?
La création d'un indexeur personnalisé offre un contrôle total, mais nécessite de mettre en place l'ingestion, le décodage, la conception du schéma, la gestion des réorganisations, la surveillance et la mise à l'échelle, ce qui représente souvent plusieurs mois de travail. Un pipeline géré se charge pour vous de l'extraction, du tri, des réorganisations et de la livraison ; ainsi, la plupart des équipes parviennent plus rapidement en production en configurant un service et en concentrant leurs efforts d'ingénierie sur leur produit principal.
Dans quelles bases de données peut-on stocker les données de blockchain indexées ?
Les données indexées sont généralement stockées dans PostgreSQL, MongoDB, Snowflake, Elasticsearch ou dans un système de stockage d'objets tel qu'Amazon S3, selon que vous ayez besoin de requêtes transactionnelles, d'une recherche en texte intégral ou d'analyses à grande échelle. Un pipeline de streaming permet d'acheminer directement les enregistrements vers ces destinations. Pour des tutoriels complets, le « Builders Guide » présente en détail les modèles d'indexation courants.