Réponses>En savoir plus sur l'indexation et les données de la blockchain>Comment accéder aux données historiques de la blockchain
Comment accéder aux données historiques de la blockchain
// Tags
données historiques de la blockchaindonnées d'archives
En bref : pour accéder aux données historiques de la blockchain, il faut soit un nœud d’archivage (qui stocke chaque instantané d’état depuis la genèse), soit un outil de « backfilling » qui récupère et stocke les blocs passés dans une base de données consultable. Les nœuds complets standard ne conservent que les 128 blocs les plus récents de données d’état et suppriment tout ce qui est plus ancien ; par conséquent, une requête visant à consulter le solde d’un portefeuille datant de six mois sur un nœud complet échouera. Les deux principales approches sont l’accès RPC à un nœud d’archivage pour les requêtes d’état à un instant donné et le « backfilling » en continu pour la constitution de bases de données historiques exhaustives.
L'explication simple
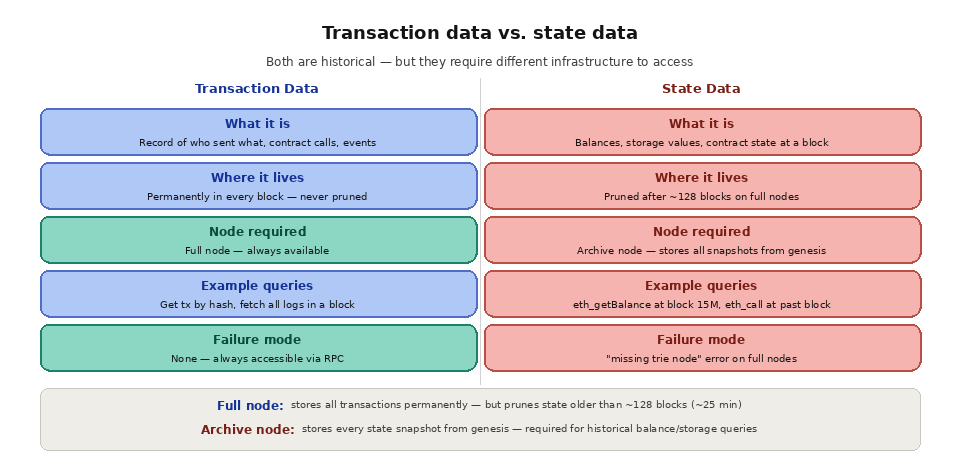
Les blockchains enregistrent toutes les transactions qui ont jamais eu lieu, mais cela ne signifie pas pour autant que toutes les données historiques soient facilement accessibles. Il convient de faire la distinction entre les données de transaction et les données d’état. Les données de transaction (qui indiquent qui a envoyé quoi à qui, quels contrats ont été exécutés, quels événements ont été émis) sont permanentes et disponibles dans chaque bloc. Les données d’état (les soldes, les valeurs stockées et l’état des contrats à un moment donné) constituent une autre story.
Les nœuds complets, qui constituent le type de nœud standard utilisé par la plupart des fournisseurs de RPC, stockent l’historique complet des blocs et des transactions, mais ne conservent que l’état actuel et une fenêtre glissante d’instantanés récents de l’état (généralement les 128 derniers blocs sur Ethereum, soit environ 25 minutes). Ils suppriment les données d'état les plus anciennes afin d'économiser de l'espace de stockage. Cela signifie qu'un nœud complet peut vous indiquer quelles transactions ont eu lieu dans le bloc 15 000 000, mais qu'il ne peut pas vous indiquer quel était le solde d'un portefeuille au niveau du bloc 15 000 000, à moins que ce bloc ne se trouve dans la fenêtre de conservation récente.
Lorsque votre application envoie un appel RPC tel que « eth_getBalance » avec un numéro de bloc historique à un nœud complet, celui-ci renvoie une erreur « missing trie node » car les données d'état correspondant à ce bloc ont été supprimées. C'est la surprise la plus courante à laquelle sont confrontés les développeurs lorsqu'ils travaillent pour la première fois avec des données historiques. La blockchain « se souvient » de tout, dans le sens où toutes les transactions sont enregistrées, mais la restauration de l'état à un moment arbitraire de l'historique nécessite une infrastructure spécifique.
Quelle est la différence entre un nœud complet et un nœud d'archive ?
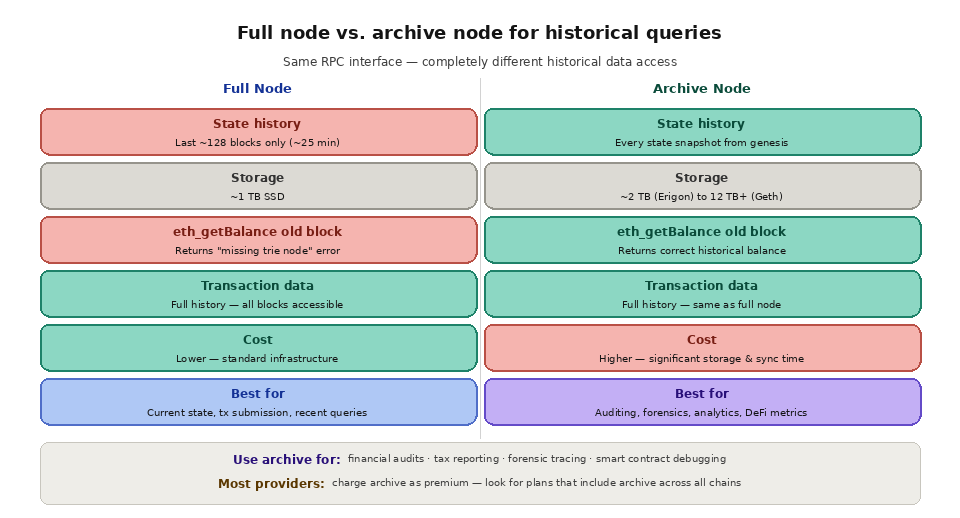
Le moyen le plus rapide de comprendre l'accès aux données historiques consiste à comparer les deux types de nœuds utilisés par la plupart des fournisseurs. Un nœud complet conserve l'historique complet des blocs et des transactions, mais élimine les anciens états, tandis qu'un nœud d'archivage conserve chaque instantané de l'état historique. Si vous n'avez besoin que de données récentes, un nœud complet est moins coûteux et plus rapide, mais les requêtes portant sur l'état historique à un moment donné nécessitent un nœud d'archivage. Pour une analyse plus approfondie, consultez notre guide comparatif entre nœud complet et nœud d'archivage, ainsi que la présentation générale de ce qu'est un nœud de blockchain.
Capacité
Nœud complet
Nœud d'archive
Rétention par l'État
Les ~128 derniers blocs (environ 25 minutes sur Ethereum)
Tous les états, depuis la genèse jusqu'aux plus récents
Encombrement de stockage
Environ 1 To sur Ethereum
12 To ou plus sur Ethereum
Requêtes sur l'historique des états
Échec dû à une erreur liée à un nœud manquant dans l'arbre trie
Renvoie l'état à n'importe quelle hauteur de bloc
Coût d'exploitation
Inférieur
Nettement plus élevé
Idéal pour
Soldes actuels et mouvements récents
Audits, déclarations fiscales, expertise judiciaire, analyse de données
Nœuds d'archivage pour les requêtes à un instant donné
Les nœuds d’archivage résolvent le problème de l’élagage de l’état en conservant chaque instantané d’état à partir du bloc de genèse. Un nœud d’ Ethereum -archivage stocke plus de 12 To de données, contre environ 1 To pour un nœud complet, ce qui rend son exploitation et sa maintenance nettement plus coûteuses. Mais il offre une fonctionnalité essentielle : la possibilité d’interroger l’état exact de n’importe quel compte, contrat ou emplacement de stockage à n’importe quelle hauteur de bloc historique.
C'est essentiel pour toute une série de cas d'utilisation. L'audit financier nécessite de reconstituer les soldes des comptes à des dates précises. Les déclarations fiscales doivent déterminer la valeur des avoirs en fin d'année. L'analyse judiciaire retrace l'flow des fonds à travers les transitions d'état historiques. Le débogage des contrats intelligents utilise l'historique des états pour reproduire et analyser les bugs ou les failles passés. L'analyse des protocoles DeFi calcule la TVL, l'APY et d'autres indicateurs historiques en interrogeant les états des pools à des hauteurs de bloc passées.
L'exploitation de votre propre nœud d'archivage mobilise d'importantes ressources. La synchronisation initiale dure plusieurs semaines, les coûts de stockage sont élevés et le nœud nécessite une maintenance continue, des mises à jour des clients et une surveillance. La plupart des équipes accèdent aux données archivées par l'intermédiaire de fournisseurs d'infrastructure plutôt que d'exploiter leurs propres nœuds. Lors de l'évaluation des fournisseurs, il est essentiel de vérifier si l'accès aux archives est inclus dans votre forfait ou facturé en tant que module complémentaire premium, et si le fournisseur prend en charge les données archivées sur toutes les chaînes dont votre application a besoin.
Jusqu'à quand peut-on remonter pour consulter les données historiques de la blockchain ?
Un nœud d’archivage vous permet de consulter l’état de n’importe quel compte, contrat ou emplacement de stockage, et ce depuis le bloc de genèse. Les données relatives aux transactions et aux événements sont disponibles dans chaque bloc, même sur un nœud complet standard, mais les soldes historiques et le stockage des contrats ne sont récupérables qu’à partir d’un nœud d’archivage. Cette distinction est importante lorsque vous devez déterminer si vous avez besoin de l’état à un instant donné ou d’un historique complet des activités passées, un compromis que nous abordons dans la section « Données blockchain en temps réel vs données historiques ». Si vos requêtes échouent systématiquement, c’est généralement parce que la requête a atteint un nœud complet ; c’est pourquoi comprendre le fonctionnement des requêtes RPC vous aide à les acheminer correctement.
Remplissage en continu des bases de données historiques
Les nœuds d'archivage répondent aux requêtes portant sur l'état à un instant donné, mais de nombreux cas d'utilisation des données historiques nécessitent autre chose : une base de données complète et consultable contenant les blocs, les transactions, les journaux d'événements et les traces passés. La création d'un tableau de bord d'analyse de la blockchain, d'une API d'historique des transferts de jetons ou d'un explorateur de blocs complet nécessite de traiter et de stocker les données historiques des blocs dans une base de données structurée, et ne se limite pas à interroger un nœud d'archivage à la demande.
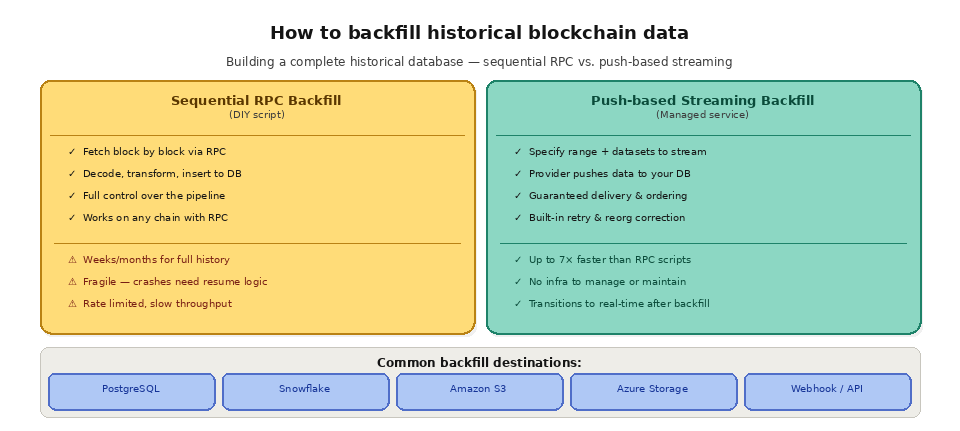
L'approche traditionnelle pour créer cette base de données consiste à écrire un script qui parcourt les blocs un par un, récupère les données de chaque bloc via RPC, décode les transactions et les journaux, puis insère les résultats dans votre base de données. Cela fonctionne, mais s'avère extrêmement lent et peu fiable à grande échelle. Le remplissage rétrospectif de l'historique complet d'Ethereum(plus de 20 millions de blocs) via des appels RPC séquentiels peut prendre des semaines, voire des mois. Le script doit gérer la limitation de débit, les échecs de connexion, les délais d'attente des nœuds, les nouvelles tentatives et l'ordre des blocs. Si le script plante en cours d'exécution, vous avez besoin d'une logique permettant de reprendre là où il s'est arrêté sans créer de lacunes ni de doublons dans vos données.
Les outils de « backfilling » de type « push » résolvent ces problèmes opérationnels en prenant en charge la complexité de l'infrastructure du côté du fournisseur. Vous spécifiez une plage de blocs, sélectionnez les ensembles de données dont vous avez besoin (blocs, transactions, reçus, traces, journaux), appliquez éventuellement des filtres, puis le système envoie les données vers votre destination en garantissant leur livraison, leur ordre correct et une nouvelle tentative automatique en cas d'échec. Une fois le remplissage historique terminé, ce même pipeline peut passer en mode de diffusion en temps réel afin de maintenir votre base de données à jour à mesure que de nouveaux blocs sont générés.
Combien de temps dure le remplissage des données historiques ?
Le temps nécessaire au « backfill » dépend de la chaîne, de la plage de blocs et des ensembles de données que vous demandez. Un script séquentiel qui récupère les blocs un par un via RPC standard peut prendre des semaines, voire des mois, pour couvrir 20 millions de blocs, et il doit gérer lui-même les tentatives de réessai, l’ordonnancement et la reprise. Les « backfills » gérés basés sur la poussée (push) parallélisent le travail et peuvent s’effectuer jusqu’à sept fois plus rapidement, avec des estimations de coût et de durée affichées avant le lancement. Le débit de votre infrastructure RPC sous-jacente constitue le principal facteur limitant pour toute approche « à faire soi-même ».
Autres méthodes pour les données historiques
The Graph et d’autres protocoles d’indexation fournissent des données historiques pré-indexées pour des contrats intelligents spécifiques via des sous-graphes. Si quelqu’un a déjà déployé un sous-graphe pour le protocole dont vous avez besoin (comme Uniswap, Aave ou Lido), vous pouvez interroger les données historiques via son API GraphQL sans avoir à créer votre propre pipeline. La limite réside dans le fait que les sous-graphes sont spécifiques à un contrat et à un schéma ; vous ne pouvez donc interroger que ce que l’auteur du sous-graphe a choisi d’indexer.
Des fournisseurs de données tiers tels que Dune Analytics, Flipside Crypto et Nansen gèrent des bases de données historiques exhaustives couvrant les principales chaînes et les mettent à disposition via des interfaces SQL ou des API. Ces solutions sont pratiques pour l'analyse et la recherche, mais impliquent une dépendance vis-à-vis de l'actualité, de la précision et de la disponibilité des données fournies par ces tiers. Pour les applications de production qui doivent disposer de leur propre pipeline de données, s'appuyer sur les données brutes de la blockchain (via des nœuds d'archivage ou des streams de backfill) offre davantage de contrôle et de fiabilité.
Les explorateurs et les API spécifiques à une chaîne (comme l'API d'Etherscan) offrent une autre voie d'accès aux données historiques, mais ils imposent généralement des limites de débit strictes sur les formules gratuites et peuvent ne pas fournir le niveau de détail ou l'exhaustivité requis par les applications de production.
Quelle méthode faut-il utiliser pour accéder aux données historiques de la blockchain ?
Il n'existe pas de méthode idéale : le choix approprié dépend de vos besoins : un état à un instant donné, une base de données complète et interrogeable, ou des analyses pré-agrégées. Le tableau ci-dessous résume les principales options. Si votre objectif est d'assurer un accès répété et efficace plutôt que des consultations ponctuelles, comparez le RPC à l'indexation et renseignez-vous sur ce qu'est l'indexation de la blockchain avant de vous engager, car l'interrogation de données de blockchain à grande échelle est plus complexe qu'il n'y paraît à première vue.
Méthode
Idéal pour
Principale limite
Nœud d'archivage RPC
État à un instant donné pour n'importe quel bloc
Ce n'est pas une base de données volumineuse
Remplissage en continu
Création d'une base de données complète et consultable
Nécessite une destination pour stocker les données
Protocoles d'indexation et sous-graphes
Données historiques spécifiques à un contrat
Limité à ce qui a été indexé
API de données tierces
Analyses et recherche
Dépendance vis-à-vis d'un fournisseur
API d'explorateurs de blocs
Recherches rapides
Limites de débit strictes et granularité restreinte
Comment « Quicknode » permet d'accéder aux données historiques
Quicknode comprend l'accès aux nœuds d'archivage pour toutes les formules, ce qui évite d'avoir à gérer ou à payer séparément une infrastructure d'archivage. Chaque Quicknode RPC endpoint peut répondre à des requêtes d'état historique à n'importe quelle hauteur de bloc, du bloc de genèse au plus récent. La technologie QRoute de Quicknode achemine automatiquement les requêtes d'état historique vers les nœuds d'archivage et les requêtes d'état actuel vers les nœuds complets, en fournissant les deux via une seule URL endpoint sans aucune configuration requise.
Pour la création de bases de données historiques, Quicknode Streams propose des modèles de backfill en un clic qui vous permettent d’alimenter votre base de données avec l’historique complet de la chaîne sur plus de 20 réseaux. Vous sélectionnez la chaîne, le type de jeu de données (blocs, transactions, reçus, traces ou combinaisons tout-en-un) et la destination (PostgreSQL, Snowflake, Amazon S3, Azure Storage, webhooks), et Streams transfère les données avec une livraison garantie, un ordre correct des blocs et une logique de réessai intégrée. Les estimations de coût et de durée d’exécution s’affichent avant le lancement, vous offrant ainsi une transparence totale. Les synchronisations rétrospectives sont jusqu’à sept fois plus rapides que les scripts traditionnels basés sur RPC, et une fois terminées, le même flux peut se poursuivre en temps réel mode afin de maintenir votre base de données à jour.
Qu'est-ce que les données historiques de la blockchain ?
Les données historiques de la blockchain désignent tout enregistrement des activités passées sur la chaîne, notamment les blocs, les transactions, les journaux d'événements, les traces et l'état (soldes et stockage des contrats) à une hauteur de bloc donnée. Les données de transaction sont permanentes sur chaque nœud, mais l'état historique nécessite un nœud d'archivage ou un « backfill » stocké.
Pourquoi la fonction eth_getBalance échoue-t-elle avec les anciens blocs ?
Un nœud complet standard élimine les états datant d'avant les 128 derniers blocs environ ; par conséquent, un appel historique à `eth_getBalance` renvoie une erreur indiquant qu'un nœud de l'arbre trie est manquant. L'interrogation d'un nœud d'archive, qui conserve tous les instantanés d'état, permet de résoudre cette erreur.
Ai-je besoin d'un nœud d'archivage pour accéder aux données historiques ?
Vous devez disposer d'un accès aux archives pour effectuer des requêtes sur l'état à un instant donné, à des hauteurs de bloc arbitraires. Si vous n'avez besoin que de l'historique des transactions et des journaux d'événements, vous pouvez les consulter à partir de nœuds complets ou les stocker dans votre propre base de données via un « backfill ».
Qu'est-ce qu'un « backfill » de données sur la blockchain ?
Un « backfill » récupère une série de blocs passés et leurs jeux de données, puis les charge dans une base de données ou une destination de stockage. Les « backfills » de type « push » gèrent l'ordonnancement, les tentatives de réessai et la livraison garantie ; ils peuvent ensuite passer en mode de diffusion en temps réel une fois qu'ils ont rattrapé leur retard.
Quelle est la capacité de stockage d'un nœud d'archivage « Ethereum » ?
Un nœud d'Ethereum d' stocke environ 12 To ou plus, contre environ 1 To pour un nœud complet. Cet espace de stockage supplémentaire contient tous les instantanés historiques de l'état du réseau, ce qui explique pourquoi l' d' est plus coûteuse à exploiter.