🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る SOC 2 タイプ II 認証取得・ISO 27001
回答>ブロックチェーン の基礎について学ぶ>オンチェーン オフチェーンデータとの違いは? オンチェーン vs オフチェーンデータ:その違いとは?
// Tags
オンチェーン vs オフチェーンブロックチェーン データ保存
要約: オンチェーン のデータはブロックチェーン 上に直接保存されるため、永続的、透明性が高く、検証可能です。by といった仕組みです。オフチェーンデータはブロックチェーン の外、通常は従来のサーバー、IPFS のような分散型ストレージネットワーク、あるいはプライベートデータベースに保存されます。実世界のアプリケーションの多くは、この両方を組み合わせて使用しており、重要な状態情報はオンチェーン に保持しつつ、コスト削減やパフォーマンス向上のために、容量の大きいデータや重要度の低いデータはオフチェーンに保存しています。
わかりやすい説明
すべてのブロックチェーン には容量に限りがあります。オンチェーン にデータを保存するということは、ネットワーク上のすべてのノードに永続的に記録されるトランザクションやスマートコントラクトの状態にデータを書き込むことを意味します。これにより、データは改ざん防止され、誰でもアクセスできるようになりますが、その代償も伴います。Ethereum では、ガス料金によっては、わずか32バイトのデータを保存するだけで数ドルの費用がかかる場合があります。画像や文書全体を保存するオンチェーン となると、その費用は法外なものになってしまいます。
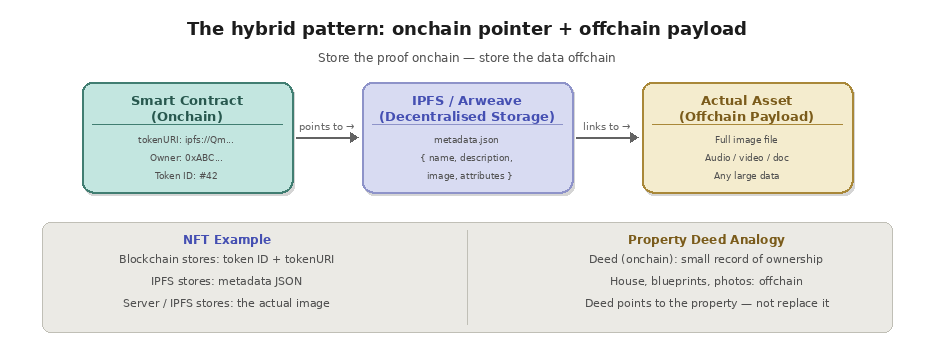
そこでオフチェーンデータの出番となります。開発者は、画像全体をブロックチェーン に保存する代わりに、IPFS (分散型ファイルストレージネットワーク)に画像を保存し、IPFS のコンテンツハッシュオンチェーン のみを保存することができます。ブロックチェーン レコードはデータの正しい内容を証明し、オフチェーンストレージが実際にデータを保持します。このハイブリッドなアプローチにより、ブロックチェーン の検証可能性と、従来のストレージシステムや分散型ストレージシステムのスケーラビリティの両方を実現できます。
これを不動産の権利証のようなものと考えてみてください。権利証そのもの(所有権を示す小さくて重要な記録)は郡書記官事務所に登録されます。しかし、実際の家屋や設計図、検査報告書、写真などはすべて別の場所に存在しています。権利証は、その不動産を指し示しているのです。ブロックチェーン も同様に機能します。重要な証拠や参照情報を保存しつつ、大規模なデータセットはオフチェーン上に存在します。
オンチェーン のデータとは何か
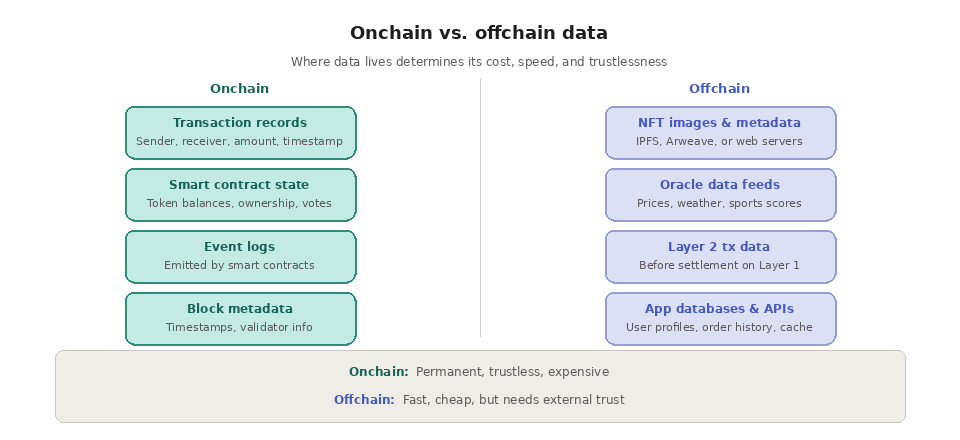
オンチェーン データには、ブロックチェーン の状態やトランザクション履歴に永続的に記録されるすべての情報が含まれます。これには、トランザクション記録(送信者、受信者、金額、タイムスタンプ)、スマートコントラクトのコードおよび状態変数(トークンの残高、所有権記録、ガバナンス投票)、by のスマートコントラクトから発行されるイベントログ、およびタイムスタンプやバリデーター情報などのブロックメタデータが含まれます。
ユーザー が分散型取引所でトークンを交換すると、取引金額、関与するアドレス、その結果生じる状態の変化など、取引の全容がオンチェーン に記録されます。NFTがミントされると、トークンID、所有者のアドレス、メタデータのURIがすべて、スマートコントラクトのオンチェーン 状態内に保存されます。このデータは、確認されるとimmutable となり、つまり誰も事後的に変更することはできません。
オンチェーン データこそが、ブロックチェーン の中核となる価値提案である「トラストレスな検証」を実現するものです。ノードを運用している人、あるいはRPCにクエリを送信する人は誰でも エンドポイント は、第三者に依存することなく、オンチェーン のあらゆるデータを独自に検証できます。これが、ネットワークにおける唯一の真実の源泉です。
オフチェーンデータとは何か
オフチェーンデータとは、ブロックチェーン の外部に存在するが、by で参照されるもの、またはオンチェーン の活動に関連するものを指します。これには、IPFS や中央集権型サーバーに保存された NFT 画像やメタデータファイル、by の dapps で使用される大規模なデータセット(ユーザー プロファイル、注文履歴、分析データ)、現実世界の情報(価格、天気、スポーツの試合結果)をブロックチェーン に提供するオラクルデータフィード、レイヤー 1 でバッチ処理および決済される前のレイヤー 2 取引データ、およびスマートコントラクトと連携するアプリケーションのフロントエンドや API が含まれます。
最も一般的なパターンは、オフチェーンデータを指すコンテンツハッシュやURI(オンチェーン )を格納することです。例えば、ほとんどのNFTスマートコントラクトは、IPFS やWebサーバー上にホストされているJSONメタデータファイルを指すtokenURIを格納しています。そのJSONファイルには、画像のURL、説明、および属性が含まれています。ブロックチェーン はこのポインタを認識しており、オフチェーンシステムがペイロードを保持しています。
Chainlinkのようなオラクルは、オンチェーン とオフチェーンの世界をつなぐ重要な架け橋です。スマートコントラクトは、本来、外部データに直接アクセスすることはできません。株価を確認したり、気象情報を検証したり、現実世界での出荷状況を確認したりすることはできないのです。オラクルは、こうしたオフチェーンのデータを取得し、検証可能な形でオンチェーン に提供することで、スマートコントラクトが現実世界の出来事に対応できるようにします。
トレードオフ
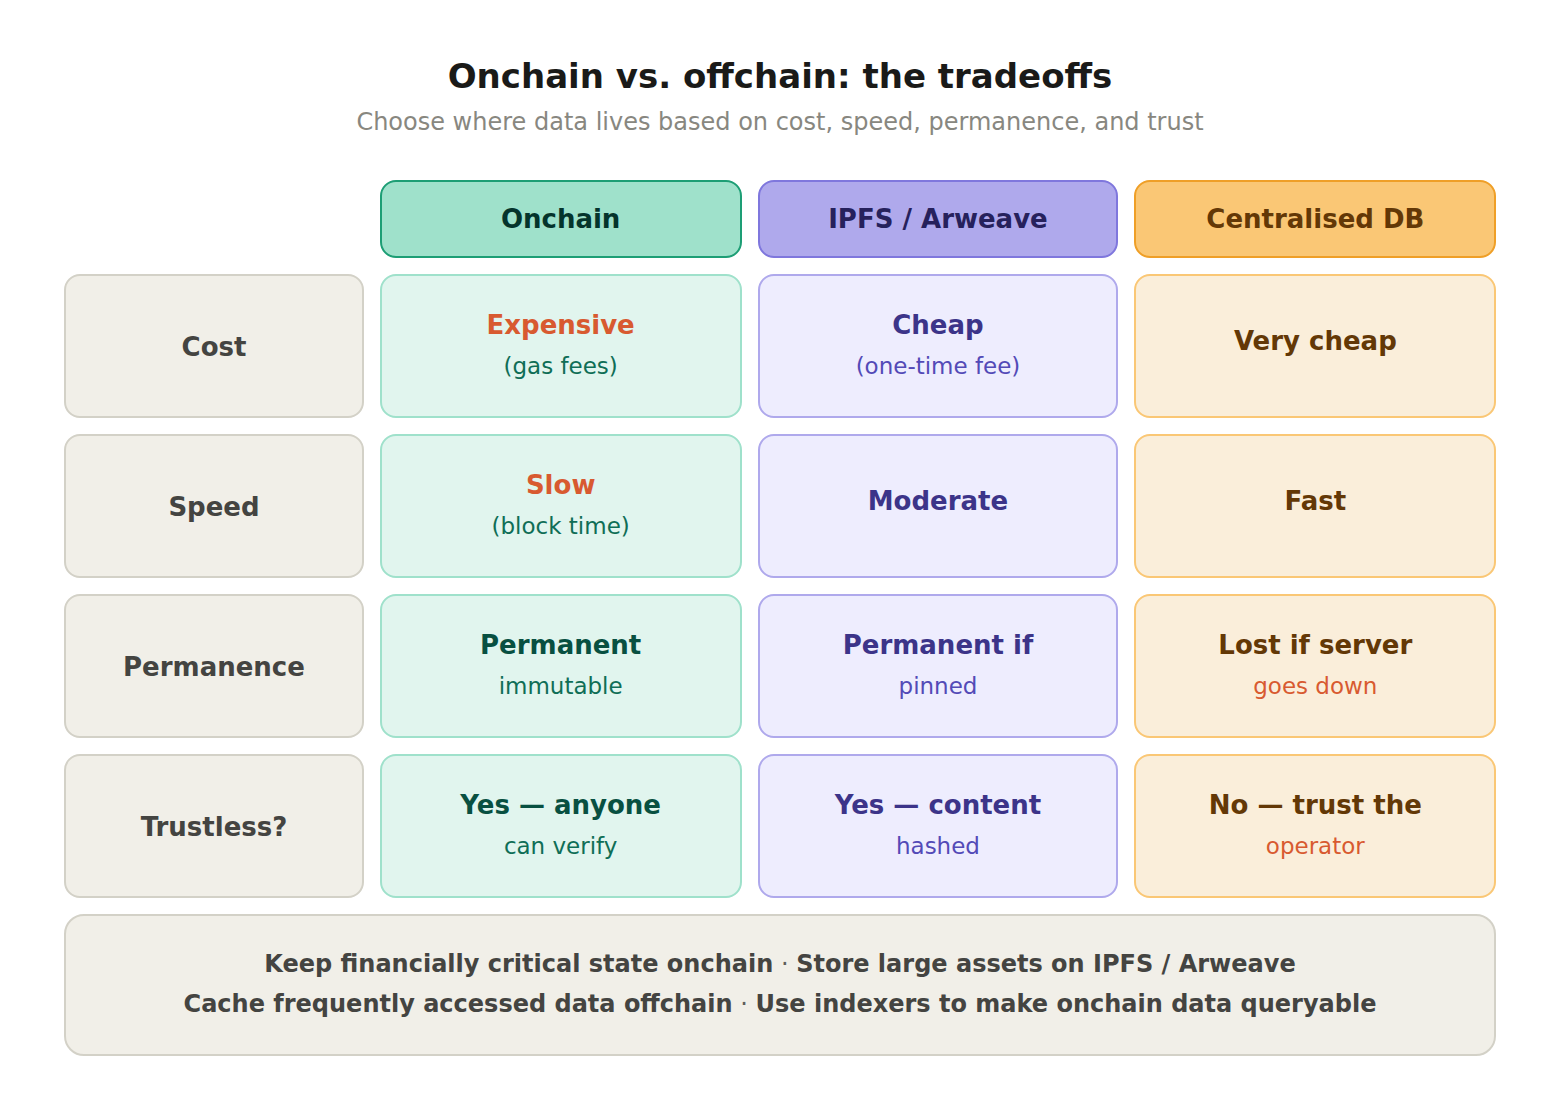
オンチェーン とオフチェーンのどちらにデータを保存するかは、コスト、速度、永続性、そして信頼性の要件によって決まります。オンチェーン での保存はコストがかかりますが、永続的かつトラストレスです。オフチェーンでの保存は安価で高速ですが、外部システムへの依存が生じます。NFTの画像が中央集権型サーバーに保存されており、そのサーバーがダウンした場合、NFT自体は依然として存在しますがオンチェーン 、それが表すアート作品にはアクセスできなくなります。画像がIPFS にあり、誰もそれをピン留めしていない場合にも、同様の事態が発生する可能性があります。
IPFS 分散型ストレージプロトコルはIPFS 単一のサーバーに依存するのではなく、ノードのネットワーク全体にファイルを分散させることで、この問題を解決することを目指しています。IPFS コンテンツアドレス方式のストレージIPFS 、ファイルはサーバー上の場所ではなく、暗号ハッシュによって参照されます。ネットワーク上の少なくとも1つのノードがそのファイルをピン留めしている限り、そのファイルにはアクセスし続けることができます。Arweaveは、この仕組みをさらに発展させ、1回限りの料金モデルを通じて永続的な保存を促進しています。
開発者 で生産用アプリケーションを構築する場合、そのアーキテクチャでは通常、財務上重要なすべての状態オンチェーン (残高、所有権、承認)を保持し、大規模な資産はIPFS のような分散型ストレージに保存し、パフォーマンス向上のために頻繁にアクセスされるデータをオフチェーンデータベースにキャッシュし、インデクサーやデータパイプラインを使用してオンチェーン のデータをクエリ可能にするという構成が一般的です。
オンチェーン とオフチェーンデータの違いは何ですか?
オンチェーン また、オンチェーンデータとオフチェーンデータは、保存場所や保証内容が異なります。オンチェーン データは、 ブロックチェーン 各ノードでby に書き込まれ、検証されますが、オフチェーンデータは、チェーンが参照するだけの外部システムに格納されています。以下の表では、最も重要な属性について両者を比較しています。
属性 | オンチェーン データ | オフチェーンデータ |
|---|
場所 | ブロックおよび契約の状態に保存される | サーバー、IPFS、またはデータベース |
費用 | 高額、バイト単位でガスを支払う | 低価格かつ標準的なストレージ料金 |
速度 | Limited by block times | 高速で、near 読み書き |
永続性 | Immutable | 固定またはアーカイブされていない限り、変更可能 |
透明性 | 誰でも閲覧・確認可能 | 非公開またはアクセス制限あり |
信頼モデル | Trustless, secured by consensus | ホストやストレージネットワークによって異なります |
こんな方に最適 | 残高、所有権、証明 | 画像、大容量ファイル、キャッシュされた分析データ |
オンチェーン とオフチェーン、どちらにデータを保存すべきか?
経験則は単純です。トラストレスで、確定性があり、公開的に検証可能でなければならないもの(オンチェーン )はすべて保持し、それ以外はコスト削減と処理速度向上のためにオフチェーンに移すことです。以下の表は、一般的なデータ型と、通常最も適したストレージ層との対応関係を示しています。
データ型 | おすすめの場所 | なぜ |
|---|
トークンの残高と保有状況 | オンチェーン | トラストレスかつ確定性があること |
スマートコントラクトのロジック | オンチェーン | 実行は検証可能でなければならない |
NFTのメディアとメタデータ | オフチェーン(IPFS) | 大きすぎて保管コストがかかりすぎるオンチェーン |
分析と検索インデックス | Offchain | 高速なクエリが必要であり、チェーンデータから再構築される |
実世界データフィード | オラクルを介したオフチェーン処理 | Chainsでは外部データを取得できません |
レイヤー2およびロールアップのトランザクションは、オンチェーン (オンチェーン)か、それともオフチェーンか?
レイヤー2のトランザクションはオフチェーンで開始され、決済が完了するとオンチェーン となります。レイヤー2のブロックチェーン は、処理速度向上のために別のレイヤーでトランザクションを実行し、その後、ロールアップがそれらの多くをバッチ処理して、圧縮されたデータと証明をレイヤー1に送信します。つまり、実行はオフチェーンで行われますが、最終的なデータとセキュリティの根拠はオンチェーン にあります。主な2つの設計であるオプティミスティック・ロールアップとZKロールアップは、バッチ処理されたオフチェーンの処理が有効であることをどのように証明するかという点で異なります。
オラクルは、オフチェーンのデータをブロックチェーン にどのように連携させるのでしょうか?
スマートコントラクトは単独ではインターネットにアクセスできないため、オフチェーンの情報を取得するためにオラクルに依存していますオンチェーン 。オラクルネットワークは、資産価格やイベントの結果などの外部データを取得し、その値について合意を形成した上で、他のコントラクトが読み取れるようにコントラクトに書き込みます。これにより、DeFiプロトコルが市場価格に反応したり、保険契約が現実世界のイベントに対応したりすることが可能になります。その際、最終的に実行される値は常にオンチェーン 検証可能な状態が保たれます。
よくある質問
オフチェーンのデータは安全なのでしょうか?
その可能性はありますが、保証の仕組みは異なります。オフチェーンデータは保存先のセキュリティを継承するため、中央集権型サーバーは単一障害点となりますが、IPFS やArweaveのようなコンテンツアドレス指定型ネットワークでは、コピーが多数のノードに分散されます。オフチェーンデータの暗号ハッシュをオンチェーン に保存することで、誰でもオフチェーンのペイロードが改ざんされていないことを検証できるようになります。
NFTのオフチェーン画像が利用できなくなると、そのNFTはどうなるのでしょうか?
トークン自体は依然として存在しています(オンチェーン )が、そのトークンが指し示すアートワークは、ホストが消滅し、誰もそのファイルをピン留めしなければ、アクセスできなくなる可能性があります。そのため、本格的なプロジェクトでは、NFTのメディアをIPFS やArweaveに保存し、不安定なWeb URLではなく、コンテンツのハッシュ(オンチェーン )を保持するようにしています。
スマートコントラクトはオフチェーンのデータを直接読み取ることができますか?
いいえ。スマートコントラクトは決定論的であり、外部環境から隔離されているため、ネットワーク呼び出しを行うことはできません。スマートコントラクトは、オフチェーンのデータオンチェーン を検証可能な形式で受け取るためにオラクルに依存しており、そのデータを受け取ってから初めて利用できるようになります。
IPFS は、オンチェーン にあるのか、それともオフチェーンなのか?
IPFS はオフチェーンです。これは、ブロックチェーン の外部にファイルを保持する分散型ストレージネットワークであり、一方、ブロックチェーン には通常、それらのファイルを指し示すIPFS のコンテンツハッシュのみが保存されます。
オンチェーン の過去のデータには、どのようにアクセスすればよいですか?
現在の状態はどのノードからでも簡単に読み取れますが、完全な履歴を取得するには、多くの場合、アーカイブノードやバックフィルパイプラインが必要となります。一般的なアプローチとそのトレードオフについては、「 ブロックチェーン の履歴データへのアクセス」を参照してください。
Quicknode のQuicknode
オンチェーン とオフチェーンデータの両方を扱うには、信頼性の高いインフラストラクチャが必要です。QuicknodeのCore APIを利用すれば、80以上のチェーンに対して低遅延のRPCアクセスを行い、オンチェーン データの読み書きが可能です。Quicknode Streams これにより、ブロックチェーン のイベントをリアルタイムでキャプチャし、webhooks 、PostgreSQLデータベース、S3バケットなどのオフチェーン先へルーティングすることが可能になり、オンチェーン とオフチェーンの世界を橋渡しするデータパイプラインを容易に構築できます。分散型ストレージについては、Quicknode の IPFS ピンニングサービスや専用ゲートウェイを利用すれば、独自のIPFS ノードを管理することなく、オフチェーンコンテンツの保存や取得が可能です。
参考資料