🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る ブロックチェーン の過去データへのアクセス:ノードとバックフィル |Quicknode
ニュースレターでは、無料のリソース、Quicknodeの最新情報、Web3に関するインサイトなどをお届けします。
CLI、Admin API 、MCP、SDK 、および75以上のチェーンに対応したAIネイティブツール。by 開発者 を構築し、開発者 向けに提供しています。
Python、Ruby、JavaScriptの最新コード例。スマートコントラクト、NFT、dAppsに関する詳細なガイド。
SOC 2 タイプ II 認証取得・ISO 27001
回答 > インデックス作成とブロックチェーン データについて学ぶ > ブロックチェーン の過去データへのアクセス方法 ブロックチェーン の過去のデータにアクセスする方法
// Tags
ブロックチェーン の過去のデータ アーカイブデータ
要約: ブロックチェーン の履歴データにアクセスするには、 アーカイブノード(ジェネシスからのすべての状態スナップショットを保存するもの)か、過去のブロックを取得してクエリ可能なデータベースに保存するデータバックフィルツールのいずれかが必要です。標準的なフルノードは、状態データの最新128ブロックのみを保持し、それより古いものはすべて削除するため、フルノード上で6か月前のウォレット残高を照会しようとすると失敗します。 主なアプローチとしては、特定の時点の状態を照会するためのアーカイブノードへのRPCアクセスと、包括的な履歴データベースを構築するためのストリーミングによるバックフィルという2つがあります。
VIDEO
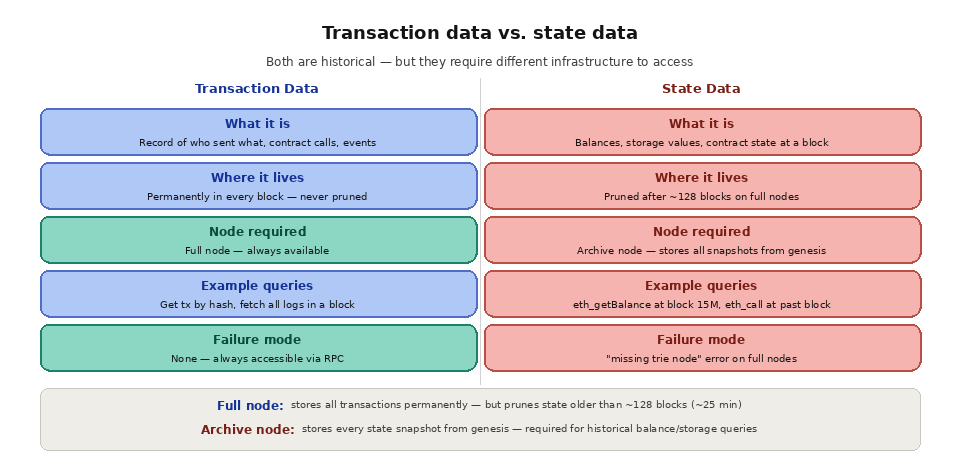
わかりやすい説明 ブロックチェーン これまでに発生したすべてのトランザクションが記録されていますが、だからといって、過去のデータすべてに簡単にアクセスできるわけではありません。その違いは、トランザクションデータと状態データにあります。トランザクションデータ(誰が誰に何を送信したか、どのコントラクトが呼び出されたか、どのイベントが発生したかといった記録)は永続的であり、すべてのブロックで確認できます。一方、状態データ(特定の時点における残高、ストレージの値、コントラクトの状態など)は、これとは異なるものですstory 。
フルノードは、ほとんどのRPCプロバイダーが運用している標準的なノードであり、ブロックとトランザクションの完全な履歴を保存しますが、維持するのは現在の状態と、直近の状態スナップショットのローリングウィンドウ(Ethereum では通常、直近の128ブロック、およそ25分間)のみです。 フルノードは、ストレージを節約するために古い状態データを削除します。つまり、フルノードはブロック15,000,000でどのようなトランザクションが行われたかは教えてくれますが、そのブロックが最近の保持ウィンドウ内に含まれていない限り、ブロック15,000,000時点でのウォレットの残高については教えてくれません。
アプリケーションが「eth_getBalance」のようなRPC呼び出しを、過去のブロック番号を指定してフルノードに送信すると、そのブロックの状態データが削除されているため、ノードは「missing trie node」エラーを返します。これは、開発者 が過去のデータを初めて扱う際に遭遇する最も一般的な予期せぬ問題です。ブロックチェーン は、すべてのトランザクションが記録されるという意味で「すべてを記憶」していますが、過去の任意の時点の状態を復元するには、特別なインフラストラクチャが必要となります。
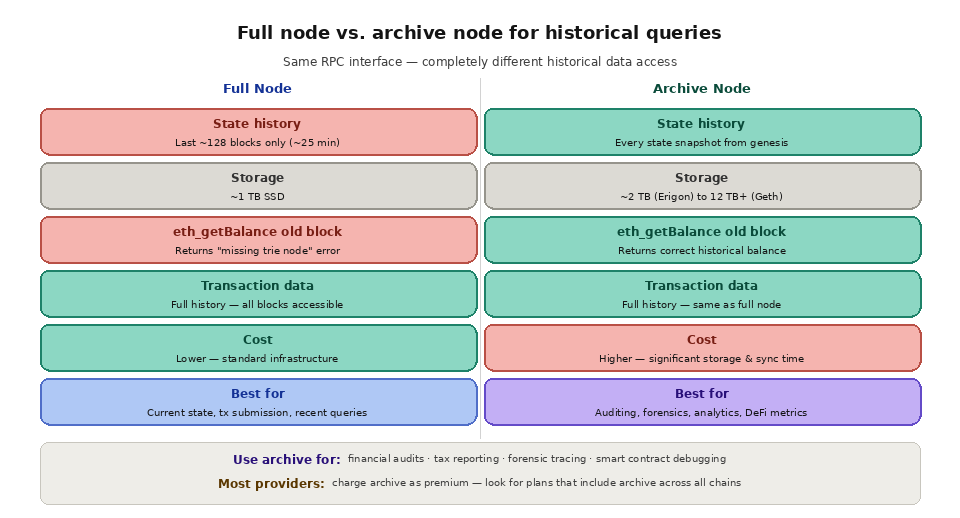
フルノードとアーカイブノードの違いは何ですか? 履歴データへのアクセス方法を理解する最も手っ取り早い方法は、ほとんどのプロバイダーが運用している2種類のノードを比較することです。フルノードはブロックとトランザクションの完全な履歴を保持しますが、古い状態は削除します。一方、アーカイブノードは過去のすべての状態のスナップショットを保持します。最近のデータのみが必要な場合は、フルノードの方がコストも低く、処理も高速ですが、特定の時点における履歴状態のクエリを行うには、アーカイブノードが必要です。より詳細な解説については、フルノードとアーカイブノードの比較に関する ガイドや、 ブロックチェーン ノードの 概要をご覧ください。
機能
フルノード
アーカイブノード
州内留保
直近の約128ブロック(Ethereum では約25分)
『ジェネシス』から最新作までの全作品
設置面積
約1TBのEthereum
12TB以上Ethereum
過去の状態に関するクエリ
トライノードが見つからないというエラーで失敗する
任意のブロック高さにおける状態を返す
運営コスト
低い
著しく高い
こんな方に最適
現在の残高と最近の取引履歴
監査、税務申告、フォレンジック、分析
ポイント・イン・タイム・クエリ用のアーカイブノード アーカイブノードは、ジェネシスブロック以降すべての状態スナップショットを保持することで、状態のプルーニング問題を解決します(by )。Ethereum のアーカイブノードは、フルノードの約1TBに対し12TB以上のデータを保存するため、運用・維持にかかるコストが大幅に高くなります。しかし、これにより、過去の任意のブロック高における、任意のアカウント、コントラクト、またはストレージスロットの正確な状態を照会するという極めて重要な機能が実現されます。
これは、さまざまなユースケースにおいて不可欠です。財務監査では、特定の日付における口座残高を再構築する必要があります。税務報告では、年度末時点での保有資産の価値を算定する必要があります。フォレンジック分析では、過去の状態遷移を通じて資金のflow を追跡します。スマートコントラクトのデバッグでは、過去の状態を利用して、過去のバグやエクスプロイトを再現・分析します。DeFiプロトコルの分析では、過去のブロック高におけるプールの状態を照会することで、過去のTVL、APY、その他の指標を算出します。by
独自のアーカイブノードを運用するには、多大なリソースが必要です。初期の同期には数週間を要し、ストレージコストも高額になる上、ノードの継続的なメンテナンス、クライアントの更新、監視も必要となります。チーム のユーザーの多くは、独自のノードを運用するのではなく、インフラプロバイダーを通じてアーカイブデータにアクセスしています。プロバイダーを評価する際の重要なポイントは、アーカイブへのアクセスがプランに含まれているか、それともプレミアムアドオンとして別途課金されるか、そしてそのプロバイダーが、アプリケーションで必要なすべてのチェーンにわたるアーカイブデータをサポートしているかどうかです。
ブロックチェーン の過去データを、どのくらいさかのぼって照会できますか? アーカイブノードを使用すると、ジェネシスブロックまで遡って、任意のアカウント、コントラクト、またはストレージスロットの状態を照会することができます。 トランザクションやイベントのデータは、標準的なフルノードであってもすべてのブロックから取得可能ですが、過去の残高やコントラクトのストレージはアーカイブノードからのみ復元可能です。この違いは、特定の時点の状態が必要なのか、過去のアクティビティの完全な記録が必要なのかを判断する際に重要になります。このトレードオフについては 、「リアルタイムデータとブロックチェーン の履歴データ」 で解説しています。クエリが繰り返し失敗する場合は、通常、リクエストがフルノードに到達したことが原因です。そのため、RPCリクエストの仕組みを理解することで 、リクエストを正しくルーティングできるようになります。
履歴データベース向けのストリーミング・バックフィル アーカイブノードは特定の時点の状態に関するクエリに応答しますが、過去のデータを利用する多くのユースケースでは、それとは異なるもの、すなわち過去のブロック、トランザクション、イベントログ、トレースを網羅し、クエリ可能な完全なデータベースが必要となります。「ブロックチェーン 」の分析ダッシュボードや、トークン転送履歴API、あるいは包括的なブロックエクスプローラーを構築するには、単にオンデマンドでアーカイブノードにクエリを実行するだけでなく、過去のブロックデータを構造化されたデータベースで処理・保存する必要があります。
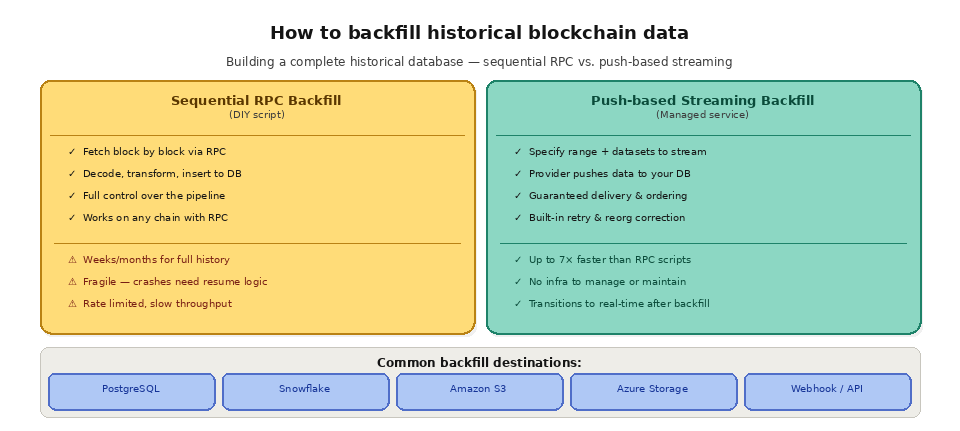
このデータベースを構築する従来のアプローチは、ブロックをby 一つずつ順に処理するスクリプトを作成し、RPCを介して各ブロックのデータを取得し、トランザクションとログをデコードして、その結果をデータベースに挿入するというものです。これは機能しますが、処理速度が極めて遅く、大規模になると不安定になりがちです。Ethereum の全履歴(2,000万ブロック以上)を順次RPC呼び出しでバックフィルするには、数週間から数ヶ月を要する場合があります。スクリプトは、レート制限、接続障害、ノードのタイムアウト、再試行、およびブロックの順序付けを処理する必要があります。もしスクリプトが途中でクラッシュした場合、データに欠落や重複を生じさせることなく、中断した箇所から再開するためのロジックが必要となります。
プッシュ型のバックフィリングツールは、プロバイダー側のインフラの複雑さを処理することで、こうした運用上の課題を解決します。by ブロック範囲を指定し、必要なデータセット(ブロック、トランザクション、レシート、トレース、ログ)を選択し、必要に応じてフィルタを適用するだけで、システムがデータを宛先へプッシュします。この際、確実な配信、正しい順序の保証、および失敗時の自動再試行が保証されます。履歴データのバックフィルが完了すると、同じパイプラインをリアルタイムストリーミングに切り替えることで、新しいブロックが生成されるたびにデータベースを最新の状態に保つことができます。
履歴データのバックフィルにはどのくらいの時間がかかりますか? バックフィルにかかる時間は、チェーン、ブロック範囲、およびリクエストするデータセットによって異なります。標準の RPC 経由でブロックを 1 つずつ取得する順次スクリプトの場合、2,000 万ブロックを処理するのに数週間から数ヶ月かかる可能性があり、リトライ、順序付け、再開の処理もすべて独自に行う必要があります。マネージドのプッシュ型バックフィルでは、処理を並列化できるため、最大 7 倍の速度で完了することができ、開始前にコストと完了までの所要時間の見積もりが表示されます。 基盤となるRPCインフラ のスループットは、あらゆる自作アプローチにおける主なボトルネックとなります。
過去データに関するその他の手法 The Graph やその他のインデックス作成プロトコルは、サブグラフを通じて特定のスマートコントラクトのインデックス化済み履歴データを提供しています。必要なデータが得られるプロトコル(Uniswap、Aave、Lidoなど)のサブグラフがすでにデプロイされている場合、独自のパイプラインを構築することなく、そのプロトコルの GraphQL API を通じて履歴データをクエリできます。ただし、サブグラフはコントラクトやスキーマごとに固有であるため、そのサブグラフの作成者がインデックス化対象として選択した内容のみをクエリできるという制限があります。
Dune Analytics、Flipside Crypto、Nansen などのサードパーティのデータプロバイダーは、主要なブロックチェーンにわたる包括的な履歴データベースを管理しており、SQL インターフェースや API を通じてこれらを提供しています。これらは分析や調査には便利ですが、サードパーティのデータの鮮度、正確性、可用性への依存が生じます。独自のデータパイプラインを構築する必要がある本番環境のアプリケーションの場合、生のブロックチェーン データ(アーカイブノードまたはバックフィルstreams 経由)を基盤として構築することで、より高い制御性と信頼性 が得られます。
チェーン固有のエクスプローラーやAPI(EtherscanのAPIなど)は、履歴データにアクセスするための別の手段を提供しますが、通常、無料プランでは厳しいレート制限が課されており、本番環境のアプリケーションに必要な詳細度や完全性を満たさない場合があります。
ブロックチェーン の過去のデータにアクセスするには、どの方法を使用すべきでしょうか? 方法
こんな方に最適
主な制限事項
アーカイブノードのRPC
任意のブロックにおけるその時点の状態
一括データベースではない
ストリーミングのバックフィル
検索可能な完全なデータベースの構築
データを保存する保存先が必要です
インデックス作成プロトコルと部分グラフ
契約ごとの履歴データ
インデックスに登録された内容に限定されます
サードパーティのデータAPI
分析・調査
ベンダーへの依存
ブロックエクスプローラーのAPI
クイック検索
厳格なレート制限と細かさの制限
Quicknode による履歴データへのアクセス方法 Quicknode すべてのプランでアーカイブノードへのアクセスが含まれており、アーカイブインフラの管理や別途の費用支払いが不要になります。すべてのQuicknode RPC エンドポイント は、ジェネシスブロックから最新ブロックに至るまで、任意のブロック高における過去の状態クエリに対応できます。Quicknode のQRouteテクノロジーは、過去の状態リクエストをアーカイブノードへ、現在の状態リクエストをフルノードへと自動的にルーティングし、設定不要で単一の エンドポイント URLを通じて提供され、設定は一切不要です。
履歴データベースの構築には、Quicknode Streams ワンクリックで利用できるバックフィルテンプレートを提供しており、20以上のネットワークにわたる完全なチェーン履歴をデータベースに取り込むことができます。チェーン、データセットの種類(ブロック、トランザクション、レシート、トレース、またはこれらを組み合わせたオールインワン)、および保存先(PostgreSQL、Snowflake、Amazon S3、Azure Storage、webhooks )を選択するだけで、Streams がデータの送信を行います。送信の確実性、正しいブロックの順序、および組み込みのリトライロジックが保証されています。 開始前にコストと所要時間の見積もりが表示されるため、完全な透明性が確保されます。バックフィル処理は、従来の RPC ベースのスクリプトに比べて最大 7 倍高速に同期され、完了後も、同じストリームをリアルタイムで継続してmode し、データベースを常に最新の状態に保つことができます。
参考資料
よくある質問
ブロックチェーン の過去のデータとは何ですか? ブロックチェーン の履歴データとは、ブロック、トランザクション、イベントログ、トレース、および特定のブロック高における状態(残高やコントラクトのストレージ)など、オンチェーン の過去の活動に関するあらゆる記録を指します。トランザクションデータはすべてのノードに永続的に保存されますが、履歴状態を保持するには、アーカイブノードまたは保存されたバックフィルが必要です。
古いブロックの場合、なぜ eth_getBalance が失敗するのですか? 標準的なフルノードは、おおよそ直近128ブロックより古い状態を削除するため、過去の`eth_getBalance`呼び出しを行うと、トライノードが見つからないというエラーが発生します。すべての状態スナップショットを保持しているアーカイブノードにクエリを実行すれば、このエラーは解消されます。
過去のデータにアクセスするには、アーカイブノードが必要ですか? 任意のブロック高における特定時点の状態を照会するには、アーカイブへのアクセス権が必要です。過去のトランザクションやイベントログのみが必要な場合は、フルノードから読み取るか、バックフィルを通じて独自のデータベースに保存することができます。
ブロックチェーン のデータバックフィルとは何ですか? バックフィルは、過去のブロックとそのデータセットの範囲を取得し、それらをデータベースや保存先へ読み込みます。プッシュ型のバックフィルは、順序付け、再試行、および確実な配信を処理し、処理が追いついた時点でリアルタイムストリーミングに切り替えることができます。
Ethereum のアーカイブノードには、どれくらいの容量が保存できますか? Ethereum のアーカイブノードには、およそ12TB以上が保存されていますが、フルノードの場合は約1TBです。この追加のストレージには、過去のすべての状態スナップショットが保存されているため、アーカイブインフラの運用コストは高くなります。
// Tags
ブロックチェーン の過去のデータ アーカイブデータ
// Publisher
Quicknode
2026年6月2日更新
2026年2月3日 — 読了時間10分