🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る ブロックチェーン のリアルタイムデータと履歴データの比較解説 |Quicknode
ニュースレターでは、無料のリソース、Quicknodeの最新情報、Web3に関するインサイトなどをお届けします。
CLI、Admin API 、MCP、SDK 、および75以上のチェーンに対応したAIネイティブツール。by 開発者 を構築し、開発者 向けに提供しています。
Python、Ruby、JavaScriptの最新コード例。スマートコントラクト、NFT、dAppsに関する詳細なガイド。
SOC 2 タイプ II 認証取得・ISO 27001
回答 > ブロックチェーン のデータストリーミングについて学ぶ > ブロックチェーン のリアルタイムデータと履歴データ ブロックチェーン のリアルタイムデータと過去データ
// Tags
ブロックチェーン のリアルタイムデータ ブロックチェーン の過去データ
要約: リアルタイムのブロックチェーン データとは、 チェーンの先端、最も最近生成されたブロック、および現在進行中のトランザクションからの情報を指します。ブロックチェーン の履歴データとは、ジェネシスブロックから直近の過去に至るまでの、それ以前のすべてのデータを指します。アプリケーションにはこの両方が必要です。リアルタイムデータはライブダッシュボード、トランザクション監視、即時通知を支え、一方、履歴データは分析、監査、データベースのバックフィル、モデルのトレーニングを支えます。インフラストラクチャ上の課題は、それぞれのデータタイプに効率的にアクセスするには異なるツールが必要となる点にあり、最適なアーキテクチャでは、これら両方を単一のパイプラインに統合します。
わかりやすい説明 ブロックチェーン は、絶えず成長し続ける台帳だと考えてください。どの瞬間においても、最新の記録は「先端」に書き込まれています。その背後にあるものはすべて過去の記録です。リアルタイムデータと履歴データの区別は、データそのもの(ブロックはブロックであり、トランザクションはトランザクションです)によるものではなく、アプリケーションがいつ、どのようにそのデータにアクセスする必要があるかという点によるものです。
リアルタイムデータとは、今まさに起きていることです。 新しいブロックが生成されたばかりです。トークンの送受信が完了したばかりです。スマートコントラクトのイベントが発生したばかりです。アプリケーションは、これらのイベントをできるだけ早く、理想的にはブロックが確定してから数秒以内に把握する必要があります。リアルタイムデータへのアクセスは、レイテンシーに敏感です。情報の価値は、遅延が1秒増えるごとに低下します。価格変動が発生してから30秒後にその情報を把握する取引 ボットは、2秒で把握するボットに比べて、著しく不利な立場に置かれます。
履歴データとは、すでに発生した事象を指します。ユーザー は、過去1年間の取引履歴をすべて確認したいと考えています。分析プラットフォームは、DEXの立ち上げ以来の総取引高を算出する必要があります。コンプライアンス担当のequipe は、過去6か月間の資金の流れを追跡する必要があります。履歴データへのアクセスは、スループットに左右されます。課題となるのは、1件のレコードをどれだけ速く取得できるかではなく、数千から数百万ブロックにまたがる数百万件、あるいは数十億件ものレコードを、いかに効率的に取得・処理・保存できるかということです。
さまざまなアクセスパターン
リアルタイムデータと履歴データのアクセスパターンは根本的に異なるため、通常、それぞれ異なるインフラストラクチャのアプローチが必要となります。
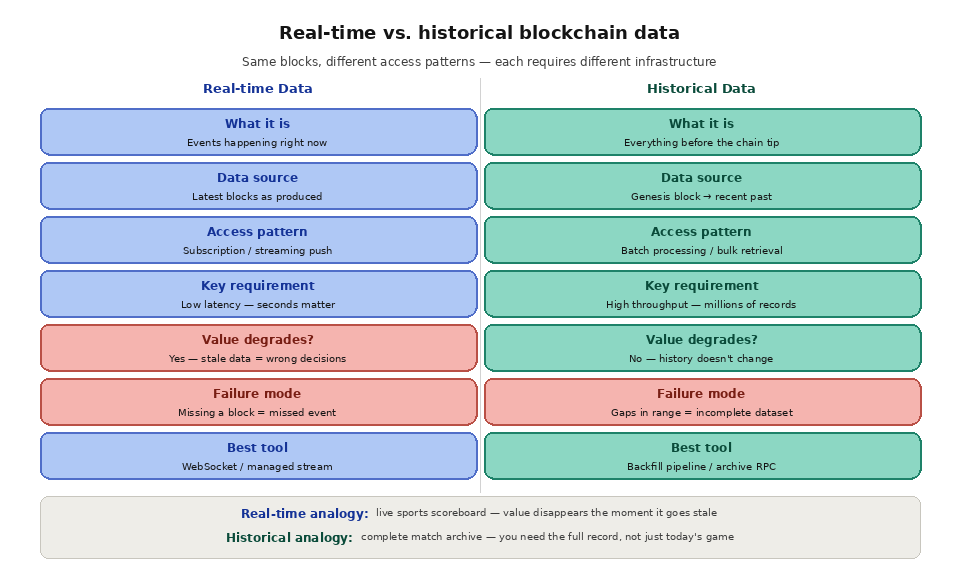
リアルタイムのデータアクセスは、サブスクリプション方式に従います。アプリケーションは、「新しいブロックが生成されたら通知してほしい」や「このコントラクトが Transfer イベントを発生させたら知らせてほしい」と指定します。データは、チェーンがブロックを生成した順序で、1ブロックずつ連続したストリームとして届きます。 アプリケーションは、各ブロックが到着するたびにそれを処理し、それに応じて状態を更新します。重要な要件は、低レイテンシ(ブロックの生成から配信までの遅延を最小限に抑えること)、信頼性 (ブロックを一切見逃さないこと)、および順序性(ブロックが欠落することなく正しい順序で到着すること)です。
履歴データへのアクセスは、バッチ処理のパターンに従います。アプリケーションは、「10,000,000 から 20,000,000 までのすべてのブロックを返してください」や、「デプロイ以降、USDC コントラクトからのすべての ERC-20 転送イベントを取得してください」といった要求を行います。 データは一括で到着し、その数は数百万件にも及ぶ可能性があります。アプリケーションは、データベースやデータウェアハウスに読み込む前に、このデータを大規模なバッチ単位で処理します。主な要件は、スループット(1秒あたりに可能な限り多くのブロックを処理すること)、完全性(ブロックの欠落やギャップがないこと)、およびコスト効率(テラバイト規模のデータを取得するために必要な演算リソースと帯域幅を最小限に抑えること)です。
こうした要件の違いがあるため、単一のアプローチで両方のニーズを十分に満たすことはほとんどありません。WebSocketによるサブスクリプションはリアルタイムデータには有効ですが、過去のデータを取得することはできません。順次RPCポーリングは技術的には過去のデータを取得できますが、大規模になると処理速度が著しく遅くなり、コストも高くなります。リアルタイムストリーミングと過去のデータのバックフィリングの両方を、同じインターフェースを通じて処理する専用データパイプラインを導入することで、このアーキテクチャ上の不整合を解決できます。
アプリケーションにその両方が必要な理由 実稼働中のブロックチェーン アプリケーションのほぼすべてにおいて、リアルタイムデータと履歴データの両方が必要とされ、多くの場合、それらは同時に必要となります。
ブロックチェーン のインデクサーは、初期データベースを構築するために履歴データが必要ですby 。これは、ジェネシス(またはコントラクトのデプロイメントブロック)から現在に至るまでのすべてのブロックを処理します。バックフィルが完了すると、データベースを最新の状態に保つためにリアルタイムデータが必要となりますby 。これは、新しいブロックが生成されるたびにそれを処理するものです。履歴データのバックフィルからリアルタイムストリーミングへの移行はシームレスでなければならず、最後に処理された履歴ブロックと最初に受信したリアルタイムブロックの間にギャップがあってはなりません。 ギャップが生じるとデータが欠落し、重複が生じるとデータが二重になります。
NFTマーケットプレイス では、各トークンの所有履歴、過去の売却価格、および来歴を表示するために、履歴データが必要です。また、新規出品が作成された瞬間にそれを表示したり、オークションに入札があった際に価格を更新したり、売買が完了した際に譲渡を確認したりするためには、リアルタイムデータも必要です。トレーダーは、評価には履歴データを、取引の実行にはリアルタイムデータを活用しています。
コンプライアンス監視システムは、不審な活動が検出された際に遡及的な調査を行うために、履歴データが必要です。また、不審なパターンを発生と同時に検知し、数日ではなく数分以内にアラートを発信するためには、リアルタイムデータも必要です。このシステムは、モードを切り替え、新しい活動をリアルタイムでストリーミングしながら、同時に数ヶ月分の履歴レコードを照会して背景情報を把握できる必要があります。
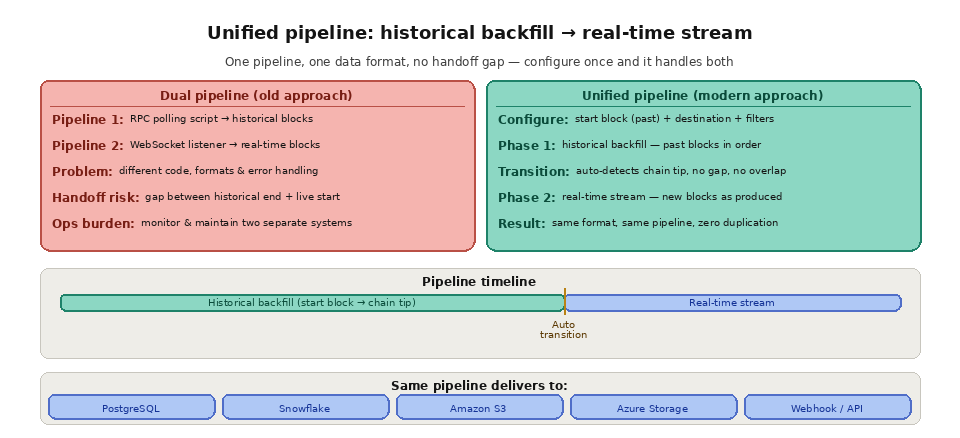
アーキテクチャ・チャレンジ これら2種類のデータを処理する従来のアプローチでは、2つの別々のシステムを構築する必要があります。1つは履歴データのバックフィル用パイプライン(通常はRPCを介してブロックを順次処理するスクリプト)、もう1つはリアルタイムリスナー(通常はWebSocketによるサブスクリプションまたはポーリングループ)です。このデュアルパイプラインアーキテクチャには、いくつかの問題があります。 2つのシステムは、異なるコード、異なるエラー処理、異なるデータ形式、そして異なる配信メカニズムを使用しています。履歴データからリアルタイムデータへの引き継ぎ時に、これらを同期させる作業はエラーが発生しやすくなります。また、2つの別々のパイプラインの保守と監視を行うことで、運用負担が倍増します。
単一のインターフェースを通じて履歴データとリアルタイムデータの両方を処理する統合データパイプラインにより、こうした問題は解消されます。開始ブロック(履歴データの場合は「過去」、リアルタイムデータのみの場合は「最新」)を指定して1つのパイプラインを設定するだけで、システムはその開始点以降からデータを配信し、チェーンの末端に追いついた時点で、履歴データのバックフィルからリアルタイムストリーミングへとシームレスに移行します。 データ形式も、配信メカニズムも、エラー処理も、監視もすべて同一です。パイプラインは、処理中のブロックが3年前に生成されたものであろうと、3秒前に生成されたものであろうと、区別しません。
ブロックチェーン のリアルタイムデータと履歴データにはどのような違いがありますか? データ自体は同じブロックとトランザクションですが、異なるのは、それを必要とするタイミングと取得方法です。リアルタイムデータは、サブスクリプションを通じてチェーンの先端から読み込まれるため、低遅延に最適化されています。一方、履歴データは過去のブロックから一括して読み込まれるため、スループットとコストに最適化されています。そのため、 ブロックチェーン のデータを 効率的にクエリするには 、通常、作業ごとに異なるツールを選択する必要があります。以下の表に、その違いをまとめました。
寸法
リアルタイムデータ
過去のデータ
定義
チェーンの先端と現在行われている取引
創世記からごく最近に至るまでのすべて
アクセスパターン
1ブロックずつ、定期購読
バッチ処理、一度に多数のブロックを処理
~に敏感な
レイテンシー
処理能力とコスト
代表的なツール
Streams または WebSocket サブスクリプション
バックフィル、アーカイブノード、インデクサ
能力
リアルタイムダッシュボード、アラート、監視
分析、監査、モデル学習
鮮度
生まれたばかり
数分から数年
ブロックチェーン の過去のデータには、どのようにアクセスすればよいですか? 過去データを読み取るには、一般的に3つの方法があります。1つ目は、アーカイブノードにクエリを実行する方法です。アーカイブノードは、すべてのブロック高における完全な状態を保持しており、過去の任意の時点に関するポイント検索に応答します。 また、ブロック範囲を順次処理して結果を一括でエクスポートする「バックフィル」を実行することも可能です。あるいは、データをすでに処理してクエリ可能なデータベースに格納済みのインデクサーを利用することもできます。それぞれ、セットアップの手間、速度、コストのトレードオフが異なり、適切な選択は、必要な履歴の量やアクセス頻度によって異なります。各オプションとそのトレードオフについて詳しく知りたい場合は、「 ブロックチェーン の履歴データへのアクセス 」を参照してください。
どのアプリケーションではリアルタイムデータが必要で、どのアプリケーションでは履歴データが必要なのでしょうか? ほとんどの本番アプリケーションではその両方が必要ですが、そのバランスはby のユースケースによって異なります。レイテンシに敏感な機能はリアルタイム寄りに、分析や監査機能は履歴データ寄りになります。以下の表では、一般的なワークロードとその主なデータ要件を対応付けています。また、ブロックチェーン のストリーミング・ユースケース では、さらに多くのパターンをご覧いただけます。
ユースケース
一次データの必要性
なぜ
取引 ボット
リアルタイム
価格変動に数秒以内に反応する
税務報告書または監査報告書
歴史的
活動履歴全体を復元します
ブロックチェーン インデクサー
両方とも
履歴を埋め戻し、その後streams で新しいブロックを作成
清算アラート
リアルタイム
ポジションが決済される前に必ず発注しなければならない
DEXの取引高分析
歴史的
過去の取引データを数百万件集計する
NFTの来歴
両方とも
所有履歴と現在の物件情報を表示します
リアルタイムデータと履歴データを1つのパイプラインで統合するにはどうすればよいでしょうか? 最も洗練されたアーキテクチャでは、過去を起点とする単一のパイプラインを構成し、順序通りに処理を進め、チェーンの末端に到達すると自動的に本番配信へと移行します。これにより、バックフィルスクリプトと別の本番リスナーとの間の脆弱な引き継ぎが排除されます。データの受信方法を検討している場合、ポーリングとストリーミングの どちらを選択するかが、その引き継ぎを独自に構築する難易度を大きく左右します。また、 Quicknode Streams のようなマネージドサービスを利用すれば、順序付け、データの欠落、再編成といった処理を自動的に代行してくれます。
よくある質問
リアルタイムデータは、過去のデータよりも価値が高いのでしょうか? どちらが絶対的に価値が高いというわけではなく、それぞれ異なる役割を果たしています。リアルタイムデータは、アラートや取引執行など、最新性が何よりも重要な機能を支える一方、履歴データは、分析や監査、そして過去の状況に基づく文脈が必要なあらゆる分析を支えます。本格的なアプリケーションのほとんどは、この両方を同時に活用しています。
ブロックチェーン の過去データを、どのくらいさかのぼって照会できますか? 適切なインフラさえ整っていれば、ジェネシスブロックまで遡ってデータを読み取ることができます。任意の過去のハイツにおけるフルステートを取得するには、プルーニングされたフルノードではなくアーカイブノードが必要となります。そのため、過去のデータへのアクセスを計画する際には、フルノードとアーカイブノード の違いが重要になります。
1つのパイプラインで、リアルタイムデータと履歴データの両方を処理することは可能ですか? はい。統合されたストリーミングパイプラインは、過去のブロックから開始し、過去分を遡って補完した後、ギャップや別のシステムを介することなく、リアルタイムデータへとシームレスに継続することができます。これが、ブロックチェーン のデータストリーミングの 根幹となる考え方であり、ブロックが古いものであれ新しいものであれ、順序付けられたデータを配信します。
過去のデータを補完する最も速い方法は何ですか? 逐次的なRPCスクリプトはシンプルですが、大規模になると処理が遅く、コストもかかります。一方、ブロック範囲を一括でデータベースやデータウェアハウスにエクスポートするように特別に設計されたバックフィルツールは、1回ごとのリクエスト処理ではなくスループットを重視して最適化されているため、通常ははるかに高速で低コストです。
過去のクエリを実行するには、インデクサーが必要ですか? 必ずしもそうとは限りません。たまに検索を行うだけなら、アーカイブノードやバックフィルで十分です。しかし、広範囲にわたる頻繁で複雑なクエリを実行する場合は、ブロックチェーン のインデックス機能によって データがクエリ可能なストアに前処理されるため、生のブロックから再計算されることなく、各クエリを高速に実行できます。
Quicknode がこれら両方をどのように処理するか Quicknode Streams ブロックチェーン のリアルタイムデータと履歴データの両方を統合したパイプラインを提供します。1つのストリームを、任意の履歴ブロックから開始して順次処理するように設定でき、データを確定順で宛先(PostgreSQL、Snowflake、Amazon S3、Azure Storage、webhooks など)に配信します。ストリームがチェーンの末端に到達すると、自動的にリアルタイムのmode に移行し、新しいブロックが生成されるたびに配信を継続します。 ギャップも、ハンドオフロジックも、維持管理が必要な 2 つ目のパイプラインも一切ありません。
リアルタイムのポイントクエリについては、QuicknodeのCore APIは 、すべてのプランにおいてアーカイブサポート へのグローバルに分散されたRPCアクセスを提供します。つまり、アプリケーションは単一の呼び出しを通じて、チェーンの現在の状態や、任意のブロック高における過去の状態をクエリできます エンドポイント1つの呼び出しを通じて、チェーンの現在の状態や任意のブロック高における過去の状態を照会できます。強化されたAPIメソッドは、一般的な多段階クエリを単一の呼び出しに集約し、リアルタイム読み取りのレイテンシを低減します。特に過去のデータのバックフィルに関しては、Quicknode は、20以上のチェーンにわたる事前設定済みのデータセットを備えたワンクリックのバックフィルテンプレート、透明性の高いコストおよび所要時間の見積もり、そしてRPCベースのスクリプトに比べて最大7倍高速な処理速度を提供します。
参考資料 // Tags
ブロックチェーン のリアルタイムデータ ブロックチェーン の過去データ
// Publisher
Quicknode
2026年6月2日更新
2026年4月1日 — 読了時間10分