ポーリングとストリーミングの解説:ブロックチェーン のデータアクセス |Quicknode🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る SOC 2 タイプ II 認証取得・ISO 27001
回答>ブロックチェーン のデータストリーミングについて学ぶ>ブロックチェーン データのポーリングとストリーミングの比較 ブロックチェーン データのポーリングとストリーミングの比較
// Tags
ポーリングとストリーミング WebSocketブロックチェーン
要約:ポーリングは、アプリケーションがブロックチェーン ノードに対して一定間隔で繰り返し新しいデータを問い合わせる「プル型」のパターンです。一方、ストリーミングは、新しいデータが生成されると自動的にアプリケーションに配信される「プッシュ型」のパターンですオンチェーン 。ポーリングは実装が簡単ですが、リソースを浪費し、遅延が生じ、データを見逃すリスクがあります。ストリーミングは、大規模な環境においてより効率的で高速、かつ信頼性が高いですが、異なるインフラストラクチャが必要となります。ほとんどの本番環境ブロックチェーン アプリケーションにおいて、データ取り込みにはストリーミングの方が優れたアプローチです。
わかりやすい説明
すべてのブロックチェーン アプリケーションは、何かが発生したタイミングを把握する必要がありますオンチェーン 。ウォレットは、ユーザー が送金を受け取ったタイミングを把握する必要があります。DeFiプロトコルは、価格オラクルが更新されたタイミングを検知する必要があります。取引 ボットは、新しいトランザクションがブロックに組み込まれた瞬間にそれを検知する必要があります。分析プラットフォームは、ブロックが生成されるたびにそれを処理する必要があります。問題は、アプリケーションがこれらのイベントをどのように把握するかということです。
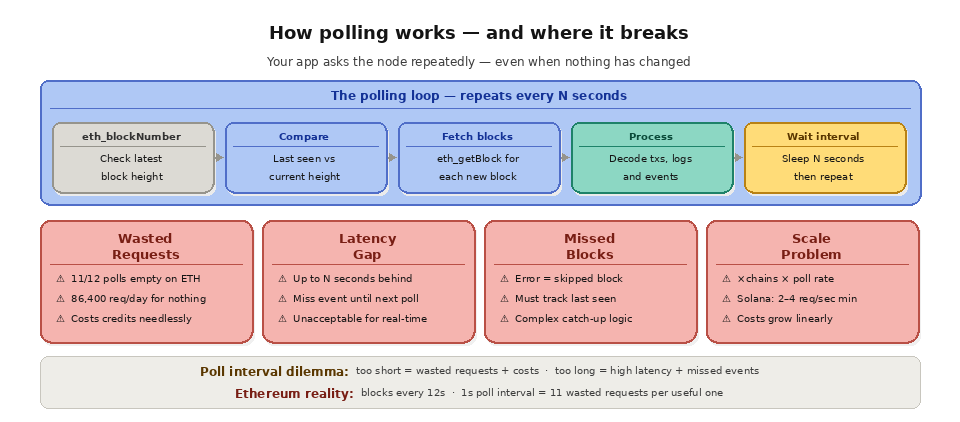
ポーリングでは、アプリケーションはループを実行します。RPCを呼び出し エンドポイントを呼び出し、何か新しいことが発生したかを確認し、新しいデータを処理し、一定時間待機し、これを繰り返します。これは、開発者 の多くが最初に学ぶパターンであり、HTTP APIの動作と自然に一致するからです。タイマーを設定し、N秒ごとにリクエストを行い、レスポンスを処理します。HTTPリクエストを行う機能以外、特別なインフラストラクチャは必要ありません。
ストリーミングでは、アプリケーションが一度接続を確立するか、データパイプラインを設定するだけで、新しいデータが自動的に届きます。ループもタイマーも、繰り返しリクエストも必要ありません。新しいブロックが生成されると、アプリケーションが要求しなくてもデータがアプリケーションに流れ込んできます。アプリケーションの役割は、届いたデータをそのまま処理することだけです。
世論調査の実際の仕組み
新しいブロックを監視するための典型的なポーリングの実装は、次のようなものです。アプリケーションは「eth_blockNumber」を呼び出して最新のブロックを取得し、それを最後に処理したブロックと比較します。その後、「eth_getBlockByNumber」を介して新しいブロックを取得し、必要なデータを抽出した上で、次のポーリングをスケジュールします。 各反復処理では、少なくとも1回のRPC呼び出し(最新のブロック番号を確認するため)が必要であり、場合によってはさらに多くの呼び出し(新しいブロックごとの完全なブロックデータ、トランザクションレシート、イベントログを取得するため)が必要になる可能性があります。
ポーリング間隔は、設計上極めて重要な決定事項です。ポーリングの頻度が高すぎると、答えが「ない」であるにもかかわらず、「何か新しいものはありますか?」と尋ねるRPCリクエスト(およびクレジット)を無駄にしてしまいます。Ethereum では、ブロックが12秒ごとに生成されるため、1秒ごとにポーリングを行うと、12回のリクエストのうち11回は有用な情報を得られないことになります。 逆に、ポーリング間隔が長すぎると、レイテンシが発生します。間隔を30秒に設定した場合、新しいブロックが生成されてから30秒経たないと、その存在に気づかない可能性があります。また、1回の間隔で複数のブロックを処理することになり、システムに不均一な負荷がかかる恐れもあります。
ポーリングには、信頼性 に関連するいくつかのリスクが伴います。ネットワークエラー、レート制限、またはノードの問題によりポーリングが失敗した場合、アプリケーションが最後に処理したブロック番号を追跡し、次回のポーリング成功時にその時点まで遡って処理を行わない限り、そのブロックを完全に見逃してしまう可能性があります。 アプリケーションがクラッシュしたり再起動したりした場合は、処理が中断した箇所を特定し、その時点から再開するとともに、ダウンタイム中に生成されたブロックを適切に処理する必要があります。処理の遅延によりポーリングワーカーが処理に遅れをとると、チェーンの先端とアプリケーションの状態との間にギャップが生じ、遅れを取り戻すには蓄積されたブロックの処理が必要となります。
スループットの高いチェーンでは、ポーリングが特に問題となります。Solana では400msごとにスロットが生成されます。Arbitrum およびBase では250msごとにブロックが生成されます。これらのチェーンをブロック生成レートに合わせてポーリングする場合、ブロック番号の確認だけで1秒あたり2~4回のRPCリクエストが必要となり、さらにブロックデータ全体の取得には追加のリクエストが必要となります。複数のチェーンにまたがる大規模な環境では、RPCリクエストの量(およびコスト)は、チェーンの数および各チェーンのブロック生成レートに比例して増加します。
ストリーミングの実際の仕組み
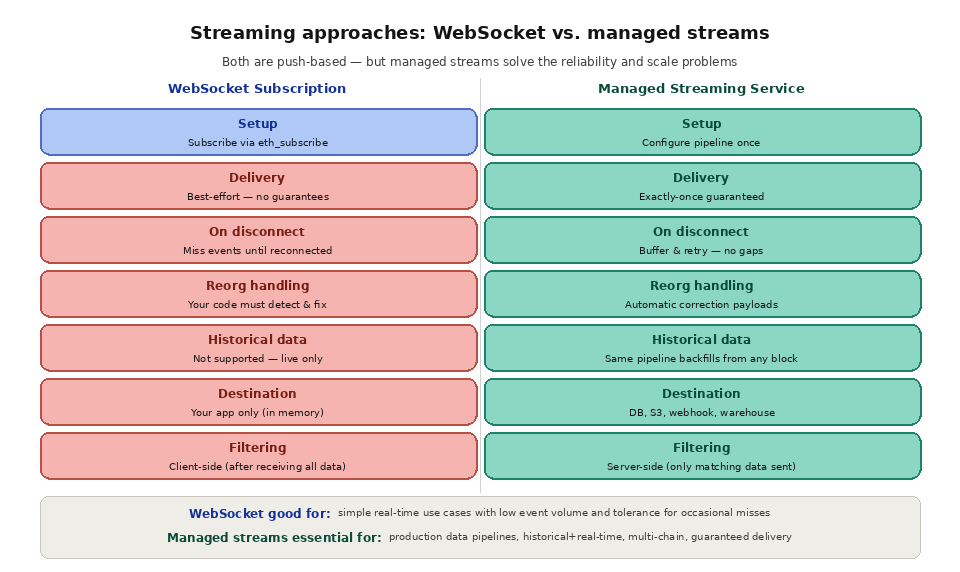
WebSocketによるサブスクリプションは、ブロックチェーン のストリーミング機能の中でも最もシンプルな形式です。アプリケーションはノードに対して永続的なWebSocket接続を確立し、サブスクリプションリクエスト(「eth_subscribe」に「newHeads」を指定したものなど)を送信します。ノードは、新しいブロックヘッダーが生成されるやいなや、そのヘッダーを開設された接続を介してアプリケーションにプッシュします。ポーリングも不要、無駄なリクエストもなく、レイテンシのギャップも生じません。
WebSocketは単純なユースケースではうまく機能しますが、大規模になると大きな制限があります。接続はステートフルであり、ネットワークの問題、サーバーの再起動、またはアイドルタイムアウトによって切断される可能性があります。接続が切断されると、アプリケーションは再接続までに発生したイベントをすべて見逃してしまうため、切断を検知し、再接続を行い、その間のデータを補完する必要があります。複数のチェーンにわたる複数の同時WebSocket接続を管理することは、複雑さを増します。 また、WebSocketのサブスクリプションでは、過去のデータをサポート できません。先週のブロックを処理する必要がある場合、WebSocketでは対応できません。
専用に設計されたストリーミングサービスは、こうした制限に対処します。アプリケーション側で不安定な WebSocket 接続を維持する代わりに、ストリーミングサービスがエンドツーエンドで管理するデータパイプラインを設定します。このサービスはブロックチェーン のノードに接続し、各ブロックを処理して、指定されたフィルタを適用し、配信を保証して結果を宛先に届けます。宛先が一時的に利用できない場合、サービスはデータをバッファに保存して再試行します。再編成が発生した場合は、サービスが修正ペイロードを送信します。 履歴データが必要な場合、同じパイプラインを使用して、任意の開始ブロックからバックフィルを行うことができます。
2つのアプローチの比較
レイテンシは、最も顕著な違いです。ポーリングの場合、最良のケースでもレイテンシはポーリング間隔と同じ長さになりますが、実際には処理時間やエラー回復に時間がかかるため、それよりも長くなります。一方、ストリーミングでは、データが利用可能になり次第、通常はブロックが生成されてから数秒以内にデータが配信されます。取引 ボットやリアルタイムダッシュボードなど、レイテンシに敏感なアプリケーションでは、ストリーミングの方が著しく高速です。
リソース効率は、2つ目の大きな違いです。ポーリングでは、新しいデータが存在するかどうかにかかわらず、ポーリングの頻度に応じたリクエスト数が発生します。1秒ごとに新しいブロックの有無を確認するポーリングワーカーは、たとえ週に1回しか発生しない特定のイベントのみに関心がある場合でも、1日あたり86,400件のリクエストを送信することになります。一方、ストリーミングでは、実際のデータ量に応じたリソースしか消費されません。フィルタ条件に一致するイベントが発生しなければ、データは配信されず、ユーザー側でリソースが消費されることもありません。
信頼性 大規模な環境では、この2つのアプローチには違いがあります。ポーリング方式では、アプリケーション側で状態の追跡、ギャップの検出、エラー回復、およびキャッチアップ処理のロジックを維持する必要があります。あらゆるエッジケース(ブロックの欠落、重複処理、再編成、レート制限、ノードのフェイルオーバーなど)を、コード内で処理しなければなりません。一方、ストリーミングサービスは、プロバイダー側でこれらのエッジケースを処理し、ギャップがなく、順序が保たれ、重複が除去されたフィードを提供するため、アプリケーションはインフラストラクチャを気にすることなく処理を行うことができます信頼性 。
複雑さがトレードオフとなります。ポーリングは、初期段階では実装が簡単です。 基本的なポーリングループは20行程度のコードで記述できます。しかし、その単純さは見かけ上のものに過ぎません。本番環境で安定して動作するポーリングには、エラー処理、バックオフロジック、状態管理、再編成の検出、監視などが必要となり、コード行数が数百行にまで膨れ上がる可能性があるからです。一方、ストリーミングでは、データパイプラインと、プッシュされたデータを受け取れる宛先システム(Webhookサーバーや、適切な取り込みロジックを備えたデータベースなど)を事前に設定する必要がありますが、一度設定すれば、その後のメンテナンスははるかに少なくて済みます。
ポーリングとストリーミングの違いは何ですか?
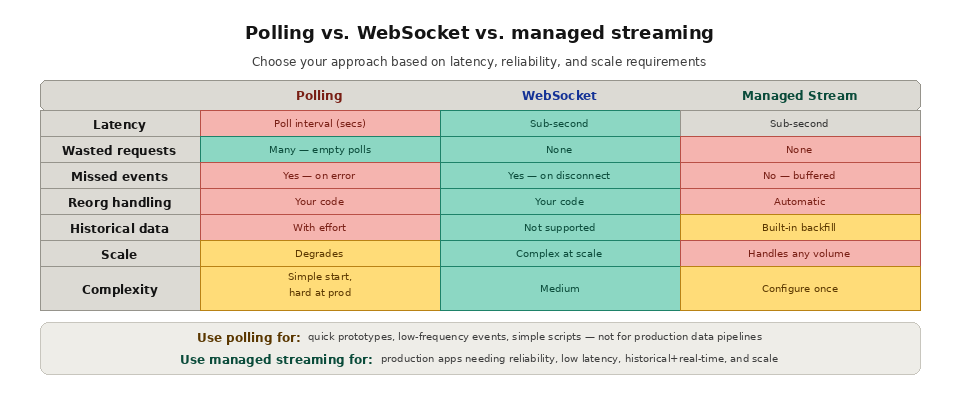
ポーリングとストリーミングは、アプリケーションに最新のオンチェーン データを取得するという同じ問題を解決しますが、制御の主体が逆転していますflow 。ポーリングでは、コード側が能動的な役割を担います。つまり、RPCエンドポイント を繰り返し呼び出し、何か変更があったかどうかを問い合わせます。一方、ストリーミングでは、プロバイダー側が能動的な役割を担い、新しいブロックや一致するイベントが生成された瞬間に、それらをアプリケーションにプッシュします。以下の表では、本番環境で最も重要な観点から、これら2つのパターンを比較しています。
寸法 | 世論調査 | ストリーミング |
|---|
データflow | プル型で、アプリがデータをリクエストします | プッシュ型で、データが自動的に配信されます |
レイテンシー | 調査間隔と同じかそれ以上 | ブロックの製造開始から数秒以内に |
リソースの使用状況 | アイドル状態であっても、ポーリングの頻度に比例して | 実際のデータ量に比例して |
信頼性 大規模に | このアプリは、ギャップ、再試行、再編成に対応しています | プロバイダーは、整理され、重複が除去されたフィードを提供します |
過去のデータ | by が過去のブロックの再クエリに対応しました | by のサポート:同じパイプラインへのバックフィリング |
セットアップの複雑さ | 導入は簡単だが、セキュリティ強化にはコストがかかる | 一度設定すれば、その後のメンテナンスの手間が少なくて済みます |
こんな方に最適 | 簡単なスクリプトと低頻度のチェック | リアルタイムアプリ およびハイスループットチェーン |
ポーリング間隔はどのように決めるのですか?
ポーリングを行う場合、その間隔は読み取るチェーンのブロック生成間隔に合わせて設定する必要があります。ブロック生成間隔よりもはるかに短い間隔でポーリングを行うと、リクエストが無駄になり、レート制限が適用される可能性があります。一方、ブロック生成間隔よりもはるかに長い間隔でポーリングを行うと、回避可能な遅延が発生し、ワーカーが一度に複数のブロックを処理せざるを得なくなります。以下の表には、各ネットワークにおける一般的なブロック生成間隔と、それによるポーリングの実務上の影響がまとめられています。
ブロックチェーン | おおよそのブロック時間 | 世論調査が示唆すること |
|---|
Bitcoin | 約10分 | 1~2分間隔で十分すぎるほどです |
Ethereum | 約12秒 | 4~12秒ごとにポーリングを行い、無駄なく最新の状態を維持する |
BNB Smart Chain | 約3秒 | サブブロックポーリングは、メリットがほとんどないにもかかわらず負荷を増大させる |
Base | 約250ミリ秒 | ポーリングではスムーズに処理しきれない;ストリーミングの方が望ましい |
Solana | 約400ミリ秒 | リクエスト数が多いため、ストリーミングでの配信を強く推奨します |
どのような場合に、依然としてポーリングを使用すべきでしょうか?
ストリーミングは、ほとんどの本番ワークロードにおいてより適切なデフォルトの設定ですが、一部のケースではポーリングも妥当な選択肢となります。 1回限りのスクリプト、バックフィル、および頻度の低いバッチジョブでは、マネージドパイプラインを導入する正当な理由となることはほとんどありません。また、ユーザー アクションの実行前の残高確認など、オンデマンドで単一の値のみが必要な場合で、継続的に配信されるデータストリームがない場合にも、ポーリングは適しています。ただし、データの鮮度や量が重要となる場合、トレードオフは急速に変化するため、アプローチを決定する前に、リアルタイムデータと履歴データの違いを理解しておくことが役立ちます。
ストリーミングでは、再編成やデータの損失にどのように対処するのでしょうか?
ブロックチェーン のライブデータを取得する上で最も難しいのは、正常な処理の流れではなく、エッジケースです。チェーンの再編成により、アプリケーションがすでに処理済みのブロックが置き換わったり、接続が切断されたことでデータに欠落が生じたりする可能性があります。生のポーリングやWebSocketsを使用する場合、こうした状況を自ら検出して修復する必要があります。一方、 Quicknode Streams のようなマネージドサービスは、これらの処理を代行してくれます。データはファイナリティ順に配信され、再編成が発生した際には修正ペイロードを送信し、宛先が利用できない場合はバッファリングと再試行を行います。この違いこそが、プッシュ型配信を大規模な運用において格段に容易にしているのです。
よくある質問
ストリーミングは、世論調査よりも常に優れているのでしょうか?
必ずしもそうとは限りません。継続的かつ低遅延のデータが必要なほとんどの生産環境では、ストリーミングの方が効率性と信頼性 の点で優れています。しかし、1回限りのスクリプト、単純な残高確認、あるいは実行頻度の低いジョブについては、ポーリングでも十分であり、設定も簡単です。どちらを選ぶべきかは、データの鮮度や処理するデータ量によって異なります。プッシュ型モデルの概要については、「ブロックチェーン データストリーミングとは」をご覧ください。
RPCのポーリングはどのくらいの頻度で行うべきですか エンドポイント?
ポーリング間隔をチェーンのブロック生成間隔に合わせて設定してください。Ethereum では、4~12秒ごとにポーリングを行うことで、呼び出しを無駄にすることなく最新の状態を維持できます。Solana やBase のような高速なチェーンでは、ブロック生成間隔でのポーリングは現実的ではなく、ストリーミングの方が適しています。ブロックが生成される速度よりもはるかに速い頻度でポーリングを行っても、ほとんどの場合、新しいデータは返されず、リクエストの割り当てを無駄に消費するだけです。各呼び出しで何が行われるかについては、「RPCリクエストの仕組み」を参照してください。
ポーリングはストリーミングよりもコストがかかるのでしょうか?
大規模な環境では、往々にしてそうなります。ポーリングは、新しいデータの有無にかかわらず、決まったスケジュールでリクエストを生成するため、負荷の高いポーリングワーカーは、ほんの数件のイベントを取得するために1日に数万回もの呼び出しを行うことになります。一方、ストリーミングは、実際にフィルタに一致するデータ量に応じてリソースを消費するため、通常、無駄なリクエストが減り、継続的なワークロードのコストを削減できます。
リオーガナイゼーション中は、私のデータはどうなるのでしょうか?
単純なポーリングや生のWebSocketsを使用している場合、リオーガナイゼーションが発生すると、アプリケーションが、正規チェーン上ではもはや存在しないトランザクションを保持したままになってしまう可能性があります。管理型のストリーミングサービスは、リオーガナイゼーションを検知して修正ペイロードを送信するため、状態の一貫性が保たれます。また、スループットとレイテンシの違いを理解しておくことで、データを確定済みとみなすまでの待機時間を適切に判断する上でも役立ちます。
ストリーミングサービスから過去のデータを取得することはできますか?
はい。接続した時点以降の新しいイベントのみを配信するWebSocketのサブスクリプションとは異なり、フルストリーミングパイプラインでは、同じ設定を使用して過去の任意の時点からデータを遡って取得することができます。これにより、2つの別々のシステムを稼働させることなく、履歴データを再生した後、ライブデータへシームレスに移行することが可能です。
Quicknode が両方のパターンをどのようにサポートしているか
QuicknodeのCore APIは、サポートされているすべてのチェーンにおいて、HTTP RPCエンドポイントによるポーリングと、WebSocket接続によるリアルタイムサブスクリプションの両方をサポートしています。ポーリングを利用するアプリケーションについては、『Quicknode 』の「効率的なRPCリクエスト」ガイドで、無駄な呼び出しを最小限に抑える方法、適切なエラー処理の実装、レート制限の管理に関するベストプラクティスが解説されています。
ポーリングの枠を超えて進化する準備が整ったアプリケーション向けに、Quicknode (Streams )は、フルマネージドのストリーミングパイプラインを提供します。Streams は、配信保証、ファイナリティ順の処理、自動再編成処理、サーバーサイドフィルタリングを備えたリアルタイムのブロックチェーン データを提供します。これらすべてを、アプリケーション側でWebSocket接続やポーリングインフラを維持する必要なく実現します。Streams は、webhooks 、PostgreSQL、Snowflake、Amazon S3、Azure Storageなどへの配信をサポートしており、あらゆるバックエンドアーキテクチャに適応可能です。 WebSocketサブスクリプションとStreams の直接比較ガイドは、Quicknode のドキュメントで公開されており、ポーリングやWebSocketベースのアーキテクチャから移行する際のトレードオフや移行パスについて解説しています。チーム
参考資料