要約: ブロックチェーン データストリーミングは、 ブロックチェーン のデータにアクセスするためのプッシュ型のアプローチであり、新しいブロック、トランザクション、イベントが生成されると同時に、アプリケーションやデータベースに自動的に配信されますオンチェーン 。アプリケーションがノードに対して「何か新しい情報はありますか?」と繰り返し問い合わせる(ポーリング)代わりに、ストリーミングサービスがデータが利用可能になった瞬間にそれを送信します。ストリーミングにより、レイテンシが低減され、イベントの取りこぼしがなくなり、バックエンドアーキテクチャが簡素化され、従来のリクエスト・レスポンス型パターンよりもはるかに効率的にスケーリングできます。
わかりやすい説明
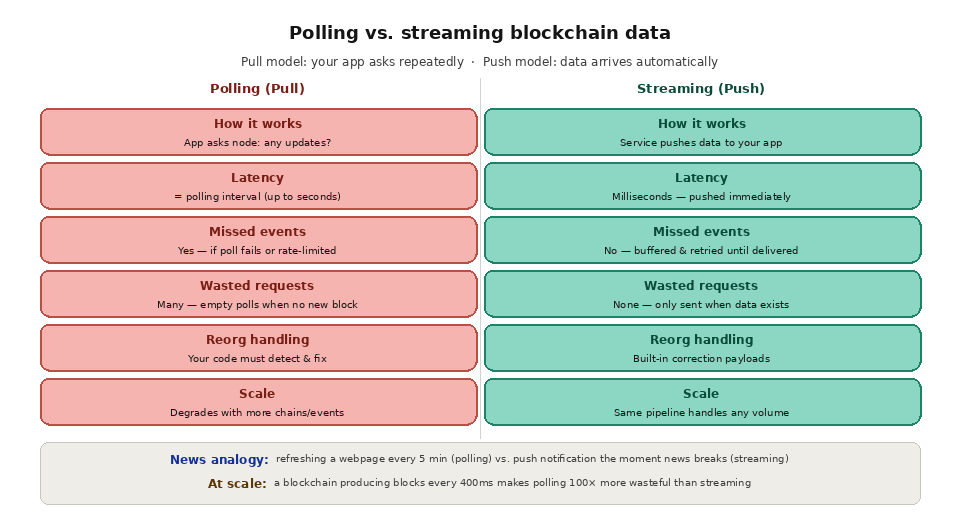
システムからデータを取得するには、基本的に2つの方法があります。データを要求する(プル)方法と、データが送信されてくる(プッシュ)方法です。ブロックチェーン の歴史の大部分において、開発者 はプルモデルを採用してきました。アプリケーションがノードにRPCリクエストを送信すると、ノードから応答が返され、アプリケーションが次にリクエストを送信するタイミングを決定します。これがポーリングパターンです。実装は簡単ですが、特にアプリケーションがブロックチェーン の最新状態と同期を維持する必要がある場合、非効率的です。
ストリーミングはこのモデルを逆転させます。アプリケーションが1日に何千回も「最新のブロックで何が起きたか」と問い合わせる代わりに、データパイプラインを一度設定するだけで、ストリーミングサービスが新しいブロックが生成されるたびに、そのデータをアプリケーションやデータベースに配信します。これにより、アプリケーションは個別のデータスナップショットを要求する存在から、継続的なデータフィードの消費者へと変わります。
この例えは、ニュースサイトを5分おきに更新し続けることと、story が配信された瞬間に通知が届くプッシュ通知を購読することの違いに例えられます。どちらも最終的には同じ情報を得られますが、プッシュ通知の方が速く、無駄が少なく、信頼性が高いのです。
ブロックチェーン のデータストリーミングの仕組み
ストリーミングサービスは、ブロックチェーン ノードと、お客様のアプリケーションまたはデータインフラストラクチャとの間に位置します。取り込み側では、このサービスはサポート対象のネットワーク上のノードに接続し、新しいブロックがファイナライズされるたびにそれを処理します。サービスは、ヘッダー、トランザクション、トランザクションレシート(イベントログを含む)、およびオプションで実行トレースを含む、生のブロックデータを抽出します。この生データは、そのブロック内で発生したすべての事象の完全な記録となります。
処理の面では、ストリーミングサービスはユーザーが設定したフィルタや変換を適用します。たとえば、特定の契約群からのERC-20転送イベントのみに関心がある場合を考えてみましょう。JavaScriptやその他のサポートされている言語で記述されたフィルタが各ブロックのデータに対して実行され、条件に一致するレコードのみを通過させます。このサーバーサイドでのフィルタリングは、ブロック全体ではなく、実際に必要なデータのみを宛先が受信・保存することになるため、効率性の観点から極めて重要です。
配信側では、フィルタリングされたデータが、設定された送信先に送信されます。送信先としては、アプリケーションがリクエストを待機している Webhook URL、PostgreSQL データベース、Snowflake データウェアハウス、Amazon S3 バケット、Azure Blob Storage、またはその他のサポートされている エンドポイントなどです。ストリーミングサービスは、失敗時の再試行、重複排除、正しい順序の保証といった配信保証を処理するため、送信先はブロックチェーン データを途切れることなく順次受信できます。
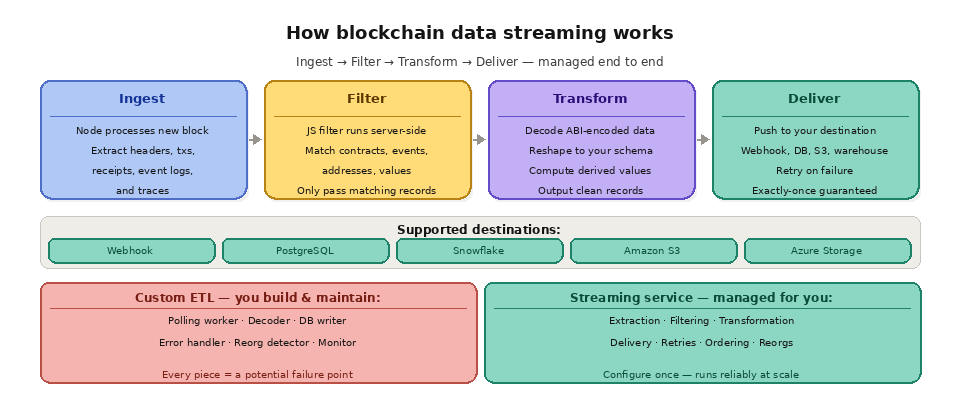
ストリーミングと従来のETLアプローチの比較
従来のブロックチェーン のETL(抽出、変換、ロード)パイプラインでは、大規模なインフラストラクチャを構築・維持するために開発者 が必要となります。 典型的なカスタムETL構成には、スケジュールに従ってRPCエンドポイントを呼び出して新しいブロックを取得するポーリングワーカー、生データをデコードおよび変換する処理層、レコードを挿入するデータベースライター、再試行や障害を管理するエラーハンドラー、放棄されたフォークを識別してデータをロールバックする再編成検出器、そしてこれらのコンポーネントのいずれかに障害が発生した際にアラートを発する監視機能が含まれます。それぞれの要素が複雑さを増し、それぞれが潜在的な障害点となります。
ストリーミングサービスは、これらすべてを単一の管理対象パイプラインに統合します。データの抽出、フィルタリング、変換、配信、再試行ロジック、順序付け、および再編成の処理はすべて、プロバイダーのインフラストラクチャ上で行われます。ユーザーが担当するのは、必要なデータ、送信先、およびデータの整形方法を設定することだけです。これにより、ブロックチェーン のデータインフラストラクチャを構築・維持するために必要なエンジニアリングの労力が大幅に削減されます。
パフォーマンスの差も甚大です。ポーリングベースのパイプラインでは、その性質上、ポーリング間隔に等しいレイテンシが発生します。ワーカーが5秒ごとに新しいブロックの有無を確認する場合、すべてが完璧に動作していても、チェーンの先端から最大5秒遅れてしまう可能性があります。エラー、レート制限、またはワーカーの再起動によるポーリングの失敗は、この遅れをさらに拡大させます。 ストリーミングでは、データが利用可能になり次第プッシュされるため、ポーリングによるレイテンシが排除されます。数百ミリ秒ごとにブロックが生成される高スループットのチェーンでは、レイテンシに敏感なアプリケーションにとって、この違いは大きな意味を持ちます。
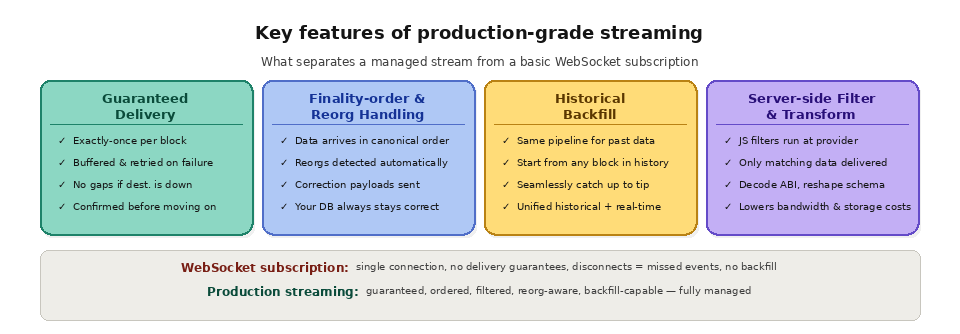
プロダクション・ストリーミングの主な特徴
本番環境向けのストリーミングには、単純なWebSocketサブスクリプションとは異なるいくつかの特徴があります。配信保証機能により、たとえ接続が一時的に切断されたり、送信先で一時的な障害が発生したりした場合でも、各ブロックのデータが確実に1回だけ送信先に到達することが保証されます。ストリーミングサービスは、配信が確認されるまでデータをバッファに保持し、再送信を繰り返すため、データに欠落が生じることはありません。
「ファイナリティ順の配信」とは、データがブロックチェーン が正規とみなす順序で到着することを意味します。ファイナリティ時間が変動するチェーンでは、ストリーミングサービスはブロックが十分に確認されるまで配信を待機します。これにより、リオーガナイゼーションby によって後で無効化される可能性のあるデータをアプリケーションが処理してしまうのを防ぎます。リオーガナイゼーションが発生した場合、サービスはフォークを検出し、どのブロックがもはや正規ではないかを特定し、修正ペイロードを送信することで、宛先がそれに応じて更新できるようにします。
履歴データのバックフィル機能により、新しいブロックだけでなく、過去のデータに対しても同じストリーミングパイプラインを使用できます。履歴データ用に別のETLプロセスを構築し、リアルタイムデータ用に別のプロセスを構築する代わりに、過去のブロックを起点とする単一のストリームを設定し、履歴を遡って処理を進め、チェーンの先端に追いついた時点でシームレスにリアルタイム処理へ移行させます。この統合されたパイプラインにより、アーキテクチャが簡素化され、履歴データとリアルタイムデータ間の一貫性が確保されます。
サーバーサイドでのフィルタリングと変換により、宛先に届くデータ量が削減され、帯域幅コスト、ストレージコスト、および処理オーバーヘッドが低減されます。フィルタは、アドレス、イベントシグネチャ、関数セレクタ、トランザクション値、あるいはブロックデータのその他の任意のプロパティに基づいて照合を行うことができます。変換処理では、ペイロードの再構成、ABIエンコードされたデータのデコード、派生値の算出、およびデータベーステーブルに一致するスキーマでのレコード出力を行うことができます。
Quicknode (Streams )によるブロックチェーン データストリーミングの実現方法
Quicknode Streams ブロックチェーン 専用のデータストリーミングおよびETLサービスであり、80以上のブロックチェーンにわたるリアルタイムデータおよび履歴データを、組み込みのフィルタリング、変換、および配信保証機能とともに提供します。Streams は、複数のデータセットタイプ(ブロック、トランザクション、レシート、イベントログ、トレース)および複数の出力先(webhooks 、PostgreSQL、Snowflake、Amazon S3、Azure Storageなど)に対応しています。
Streams データはファイナリティ順に処理され、正確に1回のみの配信が保証されます。また、チェーンの再編成を自動的に処理し(by )、修正ペイロードを送信するとともに、履歴データのバックフィル処理中に最適なスループットを実現するための、設定可能なバッチ処理および圧縮をサポートしています。JavaScriptフィルターはQuicknode のインフラストラクチャ上で実行され、データが宛先に到達する前に、イベントのデコード、パターンの照合、外部キーバリューストアへの参照、出力ペイロードの整形を行うことができます。 ワンクリックのバックフィルテンプレートは、20以上のチェーンにわたる一般的なデータセット向けに事前設定済みのパイプラインを提供し、開始前にコストと完了時間の見積もりが透明性を持って表示されます。
さらに高度なワークフローを実現するため、Streams はQuicknode Functionsと連携し、ストリーミングデータを活用したサーバーレスな自動化を可能にします。Functionsでは、ストリーミングイベントに応じて、オンチェーン の追加データでレコードを充実させたり、外部APIを呼び出したり、通知をトリガーしたり、任意のビジネスロジックを実行したりすることができます。Streams とFunctionsを組み合わせることで、完全なブロックチェーン データプラットフォームが提供され、カスタムETLインフラストラクチャを、管理されたスケーラブルなソリューションに置き換えることができます。
ストリーミングとポーリングの違いは何ですか?
ポーリングとストリーミングは、アプリケーションがオンチェーン のアクティビティを把握するための2つの方法であり、これらは対極に位置しています。ポーリングはプル型であり、アプリケーションがノードに対して新しいデータが存在するかどうかを繰り返し問い合わせます。一方、ストリーミングはプッシュ型であり、サービスが新しいデータが利用可能になった瞬間にそれを配信します。以下の表では、アプローチを選択する際に最も重要な観点から、これら2つを比較しています。
寸法 | 世論調査 | ストリーミング |
|---|---|---|
データflow | アプリケーションはスケジュールに従ってデータを取得します | データが生成されるたびにサービスがプッシュされる |
レイテンシー | by をポーリング間隔とする | Near リアルタイム、遅延なし |
データの欠落によるリスク | 投票が失敗したりスキップされたりした場合の空白 | 確実で、途切れることのない配送 |
これら2つの配信モデルをより詳細に比較し、それぞれがどのような場合に適しているかについては、「ポーリングとストリーミング」をご覧ください。
ブロックチェーン のデータストリーミングには、どのような一般的なユースケースがありますか?
ストリーミングは、オンチェーン のアクティビティに迅速に対応する必要がある、あるいはデータベースを常に同期状態に保つ必要があるあらゆるワークロードに適しています。代表的な例としては、リアルタイムのウォレットおよびポートフォリオの追跡、DeFiダッシュボード、取引 や清算ボット、NFTのミントおよび販売のモニタリング、不正やコンプライアンスに関するアラート、そしてすべてのブロックを取り込むアナリティクスウェアハウスなどが挙げられます。これらはいずれも、定期的なスナップショットではなく、低遅延かつ途切れることのないデータ配信の恩恵を受けています。パターンのより詳細な一覧については、ブロックチェーン のストリーミング活用事例をご覧ください。
ストリーミングでは、リアルタイムデータと履歴データはどのように扱われるのでしょうか?
優れたストリーミングパイプラインは、リアルタイムデータと履歴データを、2つの別々のシステムとしてではなく、1つの連続したタイムラインとして扱います。 過去の遠い時点のブロックからストリームを開始し、履歴を遡ってバックフィルを行い、チェーンの先端に追いついたらライブブロックへとシームレスに移行することができます。これにより、2つの異なるコードパスを持つ2つのパイプラインを維持する必要がなくなります。最新データとアーカイブデータのトレードオフについては、「リアルタイムデータと履歴データ(ブロックチェーン )」を参照し、バックフィル戦略については「履歴データへのアクセス方法(ブロックチェーン )」を参照してください。
ストリーミングはチェーンの再編成にどのように対処するのでしょうか?
再編成(Reorg)は、ブロックチェーン のライブデータを取得する上で最も難しい部分です。なぜなら、アプリケーションがすでに処理したブロックが、競合するブロックに置き換えられる可能性があるからです(by )。本番環境のストリーミングサービスは、この問題をby で処理し、データを確定順で配信するとともに、再編成が発生した際には、どのブロックがもはや正規のものではなくなったかを宛先に通知する修正ペイロードを送信し、影響を受けたレコードをロールバックできるようにします。これにより、カスタムパイプラインにおいて最もエラーが発生しやすい要素の1つが排除されます。詳細については、「ブロックチェーン の再編成とは」をご覧ください。
ストリーミングとインデックス作成の違いは何ですか?
ストリーミングとインデックス作成は、関連してはいるものの、それぞれ異なる問題を解決します。ストリーミングは配信に関するもので、オンチェーン のデータを発生と同時に宛先へ届けることを指します。一方、インデックス作成は整理に関するもので、そのデータをクエリ可能なデータベースとして構造化し、過去のデータや集計データに対する高速なクエリを実行できるようにするものです。多くのチーム では、ストリーミングを利用してインデックスにデータを格納し、そのインデックスに対してクエリを実行して分析を行っています。各要素がどのように連携しているかについては、「ブロックチェーン のインデックス作成とは」および「 ブロックチェーン データのクエリ」をご覧ください。
よくある質問
ブロックチェーン のデータストリーミングは、WebSocketのサブスクリプションと同じものですか?
そうとは限りません。WebSocketのサブスクリプションは、ソケットが開いている間、イベントをプッシュする低レベルの接続ですが、配信の保証はなく、接続が切断されると停止します。本番環境向けのストリーミングでは、この基本的なプッシュモデルに加え、正確に1回のみの配信、最終性順序、再編成による修正、サーバーサイドのフィルタリング、および履歴のバックフィル機能が提供されます。
ストリーミングを利用すれば、ブロックを見逃すことはないのでしょうか?
はい、本番サービスであれば可能です。「配信保証」とは、各ブロックのデータが受信先で確認されるまで、プロバイダーがバッファリングを行い、再送信を繰り返すことを意味します。そのため、たとえ エンドポイント 一時的なサービス停止が発生しても、途切れることのない配信が実現されます。 Quicknode Webhooks のようなプッシュ型イベントサービスは、イベント通知に対しても信頼性 の原則を同様に適用しています。
ストリーミングデータを宛先に届く前にフィルタリングすることはできますか?
はい。サーバーサイドのフィルタリングでは、アドレス、イベントシグネチャ、関数セレクタ、値、あるいはブロックのその他のプロパティに基づいて照合を行うことができるため、必要なレコードのみが配信されます。これにより、不要なデータを受け取ることがないため、帯域幅、ストレージ、および処理コストを削減できます。
ストリーミングは、カスタムETLパイプラインに取って代わることができるでしょうか?
ほとんどのチーム については、その通りです。マネージド・ストリーミング・サービスは、抽出、フィルタリング、変換、配信、再試行、順序付け、再編成処理を1つのパイプラインに統合し、自社開発のETLスタックに存在する多くの複雑な要素を排除します。ユーザーは、どのデータをどこに送信するかを設定するだけで、残りの処理はプロバイダーが担当します。
ストリーミングデータは、どの宛先に配信できますか?
一般的な送信先としては、Webhook URL、PostgreSQL、Snowflake、Amazon S3、Azure Blob Storageなどが挙げられます。これにより、それぞれにカスタムコネクタを構築することなく、ストリーミングデータをアプリケーションのバックエンド、データウェアハウス、またはオブジェクトストレージに直接取り込むことができます。
参考資料
Streams の始め方 - Quicknode Docs
コスト削減とブロックチェーン データパイプラインの簡素化-Quicknode ブログ
ストリーミングインデックスデータで製品開発を加速-Quicknode ブログ
Quicknode Streams
