要約: ブロックチェーン は、データの取得ではなく、セキュリティと不変性のために最適化されています。組み込みの検索機能も、SQLクエリも、インデックスも存在せず、標準的なRPCメソッドを使用してブロック間でデータをフィルタリングしたり集計したりする方法もありません。「このウォレットからのすべての送金を表示する」といった単純なクエリでさえ、数百万のブロックを順次スキャンする必要があります。 さらに、チェーンの再編成、さまざまなファイナリティモデル、エンコードされたデータ形式、そして膨大なデータ量を考慮すると、ブロックチェーン でのデータアクセスがなぜ大きな技術的課題となっているのかが明らかになります。
わかりやすい説明
従来のデータベースを使ったことがある方なら、データに対してクエリを実行するのがいかに簡単かご存じでしょう。たった1つのSQLクエリで、過去30日間のすべての注文を、by 顧客ごとにグループ化し、by 合計金額で並べ替え、$100以上の金額に限定して抽出することができます。リレーショナルデータベースは、柔軟かつ効率的なクエリ実行を前提に一から設計されているため、データベースエンジンが重い処理を代行してくれます。インデックスの管理、サポート 結合の実行、集計機能の提供、そしてクエリ実行計画の自動最適化を自動的に行います。
ブロックチェーン は、まったく逆の目的のために設計されています。その主な役割は、何千もの独立したノードが検証し、合意できる、改ざん不可能な分散型台帳に取引を記録することです。ブロックチェーン のアーキテクチャにおけるあらゆる設計上の決定は、コンセンサス、セキュリティ、不変性を最優先としています。データの取得は、せいぜい後付けの考慮事項に過ぎません。その結果、本来の目的においては非常に強力なデータ構造となっていますが、単純なポイント検索以外のクエリを行う際には、扱いにくいものとなっています。
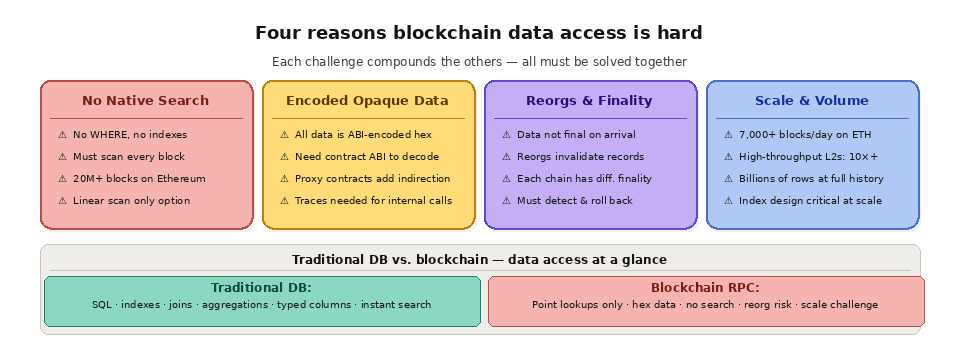
ネイティブの検索機能やフィルタ機能なし
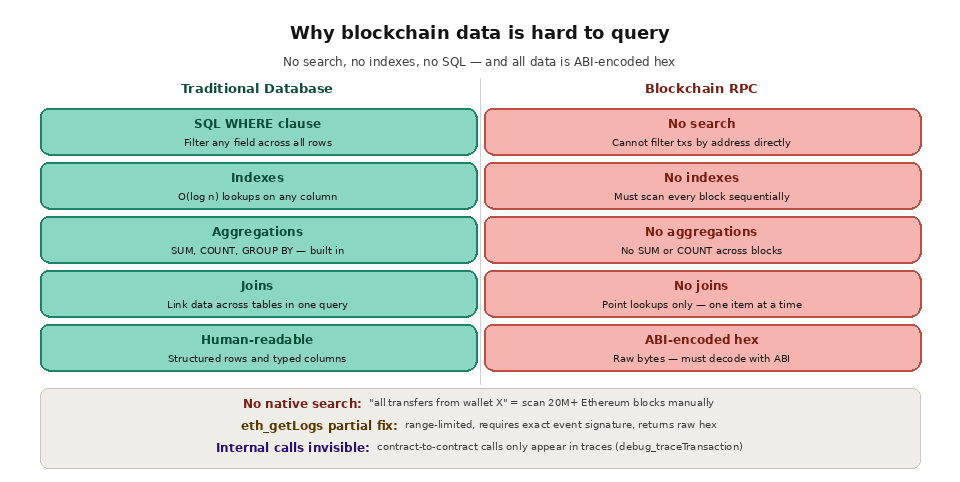
最も根本的な課題は、ブロックチェーン に検索機能がないことです。「find」コマンドは存在しません。SQLのWHERE句に相当する機能もありません。RPCインターフェースでは、ブロックby 番号の取得、トランザクションby ハッシュの取得、特定のブロックにおけるアカウントの残高の取得など、ごく少数の低レベルなメソッドが提供されています。これらはすべて、検索対象を事前に正確に把握している必要がある、特定の項目を検索するだけの機能です。
特定のウォレットアドレスからのすべての取引を検索したい場合、ブロックチェーン にこの質問を直接投げかけることはできません。ジェネシスブロックから開始し、すべてのブロックを順番に取得し、各ブロックからすべての取引を抽出し、各取引の「from」および「to」フィールドを確認して、一致するものを収集する必要があります。Ethereum では、これは2,000万を超えるブロックを順に処理することを意味し、各ブロックには0件から数百件の取引が含まれています。Solana では、その数字はさらに桁違いで、チェーンの履歴には数十億ものスロットとトランザクションが存在します。あらかじめ構築されたインデックスがない場合、この線形スキャンこそが、この質問に答える唯一の方法です。
「eth_getLogs」メソッドは、by にあるように、by 契約アドレスとトピックでフィルタリングされたブロック範囲内のイベントログを照会できる部分的な解決策を提供しています。 しかし、このメソッドには厳しいブロック範囲の制限があり(通常、1回のリクエストあたり数千ブロック程度)、検索対象のイベントシグネチャを正確に把握している必要があり、さらにアプリケーション側でデコードしなければならない生のABIエンコードデータが返されます。複数のコントラクト、イベントタイプ、および長い時間範囲にわたるアクティビティの全体像を把握するには、アプリケーションコード内で数百から数千ものページネーションされたログクエリをつなぎ合わせる必要があります。
エンコードされたデータ形式と不透明なデータ形式
ブロックチェーン データは人間が直接読み取れる形式ではありません(by がデフォルト)。トランザクションの入力データ、イベントログのパラメータ、およびコントラクトのストレージ値は、ABIに従って16進数のバイト文字列としてエンコードされています。トランザクションの内容を理解するには、アプリケーションがコントラクトのABIを使用して、関数呼び出しとそのパラメータをデコードする必要があります。イベントログを解釈するには、ABIを使用してトピックハッシュをイベント名にマッピングし、データフィールドを型付き値にデコードする必要があります。
さらに事態を複雑にしているのは、すべてのコントラクトがABIを公開しているわけではないという点です。 ブロックエクスプローラー上の未検証のコントラクトはデコード情報を提供しないため、外部の観察者にとってはそのトランザクションやイベントが不透明なままとなります。検証済みのABIがある場合でも、プロキシコントラクト(呼び出しを実装コントラクトに委譲するもの)では、アプリケーションが基盤となる関数呼び出しをデコードする前に、プロキシ関係を解決する必要があります。こうした間接的な階層が存在するため、ブロックチェーン のデータを自動的かつ広範囲に処理することは、十分に文書化されたREST APIを扱う場合よりも、はるかに複雑になります。
内部トランザクションは、さらに不透明さを増す要因となります。あるスマートコントラクトが別のスマートコントラクトを呼び出す場合、その内部呼び出しはブロックのトランザクションリストには表示されません。それは実行トレース(debug_traceTransaction または trace_block メソッドを介してアクセス可能)にのみ表示されますが、実行トレースの生成には多大な計算コストがかかり、すべてのノードタイプで利用可能なわけではありません。 DEX での単純なトークンスワップでも、12回ほどの内部契約呼び出しが行われることがあり、そのそれぞれでトークンの転送、状態の更新、イベントの発行が行われます。何が起こったかの全体像を把握するにはトレースデータが必要ですが、これによりデータ量と処理の複雑さが劇的に増大します。
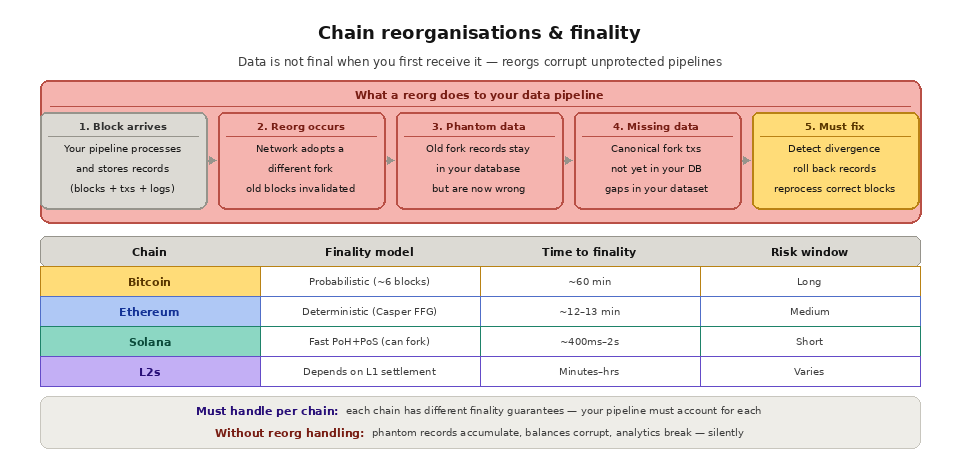
チェーンの再編成とファイナリティ
ブロックチェーン データは、最初に受け取った時点で必ずしも最終的な状態であるとは限りません。チェーンの再編成(reorg)は、ネットワークが一時的にチェーンの1つのフォークに従った後、正のチェーンとなる別のフォークに切り替わる際に発生します。再編成が発生すると、アプリケーションがすでに処理したブロックは無効になります。確認済みと見なされていたトランザクションは、正のチェーンにはもはや存在しないか、あるいは別のブロック内の異なる位置に表示される可能性があります。
データパイプラインやインデクサーにとって、再編成は悪夢のようなものです。再編成されたブロックに由来するレコードはすべて検出し、ロールバックし、正しいブロックのデータで置き換える必要があります。システムが再編成に対応していない場合、データベースにはファントムレコード(放棄されたフォークからのデータ)が蓄積され、正当なレコード(正規のフォークからのデータ)が見落とされることになります。その結果、残高の不一致、転送の重複、分析データの破損などが発生します。
チェーンごとにファイナリティの特性が異なるため、問題はさらに複雑化しています。Bitcoin のトランザクションは、約6回の確認(約60分)後に確率的にファイナリティが確定します。Ethereum は、2エポック(およそ12~13分)後にファイナリティが確定します。Arbitrum やBase といったL2チェーンは、Ethereum のL1にデータが投稿されるタイミングに依存する独自のファイナリティメカニズムを持っています。Solana は高速なファイナリティを実現していますが、スロットスキップやフォークの解決が発生する可能性があります。 データパイプラインでは、処理対象となる各チェーン固有のファイナリティモデルを考慮に入れる必要があります。
スケールとパフォーマンス
ブロックチェーン のデータ量は膨大であり、急速に増加しています。Ethereum では1日あたり約7,000ブロックが生成され、各ブロックには数百件のトランザクションと数千件のイベントログが含まれています。Solana 、Base 、Arbitrum といった高スループットチェーンでは、さらに桁違いに多くのデータが生成されます。これらすべてのデータをリアルタイムで取り込み、デコードし、保存すると同時に、完全な履歴インデックスを維持するには、膨大な計算リソースとストレージリソースが必要となります。
規模が拡大すると、パフォーマンスは微妙な形で低下します。数十億行規模のデータベーステーブルでは、許容可能な応答時間を維持するために、慎重なインデックス設計、パーティショニング戦略、およびクエリの最適化が必要となります。リアルタイムのデータ取り込みによる同時書き込みは、ユーザー 向けのクエリによる読み取りと競合します。チェーンの数、データセット(トレース、ログ、状態の差分)の量、および履歴の保存期間が長くなるにつれて、ストレージコストは複合的に増加します。 1日あたり100ブロックという規模では管理可能なデータパイプラインでも、10のチェーンにまたがり1日あたり10万ブロックになると、インフラストラクチャ上の課題となります。
ブロックチェーン のデータを照会する主な方法にはどのようなものがありますか?
ブロックチェーン のデータを読み取るための単一のツールは存在しません。チーム は、迅速なポイント検索、リアルタイムのフィード、あるいは詳細な履歴分析のいずれが必要かによって、いくつかのアプローチの中から適切なものを選択します。以下の表に、一般的な方法をまとめました。
アプローチ | 仕組み | こんな方に最適 |
|---|---|---|
RPCの直接呼び出し | ブロック、トランザクション、または残高のby キーを取得する | ポイント検索とライブ状態 |
イベントログ (eth_getLogs) | by のアドレスおよびトピックをブロック範囲でフィルタリングする | 特定の契約イベントの追跡 |
インデクサー | オンチェーン のデータをデコードし、クエリ可能なデータベースに格納する | 検索、結合、集計 |
実稼働環境のstacks の多くは、これらの要素をいくつか組み合わせています。ライブ読み取りにはRPCリクエストを使用し、検索や履歴機能が必要な処理については、別のインデックス作成層またはストリーミング層を利用しています。最下層の仕組みを理解するには、RPCエンドポイント が実際にどのような処理を行っているかを確認してください。
ブロックチェーン では、なぜSQLを直接使用できないのでしょうか?
ブロックチェーン は、データをインデックス付きテーブルとしてではなく、暗号的に連結されたブロックのシーケンスとして格納するため、クエリプランナーもWHERE句も存在せず、1回の呼び出しで「先週の1,000ドルを超えるすべてのスワップ」といった情報を取得する方法はありません。そのレベルのアクセスを実現するには、まず生データを抽出してデコードし、その後、サポート 形式の構造化クエリを実行するシステムに読み込む必要があります。この抽出、デコード、読み込みのステップこそが、ブロックチェーン のインデックス機能によって行われる処理そのものです。
データのクエリには、RPCノードとインデクサーのどちらを使うべきでしょうか?
RPCノードとインデクサーは、それぞれ異なる課題を解決します。RPCノードは直接的な検索やトランザクションの送信に最適である一方、インデクサーは、生のノードでは実行できない検索、フィルタリング、集計を行うために設計されています。以下の比較表は、それぞれがどのような場面に適しているかを示しています。
因子 | RPCノード | インデクサー |
|---|---|---|
クエリ形式 | ポイント検索のby キー | 柔軟な検索とフィルタ機能 |
集計 | 対応していません | 内蔵 |
歴史的な深み | アーカイブノードが必要です | 一度保存すれば、高速に検索可能 |
セットアップにかかる手間 |
それぞれの手法がどのような場合に有利になるかについて、より詳しく知りたい場合は、「RPC 対 インデックス」を参照してください。
ブロックチェーン の過去のデータをどのように照会すればよいですか?
最新の状態はどのフルノードからでも読み取ることができますが、古い状態や完全なトランザクション履歴を取得するには、通常、アーカイブノードまたはバックフィルパイプラインが必要となります。現在データと過去データの区別はアーキテクチャ全体を左右するものであり、これについては「リアルタイムデータと履歴データ(ブロックチェーン )」および「フルノードとアーカイブノード」で解説しています。1回限りの詳細な検索を行う場合は、アーカイブ エンドポイント で十分ですが、繰り返し行われる分析の場合は、履歴を一度インデックス化しておく方がはるかに効率的です。
よくある質問
ブロックチェーン を通常のデータベースと同じようにクエリすることはできますか?
直接的にはできません。標準のRPCメソッドでは、ブロック番号、トランザクションハッシュ、またはアドレスを基にしたサポート ポイント検索by のみが可能です。フィルタリングや集計を含むデータベース形式のクエリを実行するには、まずそれらをサポートするシステムにデータをインデックス化する必要があります。
あるウォレットのすべての取引を取得する最も速い方法は何ですか?
インデクサーまたは既製のデータAPIを利用してください。生のRPCを使用してチェーンブロック(by )をスキャンするのは、この用途には遅すぎますが、インデックス化されたデータセットであれば、1回のクエリでウォレットの完全な履歴を取得できます。
デコードされたブロックチェーン データには、なぜABIが必要なのでしょうか?
トランザクションの入力データとイベントログは、ABIエンコードされた16進数として保存されます。コントラクトのABIとは、これらのバイトを関数名、イベント名、および型付き値にマッピングするスキーマであるため、ABIがなければデータは不透明なままとなります。
組織再編は、ブロックチェーン のクエリにどのような影響を与えますか?
再編成(reorg)により、すでに読み込んだデータが無効になる可能性があるため、チェーンの先端(near )より前のクエリ結果は確定したものではありません。堅牢なパイプラインは、確定を待つか、正規チェーンが変更された際に修正アップデートを送信します。
ブロックチェーン のデータを照会するには、独自のノードを稼働させる必要がありますか?
いいえ。マネージド RPC プロバイダー、ストリーミングサービス、および分析プラットフォームを利用すれば、ノードやインデクサーを自ら運用することなく、ブロックチェーン のデータを読み取ったりクエリを実行したりすることができます。
Quicknode がブロックチェーン へのデータアクセスをいかに簡素化するのか
Quicknodeの製品スイートは、これらの課題のそれぞれに直接対処できるよう設計されています。Core APIは、ポイント検索やトランザクションの送信に対して高速かつ信頼性の高い RPC アクセスを提供し、一般的な多段階クエリを単一の呼び出しに集約する強化された API メソッドを備えています。アーカイブへのアクセスはすべてのプランに含まれているため、別途インフラストラクチャを用意したり追加コストを負担したりすることなく、過去の状態に関するクエリを実行できます。
Quicknode Streams データ取り込みの課題を完全に解消します。RPCエンドポイントをポーリングしたり、ページネーションを処理したり、リトライを管理したり、再編成を検知したりするカスタムスクリプトを構築・維持する代わりに、必要なブロックチェーン データをデータベースやデータウェアハウスに正確にプッシュするストリームを設定するだけです。Streams は、ファイナリティ順で「正確に1回」の保証付きでデータを配信し、チェーンの再編成を自動的に処理by して修正ペイロードを送信し、同じパイプラインを通じてリアルタイムストリーミングと履歴データのバックフィルの両方をサポートします。Quicknode のインフラ上で動作するJavaScriptベースのフィルターが、配信前にデータのデコード、変換、整形を行うため、宛先にはクエリ実行の準備が整った、クリーンで構造化されたレコードが届けられます。
パイプラインを一切構築せずに、ブロックチェーン のデータをインデックス化したいチーム 向けに、Quicknode の マーケットプレイス には、一般的なユースケース向けに、あらかじめ構築済みでクエリ可能なデータセットを提供する、インデックス作成プロトコルやデータサービスとのパートナー連携が含まれています。
参考資料
ブロックチェーン ETL による Web3 データの活用-Quicknode ブログ
Streams の入門-Quicknode ドキュメント
効率的な RPC リクエストのガイド-Quicknode
Streams データソース-Quicknode ドキュメント
