RPC 対 インデックス:ブロックチェーン データへの効率的なアクセス |Quicknode🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る 回答>インデックス作成とブロックチェーン データについて学ぶ>RPCとインデックス作成:その違いは? // Tags
RPC 対 インデックス作成インデクサーをいつ使うべきか
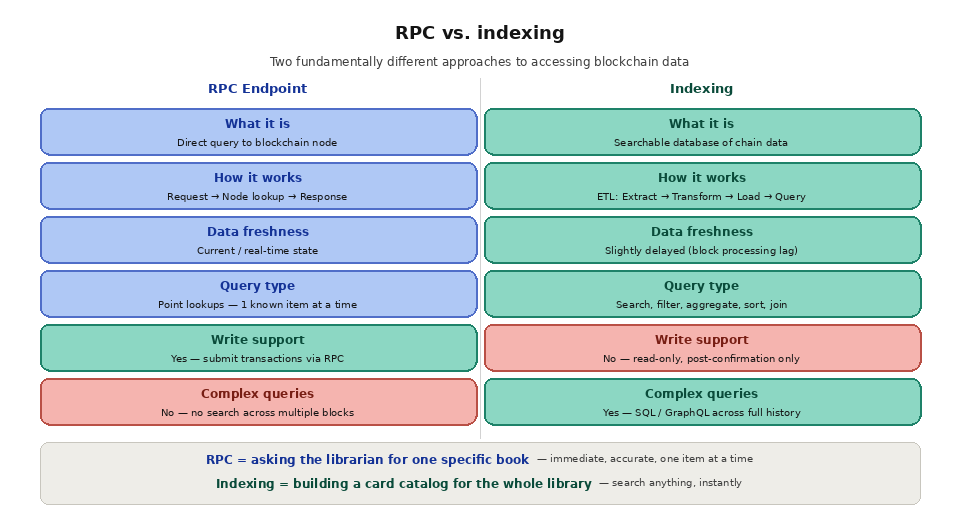
要約:RPCとインデックス化は、 ブロックチェーン のデータにアクセスするための、根本的に異なる2つのアプローチです。RPCエンドポイントを使用すると、ブロックチェーン の現在の状態を、1回につき1つのリクエストでリアルタイムに照会できます。一方、インデックス化では、ブロックチェーン のデータを抽出・変換し、検索可能なデータベースに格納するため、アプリケーションで過去の記録に対して複雑なクエリを実行できるようになります。RPCは、司書に特定の1冊の本を探してもらうようなものです。インデックス化は、図書館全体のカード目録を作成するようなものです。ほとんどの本番環境のアプリケーションでは、この両方が必要となります。
わかりやすい説明
ブロックチェーン のアプリケーションには、すべてデータが必要です。ウォレットには口座残高が必要です。DeFiダッシュボードにはトークン価格や流動性プールの状態が必要です。NFTマーケットプレイス には所有権記録や取引履歴が必要です。分析プラットフォームには、数千のコントラクトと数百万件の取引にわたる集計指標が必要です。問題は、ブロックチェーン からそのデータをアプリケーションに取り込むにはどうすればよいかということです。
RPCエンドポイントは、ブロックチェーン のネイティブインターフェースです。アプリケーションがノードにJSON-RPCリクエストを送信すると、ブロックチェーン の現在または直近の状態について直接質問することになります。例えば、「このウォレットの現在の残高はいくらか」、「この特定のトランザクションで何が起きたか」、「ブロック番号20,000,000には何が含まれているか」といった質問です。 ノードは答えを検索して返します。RPCは、特定の情報を検索する場合、即時的で正確、かつ簡潔です。しかし、重大な制限があります。RPCメソッドは、特定かつ既知のデータを取得するために設計されており、チェーン全体にわたる検索や集計を行うためのものではありません。「過去30日間のこのウォレットからのすべての取引を検索する」や「by の取引高上位10の流動性プールを表示する」といったRPCメソッドは存在しません。
インデックス作成は、このギャップを埋めるものです。by 生のブロックチェーン データの上に、検索可能なデータベースを構築します。インデクサーは、生成されるたびにすべてのブロックを読み取り、トランザクションやイベントログをデコードし、生データを構造化されたレコードに変換して、適切なインデックスが付いたデータベースにそれらのレコードを書き込みます。インデックスが作成されると、アプリケーションはSQL、GraphQL、またはデータベースがサポートするその他のクエリ言語を使用してデータをクエリできるようになります。これにより、複雑なフィルタリング、集計、ソート、結合、および全文検索が可能になります。
SOC 2 タイプ II 認証取得・ISO 27001
RPCをいつ使用すべきか
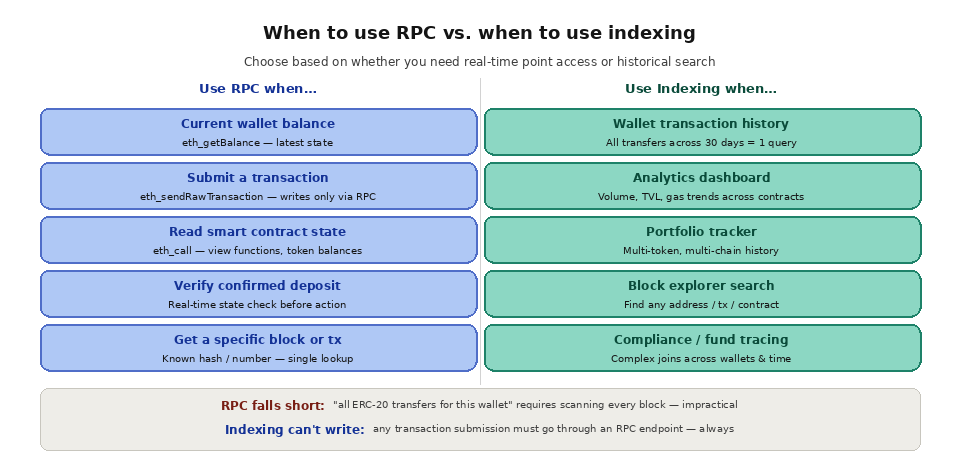
アプリケーションで、特定の既知のデータをリアルタイムで読み書きする必要がある場合、RPCが最適な選択肢となります。 ウォレットの現在のETH残高を確認するには、「eth_getBalance」を1回呼び出すだけです。署名済みのトランザクションをmempoolに送信するには、「eth_sendRawTransaction」が必要です。スマートコントラクトのview関数の戻り値を読み取るには、「eth_call」を使用します。これらはすべて、取得したい内容が正確にわかっており、RPCメソッドがそれを直接返すことができる「ポイントクエリ」です。
また、書き込み操作にはRPCしか利用できません。インデクサーを介してトランザクションを送信することはできません。インデクサーは、データがチェーンにコミットされた後にそれを処理する読み取り専用のシステムです。アプリケーションがトランザクションの送信、トークンの承認、スマートコントラクトとのやり取り、あるいは状態を変更する操作のブロードキャストを行う必要がある場合は、必ずRPCを経由する必要があります エンドポイントを経由する必要があります。
リアルタイムの状態検証も、RPCの強みの一つです。DeFiプロトコルが清算を実行する前にユーザー の担保比率を確認する必要がある場合や、ブリッジが入金の確認が完了したかどうかを検証する必要がある場合、RPCを介してノードの現在の状態を照会します。応答には最新の正規ブロックが反映されるため、データは可能な限り最新の状態が保証されます。
RPCの限界は、複数のブロックやコントラクトにわたるデータのスキャン、フィルタリング、集計を必要とするクエリにあります。「このアドレスが関与するすべてのERC-20送金を表示してください」という要求には、すべてのブロックを順に調べ、すべてのトランザクションレシートを確認する必要がありますが、RPCだけでは計算上の負荷が大きすぎて現実的ではありません。 「過去24時間におけるUniswap V3の取引 の総取引高はいくらか」というクエリでは、数十のプール契約にまたがる数千のブロックからのイベントログをデコードし、合計する必要があります。これらはインデックス作成に関する問題です。
インデックス作成を使用するタイミング
アプリケーションでブロックチェーン のデータを検索、フィルタリング、ソート、または集計する必要がある場合は、インデックス作成が不可欠です。ユーザー の複数のトークンやチェーンにわたる完全な取引履歴を表示するポートフォリオトラッカーは、インデックス化されたデータに依存しています。取引 の取引量、TVLの推移、ガス使用量のパターン、プロトコルのメトリクスを表示する分析ダッシュボードは、すべてインデックス化されたデータベースに基づいて構築されています。Etherscanのようなブロックエクスプローラーはチェーン全体をインデックス化しているため、ユーザー から任意のアドレス、取引、またはコントラクトを検索することができます。
履歴分析も、インデックス活用の主要なユースケースの一つです。コンプライアンス担当者(equipe )が、6か月間にわたる一連のウォレットを通じた資金のflow を追跡する必要がある場合、複雑な結合やフィルタリングを用いたインデックス化された取引データのクエリが必要となります。また、調査会社が1年間にわたるEthereum ブロックのMEV抽出パターンを分析したい場合、取引、トレース、イベントログを網羅した包括的なインデックスが必要となりますが、そうしたクエリの計算負荷は、ブロックチェーン ノードではなく、by データベースで処理される必要があります。
イベント駆動型アーキテクチャも、インデックス機能の恩恵を受けます。特定のスマートコントラクトイベントが発生したかどうかを検知するためにRPCエンドポイントをポーリングする代わりに、インデクサーが新しいブロックを継続的に処理し、一致したイベントをリアルタイムでアプリケーションに通知することができます。これは、WebSocketによるサブスクリプション(接続が切断されてイベントを見逃す可能性がある)よりも信頼性が高く、HTTPポーリング(空のレスポンスに対してリクエストを無駄にする)よりも効率的です。
両方を併用する
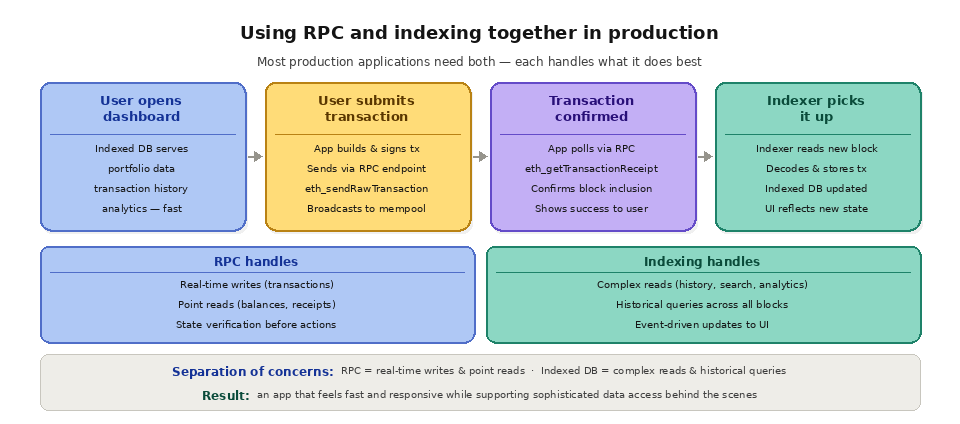
本番環境のブロックチェーン アプリケーションのほとんどは、RPCとインデックス機能を組み合わせて使用しています。ユーザー 向けの読み取り操作(ポートフォリオの価値、取引履歴、分析ダッシュボード、検索結果など)は、通常、by でインデックス化されたデータによって実現されています。ユーザー がアクション(取引の送信、トークンのスワップ、NFTの鋳造など)を実行する場合、アプリケーションはRPCに切り替えて、ネットワークに取引を送信し、その取り込みを確認します。 トランザクションが確認されると、インデクサーは新しいブロックからそのトランザクションを取得してデータベースを更新し、その変更がUIに反映されます。
このアーキテクチャは、関心を明確に分離しています。RPCはリアルタイムの書き込みやポイント読み取りを処理し、インデックス付きデータベースは複雑な読み取りや履歴クエリを処理します。その結果、ユーザー では高速で応答性の高いアプリケーションとして感じられる一方で、裏側では高度なデータアクセスパターンをサポートしています。
RPCとインデックス作成の違いは何ですか?
アスペクト | RPC | インデックス作成 |
|---|
アクセスパターン | 1つの質問、1つの答え | 検索、フィルタリング、集計 |
データの新鮮度 | リアルタイム、最新のブロック | チェーンの先端よりわずかに遅れている |
歴史的な深み | アーカイブノードが必要です | 保存され、即座に検索可能 |
書くサポート | はい、書く唯一の方法は | いいえ、読み取り専用です |
セットアップにかかる手間 | ロー、電話して エンドポイント | パイプラインを拡張するか、建設するか、あるいは購入するか |
こんな方に最適 | ライブ読み取りとトランザクション | 分析、履歴、検索 |
履歴クエリの場合、インデクサーはRPCよりも高速ですか?
複数のブロックにまたがるものについては、その通りです。RPCノードにウォレットの全履歴を問い合わせる場合、ブロックby ブロックをスキャンする必要がありますが、インデクサーはすでにそのデータをデコードして保存しているため、同じ問い合わせでも単一の高速なクエリで結果が返されます。履歴が古いほど、その差は大きくなります。 ブロックチェーン データのクエリがなぜ難しいのか、またリアルタイムデータと履歴データがどのように相反する方向に向かうのかについては、こちらをご覧ください。
クエリの種類 | 最適なツール | なぜ |
|---|
現在の残高または状況 | RPC | 直接かつリアルタイムで |
取引を送信する | RPC | 書き込みができるのはRPCのみです |
ウォレットの取引履歴 | インデクサー | ブロックをまたいだ検索が必要 |
プロトコルの総資産額(TVL) | インデクサー | 時間軸ごとの集計が必要 |
新ブロック開始イベントのライブ配信 | RPC またはストリーミング | 低遅延プッシュ |
RPCを基盤として、ブロックチェーン のインデクサーを構築することは可能でしょうか?
はい、そしてほぼすべてのインデクサーがそうしています。インデクサーは、RPC またはストリーミングフィードを通じてブロックチェーンを読み取り、各ブロックをデコードし、構造化された行を独自のデータベースに書き込みます。難しいのは、リオーガナイゼーション、リトライ、ギャップを確実に処理することであり、そのため多くのチーム では、RPCポーリングループを手作業で実装する代わりに、ブロックチェーン のマネージドデータストリーミングパイプラインを使用しています。
インデックス化はRPCに取って代わるのでしょうか?
いいえ。インデックスとRPCは、Web3インフラストラクチャスタックにおいて相互に補完し合うレイヤーです。RPCは、トランザクションの送信や最新の状態の読み取りを行う唯一の手段であり続ける一方、インデックスは検索、履歴、分析機能を支えています。本番環境のアプリ では、書き込みやリアルタイムの読み取りはRPCに、複雑な読み取りはインデックスにそれぞれルーティングされます。
よくある質問
インデクサーを介してトランザクションを送信することはできますか?
いいえ。インデクサーは、データがチェーンにコミットされた後にそれを処理する読み取り専用のシステムです。すべてのトランザクションの送信は、RPCを経由する必要があります エンドポイントを経由する必要があります。
分析クエリにおいて、RPCの処理が遅くなるのはなぜですか?
RPCは1回の呼び出しにつき1つの既知のデータを返すだけで、チェーン全体にわたるフィルタリングや集計を行うことはできません。RPCを使って分析上の疑問に答えるには、何千もの呼び出しを順次行い、その結果を自分で組み合わせる必要があり、これは処理に時間がかかり、コストもかかります。
インデックス化されたデータは、RPCと比べてどの程度最新のものなのでしょうか?
インデックス化されたデータは通常、インデクサーによっては、チェーンの先端よりby 秒から数分遅れます。RPCは最新の正規化ブロックを反映しているため、1秒未満の最新性を確保するには、依然としてノードから直接読み取る必要があります。
インデックス作成用にアーカイブノードは必要ですか?
過去の履歴をバックフィルするには、アーカイブノードまたはバックフィルパイプラインからのアーカイブデータが必要です。両者の違いについては、「フルノードとアーカイブノードの違い」を参照してください。
The Graphはインデクサーですか、それともRPCプロバイダーですか?
The Graphはインデックス作成プロトコルです。独自のインデクサーがRPCを介してブロックチェーンを読み取り、処理結果をクエリ可能なサブグラフとして公開します。The Graph単体では、トランザクションを送信したり、1秒未満のリアルタイムデータを提供したりすることはできません。
Quicknode が両方をどのようにサポートしているか
Quicknode この方程式の両側に必要なインフラストラクチャを提供します。Core APIは、80以上のチェーンにまたがるグローバルに分散された低遅延のRPCアクセスを提供し、99.99%の稼働率と競合他社よりも2.5倍速い応答時間で、リアルタイムの読み取りやトランザクションの送信を処理します。強化されたAPIメソッドにより、トークンの残高取得やNFTコレクションの取得といった一般的な操作に必要な個別のRPC呼び出し回数が削減されます。
Quicknode Streams RPCとインデックス作成の間のギャップを埋めるby は、未加工またはフィルタリング済みのブロックチェーン データを、データベース、データウェアハウス、またはWebhookに直接配信するプッシュ型のデータパイプラインを提供します。 インデクサーにデータを供給するためにカスタムRPCポーリングインフラを構築・維持する代わりに、Streamを設定するだけで、Quicknode がデータの抽出、フィルタリング、配信、再編成の修正、およびリトライロジックを処理します。Streams はリアルタイムストリーミングと履歴データのバックフィルの両方をサポートしているため、単一のツールでインデックスを創世期から構築し、常に最新の状態に保つことができます。 独自のインデクサーを構築する必要があるチーム 向けに、Quicknode は、Streams を使用して、PostgreSQLをバックエンドとした完全なブロックチェーン インデクサーを作成する方法を解説したステップバイby ガイドを公開しています。by
参考資料