🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る ブロックチェーン のインデックス作成とは? その仕組みと理由 |Quicknode
ニュースレターでは、無料のリソース、Quicknodeの最新情報、Web3に関するインサイトなどをお届けします。
CLI、Admin API 、MCP、SDK 、および75以上のチェーンに対応したAIネイティブツール。by 開発者 を構築し、開発者 向けに提供しています。
Python、Ruby、JavaScriptの最新コード例。スマートコントラクト、NFT、dAppsに関する詳細なガイド。
SOC 2 タイプ II 認証取得・ISO 27001
回答 > インデックス作成とブロックチェーン データについて学ぶ > ブロックチェーン のインデックス作成とは? ブロックチェーン のインデックス作成とは何ですか?
// Tags
ブロックチェーン インデックス作成 ブロックチェーン インデクサー
要約: ブロックチェーン インデックス作成とは、 ブロックチェーン から生データを抽出し、構造化された形式に変換し、高速なクエリに最適化されたデータベースに格納するプロセスです。ブロックチェーン は、検索のためではなく、セキュリティと不変性を確保するために設計されています。インデックス作成を行わない場合、「このウォレットからのすべての送金を表示して」といった単純な質問に答えるだけでも、ジェネシスブロックからすべてのブロックをスキャンする必要があり、大規模な環境では現実的ではありません。 インデクサーはこの問題を解決し(by )、クエリ可能なデータベースを構築することで、オンチェーン のデータをアプリケーションがリアルタイムで利用できるようにします。
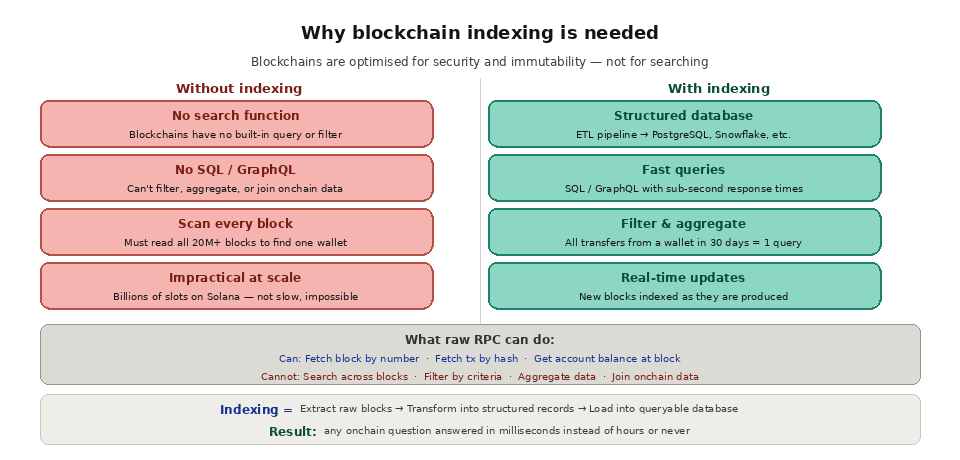
わかりやすい説明 ブロックチェーン これらは書き込み専用台帳です。改ざん防止された順序で取引を記録することには優れていますが、それらの取引に関する質問に答えることに関しては極めて不向きです。組み込みの「検索」機能はありません。SQLクエリも利用できません。標準的なRPCメソッドのみを用いて、「過去30日間にこのアドレスが関与したすべてのERC-20送金を検索する」といった操作を行う方法はありません。
RPCエンドポイントを通じて利用可能な基本的なツールは、by という原始的な設計に基づいています。特定のブロックby 番号を取得できます。特定のトランザクションby ハッシュを取得できます。特定のブロックにおけるアカウントの残高を取得することも可能です。しかし、ブロックを横断して検索したり、by 条件でフィルタリングしたり、データを集計したり、チェーンの異なる部分からの情報を結合したりすることはできません。 特定のウォレットからのすべてのトランザクションを見つけるには、これまでに生成されたすべてのブロックを取得し、各ブロックからすべてのトランザクションを抽出し、送信者または受信者が対象のアドレスと一致するかどうかを確認し、一致するものを収集する必要があります。Ethereum では、これは2,000万ブロック以上をスキャンすることを意味します。Solana では、数十億のスロットをスキャンすることを意味します。インデックス化なしでは、これは単に遅いというレベルではありません。合理的な時間枠内では不可能です。
ブロックチェーン インデックス化によってこの問題は解決されます。by ここでは、ノードから新しいブロックを継続的に読み取り、生データ(トランザクション、イベントログ、状態変化、トレース)をデコードして構造化されたレコードに変換し、適切なインデックスを設定したデータベースにそれらのレコードを書き込むプロセスが実行されます。データがデータベースに格納されれば、アプリケーションはSQLやGraphQLといった使い慣れたツールを使用してクエリを実行でき、応答時間は1秒未満となります。
インデックスの仕組み
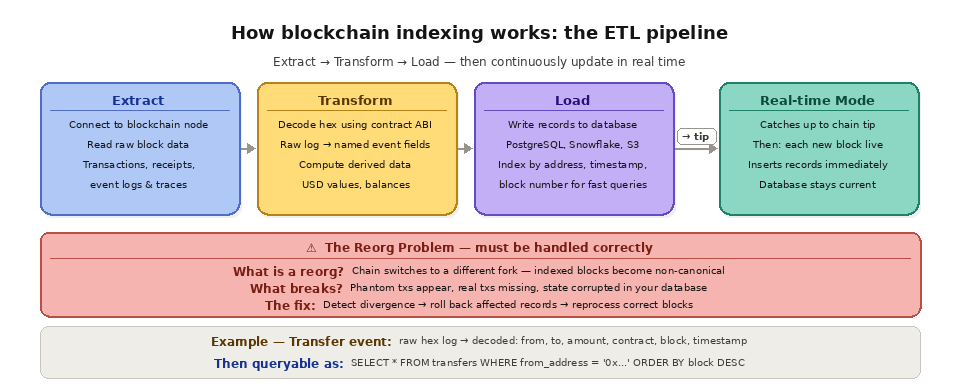
インデックス作成パイプラインは、抽出・変換・ロード(ETL)のパターンに従っています。抽出フェーズでは、インデクサーがブロックチェーン ノードに接続し、生のブロックデータを読み取ります。これには、ブロックヘッダー、トランザクション、トランザクションレシート(イベントログを含む)、およびオプションでトレースデータ(契約間の内部呼び出しをキャプチャしたもの)が含まれます。インデクサーは、設定された開始ブロックから順に、チェーンの履歴に沿ってブロックを処理していきます。
変換フェーズでは、インデクサーが生データを意味のある構造にデコードします。例えば、生のイベントログは、トピックハッシュやデータフィールドを含む16進数の文字列としてエンコードされています。インデクサーは、スマートコントラクトのABI(アプリケーションバイナリインターフェース)を使用して、これらを名前付きパラメータと適切なデータ型を持つ、人間が読み取れるイベントにデコードします。 生のTransferイベントログは、「送信元」アドレス、「宛先」アドレス、トークン量、およびコントラクトアドレスを含む構造化されたレコードになります。変換フェーズでは、転送時点での米ドル価値の算出、by トークンの取引高の集計、または残高の追跡など、派生データの計算を行うこともできます。
ロードフェーズでは、構造化されたレコードが、PostgreSQL、MongoDB、Snowflake、Elasticsearch、あるいはその他のストレージシステムといったデータベースに書き込まれます。データベースは、アプリケーションがクエリを実行するフィールド(ウォレットアドレス、トークン契約、タイムスタンプ、ブロック番号など)に対してインデックスを作成し、データセット全体にわたる高速な検索や複雑なクエリを可能にします。
インデクサーがチェーンの先端に追いつくと、リアルタイムのmode モードに切り替わり、新しいブロックが生成されるたびにそれを処理し、その結果として生成されたレコードを即座に挿入します。これにより、データベースはチェーンの最新の状態に常に同期されます。
組織再編の問題 ブロックチェーン のインデックス作成において、最も困難な課題の一つは、チェーンの再編成への対応です。再編成は、ブロックチェーン の正規チェーンが変更された際に発生します。これは通常、同じ高さで競合するブロックが生成され、ネットワークが最終的に、インデクサーが最初に処理したフォークとは異なるフォークに収束したことが原因です。これが発生すると、インデクサーがすでに処理したブロックは正規チェーンではなくなり、それらのブロックから派生したレコードはすべて不正確なものとなります。
堅牢なインデクサーは、リオーガナイゼーションを検出し、影響を受けたレコードをロールバックし、正しいブロックを再処理できなければなりません。リオーガナイゼーションへの対応に失敗すると、データベース内にファントムトランザクション(古いフォークには存在したが新しいフォークには存在しないトランザクション)や、欠落したトランザクション(新しいフォークには存在するが古いフォークには含まれていなかったトランザクション)が発生し、状態が不正確になります。金融アプリケーションにおいて、このようなデータの破損は許容できません。
リオーガナイゼーションの処理は、インデックス作成パイプラインにかなりの複雑さを加えます。インデクサーは、どのブロックが処理済みかを追跡し、現在確認しているチェーンとすでに保存済みのチェーンを比較し、不一致を検出し、ロールバックを適切に実行する必要があります。これが、チーム が、カスタムインデクサーを一から構築するのではなく、マネージドインデックスソリューションを選択する主な理由の一つです。
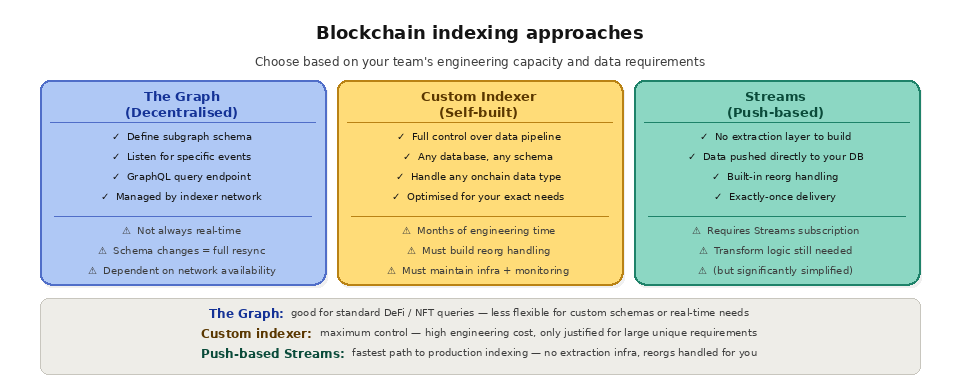
インデックス作成の手法 The Graphは、最も広く採用されている分散型インデックスプロトコルです。開発者 は「サブグラフ」を作成します。サブグラフとは、監視対象のスマートコントラクト、受信対象のイベント、およびイベントデータをクエリ可能なスキーマにマッピングする方法を定義する設定ファイルのことです。インデクサーと呼ばれる独立したノードオペレーターが処理インフラを運用し、GraphQLエンドポイントを通じてクエリに対応します。 The Graphは、DeFiプロトコルのデータ、NFTの所有履歴、DAOのガバナンス活動などのクエリといった標準的なユースケースにおいて、良好に機能します。その制限事項としては、レイテンシ(サブグラフの更新が必ずしもリアルタイムではないこと)、スキーマの柔軟性の欠如(スキーマを変更するには、多くの場合、再デプロイと再同期が必要となること)、および分散型ネットワークの可用性への依存などが挙げられます。
カスタムインデクサーを利用すれば、チーム はデータパイプラインを完全に制御できますが、その一方で多大なエンジニアリングリソースの投入が必要となります。本番環境向けのカスタムインデクサーを構築するには、ブロックの取り込みロジック、イベントのデコード、データベーススキーマの設計、再編成の処理、エラー回復、監視、およびインフラのスケーリングといった作業を行う必要があります。独自のデータ要件を持つ大規模なアプリケーションの場合、この投資は価値があるかもしれませんが、ほとんどのチーム にとっては、本来なら自社の主力製品の開発に充てられるはずの数ヶ月分のエンジニアリング時間を費やすことになってしまいます。
プッシュ型ストリーミングは、インデックス作成を簡素化する新しいアプローチです。by フィルタリング済みのブロックチェーン データをストレージシステムに直接配信するため、抽出レイヤーを独自に構築・維持する必要がなくなります。インデクサーがノードからデータを取得する代わりに、ストリーミングサービスが、必要なデータを正確にデータベース、Webhook、またはデータウェアハウスにプッシュします。
Quicknode がブロックチェーン のインデックス作成をどのように支えているか Quicknode Streams ブロックチェーン のデータインデックス作成に特化して設計されています。Streams は、プッシュ型のデータパイプラインを提供し、ブロックチェーン の生データまたはフィルタリング済みのデータを、PostgreSQL、Snowflake、Amazon S3、Azure Storage、webhooks など、ご希望の保存先へ直接配信します。チェーンからデータを抽出するためのRPCポーリングインフラを構築・維持する代わりに、ご希望のネットワーク、データセット(ブロック、トランザクション、レシート、トレース)、およびオプションのJavaScriptフィルターを設定してStreamを構成するだけで、残りの処理はQuicknode が自動的に行います。
Streams データはファイナリティ順で配信され、「Exactly-Once」配信が保証されます。つまり、コード側でブロックの順序や重複排除を管理する必要がなく、データベースは常に正規チェーンと一貫性を保つことができます。組み込みの再編成処理機能により、チェーンの再編成が自動的に検出され、修正ペイロードが送信されるため、インデックス化されたデータは常にチェーンの真の状態を反映します。 履歴データについては、Streams の「バックフィル」機能により、任意の範囲の過去のブロックをデータベースに格納できます。この機能は、従来のRPCベースのインデックス作成パイプラインに比べて最大7倍高速に同期を行い、リアルタイムストリーミングと同様のフィルタリングおよび配信保証を提供します。
Quicknode また、Streams を使用したブロックチェーン インデクサーの構築に関するステップバイby ガイドも公開しており、設定からクエリ実行に至るまで、by PostgreSQL を基盤とし、REST API を備えた完全な ERC-20 転送インデクサーの作成方法を解説しています。さらに高度なデータ処理を必要とするチーム 向けに、Streams はQuicknode Functions と連携し、ストリーミングデータパイプライン上でサーバーレスなデータ変換、エンリッチメント、自動化を実現します。
インデックス化と生のRPCの違いは何ですか? 生のRPCとインデックスは、それぞれ異なる種類の質問に対応しています。RPCは、特定のデータの検索や書き込み(このブロックの取得、この残高の読み取り、このトランザクションの送信など)を目的として設計されています。一方、インデックスは、検索や分析(特定のウォレットのすべての送金、by トークンの総取引量、コレクションの所有履歴など)を目的として設計されています。以下の表では、この2つを比較していますので、用途に応じて適切なツールを選択してください。
寸法
Raw RPC
インデックス付きデータベース
最も得意な分野は
ポイントの読み取りと取引の送信
検索、フィルタリング、集計
クエリ言語
JSON-RPC メソッド
SQL または GraphQL
過去のスキャン画像
Slow, block-by-block
高速で、前処理済み、かつインデックス化済み
セットアップにかかる手間
に接続する エンドポイント
パイプラインの構築または設定
一般的なレイテンシ
1回の通話あたりの往復時間
大規模なデータセットでも1秒未満
インデックス作成によって、どのようなクエリが可能になるのでしょうか? データが構造化されたデータベースにインデックス化されれば、生のRPCでは不可能なクエリも簡単に行えるようになります。特定のアドレスのすべての取引を一覧表示したり、NFTの完全な所有履歴を追跡したり、トークンごとの1日あたりの取引 取引高を集計したり、ウォレットのby 保有高をランキング化したり、複数のコントラクトにまたがるイベントを結合したりすることが可能です。これらはまさに、ダッシュボード、エクスプローラー、分析製品を支えるクエリそのものです。インデックス化なしではなぜこれらのクエリがこれほど困難なのかについては、「ブロックチェーン データのクエリ」を 参照してください。
インデックス作成とストリーミングはどのように連携しているのでしょうか? ストリーミングとインデックス作成は、互いに補完し合う層です。ストリーミングは、新しいブロックやイベントが発生した時点でそれらをインフラストラクチャにプッシュする配信メカニズムであり、一方、インデックス作成は、その受信データをクエリ可能なストアとして整理する処理です。現代の一般的なアーキテクチャでは、ストリーミングパイプラインを使用してレコードをインデックス付きデータベースに取り込み、脆弱なポーリング層を完全に排除しています。データがそもそもどのようにインデクサーに届くのかについては、「ブロックチェーン のデータストリーミングとは」 および「ポーリングとストリーミングの比較 」をご覧ください。
インデクサーは、過去のデータをどのように遡及的に取り込むのでしょうか? バックフィリングとは、ライブデータへの切り替え前に、過去のブロックをデータベースに格納するプロセスです。優れたパイプラインは、選択した過去のブロックから開始し、チェーンを順方向に処理していき、チェーンの先端に到達するとシームレスにリアルタイム処理へ移行するため、過去のレコードとライブレコードは同一のスキーマを共有します。適切に実施されれば、バックフィリングは生のRPCを介してチェーンを再スキャンするよりもはるかに高速です。過去のブロックチェーン データへのアクセス方法や 、リアルタイムデータと過去のブロックチェーン データとの比較については 、それぞれのトレードオフについてご確認ください。
よくある質問
インデックス作成の代わりに、RPCを使えばいいだけではないのでしょうか? RPCは特定のブロック、トランザクション、残高を取得するには最適ですが、チェーン全体にわたる検索、フィルタリング、集計を行う手段は提供していません。RPCを介して「このウォレットからのすべての送金」といった質問に答えるには、by ごとに何百万ものブロックをスキャンする必要があり、現実的ではありません。インデックス作成では、そのデータをデータベースに事前処理しておくため、同じ質問に対して単一のクエリで結果が返されます。
部分グラフとは何ですか? サブグラフとは、by で使用される構成であり、インデックス化する契約やイベント、およびそれらをクエリ可能な GraphQL スキーマにマッピングする方法を定義するグラフです。これはインデックスを構築する一般的な手法の一つであり、標準的な DeFi、NFT、ガバナンスデータに適していますが、カスタムパイプラインやストリーミングベースのパイプラインと比較すると、リアルタイムのレイテンシとスキーマの柔軟性の間でトレードオフが生じる可能性があります。
インデクサーはチェーンの再編成にどのように対処するのでしょうか? 堅牢なインデクサーは、正規チェーンが変更されたことを検知し、孤立したブロックから派生したレコードをロールバックし、正しいレコードを再処理します。これがなければ、データベースにファントムトランザクションや欠落したトランザクションが蓄積されてしまいます。マネージドパイプラインは、修正ペイロードを送信することで、リオーガナイゼーションを自動的に処理します(by 「ブロックチェーン のリオーガナイゼーションとは」を 参照してください。
独自のインデクサーを構築すべきか、それともマネージドサービスを利用すべきか? カスタムインデクサーを構築すれば完全に制御できますが、データ取り込み、デコード、スキーマ設計、再編成の処理、監視、スケーリングなどの実装が必要となり、多くの場合、数か月の作業を要します。マネージドパイプラインでは、データの抽出、順序付け、再編成、配信が自動的に行われるため、ほとんどのチーム は、by でサービスを設定するだけで本番環境への移行が早まり、エンジニアリングリソースをコア製品の開発に集中させることができます。
ブロックチェーン のインデックス付きデータは、どのようなデータベースに格納できますか? インデックス化されたデータは、トランザクションクエリ、全文検索、あるいは大規模な分析のいずれが必要かによって、通常、PostgreSQL、MongoDB、Snowflake、Elasticsearch、あるいはAmazon S3などのオブジェクトストレージに格納されます。ストリーミングパイプラインを使用すれば、レコードをこれらの保存先に直接送信することができます。エンドツーエンドのチュートリアルについては、『Builders Guide 』で一般的なインデックス作成パターンについて詳しく解説しています。
参考資料 // Tags
ブロックチェーン インデックス作成 ブロックチェーン インデクサー
// Publisher
Quicknode
2026年6月3日更新
2026年2月3日 — 読了時間10分