요약: 풀 노드는 블록체인의 현재 상태를 저장하고 모든 새로운 거래와 블록을 검증하지만, 저장 공간을 절약하기 위해 오래된 과거 데이터는 삭제합니다. 아카이브 노드는 풀 노드가 수행하는 모든 작업을 수행할 뿐만 아니라, 제네시스 블록부터 현재까지의 블록체인의 전체 과거 상태를 유지합니다. 어떤 유형이 필요한지는 애플리케이션이 현재 데이터만 필요로 하는지, 아니면 특정 시점의 과거 상태에 대한 접근이 필요한지에 따라 달라집니다.
간단한 설명
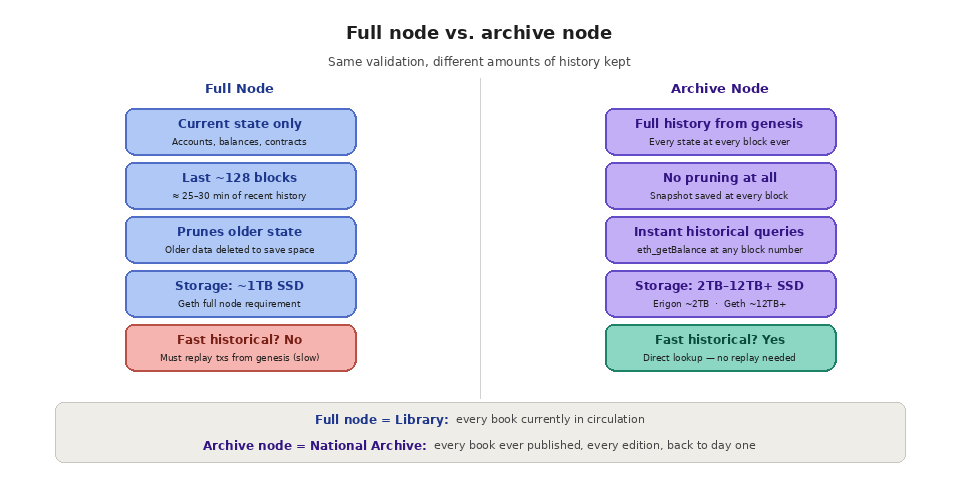
모든 블록체인 노드는 체인을 다운로드하고 검증하지만, 모든 노드가 동일한 양의 데이터를 보관하는 것은 아닙니다. 이를 도서관과 기록 보관소의 차이로 생각해 보세요. 풀 노드는 도서관과 같습니다. 현재 유통 중인 모든 책을 보유하고 있으며, 지금 서가에 어떤 책이 있는지 알려줄 수 있습니다. 반면 아카이브 노드는 국립 기록 보관소와 같습니다. 창간 이래로 출판된 모든 책, 모든 판본, 그리고 절판된 원고까지 모두 보유하고 있습니다.
Ethereum 에서 풀 노드는 모든 계정, 잔액 및 스마트 계약의 현재 상태와 함께, 체인의 무결성을 검증하기에 충분한 최근 블록 내역을 저장합니다. 기본적으로 대부분의 Ethereum 클라이언트는 최근 128개의 블록에 해당하는 상태 데이터를 즉시 접근 가능한 상태로 유지하며, 이는 대략 지난 25~30분간의 네트워크 활동을 포함합니다. 그보다 오래된 데이터는 디스크 공간을 절약하기 위해 삭제됩니다. 풀 노드는 기술적으로 제네시스 블록부터 트랜잭션을 재실행하여 이전 상태를 재구성할 수는 있지만, 이 과정은 매우 느리고 계산 비용이 많이 듭니다.
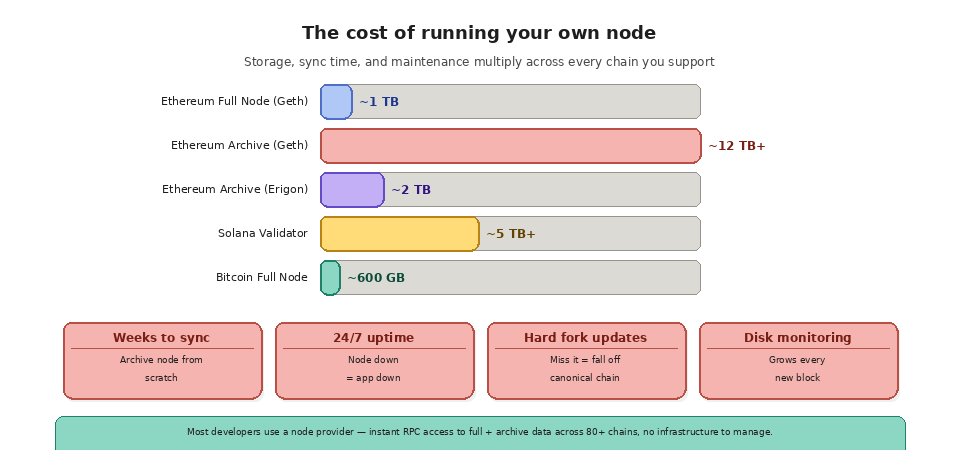
아카이브 노드는 프루닝 과정을 완전히 생략합니다. 이 노드는 체인이 생성된 이후 모든 블록에 대해 전체 블록체인 상태의 스냅샷을 저장합니다. 즉, 체인 기록의 어느 시점에서든 임의의 지갑 잔액, 스마트 계약의 저장 내용, 또는 거래의 출력을 조회할 수 있으며, 즉시 응답을 받을 수 있습니다. 재실행(replay)이 필요하지 않습니다. 대신 저장 공간이 많이 소요된다는 단점이 있습니다. Geth를 실행하는 풀 노드( Ethereum )는 약 1TB의 SSD 공간이 필요합니다. Geth를 실행하는 아카이브 노드는 12TB 이상이 필요하며, 이 용량은 매일 증가하고 있습니다. 저장 공간 효율이 더 높은 클라이언트인 Erigon을 사용하면 아카이브 요구 용량을 약 2TB까지 줄일 수 있지만, 여전히 프루닝된 풀 노드보다 훨씬 많은 용량이 필요합니다.
두 노드 유형 모두 체인을 검증하고 현재 상태를 저장하지만, 모든 과거 상태 스냅샷을 보관하는 것은 아카이브 노드뿐입니다. 아래 표에는 두 유형의 실질적인 차이점이 요약되어 있습니다. 아직 어떤 노드 유형을 운영할지 결정하지 못하셨다면, ‘블록체인 노드란 무엇인가 ’와 ‘노드 운영 대 RPC 제공자 사용’에 대한 개요를 참고하시면 도움이 될 것입니다.
속성
풀 노드
아카이브 노드
역사적 상태
약 128블록 후에 정리됨
창세기에부터 이어져 온
저장소 (Ethereum, Geth)
약 1TB
12TB 이상 (Erigon 기준 약 2TB)
과거 상태 조회
누락된 트라이 노드 오류 반환
어떤 블록 높이에서든 즉시
동기화 시간
시간에서 일까지
며칠에서 몇 주
다음에 가장 적합합니다
지갑, DApp, 결제, 실시간 조회
탐색, 분석, 감사, 추적
풀 노드가 필요한 경우
풀 노드는 모든 블록체인 네트워크의 중추적인 역할을 합니다. 풀 노드는 모든 새로운 블록을 검증하고, 합의 규칙을 적용하며, 유효하지 않은 거래를 거부하고, 전체 체인을 저장하지 않는 경량 클라이언트에 대한 신뢰의 기반이 됩니다. 지갑을 개발하거나, 현재 잔액과 최근 거래 데이터만 필요한 dapp을 만들거나, 네트워크에 거래를 제출하는 서비스를 구축하는 경우라면 풀 노드만으로도 충분합니다.
대부분의 생산 환경 애플리케이션은 이 범주에 속합니다. 탈중앙화 거래소(DEX)는 현재 토큰 잔액을 파악하고 실시간으로 스왑을 실행해야 합니다. 결제 처리 업체는 수신된 거래가 유효하고 확정되었는지 확인해야 합니다. 지갑은 현재 잔액을 표시하고 새로운 거래를 전송해야 합니다. 이러한 사용 사례 중 어느 것도 50만 블록 전 특정 계정의 잔액이 얼마였는지 조회할 필요가 없습니다. 현재 상태만으로도 충분하며, 풀 노드는 아카이브 노드에 비해 훨씬 낮은 하드웨어 사양으로도 이를 제공합니다.
풀 노드는 네트워크의 건전성 유지에도 중요한 역할을 합니다. 블록체인에서 실행되는 독립적인 풀 노드가 많을수록 네트워크는 더욱 탈중앙화되고 탄력성을 갖추게 됩니다. 각 풀 노드는 체인을 독립적으로 검증하므로, 어떤 단일 노드나 노드 그룹도 일방적으로 기록을 변경할 수 없습니다. 풀 노드를 운영하는 것은 블록체인의 보안 모델에 참여하고 이를 지원하는 가장 직접적인 방법입니다.
아카이브 노드가 필요한 경우
애플리케이션이 과거 블록체인 데이터에 의존하는 경우, 아카이브 노드는 필수적입니다. 사용자가 체인 기록의 어느 시점에서도 거래 내역이나 계정 상태를 조회할 수 있는 블록 탐색기를 구축하고 있다면, 아카이브에 대한 접근 권한이 필요합니다. 토큰 보유량, 스마트 계약 상태 또는 DeFi 프로토콜 지표가 시간 경과에 따라 어떻게 변화했는지 추적하는 분석을 수행하고 있다면, 아카이브에 대한 접근 권한이 필요합니다. 테스트를 위해 Hardhat이나 Foundry와 같은 개발 도구를 사용하여 mainnet 을 포크하여 과거 조건을 시뮬레이션하는 경우에도 아카이브에 대한 접근 권한이 필요합니다.
특정 기술적 시나리오에서도 아카이브 노드가 필요합니다. 과거 블록 번호(대부분의 클라이언트에서 최근 128개 블록보다 오래된 블록)에서 eth_getBalance 또는 eth_call을 호출하려면 아카이브 데이터가 필요합니다. 몇 주 전 실패한 트랜잭션의 실행 과정을 추적하여 디버깅하려면 아카이브 데이터가 필요합니다. 청산 이벤트를 감사하기 위해 특정 블록 시점의 대출 프로토콜 상태를 재구성하는 데에도 아카이브 데이터가 필요합니다. 아카이브 노드가 없으면 데이터가 정리(pruning)되었기 때문에 이러한 쿼리는 “트리 노드 누락(missing trie node)” 오류를 반환하게 됩니다.
아카이브 노드의 대상은 좁지만 매우 중요합니다. 블록체인 분석 플랫폼, 포렌식 조사관, 프로토콜 감사관, The Graph와 같은 인덱싱 서비스, 그리고 현재뿐만 아니라 과거에 대한 질문에 답해야 하는 모든 애플리케이션이 이에 해당합니다.
풀 노드에서 역사 조회 쿼리가 실패하는 이유는 무엇인가요?
풀 노드는 대략 최근 128블록보다 오래된 상태를 정리하므로, 더 오래된 블록에서 eth_getBalance나 eth_call을 호출하면 트라이 노드가 누락되었다는 오류가 발생합니다. 트랜잭션 기록은 여전히 존재하지만, 공간 절약을 위해 해당 시점의 상태는 삭제되었습니다. 이를 복구하려면 아카이브 노드나 저장된 데이터 세트가 필요하며, 이것이 바로 과거 블록체인 데이터에 접근하는 데 있어 핵심 개념입니다. 또한 이러한 상태 정보 정리(pruning) 때문에 대규모로 블록체인 데이터를 조회할 때는 종종 하나의 풀 노드만으로는 부족합니다.
각 노드 유형마다 얼마나 많은 저장 공간이 필요한가요?
저장 용량은 가장 큰 실질적인 차이점이며, 이는 체인과 클라이언트에 따라 달라집니다. 표에는 Ethereum 의 일반적인 수치가 나와 있습니다. 이러한 수치는 지속적으로 증가하고 있으며, 이는 ‘실시간 대 과거 블록체인 데이터’에서 다룬 바와 같이 많은 팀이 대신 프로바이더를 통해 과거 상태를 조회하는 이유 중 하나입니다.
구성
대략적인 저장 용량
참고 사항
풀 노드 (Geth)
약 1TB
프룬의 이전 상태
아카이브 노드 (Geth)
12TB 이상
모든 상태 스냅샷을 저장합니다
아카이브 노드 (Erigon)
대략 2TB
저장 공간 활용도가 더 높은 클라이언트
저장 공간과 비용의 현실
자체 아카이브 노드를 운영하는 것은 상당한 부담이 따르는 일입니다. Ethereum 만 해도 12TB 이상의 저장 공간이 필요할 뿐만 아니라, 적절한 쿼리 속도를 확보하려면 고성능 SSD(HDD가 아닌)가 필요하며, 하드웨어 사양과 인터넷 연결 상태에 따라 아카이브 노드를 처음부터 동기화하는 데 몇 주가 걸릴 수도 있습니다. 초기 동기화 과정에서 노드의 동기화가 어긋나거나 노드가 다운될 경우, 처음부터 다시 시작해야 할 수도 있습니다. 이를 애플리케이션이 지원하는 모든 체인에 적용하면 인프라 부담이 급격히 증가합니다.
이 때문에 대부분의 개발자와 팀은 아카이브 노드를 직접 운영하기보다는 인프라 제공업체에 의존합니다. Quicknode 는 모든 요금제에 아카이브 데이터 액세스 기능을 포함하고 있으므로, 사용자는 기본 스토리지나 동기화 프로세스를 관리할 필요 없이 지원되는 모든 체인의 과거 상태를 조회할 수 있습니다. 지난 10분간의 데이터가 필요하든, 제네시스까지 거슬러 올라가는 전체 이력이 필요하든, Quicknode 의 Core API는 동일한 RPC endpoint 를 통해 이를 처리합니다. 전용의 격리된 인프라가 필요한 팀을 위해, Quicknode 의 Dedicated Clusters 는 가동 시간 SLA가 보장되고 예측 가능한 성능을 갖춘 비공개 아카이브 노드 액세스를 제공합니다.
하나의 endpoint 서버로 전체 데이터와 아카이브 데이터를 모두 제공할 수 있습니까?
네. 많은 제공업체들이 단일 URL을 통해 현재 상태 요청은 풀 노드로, 과거 상태 요청은 아카이브 노드로 각각 전달하므로, 두 가지 설정을 따로 관리할 필요가 없습니다. 애플리케이션 측면에서는 최근 및 과거 쿼리 모두에 응답하는 RPC endpoint 가 단 하나뿐입니다.