요약: 고가용성(HA)이란 개별 구성 요소가 고장 나더라도 가동 중단 시간을 최소화하며 온라인 상태를 유지하고 응답성을 유지하도록 설계된 시스템을 의미합니다. 블록체인 인프라에서 HA는 RPC 엔드포인트, 노드 및 데이터 파이프라인이 요청을 안정적으로 계속 처리함을 의미하며, 일반적으로 99.9% 이상의 가동 시간을 목표로 합니다. 가동 시간이 생각보다 중요한 이유
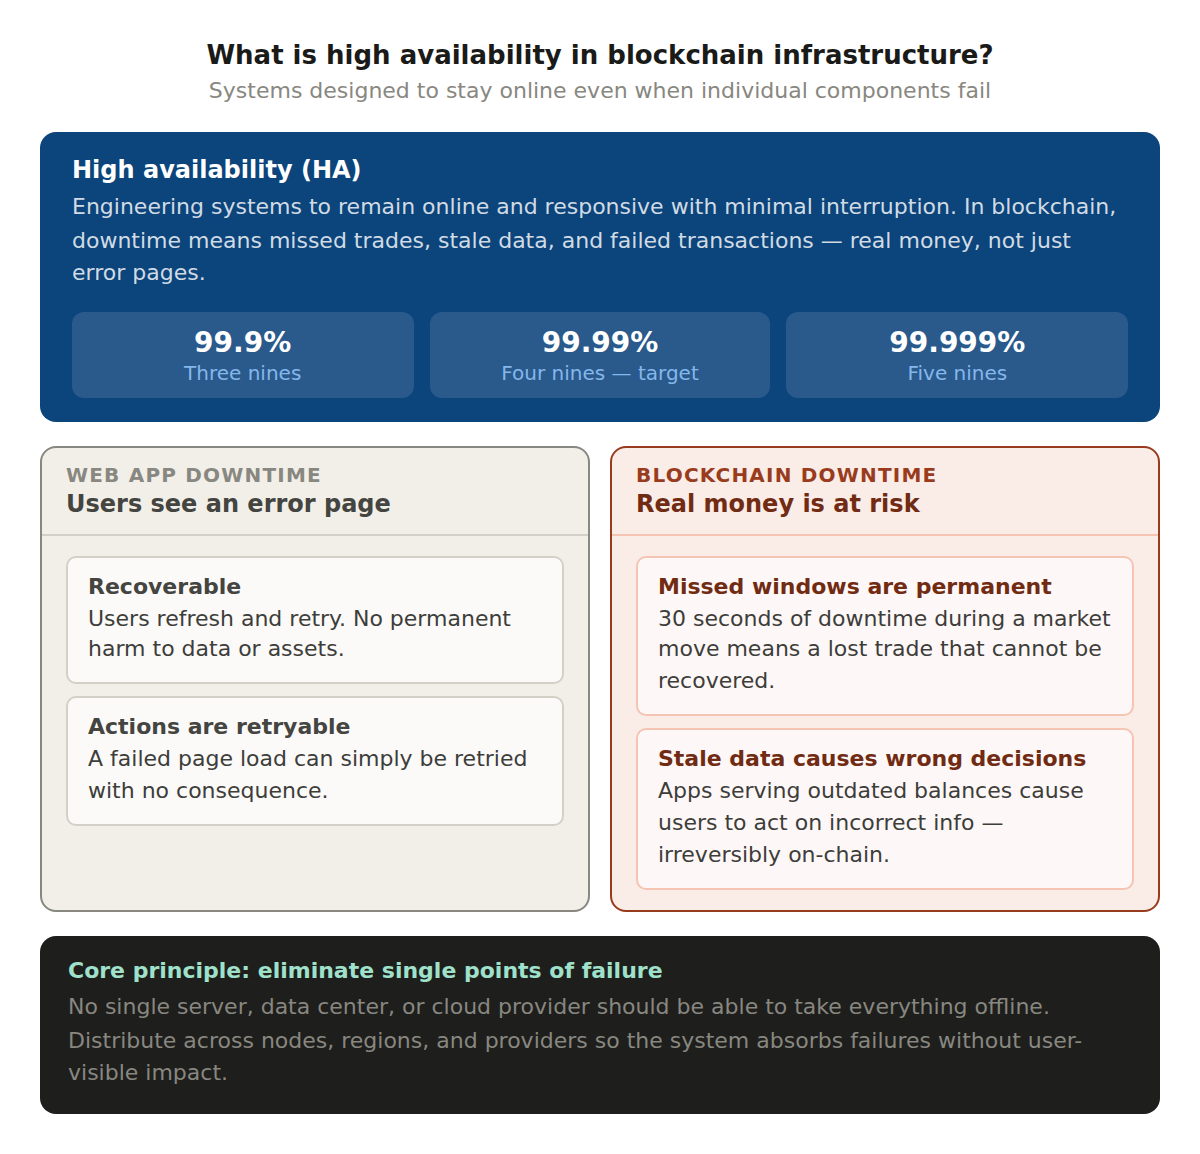
일반적인 웹 앱이 다운되면 사용자에게 오류 페이지가 표시됩니다. 반면 블록체인 인프라가 다운될 경우 그 결과는 훨씬 더 심각할 수 있습니다. 누락된 거래, 오래된 데이터, 실패한 거래, 처리되지 않은 이벤트 등은 단순히 사용자에게 불편을 주는 데 그치지 않습니다. 이는 실질적인 금전적 손실을 초래합니다.
RPC endpoint 를 통해 거래를 전송하는 DeFi 거래 봇을 생각해 보세요. 변동성이 심한 시장 상황에서 해당 endpoint 가 단 30초만이라도 접속이 끊기면, 봇은 거래 기회를 완전히 놓치게 됩니다. 또는 노드 제공업체의 서비스 중단으로 인해 잔액을 조회할 수 없는 지갑 앱의 경우도 생각해 보세요. 사용자들은 자신의 자금이 안전한지 알 수 없게 되고, 고객 지원 문의가 폭주하게 됩니다.
고가용성은 이러한 상황을 방지하기 위한 공학적 접근 방식입니다. 이는 단 한 번의 장애만으로도 전체 시스템이 중단되지 않도록 시스템을 설계하는 것을 의미합니다.
블록체인에서 고가용성이란 무엇인가요?
블록체인에서 고가용성이란 개별 구성 요소가 고장 나더라도 노드, RPC 엔드포인트 및 데이터 파이프라인을 온라인 상태로 유지하고 정상적으로 응답할 수 있도록 하는 방식입니다. 고가용성 환경은 단일 노드나 특정 지역에만 의존하는 대신, 중복된 구성 요소에 작업을 분산시켜 단일 장애로 인해 전체 서비스가 중단되는 일이 없도록 합니다. 이는 정상적으로 작동하며 동기화된 노드에 크게 의존하기 때문에, 노드의 신뢰성과 자동 장애 조치 기능이 핵심 구성 요소로 작용합니다.
본질적으로 고가용성(HA)은 단일 장애 지점을 제거하는 데 목적이 있습니다. 고가용성 시스템은 단일 서버, 단일 데이터 센터 또는 단일 클라우드 공급자에 의존하는 대신, 여러 중복 구성 요소에 걸쳐 워크로드를 분산시킵니다.
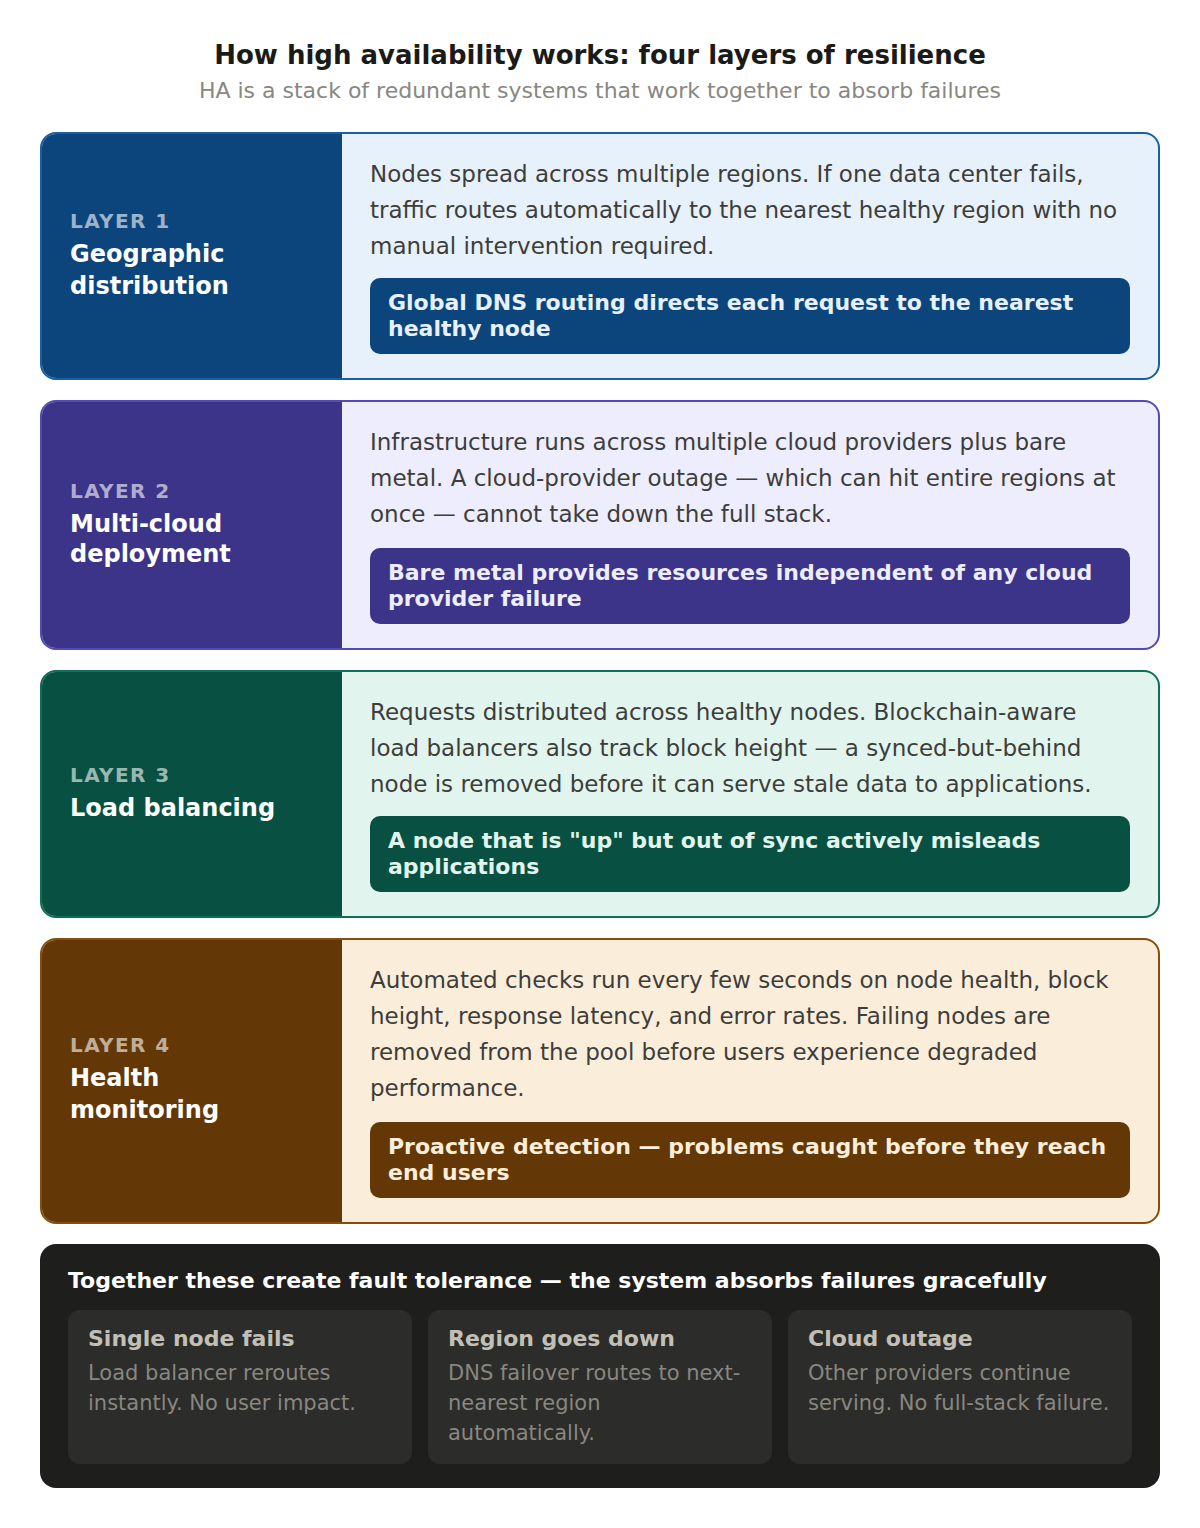
블록체인 인프라에서는 일반적으로 여러 계층이 포함됩니다. 첫 번째는 지리적 분산으로, 노드를 여러 지역에 분산 배치하여 특정 데이터 센터에 문제가 발생하더라도 트래픽이 자동으로 가장 가까운 정상 작동 중인 대체 노드로 라우팅되도록 합니다. 두 번째는 멀티 클라우드 배포입니다. 두 개 이상의 클라우드 공급자(때로는 베어 메탈)에서 서비스를 운영함으로써, 특정 클라우드의 장애로 인해 전체 스택이 중단되는 것을 방지할 수 있습니다. 세 번째는 부하 분산으로, 들어오는 RPC 요청을 정상적인 노드 풀에 분산시키고, 속도가 느리거나 응답이 없는 노드는 자동으로 우회하여 라우팅합니다. 네 번째는 상태 모니터링으로, 자동화된 시스템이 노드 상태, 블록 높이, 응답 시간을 지속적으로 확인하여 문제가 사용자에게 영향을 미치기 전에 이를 감지하고 경고합니다.
이러한 구성 요소들은 서로 협력하여 엔지니어들이 ‘내결함성’이라고 부르는 기능을 구현합니다. 이 시스템은 완전히 마비되는 대신 오류를 원활하게 처리합니다.
가용성 측정
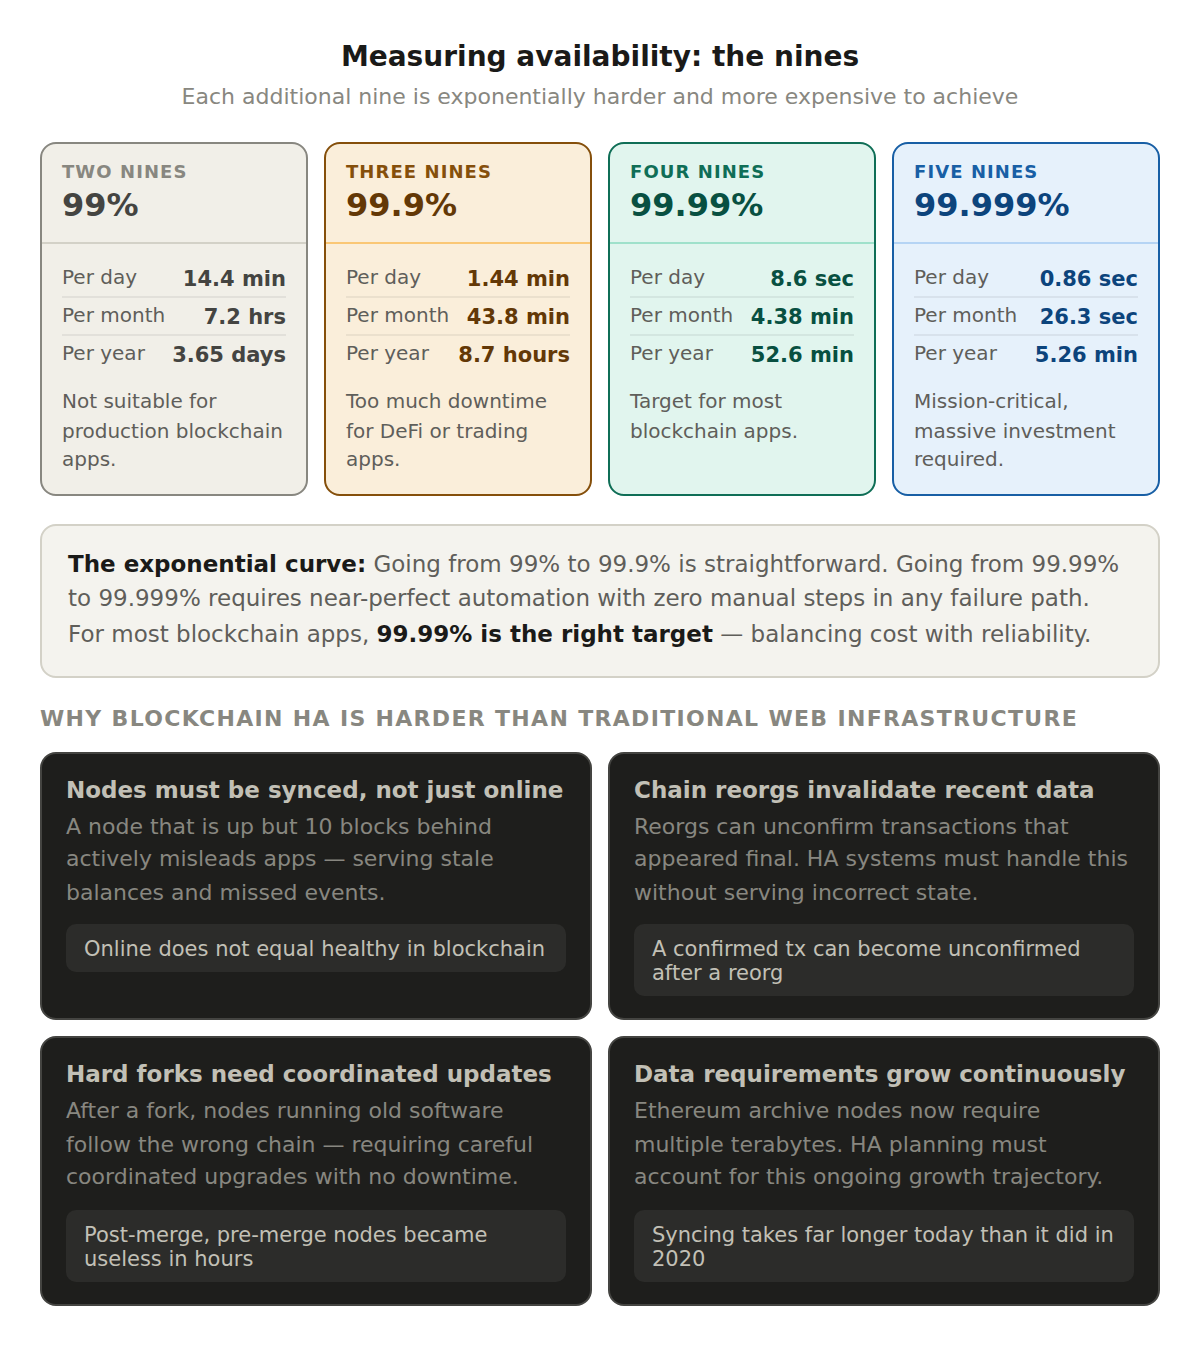
가용성은 대개 특정 기간 동안의 가동 시간을 백분율로 나타냅니다. 흔히 “세 개의 9”(99.9%)나 “네 개의 9”(99.99%)와 같은 용어를 듣게 됩니다.
실제로 이러한 수치가 무엇을 의미하는지 살펴보겠습니다. 가동률이 99.9%일 경우, 연간 다운타임은 대략 8.7시간입니다. 99.99%일 경우, 이는 연간 약 52분으로 줄어듭니다. 99.999%(5개의 9)일 경우, 1년 동안의 다운타임은 5분을 약간 넘는 수준입니다.
9가 하나씩 늘어날 때마다 달성 난이도는 기하급수적으로 높아지며, 중복성, 모니터링 및 자동화에 훨씬 더 많은 투자가 필요합니다. 대부분의 블록체인 애플리케이션에서 99.99%는 비용과 신뢰성 사이의 균형을 맞추는 목표치입니다.
가동률 목표치를 몇 퍼센트로 설정해야 할까요?
가동 시간 목표는 “나인” 단위로 표시됩니다. ‘나인’이 하나 추가될 때마다 허용되는 가동 중단 시간은 급격히 줄어들며, 이를 달성하는 데 드는 비용도 더 많이 듭니다. 이 표는 각 수준이 1년 동안 실제로 어떤 의미를 갖는지 보여줍니다.
가동 시간
이름
연간 가동 중단 시간
99.9%
9가 세 개
약 8.7시간
99.99%
4개의 9
약 52분
99.999%
5개의 9
5분이 조금 넘는 시간
고가용성은 내결함성과 어떻게 다른가요?
사람들은 이 두 용어를 혼용하여 사용하지만, 둘은 같은 개념이 아닙니다. 고가용성은 장애 전환 과정에서 발생하는 일시적인 중단을 감수하면서 가동 중지 시간을 최소화하는 것을 목표로 합니다. 반면, 내결함성은 완전히 중복된 구성 요소를 병렬로 구동하여 가동 중지 시간을 완전히 없애는 것을 목표로 합니다. 대부분의 블록체인 팀은 합리적인 비용으로 높은 가동 시간을 확보할 수 있기 때문에 고가용성을 추구합니다.
기존 웹 서비스의 경우, 로드 밸런서 뒤에 서버를 더 많이 가동하기만 하면 됩니다. 반면 블록체인 인프라는 노드들이 네트워크와 동기화를 유지해야 하기 때문에 더 복잡합니다. 블록 높이가 뒤처진 노드는 기술적으로는 ‘온라인’ 상태라 하더라도 사실상 무용지물입니다.
또한 블록체인은 기존 인프라에는 존재하지 않는 독특한 장애 유형을 초래합니다. 체인 재구성(reorg)으로 인해 최근 데이터가 일시적으로 무효화될 수 있습니다. 네트워크 업그레이드나 하드 포크를 수행하려면 노드 간에 조율된 업데이트가 필요합니다. 클라이언트 구현 방식에 따라 부하 상황에서 서로 다른 동작을 보일 수 있습니다. 게다가 데이터 자체의 양이 끊임없이 증가하기 때문에, 시간이 지남에 따라 저장 공간 및 동기화 요구 사항도 늘어납니다.
이러한 모든 요인으로 인해 블록체인의 고가용성(HA) 구현은 단순히 서버 클러스터 앞에 로드 밸런서를 배치하는 것보다 훨씬 더 미묘한 차원이 필요합니다. 이를 위해서는 프로토콜에 대한 깊은 이해와 지속적인 운영 투자가 필요합니다.
고가용성 RPC 환경을 어떻게 설계할 수 있을까요?
탄력적인 구성은 여러 기술을 결합합니다. 즉, 노드를 여러 지역과 제공업체에 분산 배치하고, 정상 작동 중인 노드 풀 앞에 로드 밸런서를 배치하며, 블록 높이와 지연 시간을 모니터링하여 동기화가 되지 않은 노드가 자동으로 제거되도록 하고, 장애 전환을 위해 백업 제공업체를 항상 대기 상태로 유지합니다. 애플리케이션 측면에서는 여전히 단일 RPC endpoint 로 보이지만, 그 이면에는 서비스를 계속 가동 상태로 유지하는 중복성이 자리 잡고 있습니다. 블록체인 인프라를 지속적으로 모니터링해야만 자동 라우팅 결정이 가능해집니다.
Quicknode 의 고가용성 구현 방식
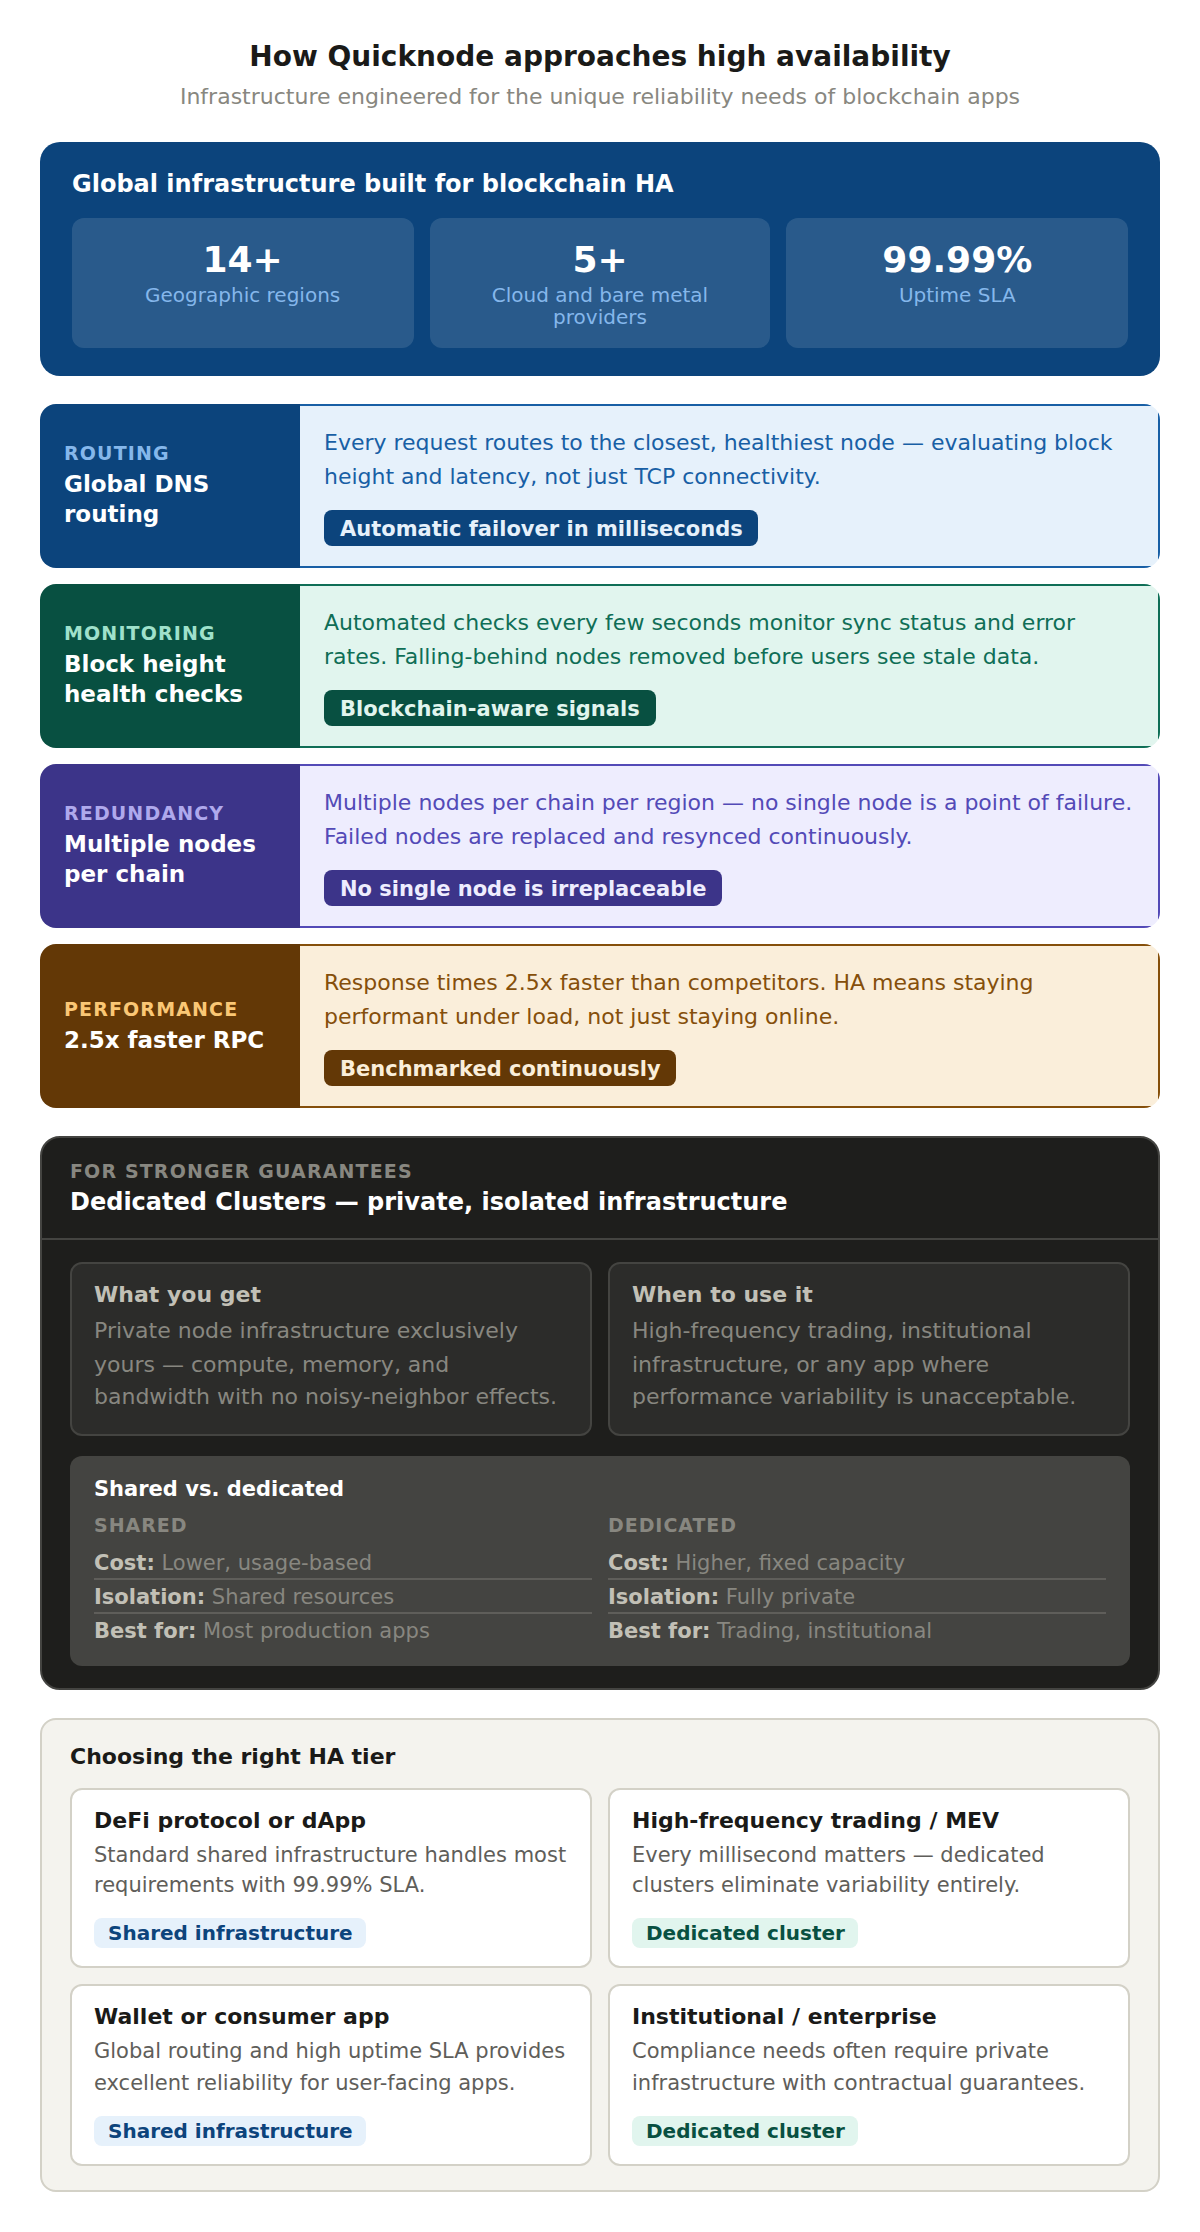
Quicknode 여러 클라우드 및 베어메탈 제공업체의 14개 이상의 리전에서 인프라를 운영합니다. 모든 RPC 요청은 글로벌 DNS 기반 라우팅을 통해 가장 가까운 정상 노드로 전달되며, 시스템은 블록 높이, 지연 시간 및 오류율을 지속적으로 모니터링하여 요청이 항상 온라인 상태이고 완전히 동기화된 노드로 전달되도록 보장합니다.
더 강력한 보장이 필요한 팀을 위해, Quicknode 에서는 전용 clusters 를 제공하며, 여기에는 독립적이고 격리된 인프라와 가동 시간 SLA가 보장됩니다.