요약: 메트릭, 로그, 트레이스는 관측 가능성의 세 가지 기본 데이터 유형으로, 각각 시스템 동작을 이해하는 데 있어 뚜렷한 목적을 수행합니다. 메트릭은 시간 경과에 따라 추적되는 집계된 수치 측정값으로, 대시보드, 알림 및 추세 분석에 이상적입니다. 로그는 타임스탬프가 포함된 개별 이벤트 기록으로, 특정 사고를 디버깅하고 감사 추적을 유지하는 데 가장 적합합니다. 추적(Trace)은 분산 시스템 내에서 단일 요청의 전체 경로를 따라가며, 시간이 어디에 소요되고 병목 현상이 발생하는지 밝혀줍니다. 실제로 이 세 가지는 서로 연동되어 작동합니다. 메트릭이 경보를 유발하고, 로그가 오류 세부 정보를 제공하며, 추적이 실패한 요청 경로의 전체적인 맥락을 보여줍니다. 블록체인 애플리케이션에 대한 효과적인 가시성을 확보하려면 이 세 가지 기둥이 모두 필요합니다. 블록체인 인프라의 분산된 특성상, 단일 데이터 유형만으로는 진단할 수 없는 오류 양상이 발생하기 때문입니다.
간단한 설명
의학적 상태를 진단하는 과정을 생각해 보세요. 생체 징후(심박수, 혈압, 체온)는 지표입니다. 이 지표들은 무언가 비정상적이라는 사실을 알려줍니다. 진료 기록과 검사 결과는 기록입니다. 이 기록들은 현재 어떤 상황이 벌어지고 있는지에 대한 구체적인 세부 정보를 제공합니다. MRI나 CT 촬영은 영상입니다. 이 영상은 신체 내부의 전체적인 모습을 보여주므로 의사가 문제가 있는 위치를 정확히 파악할 수 있게 해줍니다.
블록체인 인프라에서도 동일한 진단 문제에 직면하게 됩니다. 애플리케이션은 프론트엔드, 백엔드, RPC 엔드포인트, 블록체인 노드, 그리고 체인 자체에 걸쳐 분산되어 있습니다. 각 계층은 독립적으로 오류가 발생하거나 성능이 저하될 수 있습니다. 메트릭을 통해 무언가 문제가 발생했음을 알 수 있습니다(지연 시간이 급증함). 로그는 무엇이 잘못되었는지(특정 RPC 메서드가 오류를 반환함) 알려줍니다. 트레이스는 요청 경로 중 어디에서 문제가 발생했는지(노드가 복잡한 계약에 대한 eth_call을 처리하는 데 3초가 소요됨) 알려줍니다.
모니터링과 가시성(Observability)의 차이점은 무엇인가요?
모니터링과 가시성은 관련이 있지만 별개의 개념입니다. 모니터링은 알려진 신호를 감시하며, 미리 정의된 임계값을 초과할 때 이를 알려줍니다. 가시성은 시스템에서 생성되는 데이터를 활용하여, 예상치 못한 문제에 대해서도 시스템에 대한 새로운 질문을 던질 수 있는 더 광범위한 능력을 말합니다. 메트릭, 로그, 트레이스는 가시성의 원재료입니다. 이 세 가지를 종합하면 “무언가 잘못되었다”는 수준에서 “정확히 왜 그런가”를 파악할 수 있게 됩니다. 더 심층적인 입문 정보를 원하시면, 당사의 블록체인 가시성 개요를 참고하시기 바랍니다.
메트릭, 로그, 트레이스는 어떻게 다른가?
각 기둥은 서로 다른 질문에 답하며, 각각 다른 비용이 수반됩니다. 아래 표는 각 기둥을 언제 활용해야 하는지 요약한 것입니다.
차원 | 지표 | 로그 | 흔적 |
|---|---|---|---|
데이터 유형 | 합계 수치 | 시간 기록이 있는 이벤트 | 연결된 요청 범위 |
가장 좋은 질문 | 무슨 문제라도 있나요? | 무엇이 잘못된 걸까요? | 어디서 문제가 생긴 걸까? |
보관 비용 |
블록체인 시스템의 경우, 이러한 핵심 요소들은 노드 상태, 동기화 상태, RPC 동작 등을 모니터링하는 광범위한 인프라 모니터링을 기반으로 합니다.
지표 상세 정보
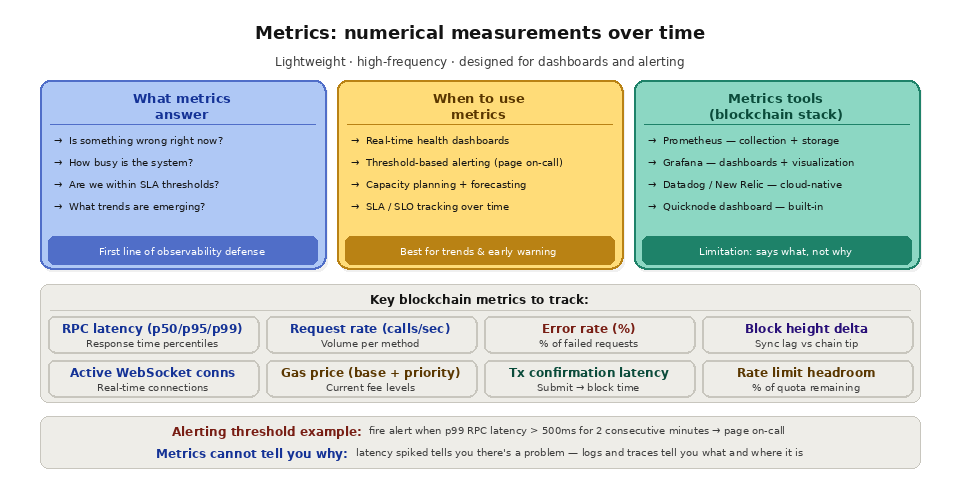
메트릭은 정기적인 간격으로 수집되고 시간 경과에 따라 집계되는 수치입니다. 메트릭은 용량이 작고 저장 효율이 높으며, 고주파수 수집에 적합하도록 설계되었습니다. 일반적인 블록체인 애플리케이션은 RPC 요청률(메서드별 초당 요청 수), 응답 지연 시간(p50, p95, p99 백분위수), 오류율(200이 아닌 상태 코드를 반환하는 요청의 비율), 블록 높이 차이(노드의 최신 블록과 체인 끝점 간의 차이), 활성 WebSocket 연결 수, 가스 가격(현재 기본 수수료 및 우선순위 수수료 수준), 거래 확인 지연 시간 등의 메트릭을 추적합니다.
메트릭은 관측 가능성의 첫 번째 방어선입니다. 메트릭은 시스템 상태가 정상인지 한눈에 파악할 수 있는 실시간 대시보드를 구동합니다. 또한 특정 값이 임계값을 초과할 경우 당직 엔지니어에게 알림을 보내는 경보 규칙을 작동시킵니다. 아울러 리소스 사용량과 트래픽 패턴의 장기적인 추세를 보여줌으로써 용량 계획을 수립할 수 있게 해줍니다.
블록체인 생태계의 표준 메트릭스 스택은 일반적으로 데이터 수집 및 저장을 위한 Prometheus, 시각화 및 대시보드 생성을 위한 Grafana, 그리고 알림 라우팅을 위한 Alertmanager 또는 PagerDuty로 구성됩니다. 클라우드 네이티브 대안으로는 Datadog, New Relic, AWS CloudWatch 등이 있습니다. 이러한 도구들은 모두 메트릭스 데이터의 대량 처리 및 시계열 특성을 처리할 수 있도록 설계되었습니다.
메트릭의 한계는 집계된 정보라는 점입니다. 메트릭을 통해 p99 RPC 지연 시간이 500ms를 초과했다는 사실은 알 수 있지만, 구체적으로 어떤 요청이 느렸는지, 해당 요청의 매개변수가 무엇이었는지, 또는 지연이 발생했을 때 노드가 어떤 작업을 수행 중이었는지는 알 수 없습니다. 이러한 세부 정보를 파악하려면 로그와 트레이스가 필요합니다.
상세 로그
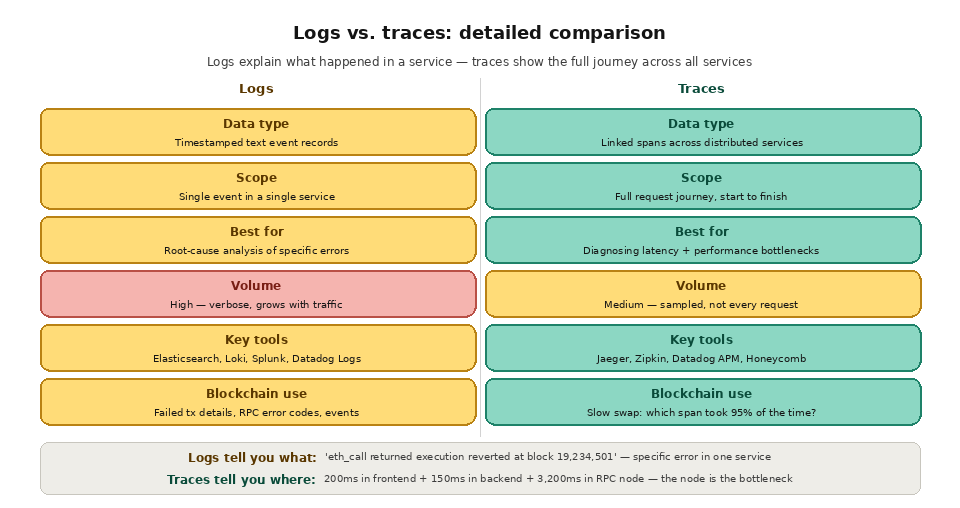
로그는 개별 이벤트에 대한 타임스탬프가 포함된 텍스트 기록입니다. 애플리케이션이 RPC 호출을 수행하거나, 트랜잭션을 처리하거나, 오류가 발생하거나, 사용자 동작을 처리할 때마다 로그 항목이 해당 세부 정보를 기록합니다. (특정 기간 동안 집계된 수치인) 메트릭과 달리, 로그는 풍부한 컨텍스트를 포함하는 개별 기록입니다. 여기에는 전체 요청 매개변수, 정확한 오류 메시지, 스택 트레이스, 사용자 ID, 트랜잭션 해시 등이 포함됩니다.
블록체인 애플리케이션에서 중요한 로그 범주로는 RPC 요청 로그(메서드, 매개변수, 응답 코드, 요청별 지연 시간), 트랜잭션 라이프사이클 로그(해시, 보류 중 → 확인됨 → 완료됨으로의 상태 전환), 스마트 계약 이벤트 로그(계약에서 디코딩된 이벤트 및 전체 매개변수 데이터), 오류 로그(RPC 오류, 타임아웃 예외, 논스 충돌, 가스 추정 오류), 애플리케이션 로그(사용자 인증 이벤트, 비즈니스 로직 결정, 상태 변경) 등이 있습니다.
로그는 근본 원인 분석을 위한 주요 도구입니다. 메트릭을 통해 오류율이 증가했다는 알림을 받으면, 로그에서 최근 오류 항목을 조회하고 오류 유형별로 필터링하여 패턴을 파악합니다. 노드가 상태 데이터를 정리한 탓에 특정 RPC 메서드가 “트리 노드 누락(missing trie node)” 오류를 반환하기 시작했을 수도 있습니다. 또는 동시 처리 버그로 인한 논스(nonce) 충돌 때문에 트랜잭션 제출이 실패하고 있을 수도 있습니다. 로그에는 메트릭으로는 파악할 수 없는 구체적인 정보가 담겨 있습니다.
로그 관리 도구로는 Kibana가 포함된 Elasticsearch(이하 “ELK 스택”), Grafana Loki, Splunk, Datadog Logs, AWS CloudWatch Logs 등이 있습니다. 이러한 도구들은 대규모로 로그 항목을 저장, 색인화 및 검색하여, 전체 텍스트 검색, 구조화된 쿼리, 그리고 서비스 간 상관 관계 분석을 가능하게 합니다.
로그 사용 시 고려해야 할 점은 저장 용량과 비용입니다. 트래픽이 많은 애플리케이션의 모든 RPC 요청을 로깅하면 하루에 기가바이트 단위의 데이터가 생성됩니다. 구조화된 로깅(로그 항목이 일관된 필드 이름을 가진 JSON 형식으로 구성되는 방식)은 비구조화된 텍스트 로그보다 더 효율적인 색인 생성 및 쿼리 처리가 가능하며, 로그 샘플링(일상적인 이벤트 중 일부만 기록하는 방식)을 통해 오류 및 이상 현상에 대한 가시성을 유지하면서 데이터 용량을 줄일 수 있습니다.
자세히 살펴보는 흔적들
트레이스는 분산 시스템을 통과하는 단일 요청의 종단 간 경로를 포착합니다. 트레이스는 여러 스팬으로 구성되며, 각 스팬은 특정 서비스 내의 작업 단위를 나타냅니다. 스팬은 계층적으로 중첩되어 있으며(전체 요청을 나타내는 부모 스팬, 각 하위 작업을 나타내는 자식 스팬), 공통의 트레이스 ID로 연결됩니다.
블록체인 애플리케이션의 경우, 단일 트레이스에는 다음과 같은 스팬이 포함될 수 있습니다. 사용자가 브라우저에서 “스왑(swap)”을 클릭함(프론트엔드 스팬, 50ms), 프론트엔드가 백엔드에 API 요청을 전송함(네트워크 스팬, 20ms), 백엔드가 가스 비용 추정을 위해 RPC endpoint 를 호출함 (RPC 스팬, 150ms), 백엔드가 트랜잭션 제출을 위해 RPC endpoint 를 호출(RPC 스팬, 200ms), 백엔드가 트랜잭션 수신 여부를 폴링(여러 RPC 스팬, 총 12,000ms), 백엔드가 프론트엔드에 확인을 전송(네트워크 스팬, 15ms), 프론트엔드가 UI를 업데이트(프론트엔드 스팬, 30ms)하는 과정을 포착할 수 있습니다. 이 트레이스를 보면 전체 시간의 95%가 애플리케이션 자체 코드가 아닌 온체인 확인을 기다리는 데 소요된 것으로 나타납니다.
분산 추적은 시스템 내를 통과하는 모든 요청에 추적 컨텍스트(추적 ID 및 스팬 ID)를 주입함으로써 구현됩니다. 각 서비스는 자체 작업에 대한 스팬을 생성하고, 이 추적 컨텍스트를 하류 서비스로 전달합니다. OpenTelemetry와 같은 추적 라이브러리는 대부분의 프로그래밍 언어와 프레임워크에 대해 표준화된 계측 기능을 제공합니다. Jaeger, Zipkin, Datadog APM과 같은 시각화 도구는 각 스팬의 타이밍과 중첩 관계를 보여주는 폭포형 다이어그램 형태로 추적을 표시합니다.
트레이스는 분산 아키텍처에서 지연 문제를 진단하는 데 가장 유용합니다. 사용자가 트랜잭션 확인에 30초가 걸렸다고 보고할 때, 트레이스를 통해 그 30초가 정확히 어디에 소요되었는지 확인할 수 있습니다. 즉, 블록 포함을 기다리는 데 25초, RPC 호출에 3초, 백엔드 처리에 1.5초, 프론트엔드 렌더링에 500ms가 소요된 것입니다. 이 경우 백엔드 코드를 최적화해도 소용이 없다는 것을 즉시 알 수 있습니다. 병목 현상은 체인 수준의 확인 시간에 있기 때문입니다.
세 가지를 모두 함께 사용하기
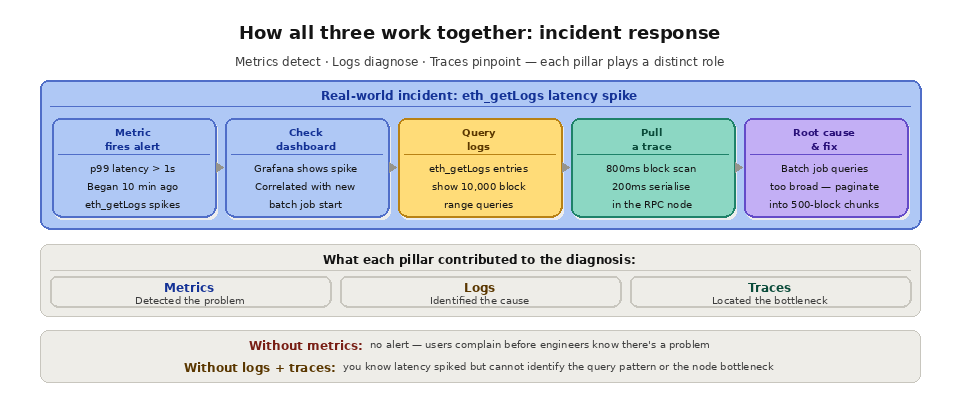
이 세 가지 축은 서로 경쟁 관계가 아니라 상호 보완적입니다. 일반적인 사고 대응 워크플로에서는 이 세 가지를 모두 활용합니다.
메트릭 알림이 발생합니다. p99 RPC 지연 시간이 1초를 초과했습니다. Grafana 대시보드를 열어 보니, 지연 시간 급증이 10분 전부터 시작되었으며 eth_getLogs 호출의 급증과 연관되어 있음을 확인합니다. 최근 eth_getLogs 요청에 대해 로그를 조회해 본 결과, 같은 시간에 새로운 배치 작업이 시작되어 각각 10,000개의 블록에 걸친 광범위한 로그 쿼리를 수행하고 있음을 알게 됩니다. 이 요청 중 하나에 대한 추적을 확인해 보니, RPC 노드가 블록 스캔에 800ms, 응답 직렬화에 200ms를 소요했음을 알 수 있습니다. 근본 원인은 분명합니다. 배치 작업의 지나치게 광범위한 로그 쿼리가 노드 리소스를 불균형하게 소모하고 있는 것입니다. 해결책은 쿼리를 더 작은 블록 범위로 분할하는 것입니다.
메트릭이 없다면, 사용자가 불만을 제기하기 전까지는 문제가 있다는 사실조차 알 수 없을 것입니다. 로그가 없다면, 지연 시간이 증가했다는 사실은 알 수 있겠지만, 어떤 요청이 그 원인이었는지는 알 수 없을 것입니다. 트레이스가 없다면, eth_getLogs의 처리 속도가 느리다는 사실은 알 수 있겠지만, 병목 현상이 애플리케이션, 네트워크, 아니면 노드의 블록 스캔 중 어디에서 발생하는지는 알 수 없을 것입니다.
어떤 기둥부터 시작해야 할까요?
관측 기능을 자체적으로 구축하고 있다면, 먼저 메트릭부터 시작하세요. 메트릭은 수집 비용이 저렴할 뿐만 아니라 대시보드와 알림 기능을 통해 문제를 즉시 파악할 수 있기 때문입니다. 그 다음에는 구조화된 로그를 추가하여 메트릭을 통해 드러난 문제를 조사할 수 있도록 하세요. 시스템이 여러 서비스에 걸쳐 있고 지연 시간이 발생하는 지점을 정확히 파악해야 할 때는 분산 추적을 도입하세요. 특히 블록체인의 경우, 이를 RPC 지연 시간 추적과 결합하면 운영 환경에서 가장 예기치 못한 문제가 발생할 가능성이 높은 계층을 포괄적으로 다루게 됩니다.
Quicknode 가 세 가지 핵심 축을 어떻게 뒷받침하는지
Quicknode이 대시보드는 모든 endpoint 에 대해 요청량, 응답 지연 시간, 오류율, 메서드별 세부 정보 등 내장된 지표들을 제공합니다. 이러한 지표를 통해 개발자는 별도의 계측 작업 없이도 블록체인 인프라 계층에 대한 즉각적인 가시성을 확보할 수 있습니다.
기존 가시성 스택에 블록체인 메트릭을 통합하려는 팀을 위해, Quicknode 의 전용 Clusters 는 Prometheus Exporter를 지원하여 노드 수준 메트릭을 Prometheus, Grafana, Datadog 또는 기타 호환 가능한 시스템으로 직접 수집할 수 있게 합니다. 이를 통해 애플리케이션 메트릭과 블록체인 인프라 메트릭을 아우르는 통합 대시보드를 구축할 수 있습니다.
Quicknode Streams 전달 지표, 처리 상태, 오류 보고 등을 포함하여 데이터 파이프라인의 상태에 대한 가시성을 제공합니다. RPC 분석 기능과 개발자가 직접 구현한 애플리케이션 수준의 로깅 및 추적 기능을 결합한 ‘ Quicknode ’는 개발자에게 블록체인 스택의 모든 계층에 걸쳐 문제를 진단하고 해결하는 데 필요한 포괄적인 가시성을 제공합니다.
자주 묻는 질문
메트릭, 로그, 트레이스는 모니터링과 같은 것입니까?
아닙니다. 그것들은 기본 데이터 유형입니다. 모니터링은 미리 정의된 신호를 관찰하고 이에 대해 경고를 발령하는 과정인 반면, 관측 가능성은 이 세 가지 데이터 유형을 활용하여 사전에 예측하지 못한 문제를 조사하는 것입니다.
이 세 가지 중 보관 비용이 가장 비싼 것은 무엇일까요?
로그는 모든 개별 이벤트를 아주 상세하게 기록하기 때문에 대개 비용이 가장 많이 듭니다. 메트릭은 집계 과정 덕분에 비용이 가장 적게 들며, 트레이스는 일반적으로 모든 요청에 대해 데이터를 수집하기보다는 표본 추출 방식으로 처리되기 때문에 그 중간 정도에 해당합니다.
작은 애플리케이션을 만들려면 이 세 가지가 모두 필요한가요?
처음부터는 아닙니다. 대부분의 팀은 메트릭과 기본 로그부터 시작합니다. 요청이 여러 서비스를 거치게 되고, 지연 시간을 특정 구성 요소 하나로만 돌리기 어려워질 때 비로소 분산 추적이 그 가치를 발휘합니다.
OpenTelemetry란 무엇인가요?
OpenTelemetry는 벤더 중립적인 방식으로 메트릭, 로그 및 트레이스를 생성하기 위한 개방형 표준이자 라이브러리 모음입니다. 이를 통해 한 번만 계측을 수행하면 Prometheus, Jaeger, Datadog 등 다양한 백엔드로 데이터를 내보낼 수 있습니다.
이것이 특히 블록체인 RPC에는 어떻게 적용되는 건가요?
RPC 호출은 지연 시간과 오류의 흔한 원인이므로, 요청 빈도, 지연 시간 백분위수, 오류 코드를 지표로 추적하고, 실패한 호출을 로그에 기록하며, 느린 요청을 종단 간으로 추적하면 전체 상황을 명확히 파악할 수 있습니다. ‘Node 안정성 가이드’에서 다룬 바와 같이, 안정적인 Node 인프라를 구축하면 애초에 진단해야 할 사고의 발생 빈도를 줄일 수 있습니다.
추가 자료
메트릭 vs 로그 vs 트레이스 - Quicknode 문서
블록체인 인프라 모니터링 - Quicknode 용어집
Quicknode 코어 API
Quicknode 전용 Clusters
