TL;DR: Blockchains können auf drei Ebenen ausfallen. Zu den Ausfällen auf der Konsens-Ebene zählen Fehler bei Validatoren, Netzwerkpartitionen und 51-Prozent-Angriffe. Zu den Ausfällen auf der Anwendungsebene zählen Fehler in Smart Contracts, Manipulationen von Oracles und Ausnutzung von Sicherheitslücken in der Governance. Zu den Ausfällen auf der Infrastruktur-Ebene zählen Knotenausfälle, Ausfälle von Anbietern und Cloud-Vorfälle. Jede Ebene benötigt eigene Schutzmaßnahmen. Diese Ausfälle sind von großer Bedeutung, da in Blockchain-Anwendungen echtes Geld bewegt wird – ein Ausfall kostet daher weitaus mehr als bei herkömmlicher Software.
Die einfache Erklärung
Blockchains werden oft als vertrauenslos und „ immutable “ bezeichnet. Das bedeutet jedoch nicht, dass sie nicht ausfallen können. Wie jedes komplexe verteilte System kann auch eine Blockchain auf vielfältige Weise und auf vielen Ebenen ausfallen.
Der entscheidende Punkt für Entwickler ist, dass sich Fehler schichtweise auftürmen. Selbst ein sicherer Smart Contract kann noch immer Nutzergelder verlieren, wenn jemand das Orakel manipuliert, das ihm Daten liefert. Selbst eine gut programmierte App kann noch immer ausfallen, wenn die ihr zugrunde liegenden Knoten ausfallen.
Stellen Sie sich das wie ein Gebäude vor. Das Fundament (Konsensschicht) könnte Risse bekommen. Die Wasser- und Stromleitungen (Anwendungsschicht) könnten undicht werden oder einen Kurzschluss verursachen. Der Hausverwalter (Infrastrukturschicht) könnte in Konkurs gehen. Jeder Ausfall erfordert eine andere Art von Schutz, und ein widerstandsfähiges System schützt gleichzeitig vor allen drei Risiken.
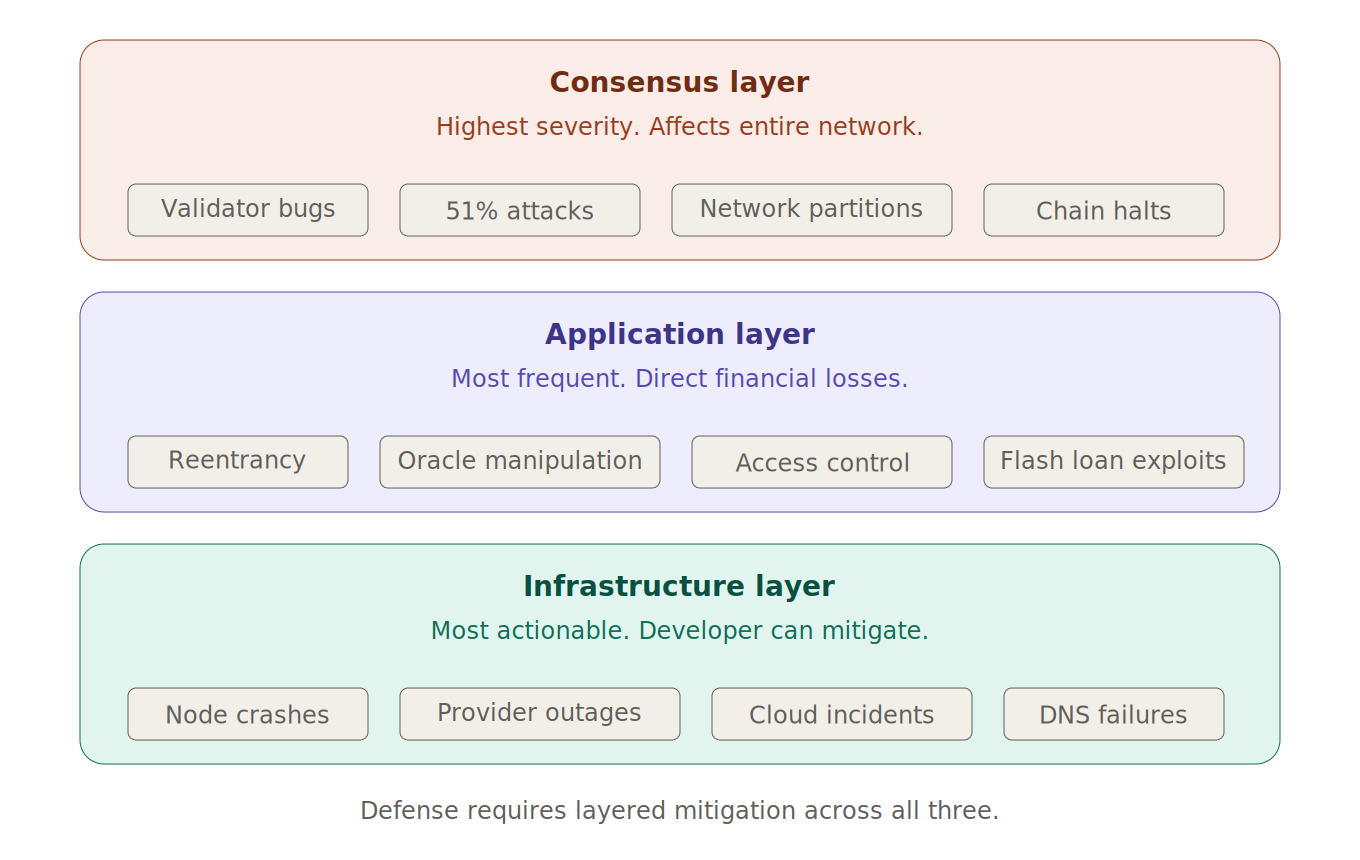
Fehler auf der Konsens-Ebene
Die Konsensschicht bildet das Fundament jeder Blockchain. Über sie einigen sich die Validatoren darauf, welche Transaktionen gültig sind und welche Blöcke in die Kette aufgenommen werden. Wenn der Konsens scheitert, sind die Folgen so gravierend wie in keiner anderen Schicht: Die Kette kann zum Stillstand kommen, sich neu organisieren oder widersprüchliche Blöcke erzeugen.
Fehler bei Validatoren gehören zu den häufigsten Ursachen für Konsensausfälle. Blockchain-Client-Software ist komplex. Ein Fehler bei der Blockerstellung, der Beglaubigungslogik oder den Zustandsübergängen kann dazu führen, dass Validatoren ungültige Blöcke erzeugen, mitten in einer Runde abstürzen oder sich nicht über den korrekten Zustand einigen können.
Das Risiko steigt, wenn ein Client das Netzwerk dominiert. Wenn 70 % der Validatoren denselben Client verwenden und dieser Client einen Fehler aufweist, fällt 70 % des Netzwerks auf einmal aus. Aus diesem Grund spielt die Client-Vielfalt – also mehrere unabhängige Implementierungen desselben Protokolls – in der Blockchain-Sicherheit eine so wichtige Rolle.
Netzwerkpartitionen treten auf, wenn Gruppen von Validatoren nicht mehr miteinander kommunizieren können. Häufige Ursachen sind Internetausfälle, gezielte DDoS-Angriffe und Routing-Fehler.
Wenn keine der beiden Seiten der Abspaltung die Konsensschwelle (in der Regel zwei Drittel des eingesetzten Gewichts) erreicht, wird die Blockproduktion eingestellt.
Wenn beide Seiten die Schwelle weiterhin erreichen können, kommt es für eine gewisse Zeit zu einer Kettenaufspaltung, und jede Seite erzeugt ihre eigenen Blöcke.
Sobald die Netzwerkverbindung wiederhergestellt ist, wird die Verzweigung durch eine Reorganisation aufgelöst. Transaktionen auf der kürzeren Verzweigung werden rückgängig gemacht.
Bei 51-Prozent-Angriffen (bzw. 34-Prozent-Angriffen auf BFT-basierte Blockchains) kann ein Angreifer, der über die Mehrheit der Konsensmacht verfügt, die jüngste Historie umschreiben. Und so funktioniert es:
Der Angreifer erstellt eine private Blockchain, die von der öffentlichen abzweigt.
Die private Blockchain sammelt mehr Proof-of-Work-Nachweise oder Validator-Bestätigungen als die öffentliche Blockchain.
Der Angreifer sendet sie im Netzwerk. Da sie ein höheres Gewicht hat, akzeptiert das Netzwerk sie und verwirft die jüngsten Blöcke der öffentlichen Blockchain.
Dies ermöglicht eine doppelte Ausgabe. Der Angreifer sendet Geld auf der öffentlichen Blockchain und wartet auf die Bestätigung. Anschließend veröffentlicht er eine private Blockchain, in der diese Transaktion nicht enthalten ist. Er erhält die Ware und behält das Geld.
Ausfälle auf Anwendungsebene
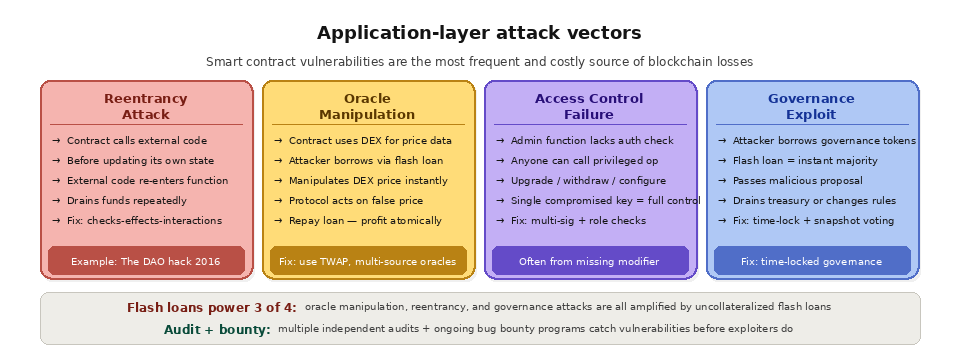
Die Anwendungsschicht umfasst Smart Contracts, DeFi-Protokolle, Oracles und die On-Chain-Logik, die Nutzergelder in Höhe von mehreren Milliarden Dollar verwaltet. Hier treten am häufigsten Fehler auf, die zudem die höchsten Kosten verursachen.
Reentrancy-Angriffe zielen auf einen Vertrag ab, der einen anderen Vertrag aufruft, bevor er seinen eigenen Status aktualisiert. Der aufgerufene Vertrag kann erneut in den ursprünglichen Vertrag „eintreten“ und dieselbe Funktion erneut ausführen, bevor die Aktualisierung wirksam wird, wodurch Gelder abgezogen werden können.
Der DAO-Hack von 2016 war ein Reentrancy-Angriff. Er verursachte Verluste in Höhe von etwa 60 Millionen US-Dollar und führte zur Spaltung in Ethereum und Ethereum Classic. Die Schwachstelle ist seit Jahren bekannt, taucht jedoch immer noch in neuen Verträgen auf, die das „Checks-Effects-Interactions“-Muster außer Acht lassen.
Ein Integer-Überlauf und -Unterlauf treten auf, wenn eine mathematische Operation eine Zahl erzeugt, die außerhalb des Bereichs liegt, den der Datentyp aufnehmen kann, sodass der Wert umläuft. Eine Subtraktion, die zu einem negativen Ergebnis führen sollte, könnte stattdessen eine extrem große positive Zahl zurückgeben, wodurch ein Angreifer mehr Token beanspruchen könnte, als ihm zustehen. Mit Solidity 0.8.0 wurden integrierte Prüfungen hinzugefügt, die bei einem Überlauf die Transaktion rückgängig machen. Kontrakte, die mit älteren Versionen erstellt wurden oder die Blöcke mit ungeprüfter Mathematik verwenden, sind weiterhin gefährdet.
Fehler bei der Zugriffskontrolle treten auf, wenn Admin-Funktionen nicht prüfen, wer sie aufruft. Dann kann jeder Funktionen ausführen, die eigentlich nur für den Vertragsinhaber oder eine bestimmte Rolle bestimmt sind. Häufige Beispiele:
Ungeschützte Upgrade-Funktionen, die es jedem ermöglichen, die Logik des Vertrags zu ändern
Auszahlungsfunktionen ohne Eigentumsprüfung
Falsch eingerichtete rollenbasierte Zugriffsrechte
Die Manipulation von Orakeln ist besonders gefährlich, da sie die Verbindung zwischen On-Chain- und Off-Chain-Daten angreift. Kontrakte, die Preisorakel für Kreditvergabe, Zwangsliquidationen oder Derivate nutzen, können dazu gebracht werden, auf der Grundlage eines gefälschten Preises zu handeln.
Flash-Kredite sind das am häufigsten verwendete Mittel. In einer einzigen atomaren Transaktion führt der Angreifer Folgendes aus:
Lehnt sich eine große Menge an Token aus
Nutzt sie, um den Kurs auf einer DEX zu beeinflussen, die das Orakel ausliest
Löst beim Zielprotokoll eine gewinnbringende Aktion zum gefälschten Preis aus
Zahlt das Darlehen zurück
Der betreffende Smart Contract hat genau das getan, wofür er entwickelt wurde. Der Fehler lag im Design des Oracles, das kurzfristige Kursschwankungen nicht berücksichtigt hatte.
Governance-Exploits zielen auf die Abstimmungssysteme von DAOs und DeFi-Protokollen ab. Ein Angreifer verschafft sich – häufig mithilfe eines Flash-Kredits – genügend Governance-Token, um einen böswilligen Vorschlag durchzusetzen. Dieser Vorschlag könnte die Kasse leerräumen, Protokolleinstellungen ändern, um eine Sicherheitslücke zu schaffen, oder dem Angreifer Administratorrechte verschaffen.
Ausfälle auf der Infrastruktur-Ebene
Infrastrukturausfälle beeinträchtigen nicht die Blockchain selbst. Sie beeinträchtigen vielmehr die Möglichkeit von Apps und Nutzern, auf sie zuzugreifen. Für einen Entwickler oder Endnutzer sieht das Ergebnis genauso aus wie ein Ausfall der Blockchain: Die App funktioniert nicht mehr.
Knotenabstürze und Synchronisierungsfehler führen dazu, dass Knoten offline gehen oder veraltete Daten ausgeben. Ein Knoten, der mehrere Blöcke hinter der Kettenspitze zurückfällt, gibt alte Guthaben an, übersieht aktuelle Transaktionen und lehnt möglicherweise gültige Transaktionen ab, die vom aktuellen Zustand abhängen. Eine App, die auf einen einzigen Knoten ohne Ausfallsicherung angewiesen ist, fällt aus, sobald dieser Knoten ausfällt.
Ausfälle bei Anbietern betreffen alle Kunden eines Anbieters gleichzeitig. Wenn ein großer RPC-Anbieter ausfällt, verlieren alle Apps, die dessen Endpunkte nutzen, den Zugriff auf die Kette. Dies stellt ein Zentralisierungsrisiko innerhalb eines Systems dar, das eigentlich dezentralisiert sein soll: Wenn Tausende von Apps denselben Anbieter nutzen, wird dieser Anbieter zu einem Single Point of Failure.
Störungen bei Cloud-Anbietern wirken sich wie bei jedem anderen Cloud-Dienst auch auf Blockchain-Knoten aus. Wenn es bei AWS, GCP oder einem anderen Cloud-Anbieter zu einem regionalen Ausfall kommt, gehen alle Knoten in dieser Region offline. Da ein großer Teil der Blockchain-Knoten bei wenigen Cloud-Anbietern betrieben wird, kann ein einziger Cloud-Ausfall die Netzwerkstabilität und die Verfügbarkeit von Anwendungen weitaus stärker beeinträchtigen, als man erwarten würde.
DNS- und Netzwerkausfälle können dazu führen, dass Apps ihre RPC-Endpunkte nicht erreichen können, selbst wenn diese einwandfrei funktionieren. DNS-Hijacking, Probleme beim BGP-Routing und Probleme mit TLS-Zertifikaten können die Verbindung zwischen einer App und ihrer Infrastruktur unterbrechen.
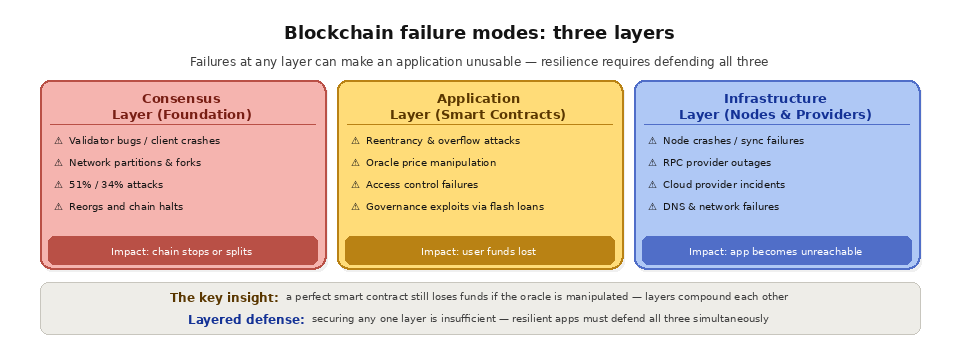
Maßnahmen zur Risikominderung
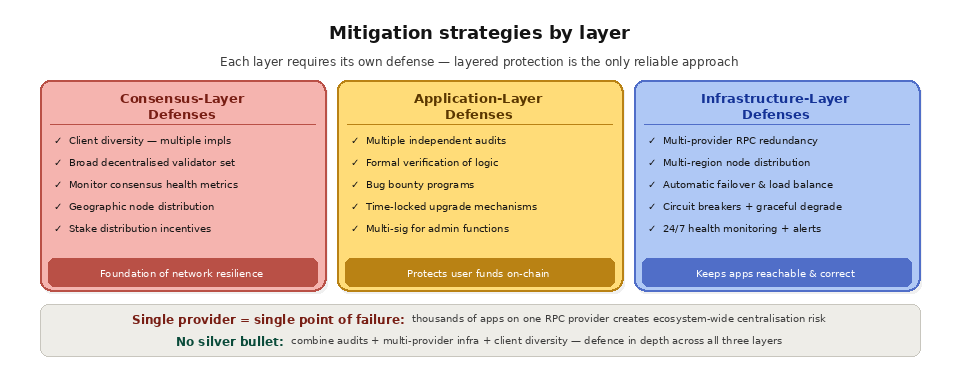
Um sich gegen diese Ausfälle zu schützen, ist ein mehrschichtiger Ansatz erforderlich, der alle drei Ebenen abdeckt.
Auf der Konsens-Ebene ist die Vielfalt der Clients der wirksamste Schutz. Bei mehreren Client-Implementierungen führt ein Fehler in einem einzelnen Client nicht zum Ausfall des gesamten Netzwerks. Auch die Verteilung der Stakes spielt eine Rolle: Eine breite, dezentrale Validatorengruppe senkt das Risiko koordinierter Ausfälle und 51-Prozent-Angriffe.
Auf der Anwendungsebene bestehen die wichtigsten Abwehrmaßnahmen aus Sicherheitsaudits, formaler Verifikation und Bug-Bounty-Programmen:
Lassen Sie Smart Contracts vor ihrer Bereitstellung von mehreren unabhängigen Unternehmen prüfen.
Nutzen Sie die formale Verifikation, um mathematisch nachzuweisen, dass der Code der Spezifikation entspricht. So lassen sich Fehler aufspüren, die bei einer manuellen Überprüfung übersehen werden können.
Führen Sie Bug-Bounty-Programme durch, bei denen White-Hat-Hacker dafür bezahlt werden, Schwachstellen zu finden und verantwortungsbewusst offenzulegen.
Upgrades mit Zeitverzögerung, damit die Community Änderungen prüfen kann, bevor sie in Kraft treten. Dadurch wird verhindert, dass böswillige oder fehlerhafte Upgrades sofort live geschaltet werden.
Für Administratorfunktionen ist eine Genehmigung durch mehrere Signaturen erforderlich, damit kein einzelner gestohlener Schlüssel privilegierte Vorgänge ausführen kann.
Auf der Infrastrukturebene bildet die Redundanz über Anbieter, Regionen und Clouds hinweg die Grundlage. Verlassen Sie sich niemals auf einen einzigen RPC-Anbieter, ein einziges Rechenzentrum oder eine einzige Cloud.
Leistungsschalter schalten defekte Komponenten ab, bevor diese die davon abhängigen Systeme lahmlegen.
Dank „Graceful Degradation“ bleiben Kernfunktionen – wie die Anzeige von Kontoständen – auch dann funktionsfähig, wenn einige Komponenten ausgefallen sind.
Wie „ Quicknode “ Widerstandsfähigkeit fördert
QuicknodeDie Infrastruktur ist so ausgelegt, dass sie Ausfälle auf der Infrastrukturebene auffangen kann:
Geografische Verteilung über mehr als 14 Regionen und mehr als 5 Cloud- und Bare-Metal-Anbieter
Kundenvielfalt, sofern vorhanden
Automatisches Failover, das Anfragen von ausgefallenen Knoten umleitet
Rund-um-die-Uhr-Überwachung durch ein spezielles Blockchain-Betriebsteam equipe
Quicknode Streams sorgt für ausfallsichere Datenpipelines mit garantierter Zustellung, Verarbeitung in endgültiger Reihenfolge und automatischer Behandlung von Reorgs. Wenn ein Reorg auftritt, erkennt und korrigiert „ Streams “ die betroffenen Daten selbstständig. Für die Überwachung auf Anwendungsebene können Sie mit „ Streams “ auf bestimmte Vertragsereignisse, ungewöhnliche Transaktionsmuster und Zustandsänderungen achten, die auf einen laufenden Angriff hindeuten könnten.
Für Teams mit höchsten Anforderungen an die Verfügbarkeit bieten die dedizierten „ Quicknode “ Clusters eine isolierte Infrastruktur mit SLAs für garantierte Verfügbarkeit, die vom gemeinsamen Datenverkehr getrennt ist. Ein Datenverkehrsanstieg bei einem anderen Kunden kann Ihre Leistung nicht beeinträchtigen, wodurch geschäftskritische Anwendungen die erforderliche Isolation erhalten.
Was sind die häufigsten Arten von Blockchain-Ausfällen?
Die oben genannten Sicherheitslücken sind nach der Ebene gruppiert, in der sie ihren Ursprung haben. Anhand der Ebene lässt sich auch erkennen, wer für die Abwehr der jeweiligen Sicherheitslücke verantwortlich ist. In der folgenden Tabelle sind die häufigsten Sicherheitslücken, jeweils ein Beispiel sowie der Ort, an dem die Abhilfe zu finden ist, aufgeführt.
Ebene | Häufiger Fehler | Beispiel | Wo Klimaschutz gelebt wird |
|---|---|---|---|
Konsens | 51-Prozent-Angriff oder Reorg | Die Mehrheit schreibt die jüngste Geschichte neu | Protokoll und Validator-Set |
Konsens | Netzwerkpartitionierung oder Systemabschaltung | Validatoren können den Schwellenwert nicht erreichen | Protokoll- und Client-Vielfalt |
Wie lassen sich Blockchain-Ausfälle erkennen, bevor sie zu Verlusten führen?
Die Erkennung entscheidet darüber, ob ein Vorfall eingedämmt werden kann oder zu einer Katastrophe führt. Die kontinuierliche Überwachung der Blockchain-Infrastruktur zeigt Knotenverzögerungen, Fehlerspitzen und Synchronisationslücken in Echtzeit an. Eine umfassendere Beobachtbarkeit verknüpft diese Signale mit dem Anwendungsverhalten, sodass Sie einen Angriff oder einen Ausfall erkennen können, bevor die Nutzer davon etwas bemerken.
Was ist der Unterschied zwischen einem „Chain Halt“ und einer „Chain Reorg“?
Diese beiden Arten von Konsensfehlern lassen sich leicht verwechseln. Bei einem „Chain Halt“ wird die Blockproduktion vollständig eingestellt, da die Validatoren die Konsensschwelle nicht erreichen können, sodass keine neuen Transaktionen bestätigt werden. Bei einer Blockchain-Reorganisation werden weiterhin Blöcke produziert, jedoch werden die jüngsten Blöcke gegen eine konkurrierende Kette ausgetauscht. Dadurch können Transaktionen rückgängig gemacht werden, die zuvor als bestätigt galten.
Inwiefern verringert die Redundanz der Infrastruktur das Ausfallrisiko?
Die meisten Ausfälle der Infrastruktur lassen sich auf einen einzigen Fehlerpunkt zurückführen. Sobald man verstanden hat, warum Redundanz in der Infrastruktur wichtig ist, ergibt sich das Design von selbst: mehrere Anbieter und Regionen sowie eine automatische Ausfallsicherung, die den ausgefallenen Knoten umgeht, bevor Anfragen fehlschlagen.
Häufig gestellte Fragen
Welche drei Ebenen gibt es bei einem Blockchain-Ausfall?
Störungen entstehen entweder auf der Konsensschicht (Fehler bei Validatoren, Partitionen, 51-Prozent-Angriffe), der Anwendungsschicht (Fehler in Smart Contracts, Manipulation von Oracles, Ausnutzung von Schwachstellen im Governance-System) oder der Infrastrukturschicht (Knotenausfälle, Ausfälle von Anbietern und Cloud-Diensten). Ausfallsichere Systeme schützen vor allen drei Arten von Störungen.
Was ist die häufigste Ursache für Verluste im Zusammenhang mit der Blockchain?
Fehler auf Anwendungsebene, insbesondere Schwachstellen in Smart Contracts und Manipulationen von Oracles, sind die häufigsten und kostspieligsten. Die zugrunde liegende Blockchain funktioniert oft genau wie vorgesehen, während fehlerhafte Vertrags- oder Oracle-Logik ausgenutzt wird.
Kann ein Ausfall eines einzelnen RPC-Anbieters dazu führen, dass meine App ausfällt?
Ja. Wenn Ihre Anwendung von einem einzigen Anbieter, einem einzigen Rechenzentrum oder einer einzigen Cloud-Region abhängig ist, führt ein Ausfall an dieser Stelle dazu, dass Sie nicht mehr erreichbar sind. Durch die Verteilung des Datenverkehrs auf redundante Anbieter und Regionen mit automatischer Ausfallsicherung wird dieser einzelne Ausfallpunkt beseitigt.
Ist ein 51-Prozent-Angriff dasselbe wie eine Netzwerkpartition?
Nein. Ein 51-Prozent-Angriff ist ein gezielter Versuch einer Mehrheit der Konsensmacht, die Historie umzuschreiben, während eine Netzwerkpartition ein versehentlicher Verlust der Kommunikation zwischen den Validatoren ist. Beides kann zu Reorgs führen, doch ihre Ursachen und Abwehrmaßnahmen unterscheiden sich.
Wie schützt man sich vor Oracle-Manipulationen?
Verwenden Sie Oracles, die Preise über verschiedene Quellen und Zeiträume hinweg aggregieren, vermeiden Sie es, sich auf einen einzigen DEX-Spotpreis zu verlassen, und richten Sie Plausibilitätsprüfungen und Circuit Breaker ein. Diese Maßnahmen schwächen Flash-Loan-Angriffe ab, die einen Preis-Feed kurzzeitig verzerren.
Weiterführende Literatur
Was ist ein „Chain Halt“? – Glossar von „ Quicknode “
Was ist eine Kettengabel? – Glossar von Quicknode
Was ist eine Blockchain-Reorganisation? – Glossar von „ Quicknode “
Quicknode Ketten – Quicknode Unterstützte Ketten
Warum die Zuverlässigkeit von Knoten wichtig ist – Glossar von „ Quicknode “
