Antworten>Erfahren Sie mehr über Zuverlässigkeit und Verfügbarkeit>Warum Redundanz in der Infrastruktur wichtig ist
Warum Redundanz in der Infrastruktur wichtig ist
// Tags
Infrastruktur-Redundanz
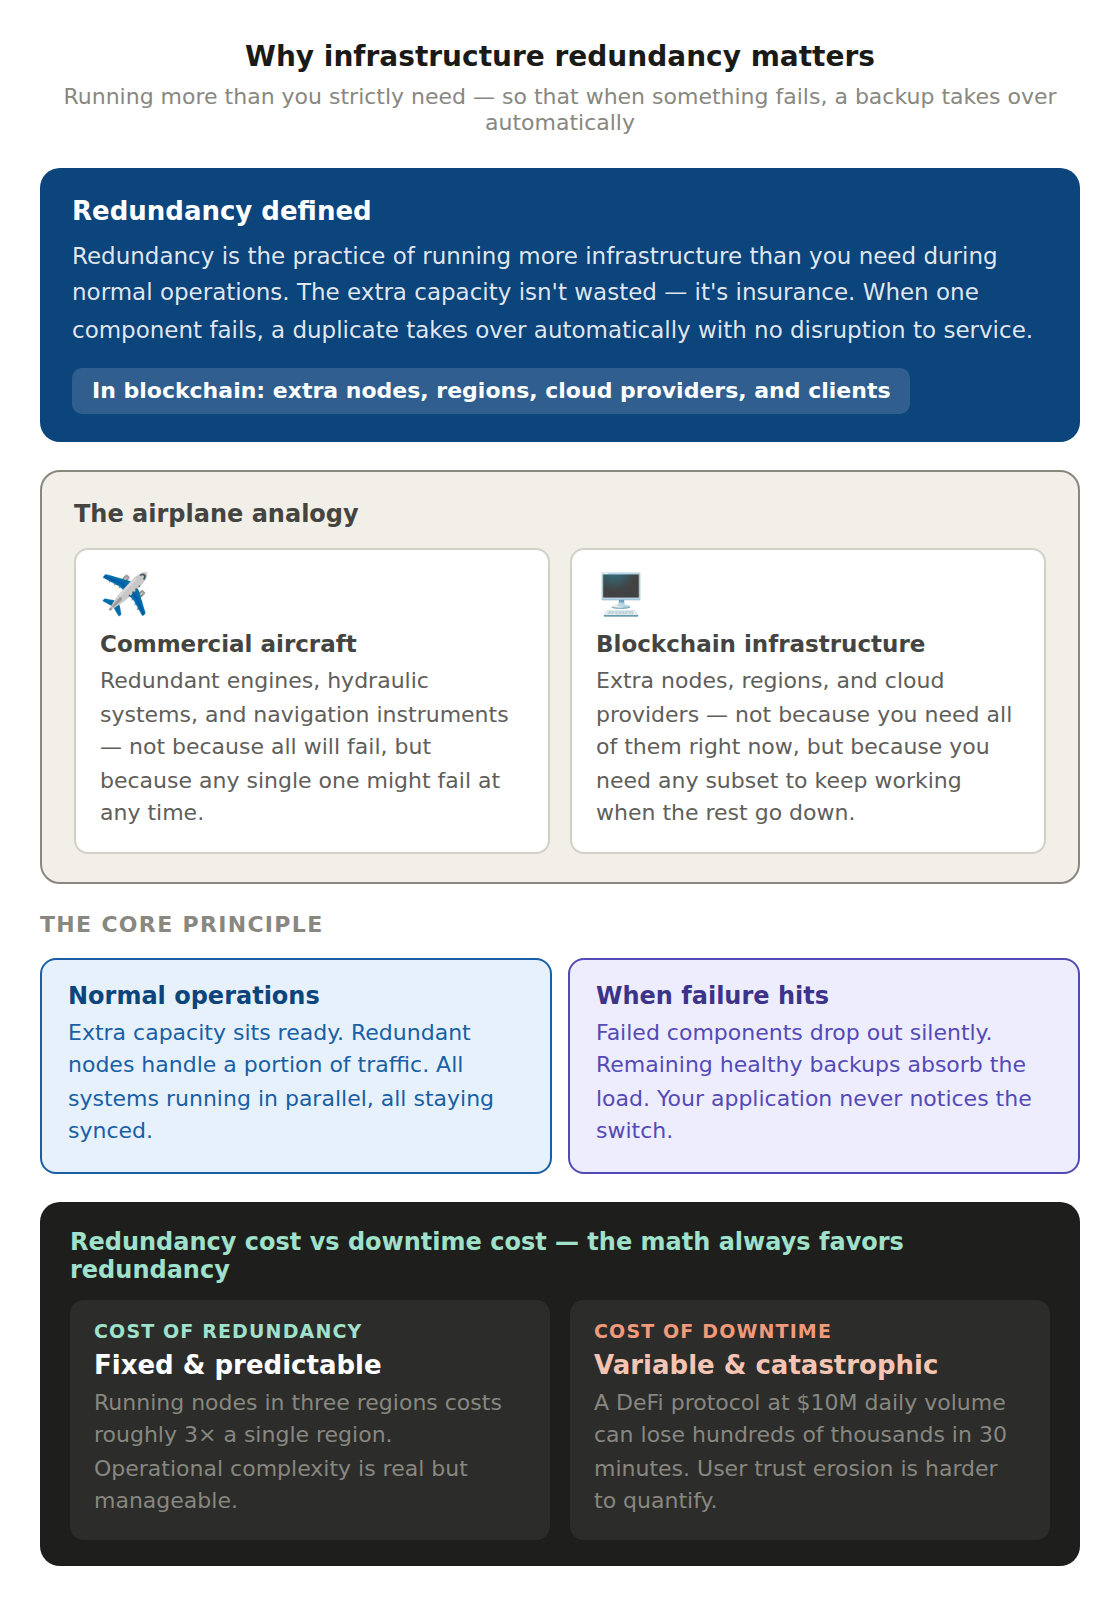
TL;DR: Redundanz bedeutet, auf jeder Ebene Ihrer Infrastruktur Reservekomponenten bereitzuhalten, sodass bei einem Ausfall automatisch ein Duplikat die Funktion übernimmt. In der Blockchain ist es die Redundanz über Knoten, Regionen, Cloud-Anbieter und Client-Implementierungen hinweg, die produktionsreife Systeme von anfälligen unterscheidet.
Was „Redundanz“ eigentlich bedeutet
Redundanz bedeutet, im Normalbetrieb mehr Ressourcen bereitzuhalten, als streng genommen benötigt werden. Diese zusätzliche Kapazität ist keine Verschwendung, sondern eine Absicherung.
Stellen Sie sich das wie bei einem Flugzeug vor. Verkehrsflugzeuge verfügen über redundante Triebwerke, redundante Hydrauliksysteme und redundante Navigationsinstrumente. Nicht, weil man davon ausgeht, dass alle gleichzeitig ausfallen, sondern weil jedes einzelne davon jederzeit ausfallen könnte. Die redundanten Systeme sorgen dafür, dass das Flugzeug auch dann weiterfliegt, wenn etwas kaputtgeht.
Bei der Redundanz der Infrastruktur gilt dasselbe Prinzip. Man betreibt zusätzliche Knoten in zusätzlichen Regionen bei zusätzlichen Cloud-Anbietern – nicht, weil man sie alle gerade jetzt benötigt, sondern weil eine beliebige Teilmenge davon weiterarbeiten muss, wenn der Rest ausfällt.
Die Ebenen der Redundanz
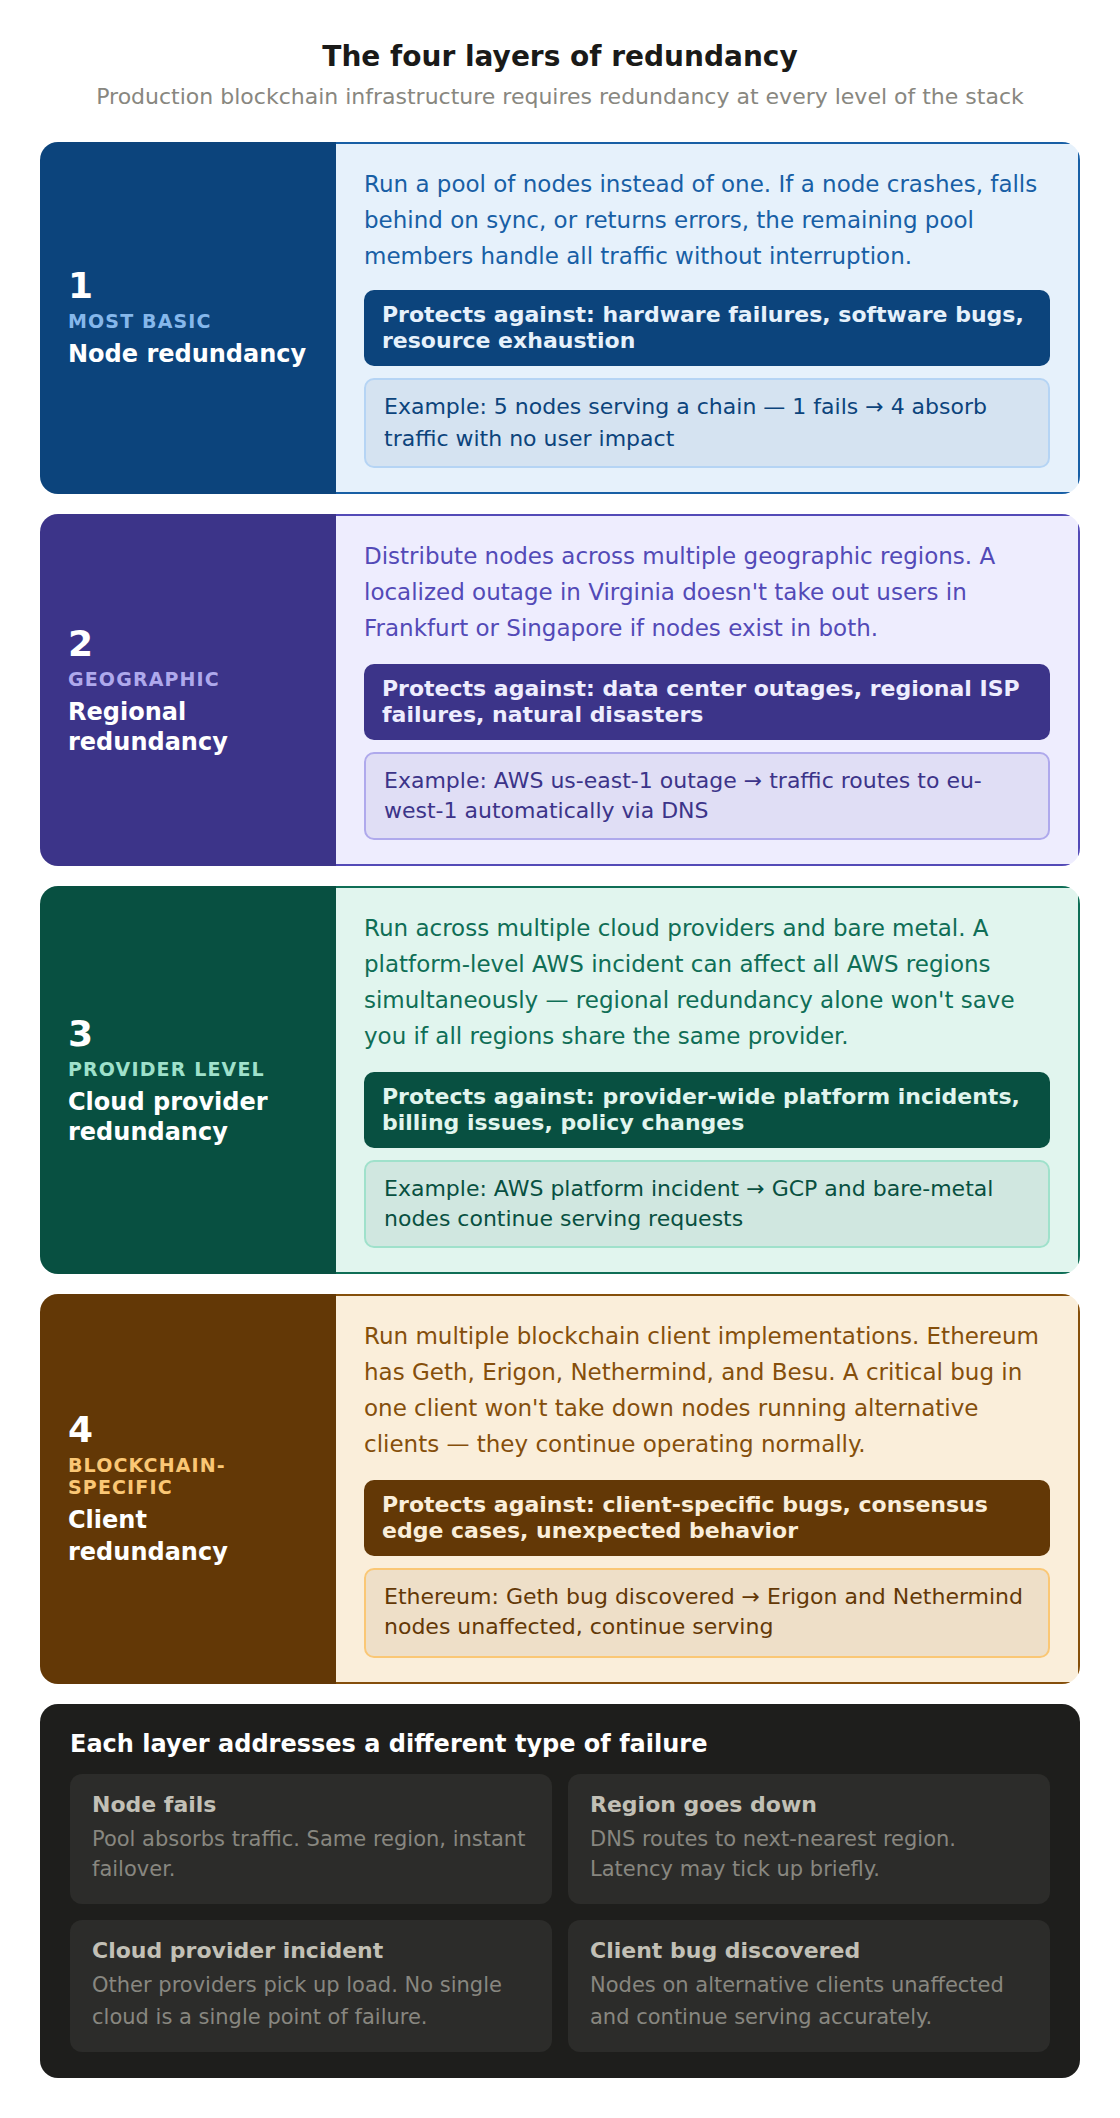
Eine Blockchain-Infrastruktur im Produktionsbetrieb erfordert Redundanz auf mehreren Ebenen. Jede Ebene ist auf eine andere Art von Ausfall ausgelegt.
Knotenredundanz ist die grundlegendste Form. Anstatt sich bei einer bestimmten Blockchain auf einen einzigen Knoten zu verlassen, betreibt man einen Pool aus mehreren Knoten. Wenn ein Knoten ausfällt, bei der Synchronisierung in Verzug gerät oder Fehler meldet, übernehmen die verbleibenden Knoten im Pool den Datenverkehr. Dies schützt vor einzelnen Hardwareausfällen, Softwarefehlern in einem bestimmten Knotenprozess oder der Erschöpfung der Ressourcen auf einem einzelnen Rechner.
Regionale Redundanz schützt vor größeren Ausfällen. Wenn alle Ihre Knoten in einer einzigen AWS-Region betrieben werden und es in dieser Region zu einem Ausfall kommt (was häufiger vorkommt, als den meisten Menschen bewusst ist), fällt das gesamte System gleichzeitig aus. Durch die Verteilung der Knoten auf mehrere geografische Regionen wird sichergestellt, dass ein lokales Ereignis in Virginia nicht dazu führt, dass Ihre Nutzer in Frankfurt oder Singapur vom System abgeschnitten werden.
Die Redundanz bei Cloud-Anbietern geht noch einen Schritt weiter. Wenn Ihre gesamte Infrastruktur bei einem einzigen Cloud-Anbieter läuft und bei diesem Anbieter ein Ausfall auf Plattformebene auftritt, reicht regionale Redundanz allein nicht aus, um Sie zu schützen. Der Einsatz mehrerer Anbieter (AWS, GCP, Bare-Metal usw.) bedeutet, dass ein anbieterspezifischer Ausfall nicht automatisch zu Ihrem Ausfall wird.
Die Client-Redundanz ist eine spezifische Eigenschaft der Blockchain. Die meisten großen Blockchains verfügen über mehrere Client-Implementierungen für Knoten. Für Ethereum gibt es Geth, Erigon, Nethermind und Besu. Für Solana gibt es den Validator-Client und Firedancer. Sollte in einem Client ein kritischer Fehler auftreten, laufen die Knoten, auf denen alternative Clients ausgeführt werden, weiterhin normal. Anbieter, die eine Vielzahl unterschiedlicher Clients einsetzen, sind widerstandsfähiger gegenüber Ausfällen auf Softwareebene.
Was passiert ohne Redundanz?
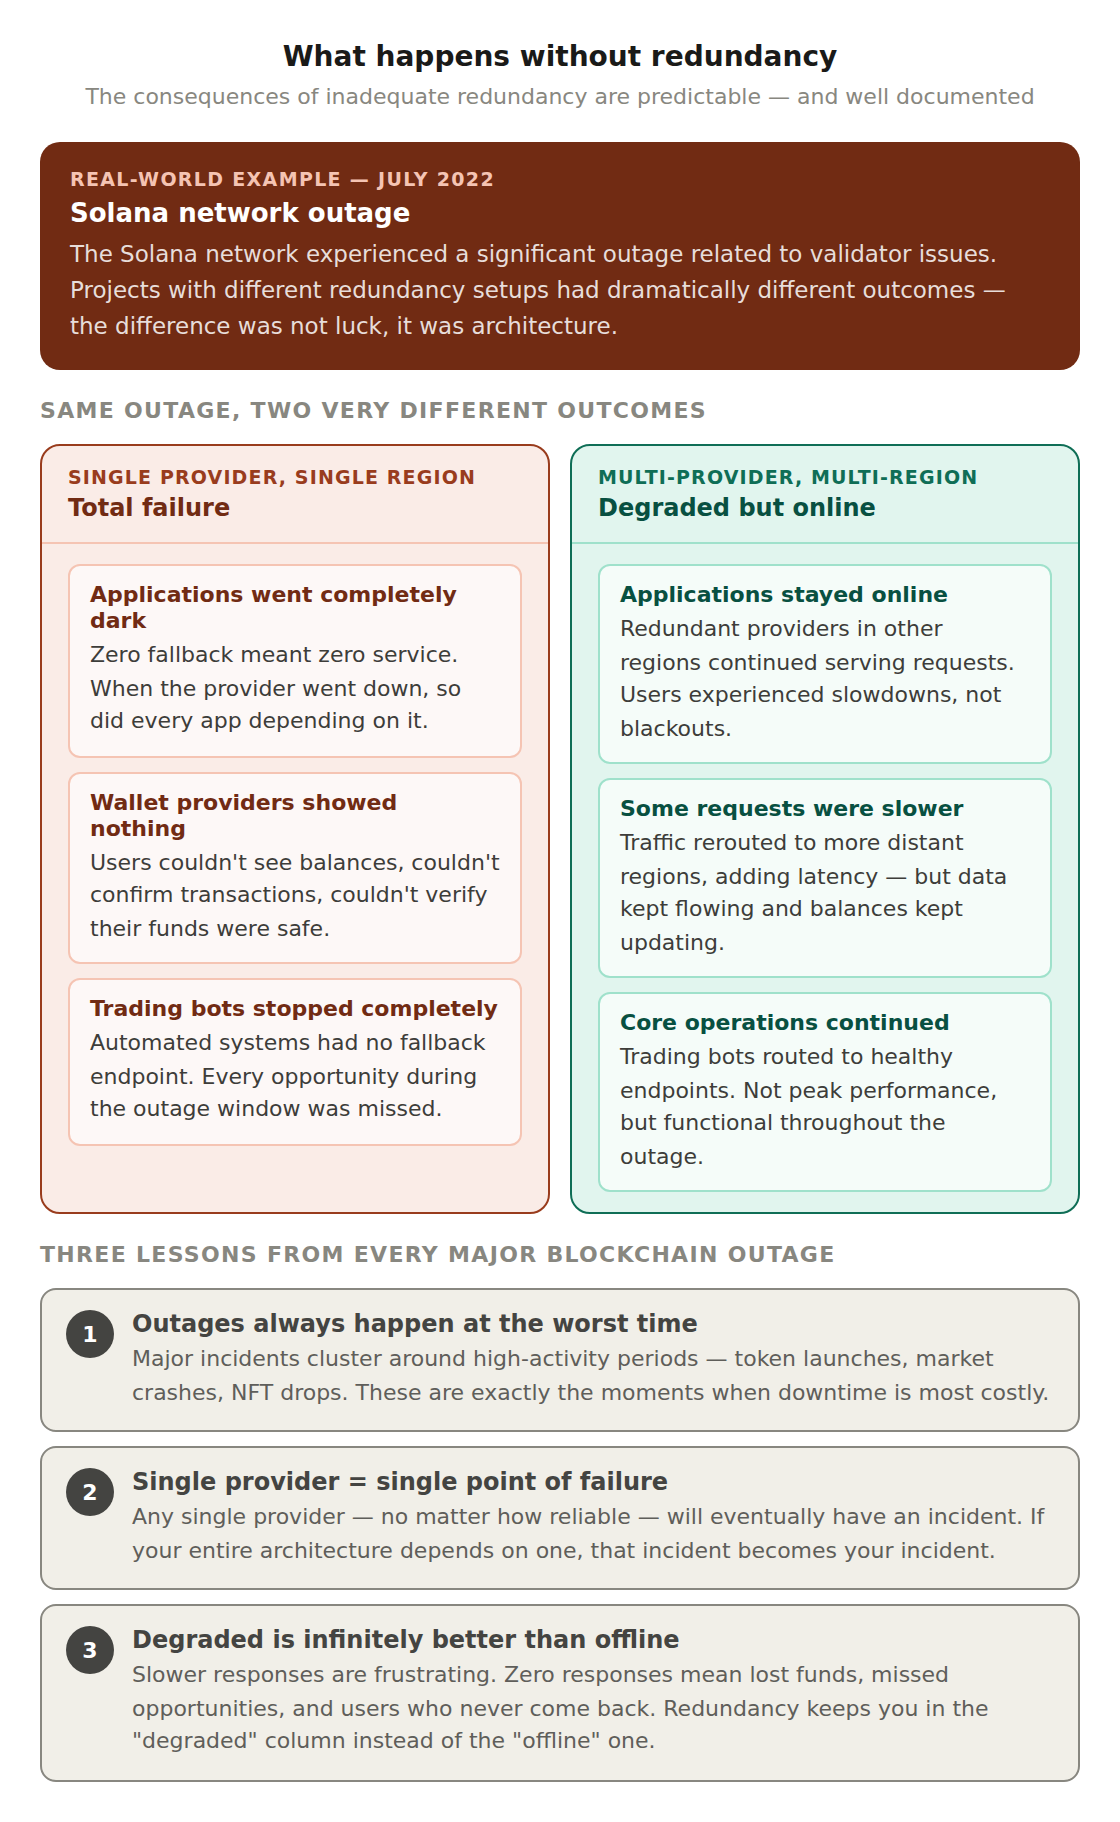
Die Folgen unzureichender Redundanz sind vorhersehbar und gut dokumentiert. Im Juli 2022 kam es im Netzwerk „ Solana “ zu einem erheblichen Ausfall, der teilweise auf Probleme mit den Validatoren zurückzuführen war. Projekte, die auf einen einzigen RPC-Anbieter in einer einzigen Region angewiesen waren, verfügten über keinerlei Ausweichlösung. Ihre Anwendungen fielen vollständig aus. Wallet-Anbieter konnten keine Guthaben anzeigen. Handels-Bots stellten ihre Ausführung ein. Die Überwachungs-Dashboards zeigten nichts an.
Vergleichen Sie das einmal mit Projekten, bei denen mehrere Anbieter und mehrere Regionen zum Einsatz kamen. Dort kam es zwar zu Leistungseinbußen, aber nicht zu einem vollständigen Ausfall. Einige Anfragen wurden zwar langsamer bearbeitet, doch die Anwendungen blieben online. Der Unterschied war kein Zufall. Es war die Redundanz.
Die Kosten für Redundanz im Vergleich zu den Kosten für Ausfallzeiten
Ein häufiger Einwand gegen Redundanz sind die Kosten. Der Betrieb von Knoten in drei Regionen kostet etwa dreimal so viel wie der Betrieb in einer einzigen Region. Der Einsatz bei zwei Cloud-Anbietern erhöht zudem die Komplexität des Betriebs und verursacht zusätzliche Kosten.
Bedenken Sie jedoch die Kosten von Ausfallzeiten. Für ein DeFi-Protokoll mit einem täglichen Handelsvolumen von 10 Millionen US-Dollar können bereits 30 Minuten Ausfallzeit zu Spitzenzeiten Hunderttausende an entgangenen Trades, fehlgeschlagenen Liquidationen und einem Vertrauensverlust bei den Nutzern bedeuten. Für einen NFT-Marktplatz während eines starken Kursrückgangs können schon wenige Minuten Offline-Zeit dazu führen, dass eine ganze Nutzergruppe an einen Konkurrenten verloren geht, der weiterhin erreichbar war.
Aus rechnerischer Sicht spricht bei Produktionsanwendungen fast immer etwas für Redundanz. Die Infrastrukturkosten sind fest und kalkulierbar. Die Kosten für Ausfallzeiten sind variabel und oft katastrophal.
Was ist der Unterschied zwischen Redundanz und Failover?
Redundanz und Failover ergänzen sich, sind jedoch nicht dasselbe. Redundanz bedeutet, über Reservekapazitäten zu verfügen: zusätzliche Knoten, Regionen und Anbieter, die bereitstehen. Failover ist der Mechanismus, der einen Ausfall tatsächlich erkennt und den Datenverkehr auf diese Reservekapazitäten umleitet. Redundanz ohne Failover bedeutet, dass Sie über Backups verfügen, auf die niemand umschaltet; Failover ohne Redundanz bedeutet, dass Sie über eine Umschaltmöglichkeit verfügen, auf die Sie nichts umschalten können. Für echte Ausfallsicherheit benötigen Sie beides.
Aspekt
Redundanz
Ausfallsicherung
Was es ist
Reservekapazität, doppelte Kapazität
Der Vorgang des Umstiegs darauf
Frage, auf die sie eine Antwort gibt
Haben wir ein Backup?
Wie schnell verbrauchen wir es?
Ohne den anderen
Backups, die niemand weiterleitet
Ein Schalter ohne Ziel
Gemessen an
Anzahl der unabhängigen Kopien
Erkennungs- und Umschaltzeit
Kurz gesagt: Redundanz ist die Grundlage, und Failover ist die darauf aufbauende Automatisierung. Zusammen bilden sie die Bausteine der Hochverfügbarkeit.
Inwiefern trägt Redundanz zur Verbesserung der Verfügbarkeit bei?
Jede Redundanzebene beseitigt einen anderen Single Point of Failure. Je mehr unabhängige Ebenen Sie also übereinander schichten, desto unwahrscheinlicher ist es, dass ein einzelner Ausfall zu einem vollständigen Ausfall des Systems führt. In der folgenden Tabelle ist aufgeführt, gegen welchen Ausfall die jeweilige Redundanzebene schützt.
Es gibt keine allgemeingültige richtige Antwort; das Ziel besteht darin, die Redundanz an die Kosten eines Ausfalls anzupassen. Ein Hobbyprojekt kann gelegentliche Ausfallzeiten verkraften und benötigt möglicherweise kaum mehr als ein Ausweich endpoint, während ein DeFi-Protokoll oder eine Börse, über die echte Werte gehandelt werden, eine Abdeckung über mehrere Regionen und Anbieter hinweg mit automatisiertem Failover benötigt. Treffen Sie Ihre Entscheidung, indem Sie die festen, vorhersehbaren Kosten der Redundanz gegen die variablen, potenziell katastrophalen Kosten eines Ausfalls abwägen. Im Grunde handelt es sich hierbei um eine „Build-versus-Buy“-Entscheidung, die sich nur dann auszahlt, wenn Sie Ausfälle vorhersehen können. Kombinieren Sie sie daher mit einer starken Beobachtbarkeit und Überwachung Ihrer Infrastruktur.
Häufig gestellte Fragen
Was versteht man unter Infrastruktur-Redundanz?
Infrastrukturredundanz bedeutet, dass mehr Komponenten betrieben werden, als im Normalbetrieb unbedingt erforderlich sind, damit im Falle eines Ausfalls ein Backup die Funktion übernehmen kann. In der Blockchain bedeutet dies, dass Knoten in mehreren Regionen, bei verschiedenen Cloud-Anbietern und in verschiedenen Client-Implementierungen doppelt vorhanden sind.
Ist Redundanz dasselbe wie ein Backup?
Nicht ganz. Ein Backup ist in der Regel eine Kopie von Daten, die man nach einem Ausfall wiederherstellt, während Redundanz eine live verfügbare Reservekapazität ist, die den Datenverkehr während eines Ausfalls mit nur geringer oder gar keiner Unterbrechung weiterbedient. Bei Redundanz geht es darum, online zu bleiben, nicht darum, den Betrieb danach wiederherzustellen.
Warum mehrere Node-Clients betreiben?
Die Vielfalt der Clients schützt vor Softwarefehlern. Wenn in einer Client-Implementierung ein kritischer Fehler auftritt, laufen die Knoten, auf denen ein anderer Client ausgeführt wird, weiterhin normal, sodass eine einzelne fehlerhafte Version nicht Ihre gesamte Flotte lahmlegt.
Verhindert Redundanz Ausfallzeiten vollständig?
Kein System erreicht eine perfekte Verfügbarkeit, doch durch mehrstufige Redundanz führen die meisten Einzelausfälle lediglich zu Leistungseinbußen und nicht zu vollständigen Ausfällen. Das Ziel besteht darin, einzelne Fehlerquellen zu beseitigen, damit kein einzelnes Ereignis den gesamten Betrieb lahmlegt.
Lohnt sich die Redundanz trotz der zusätzlichen Kosten?
Bei Produktionsanwendungen ist dies fast immer der Fall. Redundanz ist mit festen, vorhersehbaren Kosten verbunden, während Ausfallzeiten variable Kosten verursachen, die sich bei einem einzigen Ausfall während einer Spitzenzeit auf Hunderttausende Dollar an entgangenen Handelsgeschäften und verlorenen Nutzern belaufen können.
Wie „ Quicknode “ Redundanz schafft
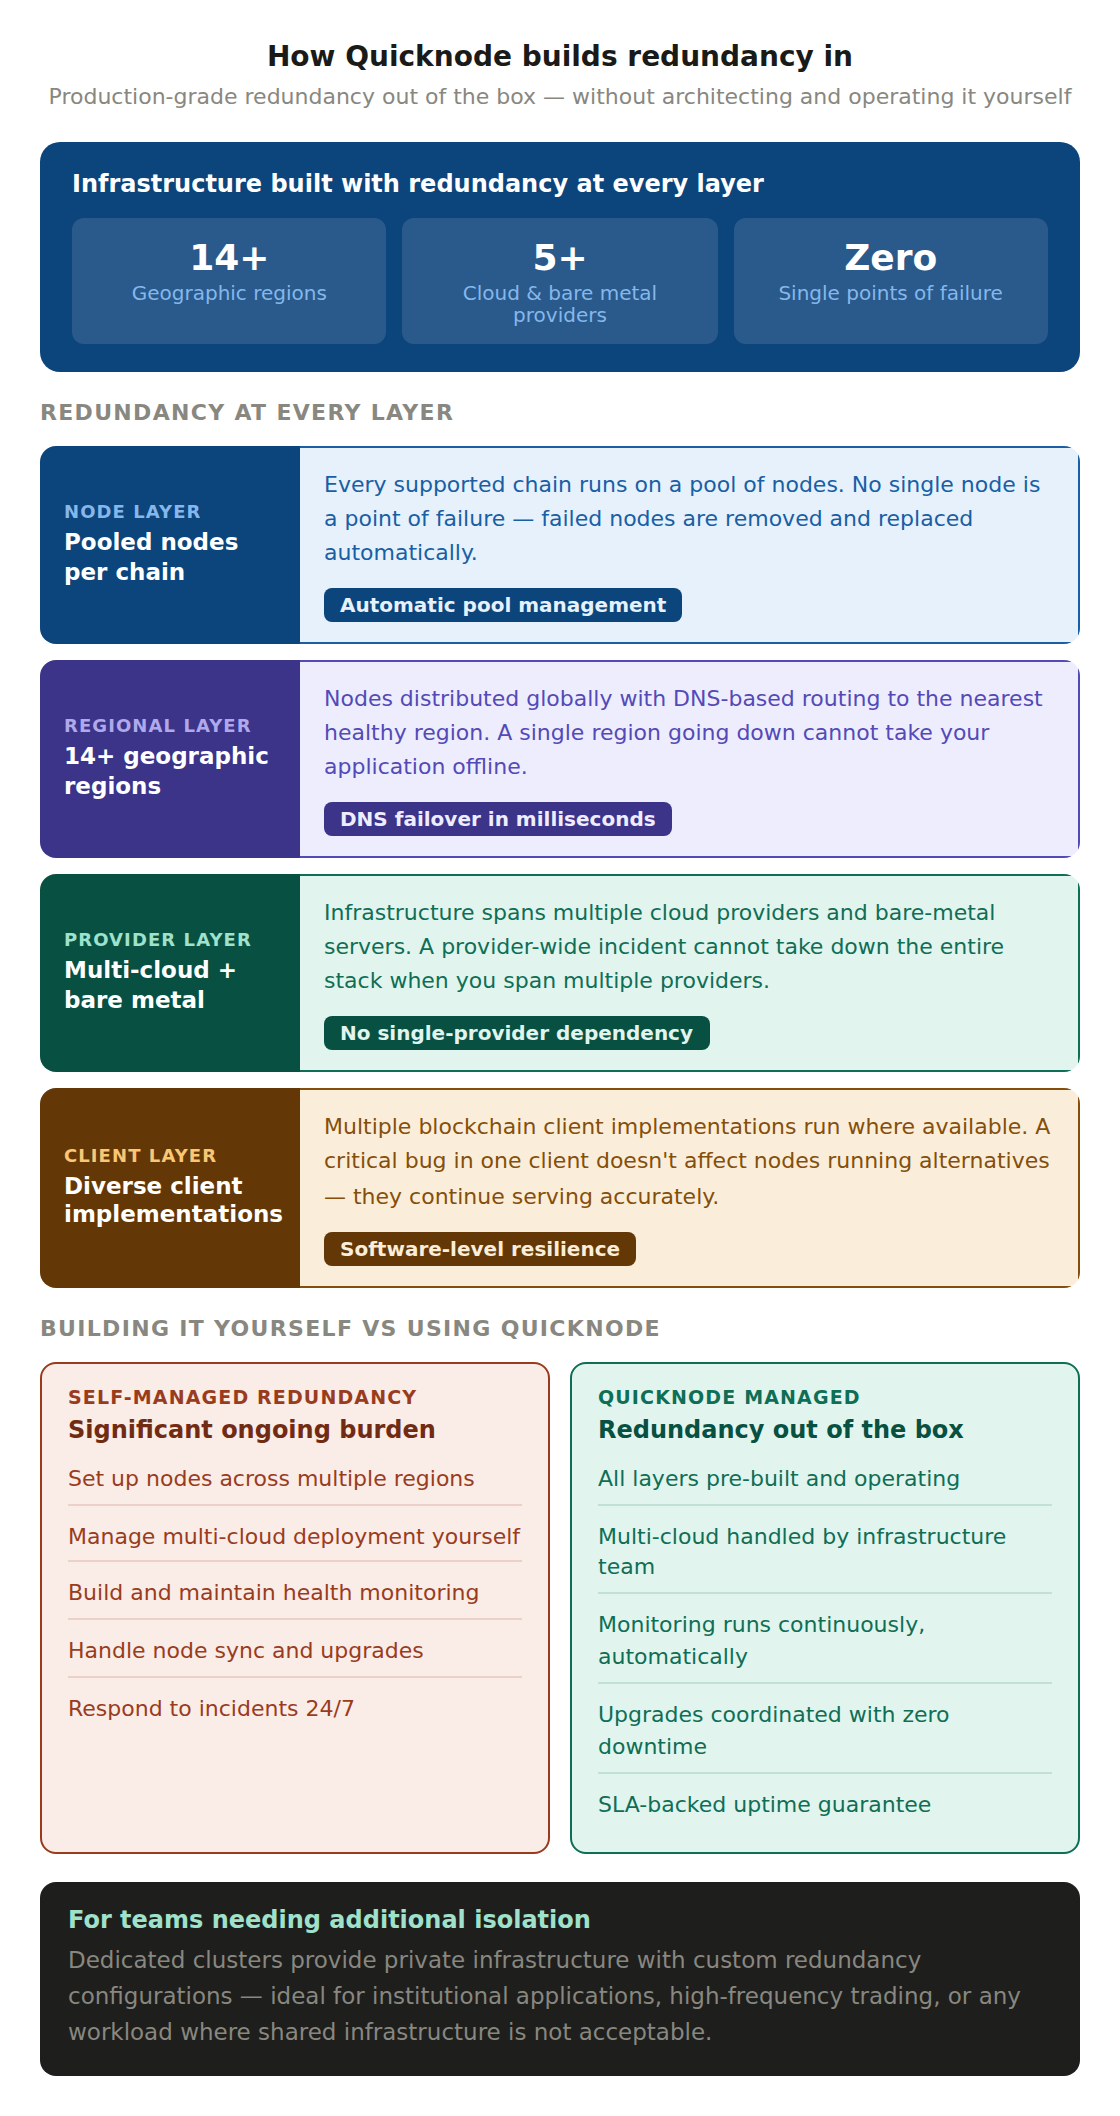
Quicknode betreibt eine Blockchain-Infrastruktur in mehr als 14 Regionen bei verschiedenen Cloud- und Bare-Metal-Anbietern. Jede unterstützte Blockchain läuft auf einem Pool von Knoten mit unterschiedlichen Client-Implementierungen, sofern verfügbar. Das System ist so konzipiert, dass kein einzelner Knoten, keine einzelne Region und kein einzelner Cloud-Anbieter einen Single Point of Failure darstellt.
Das bedeutet, dass Entwickler sofort eine Redundanz auf Produktionsniveau erhalten, ohne diese selbst konzipieren und betreiben zu müssen. Für Teams, die eine zusätzliche Isolierung benötigen, bieten dedizierte „ clusters “ eine private Infrastruktur mit individuellen Redundanzkonfigurationen.