Antworten>Erfahren Sie mehr über Blockchain-Knoten>Warum die Zuverlässigkeit von Knoten wichtig ist
Warum die Zuverlässigkeit von Knoten wichtig ist
// Tags
Zuverlässigkeit der KnotenVerfügbarkeit der Blockchain
TL;DR: Die Zuverlässigkeit eines Knotens ist das Maß dafür, wie konsistent und präzise ein Blockchain-Knoten auf Anfragen reagiert, ohne dass es zu Ausfallzeiten, Fehlern oder veralteten Daten kommt. Für jede Anwendung, die Daten aus einer Blockchain liest oder in diese schreibt, bedeutet eine unzuverlässige Knoteninfrastruktur fehlgeschlagene Transaktionen, falsche Kontostände, verpasste Ereignisse und eine beeinträchtigte Benutzererfahrung. In Produktionsumgebungen ist die Zuverlässigkeit eines Knotens kein „Nice-to-have“. Sie ist die Grundlage, auf der alles andere beruht.
Die einfache Erklärung
Jede Interaktion Ihrer Anwendung mit einer Blockchain läuft über einen Knoten. Wenn ein Nutzer seinen Wallet-Kontostand abfragt, beantwortet ein Knoten diese Anfrage. Wenn jemand einen Swap an einer dezentralen Börse aufgibt, überträgt ein Knoten diese Transaktion. Wenn Ihr Backend auf Smart-Contract-Ereignisse wartet, liefert ein Knoten diese Ereignisse. Ist der Knoten langsam, ausgefallen oder liefert er veraltete Daten, kommt es zu Störungen in Ihrer Anwendung, die sich direkt auf Ihre Nutzer und Ihren Umsatz auswirken.
Stellen Sie sich die Zuverlässigkeit von Knoten so vor, wie Sie sich die Verfügbarkeit einer Datenbank bei einer herkömmlichen Webanwendung vorstellen würden. Wenn Ihre Datenbank offline geht, kann Ihre App keine Daten lesen oder schreiben. Benutzer sehen Fehlermeldungen, Transaktionen schlagen fehl und das Vertrauen schwindet. Blockchain-Knoten erfüllen dieselbe Funktion wie Ihre Datenbankschicht, nur dass die von ihnen bereitgestellten Daten finanzieller Natur sind. Ein veralteter Kontostand könnte dazu führen, dass ein Benutzer sein Konto überzieht. Eine fehlgeschlagene Transaktion könnte einen verpassten Handel bedeuten. Ein verzögertes Ereignis könnte in einem DeFi-Protokoll zu falschen Liquidationen führen. Es steht mehr auf dem Spiel, und die Fehlertoleranz ist geringer.
Was Sie unzuverlässige Knoten tatsächlich kosten
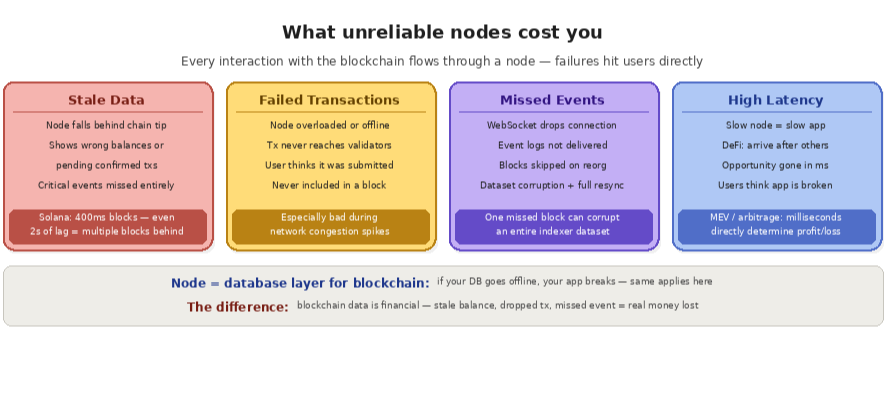
Die Folgen einer mangelnden Knotenzuverlässigkeit zeigen sich auf vielfältige Weise, und die meisten davon sind erst dann unmittelbar erkennbar, wenn in der Produktion ein Fehler auftritt.
Veraltete Daten gehören zu den gefährlichsten Fehlerquellen. Wenn Ihr Knoten hinter der Spitze der Blockchain (dem zuletzt bestätigten Block) zurückfällt, liefert er veraltete Zustandsdaten aus. Ihre Anwendung könnte einem Nutzer einen Kontostand anzeigen, der nicht mehr existiert, eine Transaktion als ausstehend darstellen, obwohl sie bereits bestätigt wurde, oder ein kritisches Smart-Contract-Ereignis komplett übersehen. Bei schnellen Blockchains wie Solana , bei denen alle 400 Millisekunden neue Blöcke erzeugt werden, kann bereits eine Synchronisierungsverzögerung von wenigen Sekunden dazu führen, dass Ihre Anwendung mehrere Blöcke hinter dem aktuellen Stand zurückbleibt.
Fehlgeschlagene Transaktionen stellen einen weiteren erheblichen Kostenfaktor dar. Wenn Sie eine Transaktion über einen Knoten einreichen, muss dieser Knoten sie an den Mempool (oder ein gleichwertiges System) des Netzwerks senden. Ist der Knoten überlastet, von den Peers getrennt oder falsch konfiguriert, erreicht die Transaktion möglicherweise nie die Validatoren. Der Nutzer glaubt, seine Transaktion sei eingereicht worden, doch sie wird nie in einen Block aufgenommen. In Ketten mit hohem Durchsatz oder in Zeiten von Netzwerküberlastung kann dies bei leistungsschwachen oder schlecht gewarteten Knoten häufig vorkommen.
Verpasste Ereignisse wirken sich auf jede Anwendung aus, die auf Echtzeit-Blockchain-Daten angewiesen ist. Wenn Ihr Knoten WebSocket-Verbindungen unterbricht, Ereignisprotokolle nicht übermittelt oder während einer Reorganisation Blöcke überspringt, gehen in Ihrer Anwendung Daten verloren. Bei Indexern, Analyseplattformen und allen Systemen, die eine lückenlose Aufzeichnung der On-Chain-Aktivitäten benötigen, kann bereits ein einziger verpasster Block Ihren Datensatz beschädigen und eine vollständige Neusynchronisierung erforderlich machen.
Die Latenz wirkt sich direkt auf wettbewerbsorientierte Anwendungsfälle aus. Beim DeFi-Handel, bei der MEV-Gewinnung und bei der Arbitrage kommt es auf Millisekunden an. Ein langsamer Knoten bedeutet, dass Ihre Transaktion nach der eines anderen eintrifft und die Gelegenheit verpasst ist. Bei Anwendungen, bei denen das Timing weniger kritisch ist, beeinträchtigt eine hohe Latenz dennoch das Nutzererlebnis. Nutzer erwarten, dass sich ihr Wallet-Guthaben sofort aktualisiert und Transaktionen schnell bestätigt werden. Träge Reaktionen der Knoten lassen Ihre Anwendung fehlerhaft erscheinen, selbst wenn die Blockchain selbst einwandfrei funktioniert.
Was macht einen Knoten zuverlässig?
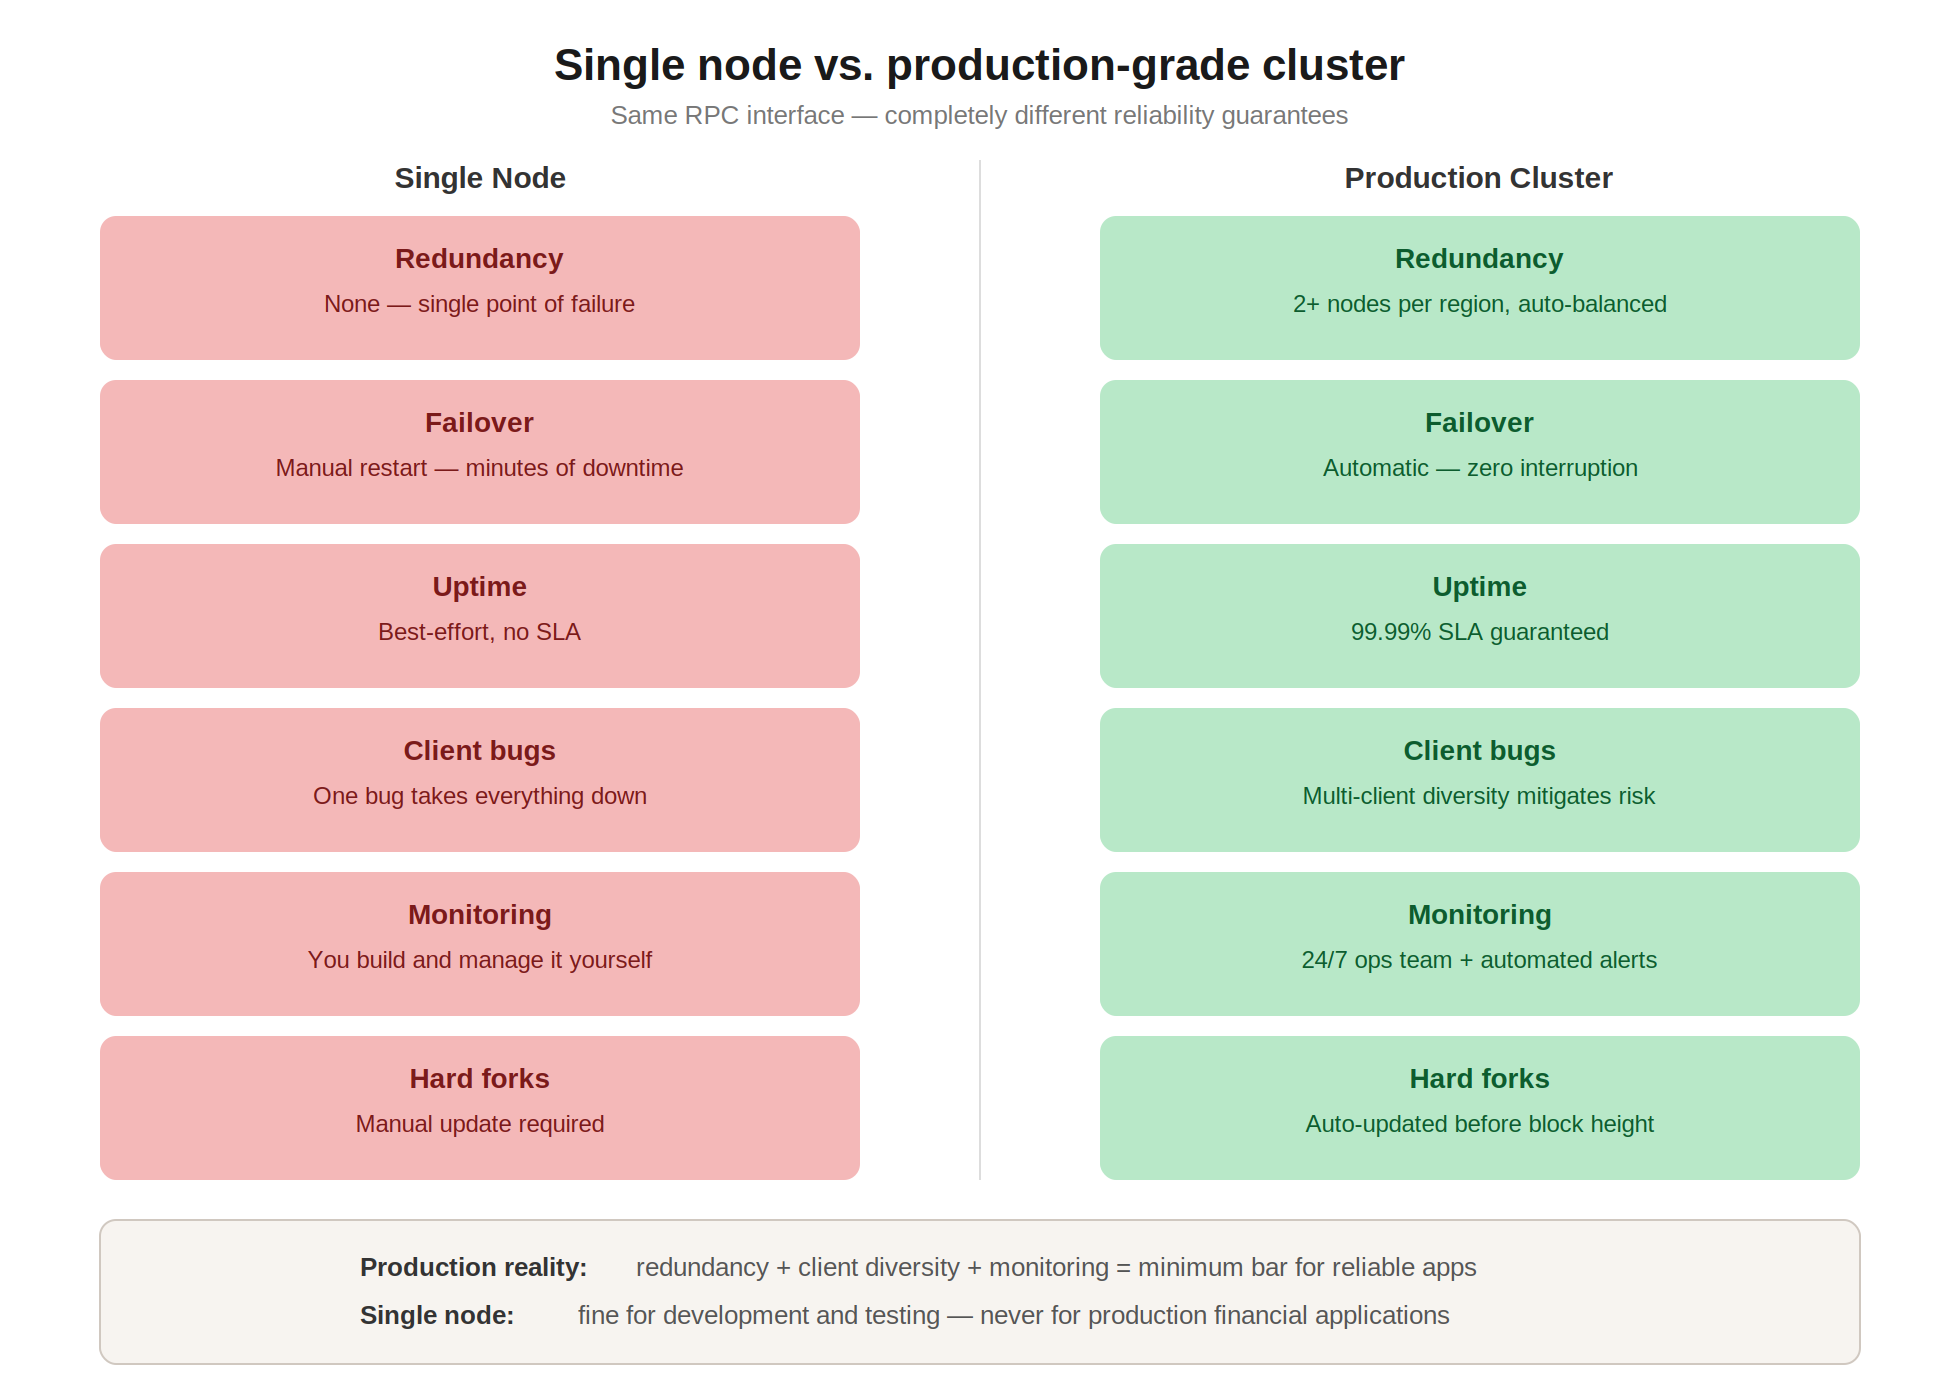
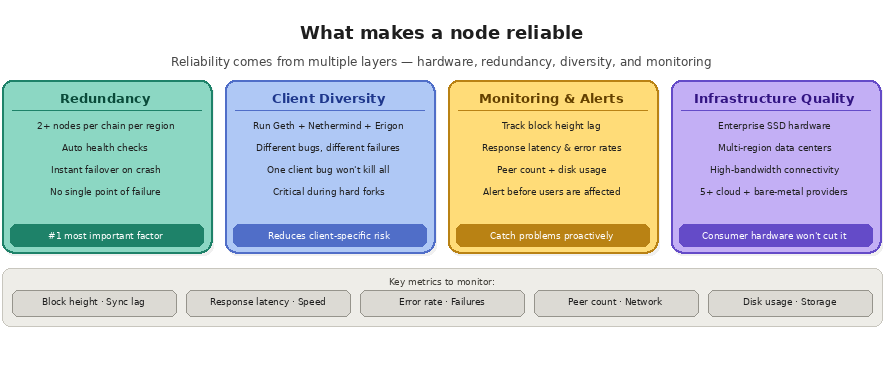
Zuverlässigkeit ergibt sich aus mehreren Faktoren: Hardwarequalität, Softwarekonfiguration, Netzwerkkonnektivität, Redundanz und Betriebsüberwachung. Ein einzelner Knoten, der auf handelsüblicher Hardware mit einer privaten Internetverbindung läuft, wird niemals die Zuverlässigkeit eines professionell verwalteten Clusters von Knoten erreichen, die über mehrere Rechenzentren und Cloud-Anbieter verteilt sind.
Redundanz ist der wichtigste Faktor. Wenn ein einzelner Knoten ausfällt (aufgrund eines Absturzes, eines Festplattenausfalls oder eines Client-Fehlers), wechselt ein redundantes System ohne Unterbrechung Ihrer Anwendung auf einen funktionsfähigen Knoten um. Ohne Redundanz kann ein einziger Ausfallpunkt dazu führen, dass Ihre gesamte Anwendung offline geht. Eine produktionsreife Infrastruktur betreibt in der Regel zwei oder mehr Knoten derselben Kette innerhalb einer Region, mit automatischen Zustandsprüfungen und Datenverkehrsweiterleitung.
Auch die Vielfalt der Clients spielt eine Rolle. Verschiedene Blockchain-Client-Implementierungen (beispielsweise Geth, Nethermind und Erigon auf Ethereum) weisen unterschiedliche Leistungsmerkmale, unterschiedliche Fehler und unterschiedliche Ausfallarten auf. Der Einsatz mehrerer Client-Implementierungen verringert das Risiko, dass ein Fehler in einem Client Ihre gesamte Infrastruktur lahmlegt. Dies ist besonders wichtig bei Hard Forks und Protokoll-Upgrades, da dann client-spezifische Probleme am ehesten auftreten.
Überwachung und Alarmierung sind unerlässlich, um Probleme zu erkennen, bevor sie sich auf die Nutzer auswirken. Eine gut betriebene Knoteninfrastruktur erfasst kontinuierlich Kennzahlen wie die Blockhöhe (zur Erkennung von Synchronisationsverzögerungen), die Antwortlatenz, Fehlerraten, die Anzahl der Peers und die Festplattenauslastung. Sobald eine Kennzahl einen Schwellenwert überschreitet, lösen automatisierte Warnmeldungen eine Untersuchung oder ein Failover aus, bevor das Problem die Produktionsumgebung erreicht.
Wie wird die Zuverlässigkeit eines Knotens gemessen?
Zuverlässigkeit lässt sich nicht durch eine einzige Zahl ausdrücken, sondern durch eine Reihe von Indikatoren, die zusammen Aufschluss darüber geben, ob ein Knoten im Produktivbetrieb als vertrauenswürdig eingestuft werden kann. Die folgende Tabelle zeigt die wichtigsten Kennzahlen, was die einzelnen Kennzahlen aussagen und welchen Bereich eine produktionsreife Konfiguration einhalten sollte.
Metrisch
Was Ihnen das sagt
Produktionsziel
SLA zur Verfügbarkeit
Anteil der Zeit, in der das „ endpoint “ verfügbar ist
99,9 % oder mehr
Fehlerquote
Anteil der Anfragen, die Fehler zurückgeben
unter 0,1 %
Synchronisationsverzögerung
Abstand hinter der Kettenspitze
Innerhalb von 0 bis 1 Block
Antwortverzögerung (p99)
Das langsamste 1 % der Antworten
Unter 500 ms
Anzahl der Peers
Stabile Netzwerkverbindung
Stabil über dem Mindestwert des Kunden
Die Verfügbarkeit ist zwar die wichtigste Kennzahl, doch ein Knoten kann zwar „in Betrieb“ sein und dennoch unzuverlässig sein, wenn er hinter der Spitze zurückbleibt oder Fehler zurückgibt. Verfolgen Sie diese Signale kontinuierlich, anstatt sie nur stichprobenartig zu überprüfen. Einen umfassenden Überblick darüber, wie eine „ endpoint “ instrumentiert wird, finden Sie unter „Überwachung der Blockchain-Infrastruktur“.
Was führt zum Ausfall eines Blockchain-Knotens?
Knoten fallen sowohl aus internen als auch aus externen Gründen aus. Intern können eine voll werdende Festplatte, ein Speicherleck oder ein Fehler in der Client-Software dazu führen, dass ein Knoten abstürzt oder ins Stocken gerät. Extern können Netzwerkpartitionen, der Verlust von Peers und Traffic-Spitzen bei Netzwerküberlastung einen unterdimensionierten Knoten überlasten. Protokoll-Upgrades und Hard Forks sind besonders riskante Momente, da ein für einen bestimmten Client spezifischer Fehler jeden Knoten lahmlegen kann, auf dem dieser läuft. Das Verständnis der gängigen Ausfallmodi von Blockchains hilft Ihnen dabei, eine Infrastruktur zu entwerfen, die bei Problemen reibungslos weiterarbeitet, anstatt komplett auszufallen.
Inwiefern verbessert Failover die Zuverlässigkeit der Knoten?
Failover ist der Mechanismus, der mehrere einzelne Knoten zu einem zuverlässigen Dienst zusammenführt. Zustandsprüfungen überwachen jeden Knoten, und wenn ein Knoten ausfällt oder offline geht, wird der Datenverkehr automatisch auf einen funktionsfähigen Knoten umgeleitet, sodass Ihre Anwendung den Ausfall gar nicht bemerkt. Dies ist der Kern der Hochverfügbarkeit und hängt von der Redundanz der Infrastruktur ab: Es werden mehrere Knoten betrieben, sodass stets ein Backup bereitsteht. Erfahren Sie mehr über Failover und wie die nahtlose Umschaltung in der Praxis funktioniert.
Sollten Sie einen eigenen Knoten betreiben oder einen Anbieter nutzen?
Wenn Sie Ihren eigenen Knoten betreiben, haben Sie zwar die volle Kontrolle, tragen aber die gesamte Verantwortung für die Zuverlässigkeit – equipe: Hardware, Redundanz, Überwachung, Upgrades und Bereitschaftsdienst rund um die Uhr. Ein Managed-Provider übernimmt diese betriebliche Belastung und stellt Ihnen von der ersten Anfrage an eine verteilte, redundante Knotenflotte zur Verfügung. Die richtige Wahl hängt von Ihrer Größe, Ihrem Budget und Ihrer Toleranz gegenüber Betriebsrisiken ab und kann je nach Workload variieren, da der Selbstbetrieb eines Archivknotens weitaus aufwendiger ist als der eines Vollknotens. Unter „Build vs. Buy“ finden Sie ein Rahmenkonzept, das Ihnen bei der Entscheidung hilft.
Wie „ Quicknode “ für Zuverlässigkeit sorgt
QuicknodeDie Infrastruktur von [Name] ist speziell auf Produktionszuverlässigkeit in großem Maßstab ausgelegt. Die Plattform verarbeitet täglich Milliarden von API-Anfragen über mehr als 80 Blockchain-Netzwerke hinweg und bietet eine SLA mit einer Verfügbarkeit von 99,99 %. Diese Zuverlässigkeit beruht auf einer global verteilten Architektur, die sich über mehr als 14 Regionen und mehr als 5 Cloud- und Bare-Metal-Anbieter erstreckt, sowie auf mehreren Client-Implementierungen pro Blockchain, automatischem Failover und Lastausgleich und einer Rund-um-die-Uhr-Überwachung durch ein spezielles Blockchain-Betriebs equipe.
Quicknode nutzt anwendungsspezifische Knoten clusters, was bedeutet, dass der Datenverkehr an Knoten weitergeleitet wird, die für die jeweilige Art der Anfrage optimiert sind. Leseintensive Workloads, Archivabfragen und die Übertragung von Transaktionen werden jeweils von einer Infrastruktur verarbeitet, die auf das jeweilige Muster abgestimmt ist. Dieser Ansatz sorgt für eine konstante Leistung bei schwankender Auslastung, anstatt bei Datenverkehrsspitzen an Leistung einzubüßen.
Für Teams mit höchsten Anforderungen an die Zuverlässigkeit bieten die „Dedicated Clusters “ von Quicknode eine vollständig isolierte, private Knoteninfrastruktur. Jeder Cluster betreibt redundante Knoten innerhalb einer Region mit unabhängigen Verteilungspfaden, sodass kein gemeinsam genutzter Datenverkehr anderer Kunden Ihre Leistung beeinträchtigen kann. Dedizierte „ Clusters “ verfügen über SLAs mit garantierter Verfügbarkeit, Unterstützung für den Prometheus Exporter zur benutzerdefinierten Überwachung sowie eine 14-tägige Protokollaufbewahrung für vollständige Transparenz im Betrieb. Diese Infrastrukturstufe bildet die Grundlage für einige der größten Wallets, Börsen und DeFi-Protokolle im Web3.
Häufig gestellte Fragen
Was versteht man unter Knoten-Zuverlässigkeit in der Blockchain?
Die Zuverlässigkeit eines Knotens beschreibt, wie konsistent und präzise ein Blockchain-Knoten Anfragen beantwortet, ohne dass es zu Ausfallzeiten, Fehlern oder veralteten Daten kommt. Ein zuverlässiger Knoten bleibt mit der Kettenspitze synchronisiert, reagiert schnell und ist stets verfügbar, sodass Ihre Anwendung Blockchain-Daten ohne Unterbrechung lesen und schreiben kann.
Was ist eine angemessene SLA-Vorgabe für die Verfügbarkeit eines Blockchain-Knotens?
Produktionanwendungen sollten eine Verfügbarkeit von 99,9 % oder mehr anstreben, was Ausfallzeiten von weniger als etwa 9 Stunden pro Jahr zulässt. Anspruchsvolle Workloads wie Börsen und DeFi-Protokolle erfordern oft ein SLA von 99,99 %, was Ausfallzeiten von weniger als einer Stunde pro Jahr zulässt.
Wie überwachen Sie die Zuverlässigkeit der Knoten?
Überwachen Sie kontinuierlich die Veränderungen der Blockhöhe, die Fehlerrate, die Antwortlatenz und die Anzahl der Peers und lösen Sie eine Warnung aus, sobald einer dieser Werte einen Schwellenwert überschreitet. Durch die Kombination dieser Kennzahlen mit Protokollen und Traces lässt sich nicht nur feststellen, dass die Leistung eines Knotens nachlässt, sondern auch der Grund dafür, sodass Sie einen Failover durchführen oder das Problem beheben können, bevor es den Benutzern auffällt.
Was ist der Unterschied zwischen der Zuverlässigkeit und der Leistung eines Knotens?
Bei der Leistung geht es um Geschwindigkeit, also darum, wie schnell ein Knoten reagiert. Bei der Zuverlässigkeit geht es um Konsistenz, also darum, ob der Knoten korrekt reagiert und über einen längeren Zeitraum hinweg verfügbar bleibt. Ein Knoten kann schnell, aber unzuverlässig sein, wenn er häufig abstürzt, und zuverlässig, aber langsam, wenn er nicht über ausreichende Leistung verfügt. Eine Produktionsinfrastruktur benötigt beides.
Verbessert der Einsatz mehrerer Knoten die Zuverlässigkeit?
Ja. Durch den Betrieb redundanter Knoten mit automatischem Failover werden einzelne Ausfallquellen beseitigt, sodass ein Ausfall eines einzelnen Knotens nicht dazu führt, dass Ihre Anwendung offline geht. Diese Redundanz bildet die Grundlage für die Hochverfügbarkeit in der Blockchain-Infrastruktur.