Antworten>Erfahren Sie mehr über Zuverlässigkeit und Verfügbarkeit>Was ist Failover?
Was ist Failover?
// Tags
Failoverautomatisches Failover
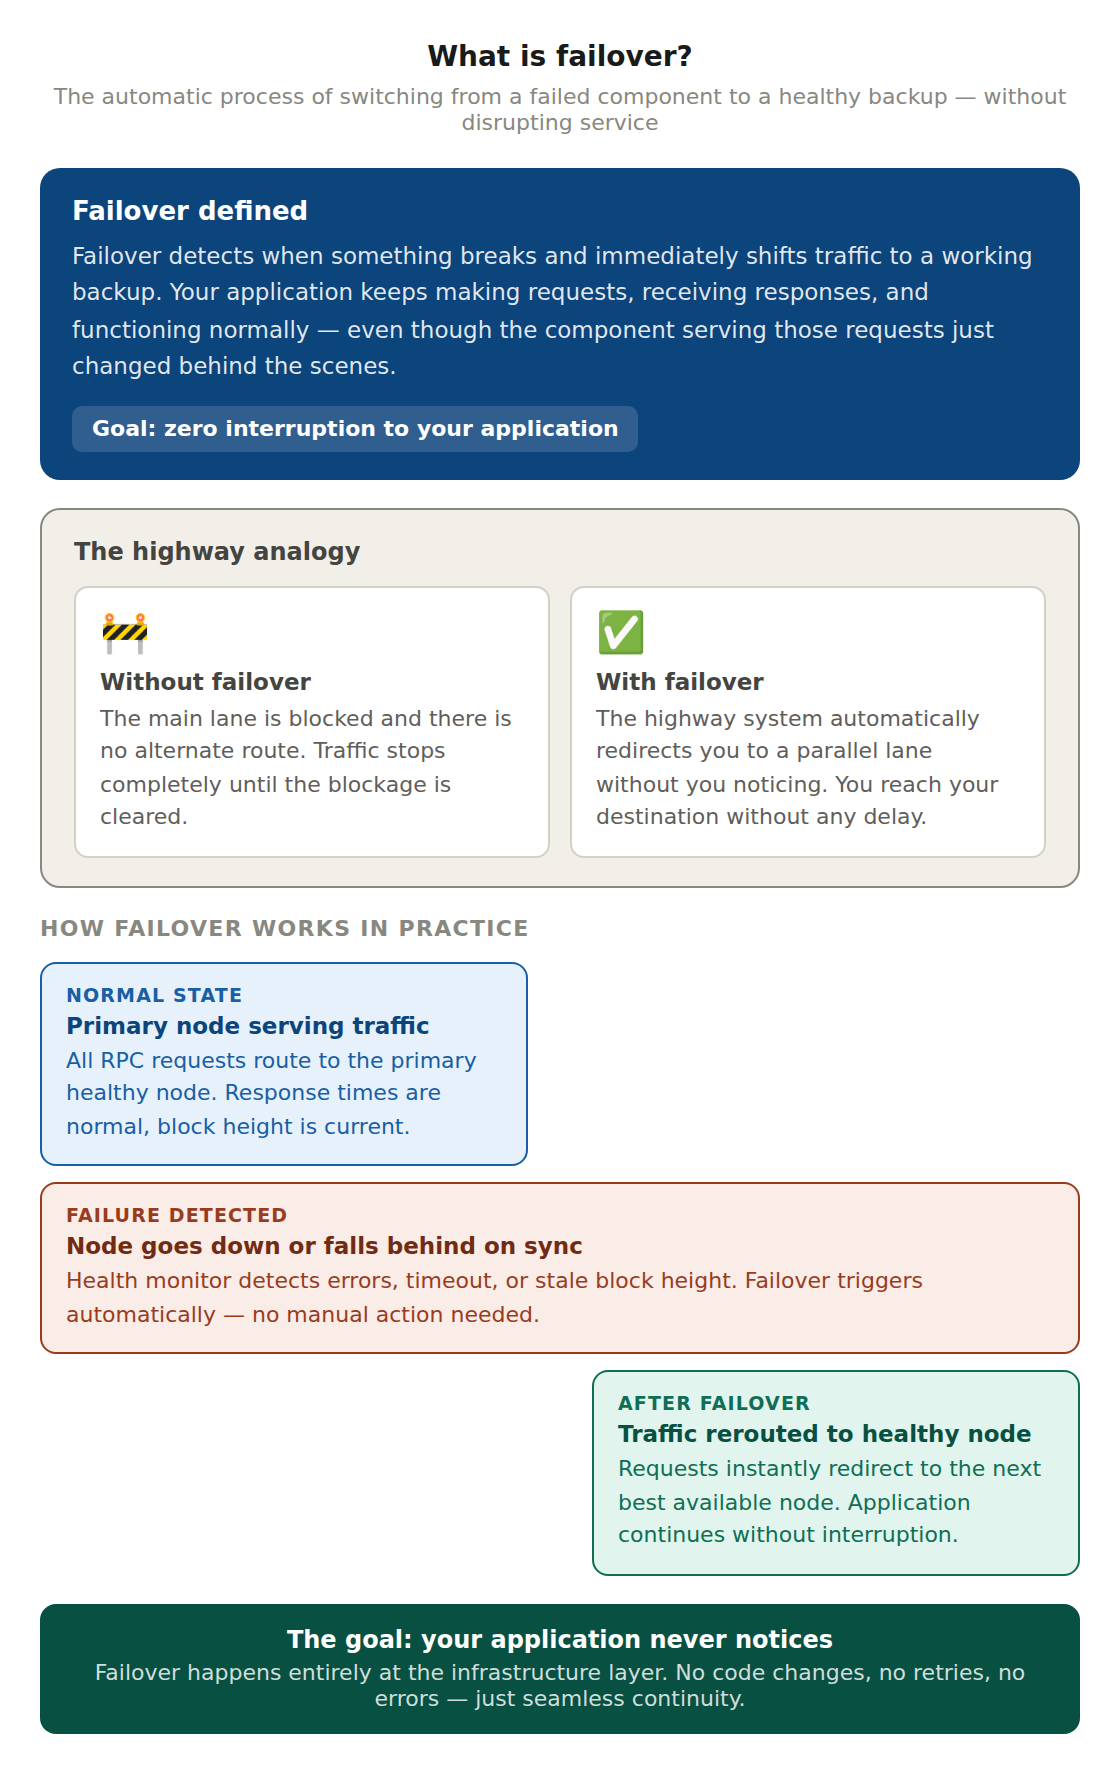
TL;DR: Failover ist der automatische Prozess, bei dem im Falle eines Ausfalls einer Komponente nahtlos auf eine funktionsfähige Ersatzkomponente umgeschaltet wird, ohne dass es zu einer Unterbrechung des Dienstes kommt. In der Blockchain-Infrastruktur stellt Failover sicher, dass die RPC-Anfragen Ihrer Anwendung bei einem Ausfall eines Knotens, Servers oder Rechenzentrums nahtlos an einen anderen funktionierenden endpoint weitergeleitet werden.
Das Grundkonzept
Stellen Sie sich vor, Sie fahren auf einer Autobahn und die Hauptfahrspur ist plötzlich blockiert. Wenn es keine Ausweichroute gibt, sitzen Sie fest. Wenn das Autobahnnetz Sie jedoch automatisch auf eine parallele Fahrspur umleitet, ohne dass Sie es überhaupt bemerken, dann ist das ein Beispiel für Failover in der Praxis.
In Bezug auf die Infrastruktur ist Failover der Mechanismus, der erkennt, wenn etwas ausfällt, und den Datenverkehr sofort auf ein Backup umleitet. Das Ziel ist eine Unterbrechung von null (oder „ near -Null“). Ihre Anwendung sendet weiterhin Anfragen, empfängt Antworten und funktioniert normal, auch wenn sich die Komponente, die diese Anfragen bedient, gerade hinter den Kulissen geändert hat.
So funktioniert Failover in einer Blockchain-Infrastruktur
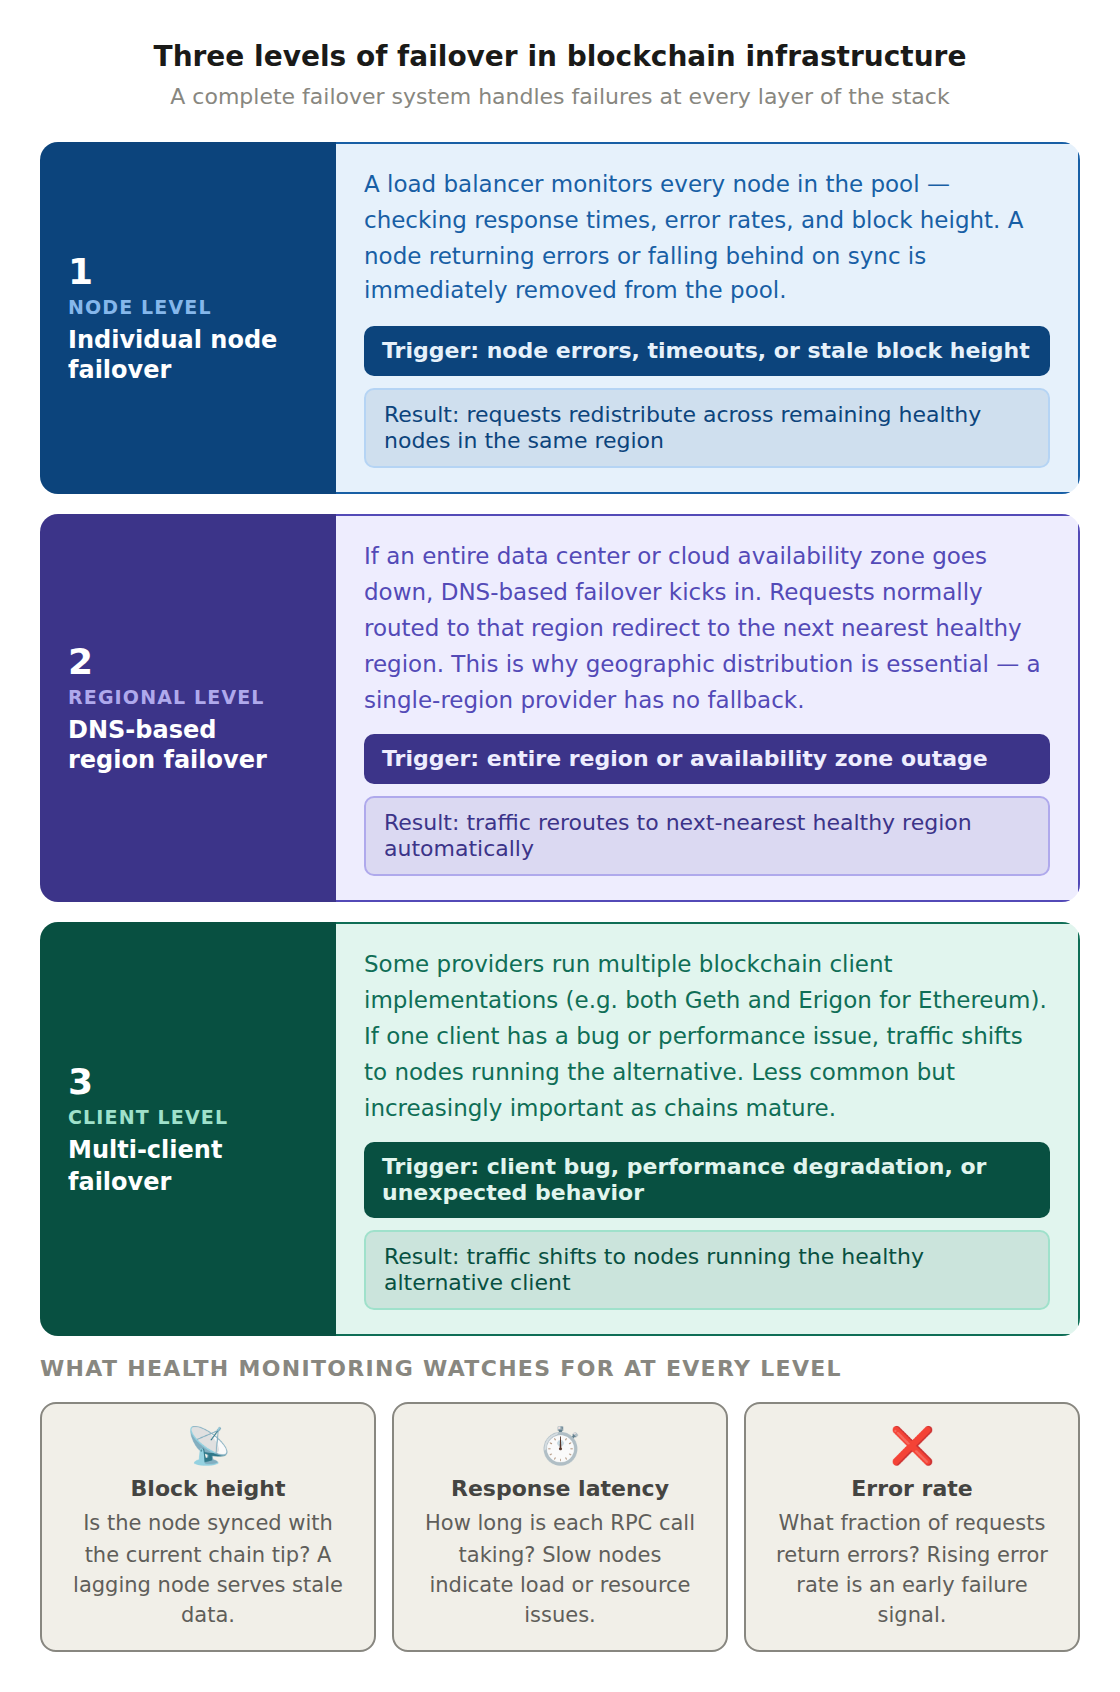
Die Blockchain-Infrastruktur umfasst eine Reihe spezifischer Komponenten, bei denen es zu Ausfällen kommen kann. Am häufigsten sind einzelne Knoten, ganze Regionen oder Rechenzentren sowie bestimmte Blockchain-Client-Implementierungen betroffen. Ein gutes Failover-System deckt alle drei Fälle ab.
Auf Knotenebene ist das Failover relativ unkompliziert. Ein Load Balancer überwacht kontinuierlich den Zustand jedes Knotens im Pool und überprüft dabei die Antwortzeiten, Fehlerraten und die Blockhöhe. Wenn ein Knoten Fehler zurückgibt oder bei der Synchronisierung in Verzug gerät, leitet der Load Balancer keinen Datenverkehr mehr an diesen Knoten weiter und verteilt die Anfragen auf die verbleibenden funktionsfähigen Knoten.
Auf regionaler Ebene wird es interessanter. Wenn es in einem gesamten Rechenzentrum oder einer Cloud-Verfügbarkeitszone zu einem Ausfall kommt, greift das DNS-basierte Failover. Anfragen, die normalerweise an diese Region weitergeleitet würden, werden automatisch an die nächstgelegene funktionierende Region umgeleitet. Deshalb ist die geografische Verteilung so wichtig. Ein Anbieter, der Knoten nur in einer Region betreibt, hat keine Ausweichmöglichkeit, wenn diese Region ausfällt.
Auf Client-Ebene betreiben einige Anbieter mehrere Blockchain-Client-Implementierungen (zum Beispiel sowohl Geth als auch Erigon für Ethereum). Wenn eine Client-Implementierung einen Fehler oder ein Leistungsproblem aufweist, kann der Datenverkehr auf Knoten umgeleitet werden, auf denen der alternative Client läuft. Diese Redundanzebene ist zwar weniger verbreitet, gewinnt aber zunehmend an Bedeutung.
Aktives vs. passives Failover
Es gibt zwei grundlegende Ansätze für das Failover, und diese Unterscheidung ist für die Leistung von Bedeutung.
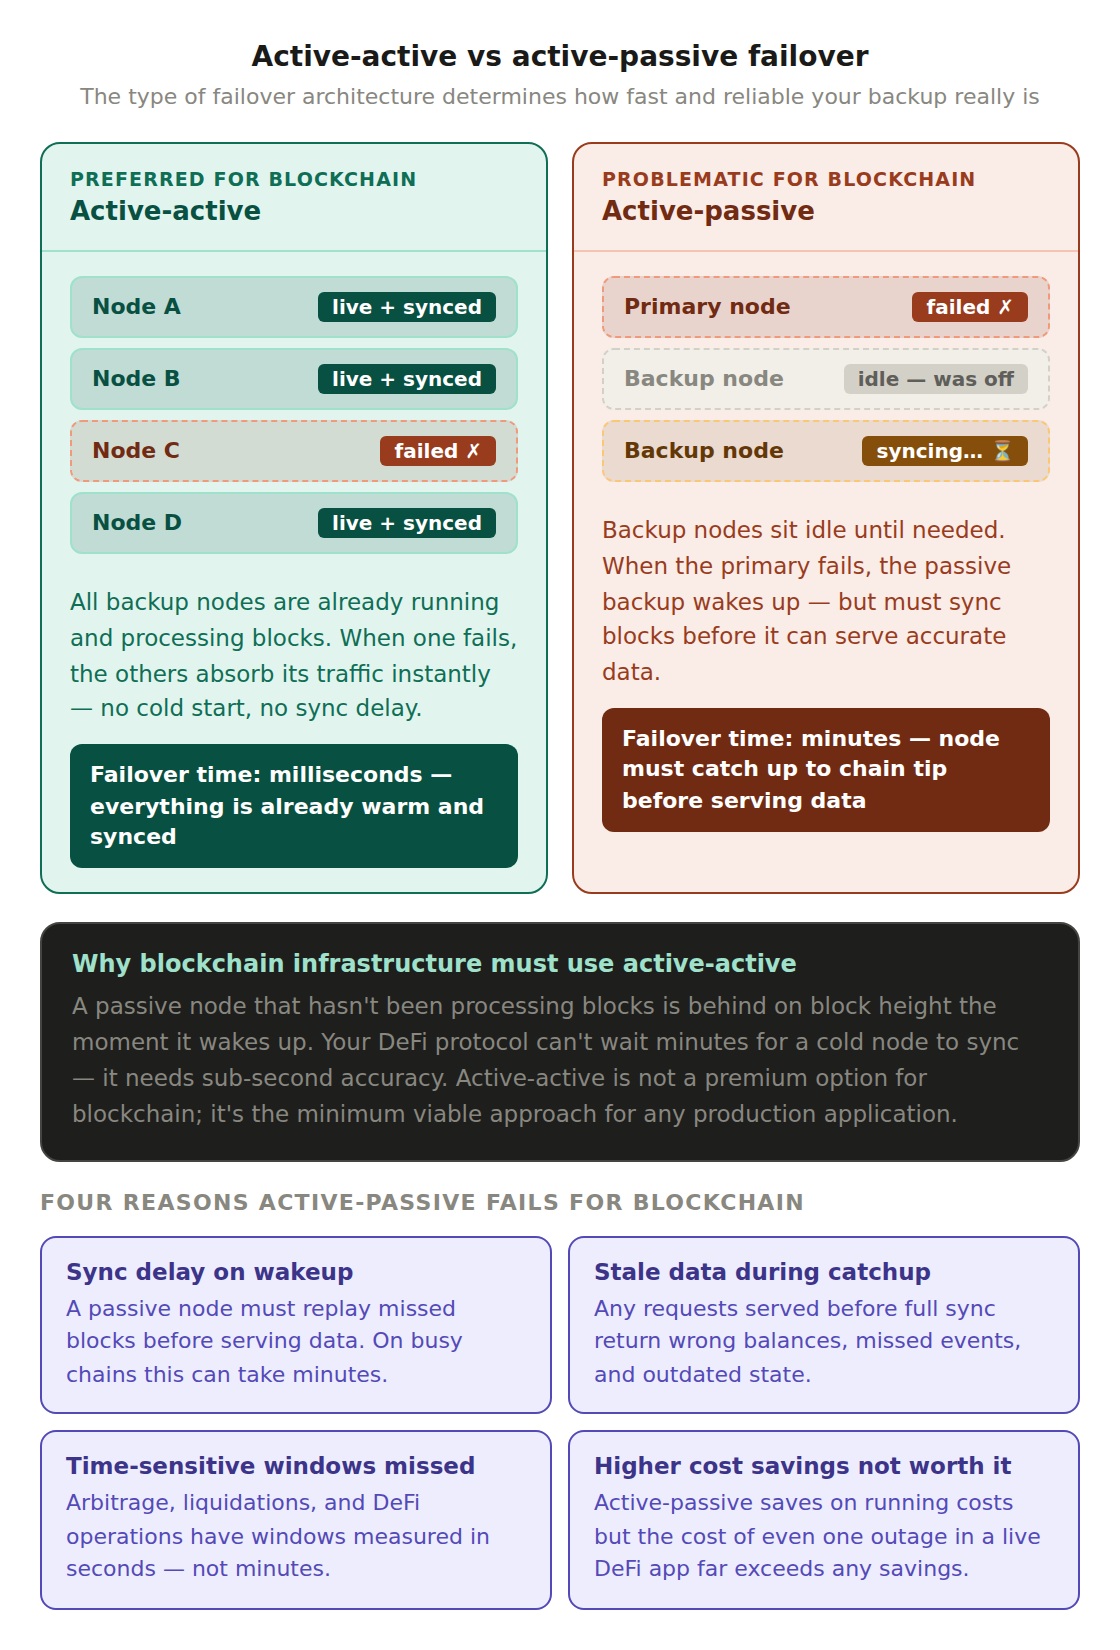
In aktiven Konfigurationen sind alle Backup-Komponenten bereits in Betrieb und verarbeiten Datenverkehr. Fällt eine Komponente aus, übernehmen die anderen einfach ihren Anteil an der Last. Es gibt keine Verzögerung durch einen „Kaltstart“, da alles bereits betriebsbereit ist. Dies ist das bevorzugte Modell für die Blockchain-Infrastruktur, da die Knoten stets mit der Blockchain synchronisiert bleiben müssen. Ein Knoten, der keine Blöcke aktiv verarbeitet, gerät bei der Blockhöhe in Rückstand und ist unbrauchbar, bis er den Rückstand aufgeholt hat.
In aktiven-passiven Konfigurationen bleiben die Backup-Komponenten im Ruhezustand, bis sie benötigt werden. Wenn der primäre Knoten ausfällt, wird das passive Backup aktiviert und übernimmt den Betrieb. Dies ist kostengünstiger im Betrieb, führt jedoch zu einer Verzögerung. Bei Blockchain-Knoten kann diese Verzögerung erheblich sein, da der passive Knoten möglicherweise erst Blöcke synchronisieren muss, bevor er korrekte Daten bereitstellen kann.
Genau aus diesem Grund nutzt der Großteil der Blockchain-Infrastruktur in der Produktion ein „Active-Active“-Failover. Man kann es sich nicht leisten, darauf zu warten, dass ein „Cold Node“ den Rückstand aufholt, wenn das DeFi-Protokoll eine Datengenauigkeit im Subsekundenbereich erfordert.
Die folgende Tabelle gibt einen Überblick über den Vergleich der beiden Failover-Modelle für Blockchain-Workloads:
Aspekt
Aktiv-Aktiv
Aktiv-Passiv
Sicherungsstatus
Alle Knoten sind in Betrieb und wickeln Datenverkehr ab
Standby-Knoten bleiben im Leerlauf, bis sie benötigt werden
Failover-Verzögerung
Near Null, kein Kaltstart
Zu beachten: Das Backup muss erst hochfahren und synchronisieren.
Betriebskosten
Je höher, desto mehr zahlst du für die volle Kapazität
Niedrigerer Standby-Modus verbraucht weniger Ressourcen
Synchronisierung der Blockhöhe
Immer aktuell
Kann hinterherhinken und muss aufholen
Am besten geeignet für
Produktions-RPC und Echtzeitdaten
Kostenempfindliche oder nicht kritische Arbeitslasten
Warum Failover für Blockchain-Anwendungen unverzichtbar ist
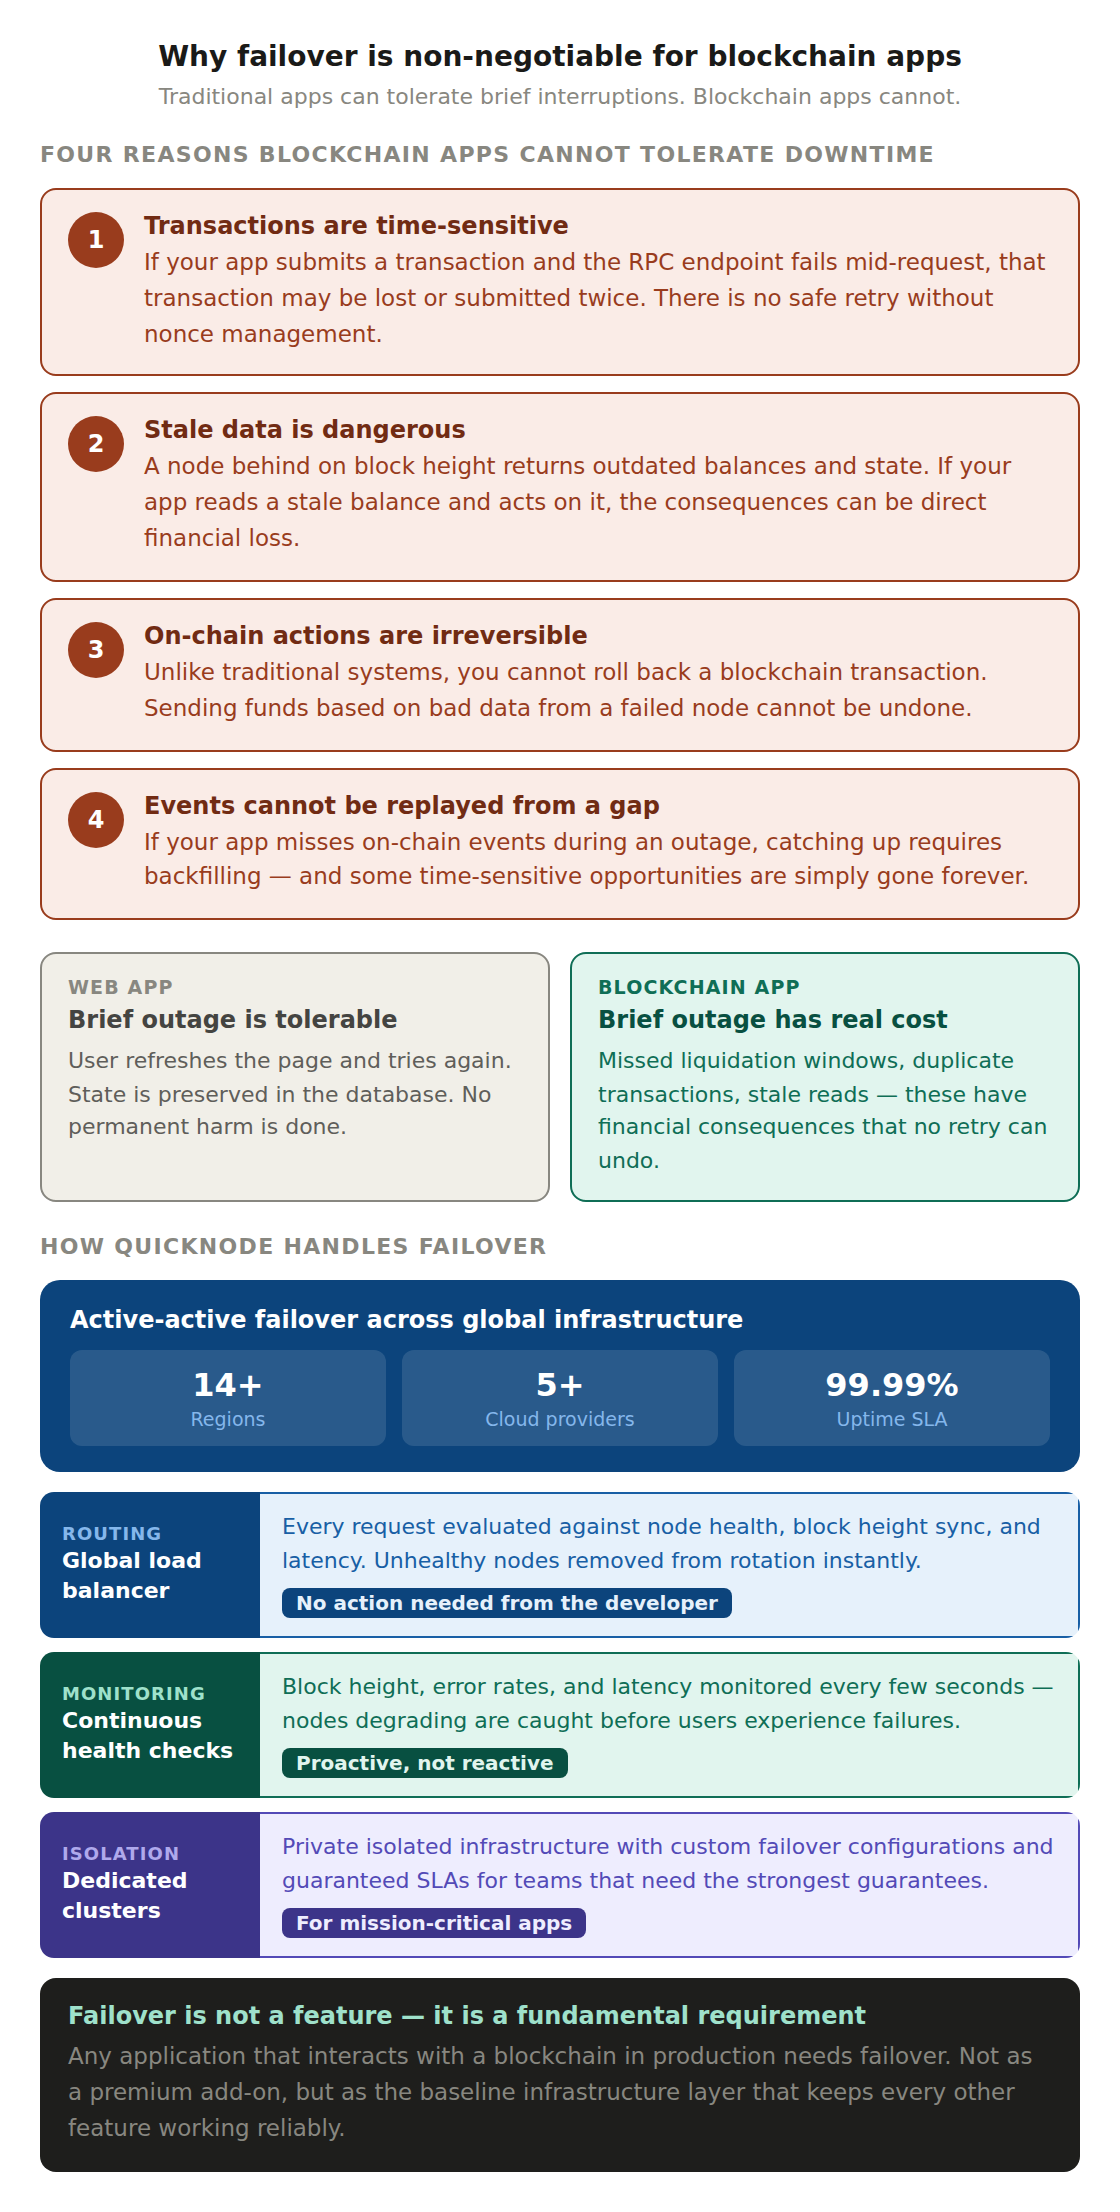
Herkömmliche Webanwendungen können kurze Unterbrechungen oft verkraften. Der Nutzer aktualisiert die Seite, und schon funktioniert alles wieder. Blockchain-Anwendungen haben diesen Luxus aus mehreren Gründen nicht.
Transaktionen sind zeitkritisch. Wenn Ihre Anwendung eine Transaktion übermittelt und die RPC- endpoint -Verbindung während der Anfrage unterbrochen wird, kann diese Transaktion verloren gehen oder doppelt übermittelt werden. Veraltete Daten sind gefährlich. Ein Knoten, der bei der Blockhöhe im Rückstand ist, liefert veraltete Informationen. Wenn Ihre Anwendung einen veralteten Kontostand ausliest und darauf reagiert, kann dies finanzielle Folgen haben. Ereignisse sind unumkehrbar. Im Gegensatz zu herkömmlichen Systemen, in denen Sie Vorgänge wiederholen oder rückgängig machen können, sind Aktionen auf der Blockchain dauerhaft. Das Senden von Geldbeträgen auf der Grundlage fehlerhafter Daten von einem ausgefallenen Knoten lässt sich nicht rückgängig machen.
Aus diesem Grund ist Failover keine bloße Zusatzfunktion. Es handelt sich vielmehr um eine grundlegende Anforderung für jede Anwendung, die im Produktivbetrieb mit einer Blockchain interagiert.
Wie „ Quicknode “ mit Failover umgeht
QuicknodeDie Infrastruktur nutzt ein „Active-Active“-Failover über mehr als 14 Regionen und mehrere Cloud-Anbieter hinweg. Jede Anfrage wird über eine globale Lastverteilungsschicht geleitet, die kontinuierlich den Zustand der Knoten bewertet, einschließlich des Synchronisationsstatus der Blockhöhe, der Antwortlatenz und der Fehlerraten. Sollte sich der Zustand eines Knotens oder einer Region verschlechtern, wird der Datenverkehr automatisch auf die nächstbeste Option umgeleitet, ohne dass seitens des Entwicklers ein Eingreifen erforderlich ist.
Für Teams, die höchste Sicherheit benötigen, bieten dedizierte „ clusters “ eine isolierte Infrastruktur mit individuellen Failover-Konfigurationen und SLAs mit garantierter Verfügbarkeit.
Was ist der Unterschied zwischen Failover und Lastenausgleich?
Failover und Lastenausgleich sind eng miteinander verbunden, lösen jedoch unterschiedliche Probleme. Beim Lastenausgleich werden eingehende Anfragen auf einen Pool funktionsfähiger Knoten verteilt, sodass kein einzelner Knoten überlastet wird. Ein Failover findet statt, wenn einer dieser Knoten nicht mehr funktionsfähig ist: Der Datenverkehr wird vom ausgefallenen Knoten abgezogen und auf die übrigen Knoten umgeleitet. In der Praxis arbeiten beide Mechanismen zusammen, und eine robuste Hochverfügbarkeitslösung erfordert, dass beide nebeneinander betrieben werden.
Fähigkeit
Lastverteilung
Ausfallsicherung
Hauptberuf
Den Datenverkehr gleichmäßig verteilen
Verkehr von Ausfällen umleiten
Wenn es wirkt
Kontinuierlich, bei jeder Anfrage
Erst wenn eine Komponente verschleißt oder ausfällt
Hauptziel
Leistung und gleichmäßige Auslastung
Kontinuität und Verfügbarkeit
Auslöser
Anfragevolumen
Fehler beim Gesundheitscheck
Was gilt als einzelner Ausfallpunkt?
Ein Single Point of Failure ist jede Komponente, deren Ausfall das gesamte System lahmlegt. Ein einzelner Knoten, eine einzelne Cloud-Region oder eine einzelne Client-Implementierung können jeweils zu einem Single Point of Failure werden. Durch Failover werden diese Schwachstellen beseitigt, indem stets eine funktionsfähige Alternative bereitsteht, die die Aufgaben übernehmen kann. Die Überprüfung der gängigen Ausfallarten bei Blockchains ist der schnellste Weg, um die in Ihrem Stack verborgenen Single Points of Failure aufzuspüren.
Wie lässt sich feststellen, ob das Failover funktioniert?
Das Failover lässt sich anhand einiger konkreter Kennzahlen messen. Die Verfügbarkeit gibt an, wie oft der Dienst erreichbar war, die Wiederherstellungszeit zeigt, wie lange es nach einem Ausfall dauerte, bis der Datenverkehr umgeleitet wurde, und die Fehlerquote während eines Vorfalls gibt an, wie viele Anfragen betroffen waren, bevor die Umstellung abgeschlossen war. Durch die kontinuierliche Überwachung Ihrer Blockchain-Infrastruktur werden diese Zahlen ermittelt, sodass Sie sicherstellen können, dass das Failover ordnungsgemäß funktioniert.
Wie kann man das Failover vor einem tatsächlichen Ausfall testen?
Die einzige Möglichkeit, sich auf das Failover verlassen zu können, besteht darin, es zu proben. Teams schalten einen Knoten oder eine Region gezielt in einem kontrollierten Zeitfenster offline und stellen sicher, dass der Datenverkehr fehlerfrei umgeleitet wird – ein Ansatz, der oft als „Chaos-Test“ bezeichnet wird. Wenn Sie Ihre eigenen Knoten betreiben, können Sie einen Prozess anhalten und beobachten, wohin die Anfragen weitergeleitet werden. Wenn Sie auf einen Managed-Provider wiedie „ Quicknode -Core-API“ zurückgreifen, wird das Failover für Sie übernommen, Sie können es jedoch weiterhin mit regionenübergreifenden Lasttests überprüfen.
Häufig gestellte Fragen
Was versteht man unter „Failover“ in einfachen Worten?
Unter „Failover“ versteht man die automatische Umschaltung von einer ausgefallenen Komponente auf eine funktionierende Ersatzkomponente, damit ein Dienst weiterhin läuft. In den meisten Fällen bemerkt der Benutzer diese Umschaltung gar nicht.
Ist Failover dasselbe wie Redundanz?
Nein. Redundanz bedeutet, dass Ersatzkomponenten bereitstehen, während Failover der Vorgang ist, bei dem der Datenverkehr auf diese Ersatzkomponenten umgeleitet wird, wenn eine Komponente ausfällt. Damit Failover funktioniert, muss eine Infrastrukturredundanz vorhanden sein.
Wie lange dauert das Failover?
Bei Aktiv-Aktiv-Systemen erfolgt das Failover oft near augenblicklich, da die Backup-Systeme den Datenverkehr bereits bedienen. Bei Aktiv-Passiv-Systemen kann es einige Sekunden bis zu mehreren Minuten dauern, bis das Standby-System hochgefahren und synchronisiert ist.
Verhindert Failover jegliche Ausfallzeiten?
Failover reduziert Ausfallzeiten erheblich, kann jedoch nicht in jeder Situation eine Unterbrechungsfreiheit garantieren. Eine gut konzipierte, über viele Regionen verteilte Aktiv-Aktiv-Infrastruktur kommt diesem Ziel sehr nahe, weshalb sie als Standard für Blockchain-Anwendungen in der Produktion gilt.
Warum ist Failover für Blockchain-Anwendungen so wichtig?
Blockchain-Vorgänge sind zeitkritisch und oft unumkehrbar, sodass ein ausgefallener endpoint eine Transaktion verwerfen oder veraltete Daten zurückgeben kann. Ein automatisches Failover schützt sowohl die Zuverlässigkeit als auch die Gelder der Nutzer, was für Dienste, die auf Echtzeitdaten basieren, von entscheidender Bedeutung ist streams.