Antworten>Erfahren Sie mehr über RPC und APIs>Was ist RPC-Latenz?
Was ist RPC-Latenz?
// Tags
RPC-LatenzBlockchain-LatenzAPI-Antwortzeit
TL;DR: Die RPC-Latenz ist die Zeit, die Ihre Anwendung benötigt, um eine Anfrage an einen Blockchain-Knoten zu senden und eine Antwort zu erhalten. Sie wird in Millisekunden gemessen und wirkt sich direkt darauf aus, wie schnell sich Ihre Dapp für die Nutzer anfühlt. Eine hohe Latenz bedeutet langsame Kontostandsaktualisierungen, verzögerte Transaktionsbestätigungen und verpasste Handelsmöglichkeiten. Eine niedrige Latenz sorgt für ein reaktionsschnelles Erlebnis in Echtzeit. Die RPC-Latenz hängt von der Netzwerkentfernung, der Knotenleistung, der Komplexität der Anfragen und der Qualität Ihres Infrastrukturanbieters ab.
Die einfache Erklärung
Jedes Mal, wenn Ihre Anwendung mit der Blockchain interagiert, entsteht eine Verzögerung zwischen der Abfrage und dem Erhalt der Antwort. Diese Verzögerung wird als Latenz bezeichnet. Wenn ein Nutzer Ihre Wallet-App öffnet und eine halbe Sekunde warten muss, bis sein Guthaben angezeigt wird, ist diese Wartezeit in erster Linie auf die RPC-Latenz zurückzuführen. Wenn ein Trading-Bot eine Swap-Transaktion sendet und es 200 Millisekunden dauert, bis die Bestätigung eintrifft, dass der Knoten die Transaktion akzeptiert hat, sind diese 200 ms Latenz. Die Zahl mag gering erscheinen, doch in Blockchain-Anwendungen – insbesondere in den Bereichen DeFi, Gaming und Handel – summieren sich diese Millisekunden zu echten Unterschieden in der Benutzererfahrung und den finanziellen Ergebnissen.
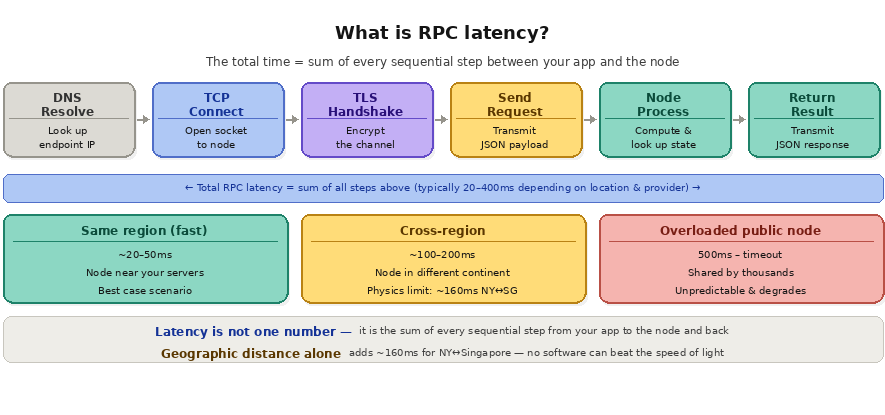
Die Latenz lässt sich nicht mit einer einzigen Zahl beziffern. Sie setzt sich aus mehreren aufeinanderfolgenden Schritten zusammen: DNS-Auflösung (Abfrage der IP-Adresse von endpoint), Aufbau der TCP-Verbindung, TLS-Handshake (Verschlüsselung der Verbindung), Übertragung der Anfrage, Verarbeitungszeit des Knotens, Übertragung der Antwort und Auswertung der Antwort. Jeder Schritt verlängert die Gesamtzeit. Eine Anfrage an einen Knoten in derselben geografischen Region kann innerhalb von 20–50 ms abgeschlossen sein. Eine Anfrage an einen Knoten auf der anderen Seite der Welt kann 200–400 ms dauern. Dieselbe Anfrage an einen überlasteten oder schlecht gewarteten Knoten kann Sekunden dauern oder sogar vollständig ablaufen.
Warum Latenz wichtiger ist, als Sie denken
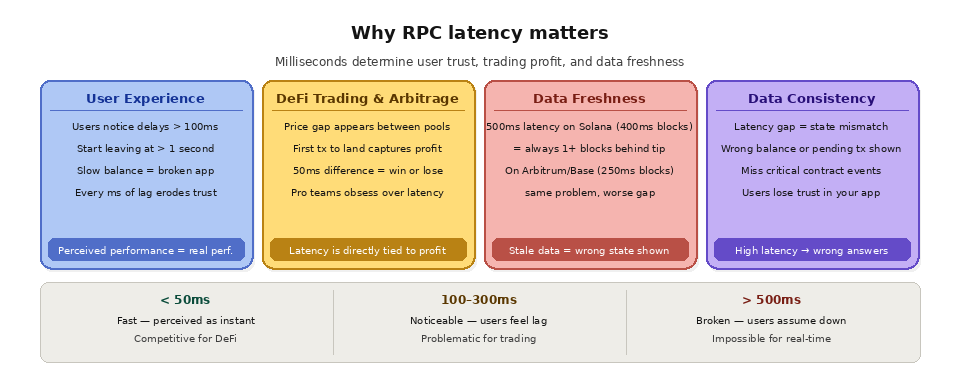
Bei benutzerseitigen Anwendungen ist die Latenz der mit Abstand wichtigste Faktor für die wahrgenommene Leistung. Untersuchungen zu Webanwendungen zeigen durchweg, dass Nutzer Verzögerungen von mehr als 100 ms bemerken und Interaktionen ab einer Dauer von mehr als einer Sekunde abbrechen. Bei Blockchain-Anwendungen verhält es sich nicht anders. Wenn die Abfrage eines Kontostands zwei Sekunden dauert, weil Ihr RPC-Anbieter langsam ist, gehen die Nutzer davon aus, dass Ihre App nicht funktioniert – und nicht, dass die dahinterstehende Infrastruktur verzögert reagiert.
Beim DeFi-Handel und bei der Arbitrage hängt die Latenz direkt mit der Rentabilität zusammen. Wenn zwischen zwei Liquiditätspools eine Preisabweichung auftritt, sichert sich der erste Bot, der eine Transaktion abschließt, den Gewinn. Ein Unterschied von 50 ms bei der RPC-Antwortzeit kann darüber entscheiden, ob Ihre Transaktion vor der eines Konkurrenten berücksichtigt wird. Aus diesem Grund legen professionelle Handelsteams größten Wert auf die Latenz der Infrastruktur und nutzen häufig dedizierte Endpunkte, die sich in geografischer Nähe zu den Validatoren befinden.
Aus Gründen der Datenkonsistenz führt die Latenz zu einer Diskrepanz zwischen dem tatsächlichen Zustand der Blockchain und dem, was Ihre Anwendung anzeigt. Auf Solana, wo alle 400 ms ein Block erzeugt wird, bedeutet ein RPC-Anbieter mit einer durchschnittlichen Latenz von 500 ms, dass Ihre Anwendung immer mindestens einen Block hinter der Chain-Tip zurückliegt. Auf Ethereum L2-Lösungen wie Arbitrum oder Base, die alle 250 ms Blöcke erzeugen, tritt dasselbe Problem auf. Quicknode hat die Metrik „Latency Freshness Score“ eingeführt, die die RPC-Antwortzeit mit der Blockerzeugungsrate einer Kette vergleicht und Entwicklern so einen genauen Maßstab dafür liefert, wie nah ihre Daten tatsächlich an der Echtzeit liegen.
Was bestimmt die RPC-Latenz?
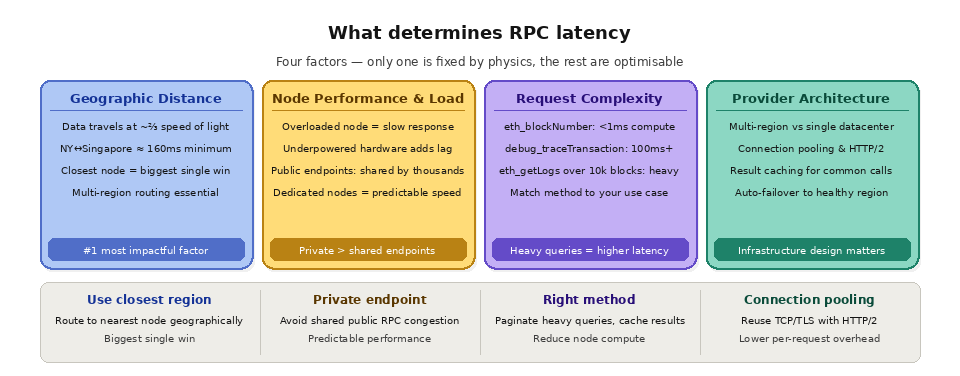
Die geografische Entfernung ist der entscheidende Faktor. Daten werden über Glasfaserkabel mit etwa zwei Dritteln der Lichtgeschwindigkeit übertragen. Das bedeutet, dass eine Hin- und Rückübertragung zwischen New York und Singapur eine rein physikalisch bedingte Verzögerung von etwa 160 ms verursacht, die sich durch keine Softwareoptimierung beseitigen lässt. Die Verbindung zu einem Knotenpunkt herzustellen, der sich in geografischer Nähe zu Ihren Anwendungsservern (oder Ihren Nutzern) befindet, ist die wirksamste Maßnahme, die Sie ergreifen können, um die Latenz zu reduzieren.
Die Leistung und Auslastung eines Knotens sind der zweite Faktor. Ein Knoten, der Tausende von gleichzeitigen Anfragen verarbeitet, bei der Blocksynchronisation in Verzug gerät oder auf leistungsschwacher Hardware läuft, reagiert langsamer als ein gut ausgestatteter, wenig ausgelasteter Knoten. Dies ist das grundlegende Problem öffentlicher RPC-Endpunkte: Sie werden von Tausenden von Benutzern gemeinsam genutzt, sodass ihre Antwortzeiten unvorhersehbar sind und sich bei Traffic-Spitzen verschlechtern.
Auch die Komplexität der Anfrage spielt eine Rolle. Ein einfacher „eth_blockNumber“-Aufruf erfordert fast keinen Rechenaufwand und liefert eine sehr kurze Antwort. Ein „debug_traceTransaction“-Aufruf erfordert, dass der Knoten eine gesamte Transaktion erneut ausführt und einen detaillierten Ausführungsablauf zurückgibt, was Hunderte von Millisekunden oder länger dauern kann. Eine „eth_getLogs“-Abfrage, die sich über Tausende von Blöcken erstreckt, erfordert, dass der Knoten erhebliche Datenmengen durchsucht. Wenn Sie den Rechenaufwand Ihrer RPC-Aufrufe kennen, können Sie realistische Erwartungen festlegen und Ihre Anfragemuster optimieren.
Die Infrastrukturarchitektur des Anbieters ist der letzte Faktor. Anbieter, die global verteilte Knoten clusters en mit intelligentem Request-Routing, Connection-Pooling und Ergebnis-Caching betreiben, bieten geringere und gleichmäßigere Latenzzeiten als Anbieter, deren Knoten in einem einzigen Rechenzentrum betrieben werden. Multiregionale Architekturen sorgen zudem für Ausfallsicherheit: Wenn in einer Region Probleme auftreten, wird der Datenverkehr automatisch an die nächstgelegene funktionierende Region umgeleitet.
Was ist eine gute RPC-Latenz?
Ein gutes Latenzziel hängt von der jeweiligen Blockchain ab, die Sie bedienen, sowie davon, wo sich Ihre Nutzer befinden. Der aussagekräftige Maßstab ist nicht ein absoluter Wert in Millisekunden, sondern das Verhältnis Ihrer Antwortzeit zur Blockerzeugungsrate der Blockchain: Wenn Sie langsamer antworten, als die Blockchain Blöcke erzeugt, sind Ihre Daten immer mindestens einen Block veraltet. Die folgende Tabelle enthält praktische Zielwerte für die Echtzeit-Reaktionsfähigkeit.
Kontext
Blockzeit
Latenzziel für Echtzeitanwendungen
Solana
Zeitfenster von ca. 400 ms
Unter ~100 ms
Ethereum L2 (Base, Arbitrum)
~250 ms
Unter ~100 ms
Ethereum L1
~12 Sekunden
Unter ~250 ms
Anfrage innerhalb derselben Region
Nicht zutreffend
20 bis 50 ms
Weltweite Anfrage
Nicht zutreffend
200 bis 400 ms
Als Faustregel gilt, dass Nutzer Verzögerungen ab 100 ms wahrnehmen; wenn typische RPC-Antworten also unter diesem Schwellenwert bleiben, wirken sie sofort. Um die hinter diesen Zahlen stehenden Aufrufe zu verstehen, lesen Sie, wie RPC-Anfragen funktionieren und welche Rolle der RPC- endpoint spielt.
Was ist der Unterschied zwischen Latenz und Durchsatz?
Latenz und Durchsatz werden oft verwechselt, doch sie messen unterschiedliche Größen. Die Latenz gibt an, wie lange eine einzelne Anfrage vom Absenden bis zur Antwort dauert. Der Durchsatz gibt an, wie viele Anfragen das System pro Zeiteinheit verarbeiten kann. Ein Anbieter kann eine niedrige Latenz, aber einen begrenzten Durchsatz aufweisen oder einen hohen Durchsatz, aber unter Last eine unbeständige Latenz. Beide Faktoren sind wichtig, und die Optimierung des einen führt nicht automatisch zu einer Verbesserung des anderen.
Aspekt
Latenz
Durchsatz
Maßnahmen
Zeit für eine Bitte
Pro Sekunde bearbeitete Anfragen
Einheit
Millisekunden
Anfragen pro Sekunde
Wahrgenommen als
Wie reaktionsschnell sich die App anfühlt
Wie viel Last kann es tragen?
Verletzt durch
Entfernung und Knotenauslastung
Kapazitätsgrenzen und Preisobergrenzen
Eine ausführlichere Erörterung dieses Kompromisses finden Sie unter „Durchsatz vs. Latenz“. Ein hohes Anforderungsvolumen kann zudem eine RPC-Ratenbegrenzung auslösen, was zu Wiederholungsversuchen und Warteschlangen führt, die sich in einer höheren effektiven Latenz niederschlagen.
Wie lässt sich die RPC-Latenz verringern?
Die größten Vorteile ergeben sich aus der Verkürzung der Übertragungswege und der Reduzierung der Datenlast. Stellen Sie eine Verbindung zu einem Knoten her, der geografisch nahe an Ihren Nutzern liegt, nutzen Sie einen multiregionalen Anbieter mit automatischem Routing und verwenden Sie Verbindungen wieder, um wiederholte DNS-, TCP- und TLS-Einrichtungskosten zu vermeiden. Fassen Sie aufwendige Aufrufe zu Stapeln zusammen oder vereinfachen Sie sie und ersetzen Sie enge Abfrageschleifen durch Push-basierte Übermittlung, damit Sie nicht wiederholt Latenzzeiten für dieselben Daten in Kauf nehmen müssen. Die Entscheidung für Streaming statt Polling, der Einsatz zuverlässiger Knoten und die Einrichtung eines Failover-Pfads sorgen dafür, dass die Latenz niedrig und konsistent bleibt, selbst wenn eine Route ausfällt.
Häufig gestellte Fragen
Ist die RPC-Latenz dasselbe wie die Blockbestätigungszeit?
Nein. Die RPC-Latenz ist die Round-Trip-Zeit, die benötigt wird, um eine Abfrage an einen Knoten zu senden und eine Antwort zu erhalten; sie wird in Millisekunden gemessen. Die Blockbestätigungszeit gibt an, wie lange die Blockchain benötigt, um eine Transaktion aufzunehmen und abzuschließen; dies wird durch das Protokoll geregelt. Selbst eine schnelle RPC- endpoint n kann nicht bewirken, dass eine Blockchain Blöcke schneller bestätigt, als es ihre Blockzeit zulässt.
Warum ist mein RPC- endpoint -Dienst so langsam?
Die häufigsten Ursachen sind die geografische Entfernung zum Knoten, ein stark ausgelasteter oder unterdimensionierter Knoten sowie ressourcenintensive Anfragetypen wie Trace- oder umfangreiche Protokollabfragen. Öffentliche Endpunkte, die von vielen Benutzern gemeinsam genutzt werden, sind besonders anfällig für unvorhersehbare, sprunghafte Latenzen bei Datenverkehrsspitzen.
Hat die Latenz Auswirkungen auf den DeFi-Handel?
Ja, direkt. Wenn sich eine Arbitrage-Gelegenheit ergibt, sichert die erste Transaktion, die erfolgreich abgeschlossen wird, den Gewinn. Daher kann bereits ein Vorsprung von 50 ms bei der RPC-Antwortzeit darüber entscheiden, ob Ihre Transaktion vor der eines Mitbewerbers berücksichtigt wird.
Wie wird die RPC-Latenz gemessen?
Es handelt sich um die verstrichene Zeit vom Absenden einer Anfrage bis zum Empfang der Antwort, summiert aus DNS-Auflösung, Verbindungsaufbau, TLS-Handshake, Übertragung, Verarbeitung durch den Knoten und Auswertung der Antwort. Teams verfolgen in der Regel Latenz-Perzentile wie p50 und p99 anstelle eines einzelnen Durchschnittswerts.
Bedeutet eine geringe Latenzzeit, dass die Daten aktuell sind?
Nicht von allein. Ein schneller endpoint , der bei der Blocksynchronisation im Rückstand ist, kann schnell veraltete Ergebnisse liefern. Echtzeit-Aktualität erfordert sowohl eine geringe Latenz als auch einen Knoten, der eng mit der Chain-Spitze synchronisiert ist. Deshalb sollte die Antwortzeit mit der Blockerzeugungsrate verglichen werden.
Wie „ Quicknode “ eine geringe Latenz gewährleistet
QuicknodeDie Infrastruktur von [Name] wurde speziell für den Zugriff auf Blockchain-Daten mit geringer Latenz entwickelt. Die Plattform betreibt ein global verteiltes Netzwerk, das sich über mehr als 14 Regionen bei mehr als 5 Cloud- und Bare-Metal-Anbietern erstreckt und sicherstellt, dass Anfragen an den nächstgelegenen verfügbaren Knoten weitergeleitet werden, unabhängig davon, wo sich Ihre Anwendung oder Ihre Nutzer befinden. Diese Architektur liefert im Durchschnitt 2,5-mal schnellere Antwortzeiten als die der Wettbewerber, gemessen mit QuickLee, dem Open-Source-RPC-Benchmarking-Tool v Quicknode, das transparente Latenzdaten in Echtzeit über mehrere Blockchains und Regionen hinweg bereitstellt.
Quicknode gewährleistet über alle unterstützten Blockchains hinweg eine hohe Aktualität der Blockhöhe, was bedeutet, dass seine Knoten stets eng mit dem neuesten Block synchronisiert sind. Dies ist entscheidend für schnelllebige Blockchains, bei denen bereits ein Rückstand von wenigen Blöcken gegenüber der Spitze die Aktualität der Daten beeinträchtigt. Die Infrastruktur skaliert sich automatisch entsprechend der Auslastung und verfügt über automatische Failover-Mechanismen, sodass die Latenz auch bei Traffic-Spitzen konstant bleibt.
Für Anwendungen mit höchsten Anforderungen an die Latenz bieten die dedizierten „ Clusters “ von Quicknode eine isolierte, private Infrastruktur ohne gemeinsam genutzten Datenverkehr anderer Kunden. Dedizierte „ Clusters “ beseitigen das Problem der „Noisy Neighbors“ vollständig und liefern jederzeit eine vorhersehbare Leistung mit geringer Latenz. Speziell für „ Solana “ verwenden die Endpunkte von QuicknodeYellowstone gRPC Endpunkte von xml-ph-0004@deepl.internal Protocol Buffers anstelle von JSON für die Datenserialisierung, wodurch die Nutzdatengröße und die Parsing-Zeit reduziert werden, um bei hochfrequenten Anwendungsfällen eine möglichst geringe Latenz zu erzielen.