Antworten>Erfahren Sie mehr über Blockchain-Datenstromübertragung>Abfrage vs. Streaming von Blockchain-Daten
Abfrage vs. Streaming von Blockchain-Daten
// Tags
Polling vs. Streaming WebSocket-Blockchain
TL;DR: Polling ist ein Pull-basiertes Muster, bei dem Ihre Anwendung in festen Intervallen wiederholt einen Blockchain-Knoten nach neuen Daten abfragt. Streaming ist ein Push-basiertes Muster, bei dem neue Daten automatisch an Ihre Anwendung übermittelt werden, sobald sie in der Blockchain erzeugt werden. Polling ist einfach zu implementieren, verschwendet jedoch Ressourcen, verursacht Latenz und birgt das Risiko, dass Daten verloren gehen. Streaming ist effizienter, schneller und im großen Maßstab zuverlässiger, erfordert jedoch eine andere Infrastruktur. Für die meisten Blockchain-Anwendungen im Produktivbetrieb ist Streaming der bessere Ansatz für die Datenerfassung.
Die einfache Erklärung
Jede Blockchain-Anwendung muss wissen, wann etwas in der Blockchain geschieht. Eine Wallet muss wissen, wann ihr Nutzer eine Überweisung erhält. Ein DeFi-Protokoll muss erkennen, wann sich ein Preisorakel aktualisiert. Ein Trading-Bot muss neue Transaktionen sofort erkennen, sobald sie in einen Block aufgenommen werden. Eine Analyseplattform muss jeden Block verarbeiten, sobald er erzeugt wird. Die Frage ist, wie Ihre Anwendung von diesen Ereignissen erfährt.
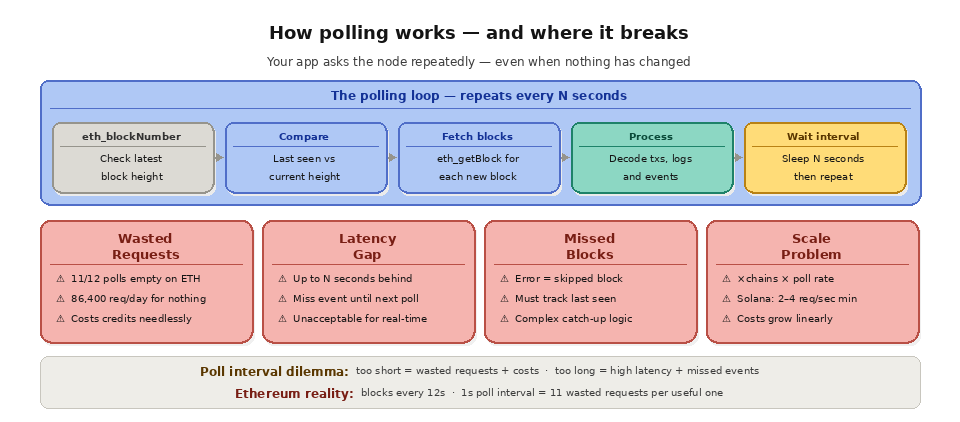
Beim Polling führt Ihre Anwendung eine Schleife aus: Aufruf des RPC- endpoint s, Überprüfung, ob etwas Neues passiert ist, Verarbeitung neuer Daten, Warten eines festgelegten Zeitraums, Wiederholung. Dies ist das Muster, das die meisten Entwickler als Erstes lernen, da es sich nahtlos an die Funktionsweise von HTTP-APIs anlehnt. Einen Timer einrichten, alle N Sekunden eine Anfrage stellen, die Antwort verarbeiten. Es erfordert keine spezielle Infrastruktur, abgesehen von der Fähigkeit, HTTP-Anfragen zu stellen.
Beim Streaming stellt Ihre Anwendung einmalig eine Verbindung her oder richtet eine Datenpipeline ein, und neue Daten treffen automatisch ein. Es gibt keine Schleife, keinen Timer und keine wiederholten Anfragen. Sobald ein neuer Datenblock generiert wird, fließen die Daten zu Ihrer Anwendung, ohne dass diese danach fragen muss. Die Aufgabe der Anwendung besteht lediglich darin, die eingehenden Daten zu verarbeiten, sobald sie eintreffen.
So funktioniert die Meinungsumfrage in der Praxis
Eine typische Polling-Implementierung zur Überwachung neuer Blöcke sieht wie folgt aus: Ihre Anwendung ruft „eth_blockNumber“ auf, um den neuesten Block abzurufen, vergleicht diesen mit dem zuletzt verarbeiteten Block, ruft etwaige neue Blöcke über „eth_getBlockByNumber“ ab, extrahiert die benötigten Daten und plant den nächsten Polling-Vorgang. Jede Iteration erfordert mindestens einen RPC-Aufruf (zur Überprüfung der aktuellen Blocknummer) und möglicherweise viele weitere (zum Abrufen der vollständigen Blockdaten, Transaktionsbelege und Ereignisprotokolle für jeden neuen Block).
Das Abfrageintervall ist eine entscheidende Designentscheidung. Wenn Sie zu häufig abfragen, verschwenden Sie RPC-Anfragen (und Credits), indem Sie nach „Gibt es etwas Neues?“ fragen, obwohl die Antwort „Nein“ lautet. Auf Ethereum, wo alle 12 Sekunden Blöcke erzeugt werden, bedeutet eine Abfrage pro Sekunde, dass 11 von 12 Anfragen keine nützlichen Informationen liefern. Abfragen Sie zu selten, verursachen Sie Latenz. Bei einem Intervall von 30 Sekunden entdecken Sie einen neuen Block möglicherweise erst 30 Sekunden nach seiner Erstellung. Außerdem könnten Sie mehrere Blöcke pro Intervall verarbeiten, was zu einer ungleichmäßigen Auslastung Ihres Systems führt.
Das Polling birgt mehrere Risiken hinsichtlich der Zuverlässigkeit. Wenn ein Poll aufgrund eines Netzwerkfehlers, einer Ratenbegrenzung oder eines Problems mit einem Knoten fehlschlägt, könnte Ihre Anwendung einen Block vollständig verpassen, es sei denn, sie verfolgt die Nummer des zuletzt verarbeiteten Blocks und kehrt beim nächsten erfolgreichen Poll zu diesem Punkt zurück. Wenn Ihre Anwendung abstürzt oder neu gestartet wird, muss sie ermitteln, an welcher Stelle sie aufgehört hat, und ab diesem Punkt fortfahren, wobei sie alle Blöcke verarbeitet, die während der Ausfallzeit erzeugt wurden. Wenn der Polling-Worker aufgrund von Verarbeitungsverzögerungen in Rückstand gerät, vergrößert sich die Lücke zwischen der Kettenspitze und dem Status Ihrer Anwendung, und um den Rückstand aufzuholen, muss ein Rückstau an Blöcken verarbeitet werden.
Bei Ketten mit hohem Durchsatz wird das Polling besonders problematisch. Solana erzeugt alle 400 ms Slots. Arbitrum und Base erzeugen alle 250 ms Blöcke. Das Polling dieser Ketten mit ihrer Blockerzeugungsrate erfordert 2–4 RPC-Anfragen pro Sekunde allein für die Überprüfung der Blocknummern, zuzüglich weiterer Anfragen für die vollständigen Blockdaten. Bei Skalierung über mehrere Ketten hinweg wächst das RPC-Anfragevolumen (und die Kosten) linear mit der Anzahl der Ketten und der jeweiligen Blockerzeugungsrate.
So funktioniert Streaming in der Praxis
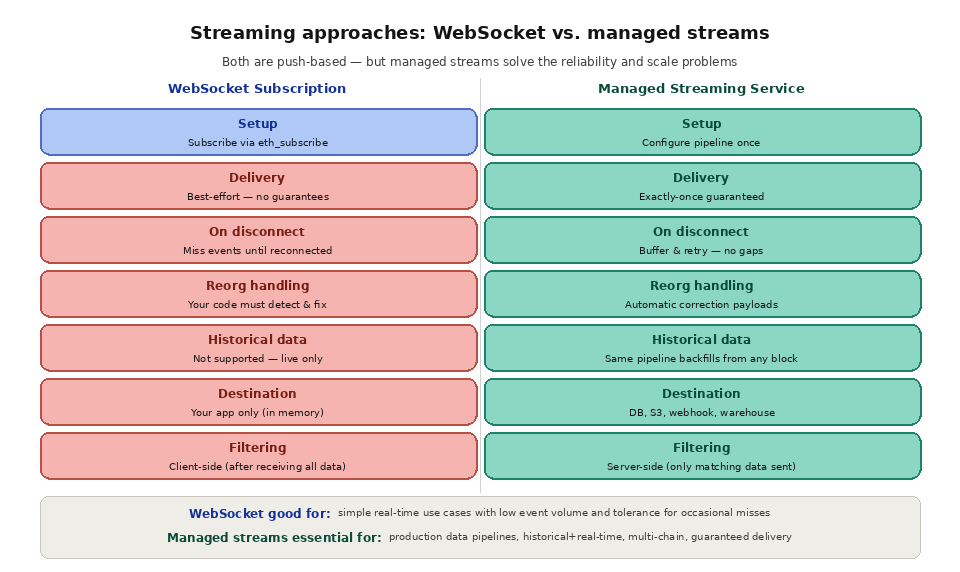
WebSocket-Abonnements sind die einfachste Form des Blockchain-Streamings. Ihre Anwendung baut eine dauerhafte WebSocket-Verbindung zu einem Knoten auf und sendet eine Abonnementanfrage (z. B. „eth_subscribe“ mit „newHeads“). Der Knoten übermittelt jeden neuen Block-Header über die offene Verbindung an Ihre Anwendung, sobald dieser erzeugt wurde. Kein Polling, keine unnötigen Anfragen, keine Latenzverzögerung.
WebSockets eignen sich gut für einfache Anwendungsfälle, weisen jedoch bei großem Umfang erhebliche Einschränkungen auf. Die Verbindungen sind zustandsbehaftet und können aufgrund von Netzwerkproblemen, Serverneustarts oder Timeouts bei Inaktivität unterbrochen werden. Wenn eine Verbindung unterbrochen wird, entgehen Ihrer Anwendung alle Ereignisse, die vor der Wiederherstellung der Verbindung auftreten, und sie muss die Unterbrechung erkennen, die Verbindung wiederherstellen und die Lücke schließen. Die Verwaltung mehrerer gleichzeitiger WebSocket-Verbindungen über mehrere Ketten hinweg erhöht die Komplexität. WebSocket-Abonnements unterstützen zudem keine historischen Daten. Wenn Sie Blöcke aus der letzten Woche verarbeiten müssen, sind WebSockets keine Hilfe.
Speziell entwickelte Streaming-Dienste beheben diese Einschränkungen. Anstatt instabile WebSocket-Verbindungen aufrechtzuerhalten, konfiguriert Ihre Anwendung eine Datenpipeline, die der Streaming-Dienst durchgängig verwaltet. Der Dienst stellt eine Verbindung zu Blockchain-Knoten her, verarbeitet jeden Block, wendet Ihre Filter an und liefert die Ergebnisse mit garantierter Zustellung an Ihr Ziel. Sollte Ihr Ziel vorübergehend nicht erreichbar sein, puffert der Dienst die Daten und versucht es erneut. Im Falle einer Reorganisation sendet der Dienst korrigierte Datenpakete. Wenn Sie historische Daten benötigen, kann dieselbe Pipeline Daten ab einem beliebigen Startblock nachliefern.
Ein Vergleich der beiden Ansätze
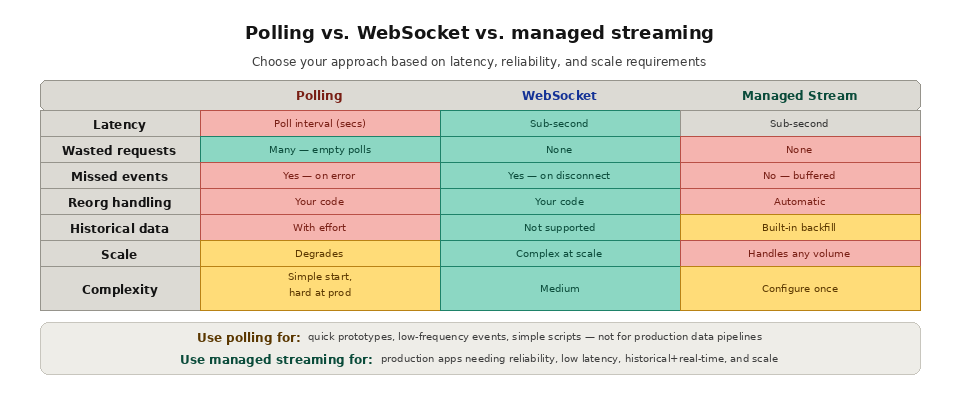
Die Latenz ist der auffälligste Unterschied. Bei der Abfrage entspricht die Latenz im besten Fall immer dem Abfrageintervall, in der Praxis ist sie jedoch aufgrund der Verarbeitungszeit und der Fehlerbehebung länger. Beim Streaming werden Daten sofort bereitgestellt, sobald sie verfügbar sind, in der Regel innerhalb von Sekunden nach der Erstellung eines Blocks. Für latenzempfindliche Anwendungen wie Trading-Bots oder Echtzeit-Dashboards ist das Streaming deutlich schneller.
Die Ressourceneffizienz ist der zweite wesentliche Unterschied. Beim Polling entsteht ein Anfragevolumen, das proportional zur Abfragehäufigkeit ist, unabhängig davon, ob neue Daten vorliegen. Ein Polling-Worker, der jede Sekunde nach neuen Blöcken sucht, stellt täglich 86.400 Anfragen, selbst wenn er nur an einem bestimmten Ereignis interessiert ist, das einmal pro Woche eintritt. Beim Streaming werden Ressourcen proportional zum tatsächlichen Datenvolumen verbraucht. Wenn nichts passiert, was Ihren Filterkriterien entspricht, wird nichts übermittelt, und auf Ihrer Seite werden keine Ressourcen verbraucht.
Im großen Maßstab unterscheidet sich der eine vom anderen Ansatz durch die Zuverlässigkeit. Beim Polling muss Ihre Anwendung selbst die Zustandsverfolgung, die Lückenerkennung, die Fehlerbehebung und die Nachhollogik übernehmen. Jeder Sonderfall (fehlende Blöcke, doppelte Verarbeitung, Reorganisationen, Ratenbegrenzungen, Knoten-Failovers) muss in Ihrem Code behandelt werden. Streaming-Dienste bearbeiten diese Sonderfälle auf Anbieterseite und liefern einen lückenlosen, geordneten und deduplizierten Feed, den Ihre Anwendung verarbeiten kann, ohne sich um die Zuverlässigkeit der Infrastruktur sorgen zu müssen.
Die Komplexität ist der Kompromiss. Polling lässt sich anfangs einfacher umsetzen. Eine einfache Polling-Schleife lässt sich in 20 Zeilen Code schreiben. Doch diese Einfachheit täuscht, denn produktionsreifes Polling erfordert Fehlerbehandlung, Backoff-Logik, Zustandsverwaltung, Reorg-Erkennung und Überwachung, was den Code auf Hunderte von Zeilen anwachsen lassen kann. Streaming erfordert zwar eine Vorabkonfiguration einer Datenpipeline und eines Zielsystems, das gepushte Daten empfangen kann (wie ein Webhook-Server oder eine Datenbank mit entsprechender Erfassungslogik), doch sobald die Konfiguration erfolgt ist, ist der laufende Wartungsaufwand deutlich geringer.
Was ist der Unterschied zwischen Polling und Streaming?
Polling und Streaming lösen dasselbe Problem – nämlich die Einbindung aktueller On-Chain-Daten in Ihre Anwendung –, kehren jedoch das Kontroll flow us um. Beim Polling ist Ihr Code die aktive Seite: Er ruft wiederholt einen RPC- endpoint auf und fragt ab, ob sich etwas geändert hat. Beim Streaming ist der Anbieter die aktive Seite, der Ihnen jeden neuen Block oder jedes passende Ereignis sofort nach dessen Erstellung übermittelt. Die folgende Tabelle vergleicht die beiden Muster anhand der Aspekte, die im Produktionsbetrieb am wichtigsten sind.
Dimension
Umfrage
Streaming
Daten flow
Auf Pull-Basis: Ihre App fordert Daten an
Push-basiert – die Daten werden automatisch bereitgestellt
Latenz
Mindestens so lang wie das Abfrageintervall
Innerhalb von Sekunden nach der Blockproduktion
Ressourcenverbrauch
Proportional zur Abfragehäufigkeit, auch im Leerlauf
Proportional zum tatsächlichen Datenvolumen
Zuverlässigkeit in großem Maßstab
Ihre App bewältigt Lücken, Wiederholungsversuche und Reorganisationen
Der Anbieter liefert einen geordneten, deduplizierten Feed
Historische Daten
Unterstützt durch erneute Abfrage früherer Blöcke
Unterstützt durch das Wiederbefüllen derselben Pipeline
Komplexität der Einrichtung
Am Anfang ganz einfach, später kostspielig zu sichern
Einmalige Konfiguration, geringer Wartungsaufwand
Am besten geeignet für
Einfache Skripte und selten durchgeführte Überprüfungen
Echtzeit-Apps und Hochdurchsatz-Ketten
Wie wählt man ein Abfrageintervall aus?
Wenn Sie ein Polling durchführen, sollte das Intervall der Blockzeit der Kette entsprechen, aus der Sie Daten abrufen. Ein Polling, das deutlich schneller erfolgt als die Blockerzeugung, verschwendet Anfragen und kann eine Ratenbegrenzung auslösen, während ein Polling, das deutlich langsamer als die Blockzeit erfolgt, vermeidbare Latenz verursacht und Ihren Worker dazu zwingt, mehrere Blöcke gleichzeitig zu verarbeiten. Die folgende Tabelle listet typische Blockzeiten und die praktischen Auswirkungen auf das Polling für jedes Netzwerk auf.
Blockchain
Ungefähre Blockzeit
Auswirkungen der Umfrage
Bitcoin
Etwa 10 Minuten
Ein Zeitabstand von 1 bis 2 Minuten ist mehr als ausreichend
Ethereum
Etwa 12 Sekunden
Alle 4 bis 12 Sekunden abfragen, um auf dem neuesten Stand zu bleiben, ohne Ressourcen zu verschwenden
BNB Smart Chain
Etwa 3 Sekunden
Das Abfragen von Teilblöcken verursacht zusätzlichen Aufwand bei geringem Nutzen
Base
Etwa 250 ms
Die Abfrage kann nicht reibungslos mithalten; ich bevorzuge Streaming
Solana
Etwa 400 ms
Hohes Anfrageaufkommen; Streaming wird dringend bevorzugt
Wann sollte man weiterhin Polling verwenden?
Streaming ist für die meisten Produktions-Workloads die bessere Standardoption, doch in einigen wenigen Fällen ist Polling nach wie vor eine sinnvolle Wahl. Einmalige Skripte, Nacherfassungen und selten ausgeführte Batch-Jobs rechtfertigen selten den Einsatz einer verwalteten Pipeline. Polling ist auch dann sinnvoll, wenn Sie nur einen einzelnen Wert auf Abruf benötigen, beispielsweise eine Kontostandsabfrage vor einer Benutzeraktion, bei der es keinen kontinuierlichen Feed gibt, den man abonnieren könnte. Wenn Aktualität und Datenvolumen jedoch eine Rolle spielen, verschieben sich die Abwägungen schnell, daher ist es hilfreich, den Unterschied zwischen Echtzeit- und historischen Daten zu verstehen, bevor man sich für einen Ansatz entscheidet.
Wie geht das Streaming mit Reorgs und Datenverlusten um?
Das Schwierigste beim Abrufen von Live-Blockchain-Daten ist nicht der „Happy Path“, sondern die Randfälle. Eine Reorganisation der Blockchain kann einen Block ersetzen, den Ihre Anwendung bereits verarbeitet hat, und eine unterbrochene Verbindung kann eine Lücke in Ihren Daten hinterlassen. Bei Raw-Polling oder WebSockets müssen Sie diese Situationen selbst erkennen und beheben. Ein Managed Service wie Quicknode Streams übernimmt das für Sie: Er liefert Daten in der Reihenfolge ihrer endgültigen Bestätigung, sendet Korrekturdaten, wenn eine Reorganisation auftritt, und puffert sowie wiederholt die Übertragung, wenn Ihr Ziel nicht erreichbar ist. Dieser Unterschied macht die push-basierte Bereitstellung im großen Maßstab so viel einfacher zu handhaben.
Häufig gestellte Fragen
Ist Streaming immer besser als Umfragen?
Nicht immer. Bei den meisten Produktionsanwendungen, die kontinuierliche Daten mit geringer Latenz erfordern, ist Streaming in puncto Effizienz und Zuverlässigkeit überlegen. Bei einmaligen Skripten, einfachen Saldenprüfungen oder selten ausgeführten Aufgaben ist das Polling-Verfahren jedoch völlig ausreichend und einfacher einzurichten. Die richtige Wahl hängt davon ab, wie aktuell Ihre Daten sein müssen und wie groß das zu verarbeitende Datenvolumen ist. Eine Einführung in das Push-basierte Modell finden Sie im Artikel „Was ist Blockchain-Daten-Streaming?“.
Wie oft sollte ich einen RPC- endpoint en abfragen?
Passen Sie Ihr Abfrageintervall an die Blockzeit der Blockchain an. Bei Ethereum bleiben Sie durch Abfragen alle 4 bis 12 Sekunden auf dem neuesten Stand, ohne unnötige Aufrufe zu verschwenden. Bei schnellen Blockchains wie Solana oder Base ist eine Abfrage im Blockrhythmus unpraktisch, und Streaming ist die bessere Wahl. Wenn Sie deutlich schneller abfragen, als Blöcke erzeugt werden, erhalten Sie meist keine neuen Daten und verbrauchen unnötig Ihr Anfragekontingent. Informieren Sie sich über die Funktionsweise von RPC-Anfragen, um zu erfahren, was jeder Aufruf beinhaltet.
Ist Polling teurer als Streaming?
Bei großem Umfang ist dies häufig der Fall. Beim Polling werden Anfragen nach einem festen Zeitplan generiert, unabhängig davon, ob neue Daten vorliegen oder nicht. Daher kann ein stark ausgelasteter Polling-Worker täglich Zehntausende von Aufrufen ausführen, um lediglich eine Handvoll Ereignisse zu erfassen. Beim Streaming werden Ressourcen proportional zu den Daten verbraucht, die tatsächlich Ihren Filtern entsprechen. Dies bedeutet in der Regel weniger verschwendete Anfragen und geringere Kosten für kontinuierliche Workloads.
Was passiert mit meinen Daten während einer Reorganisation?
Bei naiven Abfragen oder reinen WebSockets kann es bei einer Reorganisation vorkommen, dass Ihre Anwendung Transaktionen speichert, die in der kanonischen Blockchain nicht mehr vorhanden sind. Ein verwalteter Streaming-Dienst erkennt die Reorganisation und sendet Korrekturdaten, sodass Ihr Systemzustand konsistent bleibt. Das Verständnis des Verhältnisses zwischen Durchsatz und Latenz hilft Ihnen zudem bei der Entscheidung, wie lange Sie warten sollten, bevor Sie Daten als abgeschlossen betrachten.
Kann ich historische Daten von einem Streaming-Dienst abrufen?
Ja. Im Gegensatz zu WebSocket-Abonnements, die neue Ereignisse erst ab dem Zeitpunkt der Verbindungsherstellung liefern, kann eine vollständige Streaming-Pipeline mit derselben Konfiguration Daten aus jedem beliebigen vergangenen Block nachholen. Auf diese Weise können Sie den Verlauf wiedergeben und anschließend nahtlos zu Live-Daten übergehen, ohne zwei separate Systeme betreiben zu müssen.
Wie „ Quicknode “ beide Muster unterstützt
QuicknodeDie Core-API von Quicknode unterstützt sowohl das Polling über HTTP-RPC-Endpunkte als auch Echtzeit-Abonnements über WebSocket-Verbindungen für alle unterstützten Blockchains. Für Anwendungen, die Polling nutzen, enthält der Leitfaden von zu effizienten RPC-Anfragen Best Practices zur Minimierung unnötiger Aufrufe, zur Implementierung einer ordnungsgemäßen Fehlerbehandlung und zur Verwaltung von Ratenbegrenzungen.
Für Anwendungen, die bereit sind, über das Polling hinauszugehen, bietet Quicknode Streams eine vollständig verwaltete Streaming-Pipeline. Streams liefert Blockchain-Daten in Echtzeit mit garantierter Zustellung, Verarbeitung in der Reihenfolge der Finalität, automatischer Reorg-Behandlung und serverseitiger Filterung – und das alles, ohne dass Ihre Anwendung WebSocket-Verbindungen oder eine Polling-Infrastruktur aufrechterhalten muss. Streams unterstützt die Bereitstellung an webhooks, PostgreSQL, Snowflake, Amazon S3, Azure Storage und weitere Systeme und lässt sich somit an jede Backend-Architektur anpassen. Ein Leitfaden zum direkten Vergleich zwischen WebSocket-Abonnements und „ Streams “ ist in der Dokumentation von „ Quicknode “ verfügbar und behandelt die Vor- und Nachteile sowie den Migrationspfad für Teams, die von Polling- oder WebSocket-basierten Architekturen umsteigen.