Antworten>Erfahren Sie mehr über Blockchain-Datenstromübertragung>Echtzeit- vs. historische Blockchain-Daten
Echtzeit- vs. historische Blockchain-Daten
// Tags
Blockchain-Daten in Echtzeithistorische Blockchain-Daten
TL;DR: Echtzeit-Blockchain-Daten sind Informationen aus dem Chain-Tip, den zuletzt erstellten Blöcken und den Transaktionen, die gerade stattfinden. Historische Blockchain-Daten umfassen alles, was davor lag – vom Genesis-Block bis in die jüngste Vergangenheit. Anwendungen benötigen beides: Echtzeitdaten ermöglichen Live-Dashboards, Transaktionsüberwachung und sofortige Benachrichtigungen, während historische Daten Analysen, Audits, das Nachfüllen von Datenbanken und das Trainieren von Modellen unterstützen. Die Herausforderung für die Infrastruktur besteht darin, dass für den effizienten Zugriff auf jede Datenart unterschiedliche Tools erforderlich sind und die besten Architekturen beide in einer einzigen Pipeline vereinen.
Die einfache Erklärung
Stellen Sie sich eine Blockchain als ein ständig wachsendes Hauptbuch vor. Zu jedem Zeitpunkt wird der neueste Eintrag an der Spitze geschrieben. Alles, was dahinter liegt, gehört der Vergangenheit an. Der Unterschied zwischen Echtzeit- und historischen Daten liegt nicht in den Daten selbst (Blöcke sind Blöcke, Transaktionen sind Transaktionen), sondern darin, wann und wie Ihre Anwendung darauf zugreifen muss.
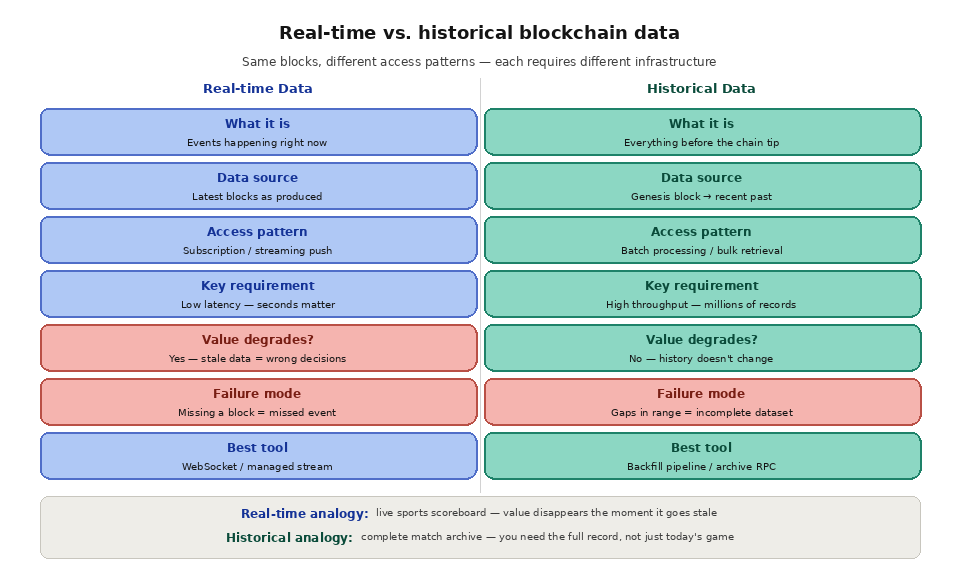
Echtzeitdaten sind das, was gerade passiert. Gerade wurde ein neuer Block generiert. Gerade ist eine Token-Übertragung eingegangen. Gerade wurde ein Smart-Contract-Ereignis ausgelöst. Ihre Anwendung muss so schnell wie möglich über diese Ereignisse informiert werden, idealerweise innerhalb von Sekunden nach der Finalisierung des Blocks. Der Zugriff auf Echtzeitdaten ist latenzempfindlich. Der Wert der Informationen nimmt mit jeder Sekunde Verzögerung ab. Ein Trading-Bot, der erst 30 Sekunden nach einer Preisänderung davon erfährt, ist im Vergleich zu einem, der dies innerhalb von 2 Sekunden erfährt, stark im Nachteil.
Historische Daten sind Ereignisse, die bereits stattgefunden haben. Ein Nutzer möchte seinen vollständigen Transaktionsverlauf des letzten Jahres einsehen. Eine Analyseplattform muss das seit dem Start auf einer DEX gehandelte Gesamtvolumen berechnen. Ein Compliance- equipe m muss die Geldströme über einen Zeitraum von sechs Monaten nachverfolgen. Der Zugriff auf historische Daten ist durchsatzabhängig. Die Herausforderung besteht nicht darin, wie schnell man einen einzelnen Datensatz abruft, sondern wie effizient man Millionen oder Milliarden von Datensätzen, die sich über Tausende oder Millionen von Blöcken erstrecken, abrufen, verarbeiten und speichern kann.
Verschiedene Zugriffsmuster
Die Zugriffsmuster für Echtzeit- und historische Daten unterscheiden sich grundlegend, weshalb sie in der Regel unterschiedliche Infrastrukturkonzepte erfordern.
Der Echtzeit-Datenzugriff erfolgt nach einem Abonnementmodell. Ihre Anwendung sagt: „Benachrichtige mich, sobald ein neuer Block erzeugt wird“ oder „Teile mir mit, sobald dieser Vertrag ein Transfer-Ereignis auslöst.“ Die Daten treffen als kontinuierlicher Strom ein, Block für Block, in der Reihenfolge, in der die Blockchain sie erzeugt. Ihre Anwendung verarbeitet jeden Block sofort nach seinem Eintreffen und aktualisiert ihren Status entsprechend. Die wichtigsten Anforderungen sind geringe Latenz (minimale Verzögerung zwischen Blockerzeugung und -übermittlung), Zuverlässigkeit (kein Block darf übersehen werden) und Reihenfolge (Blöcke treffen in der richtigen Reihenfolge ohne Lücken ein).
Der Zugriff auf historische Daten erfolgt im Batch-Verfahren. Ihre Anwendung fordert beispielsweise an: „Gib mir alle Blöcke von Nummer 10.000.000 bis 20.000.000“ oder „Rufe alle ERC-20-Übertragungsereignisse aus dem USDC-Vertrag seit dessen Bereitstellung ab.“ Die Daten treffen in großen Mengen ein – möglicherweise Millionen von Datensätzen – und Ihre Anwendung verarbeitet sie in großen Stapeln, bevor sie in eine Datenbank oder ein Data Warehouse geladen werden. Die wichtigsten Anforderungen sind Durchsatz (so viele Blöcke pro Sekunde wie möglich verarbeiten), Vollständigkeit (keine fehlenden Blöcke oder Lücken) und Kosteneffizienz (Minimierung des Rechenaufwands und der Bandbreite, die zum Abrufen von Terabytes an Daten erforderlich sind).
Diese unterschiedlichen Anforderungen erklären, warum ein einziger Ansatz selten beiden Bedürfnissen gleichermaßen gerecht wird. WebSocket-Abonnements eignen sich für Echtzeitdaten, können jedoch keine historischen Datenblöcke abrufen. Sequentielles RPC-Polling kann zwar technisch gesehen historische Daten abrufen, ist jedoch äußerst langsam und bei großem Umfang sehr kostspielig. Speziell entwickelte Datenpipelines, die sowohl Echtzeit-Streaming als auch das Nachfüllen historischer Daten über dieselbe Schnittstelle abwickeln, lösen dieses architektonische Missverhältnis.
Warum Anwendungen beides benötigen
Nahezu jede Blockchain-Anwendung im Produktivbetrieb benötigt sowohl Echtzeit- als auch historische Daten, oft gleichzeitig. Ein DeFi-Dashboard benötigt historische Daten, um Diagramme anzuzeigen, die den Kurs eines Tokens in den letzten 90 Tagen, die TVL-Entwicklung eines Pools im letzten Jahr und die vollständige Positionshistorie eines Nutzers darstellen. Gleichzeitig benötigt es Echtzeitdaten, um den aktuellen Kurs zu aktualisieren, laufende Trades in Echtzeit anzuzeigen und den Nutzer zu warnen, wenn sich seine Position einer Liquidationsschwelle nähert. Wenn das Dashboard nur über Echtzeitdaten verfügen würde, würde es bei jedem Laden mit einem leeren Bildschirm starten. Wenn es nur über historische Daten verfügen würde, wären die Zahlen immer veraltet.
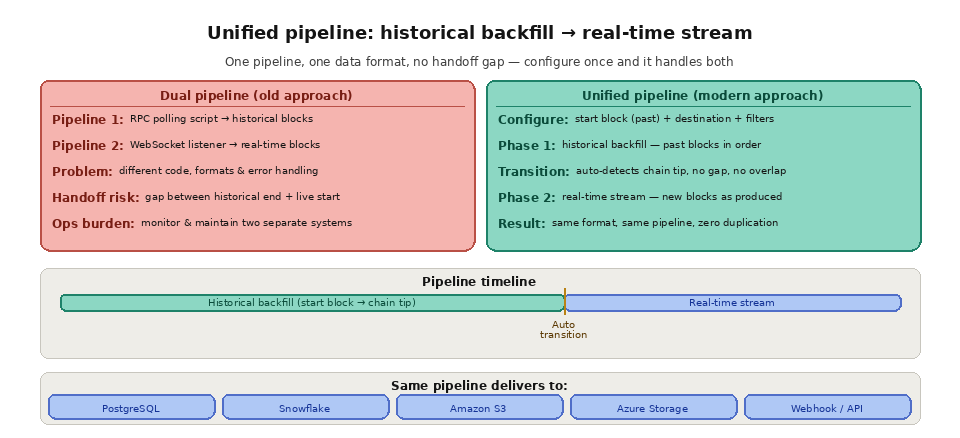
Ein Blockchain-Indexer benötigt historische Daten, um seine anfängliche Datenbank aufzubauen, indem er jeden Block vom Genesis-Block (oder vom Deployment-Block des Kontrakts) bis zur Gegenwart verarbeitet. Sobald die Nachvervollständigung abgeschlossen ist, benötigt er Echtzeitdaten, um die Datenbank auf dem neuesten Stand zu halten, indem er jeden neuen Block verarbeitet, sobald dieser erzeugt wird. Der Übergang von der historischen Nachvervollständigung zum Echtzeit-Streaming muss nahtlos erfolgen, ohne Lücke zwischen dem zuletzt verarbeiteten historischen Block und dem ersten empfangenen Echtzeit-Block. Jede Lücke bedeutet fehlende Daten. Jede Überschneidung bedeutet doppelte Daten.
Ein NFT-Marktplatz benötigt historische Daten, um die Besitzgeschichte, frühere Verkaufspreise und die Herkunft jedes Tokens anzuzeigen. Er benötigt Echtzeitdaten, um neue Angebote unmittelbar nach ihrer Erstellung anzuzeigen, Preise zu aktualisieren, sobald Gebote in Auktionen eingehen, und Übertragungen zu bestätigen, sobald Verkäufe abgeschlossen sind. Händler stützen sich bei der Bewertung auf historische Daten und bei der Ausführung auf Echtzeitdaten.
Ein System zur Überwachung der Compliance benötigt historische Daten, um rückwirkende Untersuchungen durchzuführen, wenn verdächtige Aktivitäten gemeldet werden. Es benötigt Echtzeitdaten, um verdächtige Muster sofort zu erkennen und Warnmeldungen innerhalb von Minuten statt Tagen zu generieren. Das System muss in der Lage sein, zwischen den Modi zu wechseln, neue Aktivitäten in Echtzeit zu übertragen und gleichzeitig monatelange historische Aufzeichnungen abzufragen, um den Kontext zu ermitteln.
Die Architektur-Herausforderung
Der traditionelle Ansatz für den Umgang mit beiden Datentypen besteht darin, zwei separate Systeme aufzubauen: eine Pipeline für historische Daten (in der Regel ein Skript, das Blöcke über RPC durchläuft) und einen Echtzeit-Listener (in der Regel ein WebSocket-Abonnement oder eine Polling-Schleife). Diese Architektur mit zwei Pipelines bringt mehrere Probleme mit sich. Die beiden Systeme verwenden unterschiedlichen Code, unterschiedliche Fehlerbehandlung, unterschiedliche Datenformate und unterschiedliche Übertragungsmechanismen. Sie während des Übergangs von historischen zu Echtzeitdaten synchron zu halten, ist fehleranfällig. Die Wartung und Überwachung zweier separater Pipelines verdoppelt den Betriebsaufwand.
Eine einheitliche Datenpipeline, die sowohl historische als auch Echtzeitdaten über eine einzige Schnittstelle verarbeitet, beseitigt diese Probleme. Sie konfigurieren eine Pipeline mit einem Startblock (in der Vergangenheit für historische Daten oder „aktuellste“ für reine Echtzeitdaten), und das System liefert Daten ab diesem Startpunkt weiter, wobei es nahtlos vom Nachholen historischer Daten zum Echtzeit-Streaming übergeht, sobald es den aktuellen Stand der Datenkette erreicht hat. Gleiches Datenformat, gleicher Übermittlungsmechanismus, gleiche Fehlerbehandlung, gleiche Überwachung. Für die Pipeline spielt es keine Rolle, ob der gerade verarbeitete Block vor drei Jahren oder vor drei Sekunden erzeugt wurde.
Was ist der Unterschied zwischen Echtzeit- und historischen Blockchain-Daten?
Bei den Daten handelt es sich um dieselben Blöcke und Transaktionen; der Unterschied liegt darin, wann man sie benötigt und wie man sie abruft. Echtzeitdaten werden über ein Abonnement an der Spitze der Blockchain gelesen und sind daher auf geringe Latenz optimiert. Historische Daten werden in großen Mengen aus früheren Blöcken gelesen und sind daher auf Durchsatz und Kosten optimiert. Aus diesem Grund bedeutet eine effiziente Abfrage von Blockchain-Daten in der Regel, dass für jede Aufgabe ein anderes Tool gewählt werden muss. Die folgende Tabelle fasst die Unterschiede zusammen.
Dimension
Echtzeitdaten
Historische Daten
Definition
Die Blockchain-Spitze und die derzeit stattfindenden Transaktionen
Alles von den Anfängen bis zur jüngsten Vergangenheit
Zugriffsmuster
Abonnement, Block für Block
Stapelverarbeitung, viele Blöcke auf einmal
Empfindlich gegenüber
Latenz
Durchsatz und Kosten
Typisches Werkzeug
Streams oder WebSocket-Abonnements
Nachläufe, Archivknoten, Indizierer
Befugnisse
Live-Dashboards, Benachrichtigungen, Überwachung
Analysen, Audits, Modelltraining
Frische
Erst seit wenigen Sekunden
Einige Minuten bis zu mehreren Jahren alt
Wie greift man auf historische Blockchain-Daten zu?
Es gibt drei gängige Methoden, um historische Daten abzurufen. Sie können einen Archivknoten abfragen, der den vollständigen Zustand zu jeder Blockhöhe speichert und punktuelle Abfragen für jeden beliebigen Zeitpunkt in der Vergangenheit beantwortet. Sie können einen Backfill durchführen, der einen Blockbereich durchläuft und die Ergebnisse gebündelt exportiert. Oder Sie können einen Indexer verwenden, der die Daten bereits verarbeitet und in einer abfragbaren Datenbank gespeichert hat. Jede dieser Methoden weist unterschiedliche Kompromisse hinsichtlich Einrichtungsaufwand, Geschwindigkeit und Kosten auf, und die richtige Wahl hängt davon ab, wie viel historische Daten Sie benötigen und wie oft Sie darauf zugreifen. Einen tieferen Einblick in die Optionen und ihre Vor- und Nachteile finden Sie unter „Zugriff auf historische Blockchain-Daten“.
Welche Anwendungen benötigen Echtzeitdaten und welche historische Daten?
Die meisten Produktionsanwendungen benötigen beides, doch das Verhältnis verschiebt sich je nach Anwendungsfall. Latenzempfindliche Funktionen sind eher auf Echtzeit ausgerichtet, während Analyse- und Audit-Funktionen eher auf historische Daten ausgerichtet sind. Die folgende Tabelle ordnet gängige Workloads ihrem primären Datenbedarf zu, und weitere Muster finden Sie in diesen Anwendungsfällen für Blockchain-Streaming.
Anwendungsfall
Bedarf an Primärdaten
Warum
Handelsbot
Echtzeit
Reagiert innerhalb von Sekunden auf Preisänderungen
Steuer- oder Prüfungsbericht
Historisch
Stellt einen vollständigen Aktivitätsverlauf wieder her
Blockchain-Indexer
Beides
Verlauf der Verfüllungen, anschließend „ streams “ für neue Blöcke
Meldungen zur Liquidation
Echtzeit
Muss vor der Glattstellung einer Position ausgelöst werden
DEX-Volumenanalyse
Historisch
Fasst Millionen vergangener Handelsgeschäfte zusammen
Herkunft von NFTs
Beides
Zeigt die Besitzgeschichte sowie aktuelle Angebote an
Wie lässt sich Echtzeitdaten und historische Daten in einer Pipeline zusammenführen?
Die übersichtlichste Architektur sieht eine einzige Pipeline vor, die in der Vergangenheit beginnt, die Daten der Reihe nach verarbeitet und dann automatisch in den Live-Betrieb übergeht, sobald sie das Ende der Kette erreicht hat. Dadurch entfällt die anfällige Übergabe zwischen einem Backfill-Skript und einem separaten Live-Listener. Wenn Sie abwägen, wie die Daten ankommen sollen, bestimmt die Wahl zwischen Polling und Streaming maßgeblich, wie aufwendig es ist, diese Übergabe selbst zu implementieren – und ein Managed Service wie Quicknode Streams übernimmt die Reihenfolge, Lücken und Reorganisationen für Sie.
Häufig gestellte Fragen
Sind Echtzeitdaten wertvoller als historische Daten?
Keines der beiden ist grundsätzlich wertvoller; sie erfüllen unterschiedliche Aufgaben. Echtzeitdaten sind die Grundlage für Funktionen, bei denen Aktualität entscheidend ist, wie beispielsweise Warnmeldungen und die Ausführung von Handelsgeschäften, während historische Daten für Analysen, Prüfungen und alle Auswertungen herangezogen werden, die einen Kontext aus der Vergangenheit erfordern. Die meisten anspruchsvollen Anwendungen sind auf beides gleichzeitig angewiesen.
Wie weit zurück kann ich historische Blockchain-Daten abfragen?
Mit der richtigen Infrastruktur können Sie bis zum Genesis-Block zurückverfolgen. Für den vollständigen Zustand zu beliebigen historischen Zeitpunkten ist ein Archivknoten erforderlich und kein beschnittener Vollknoten. Deshalb ist die Unterscheidung zwischen einem Vollknoten und einem Archivknoten wichtig, wenn Sie den Zugriff auf historische Daten planen.
Kann eine Pipeline sowohl Echtzeit- als auch historische Daten bereitstellen?
Ja. Eine einheitliche Streaming-Pipeline kann bei einem früheren Block beginnen, die Daten lückenlos nach vorne ergänzen und dann nahtlos in die Live-Daten übergehen, ohne dass Lücken entstehen oder ein zweites System erforderlich ist. Das ist der Kerngedanke hinter dem Blockchain-Daten-Streaming, das geordnete Daten liefert, unabhängig davon, ob der Block alt oder brandneu ist.
Wie lassen sich historische Daten am schnellsten nachträglich einpflegen?
Sequentielle RPC-Skripte sind zwar einfach, aber langsam und bei großem Umfang ressourcenintensiv. Speziell entwickelte Backfill-Tools, die Blockbereiche in großen Mengen in eine Datenbank oder ein Data Warehouse exportieren, sind in der Regel wesentlich schneller und kostengünstiger, da sie auf Durchsatz optimiert sind und nicht auf die Bearbeitung einzelner Anfragen.
Benötige ich einen Indexer für historische Abfragen?
Nicht immer. Für gelegentliche Abfragen reicht ein Archivknoten oder ein Backfill aus. Wenn Sie jedoch häufig komplexe Abfragen über große Bereiche ausführen, werden die Daten bei der Blockchain-Indizierung vorab zu einem abfragbaren Speicher verarbeitet, sodass jede Abfrage schnell ausgeführt wird und nicht aus den Rohblöcken neu berechnet werden muss.
Wie „ Quicknode “ beides unter einen Hut bringt
Quicknode Streams bietet eine einheitliche Pipeline sowohl für Echtzeit- als auch für historische Blockchain-Daten. Ein einzelner Stream kann so konfiguriert werden, dass er bei einem beliebigen historischen Block beginnt und vorwärts verarbeitet wird, wobei die Daten in der Reihenfolge ihrer endgültigen Bestätigung an Ihr Ziel (PostgreSQL, Snowflake, Amazon S3, Azure Storage, webhooks und weitere) übermittelt werden. Sobald der Stream das Ende der Blockchain erreicht, wechselt er automatisch in den Echtzeit- mode -Modus und liefert neue Blöcke fortlaufend, sobald diese erzeugt werden. Es gibt keine Lücken, keine Übergabelogik und keine zweite Pipeline, die gewartet werden muss.
Für Echtzeit-Punktabfragen bietet die Core-API von Quicknode einen global verteilten RPC-Zugriff mit Archivunterstützung in allen Tarifen. Das bedeutet, dass Ihre Anwendung den aktuellen Zustand der Blockchain oder jeden beliebigen historischen Zustand bei jeder Blockhöhe über einen einzigen Aufruf von endpoint abfragen kann. Erweiterte API-Methoden fassen gängige mehrstufige Abfragen zu einzelnen Aufrufen zusammen und reduzieren so die Latenz bei Echtzeit-Lesevorgängen. Speziell für historische Backfills bietet Quicknode Ein-Klick-Backfill-Vorlagen mit vorkonfigurierten Datensätzen für über 20 Blockchains, transparente Kosten- und Zeitschätzungen sowie Liefergeschwindigkeiten, die bis zu siebenmal schneller sind als bei RPC-basierten Skripten.