Antworten>Erfahren Sie mehr über die Indizierung und Blockchain-Daten>Warum die Abfrage von Blockchain-Daten schwierig ist
Warum die Abfrage von Blockchain-Daten schwierig ist
// Tags
Herausforderungen im Zusammenhang mit Blockchain-Daten
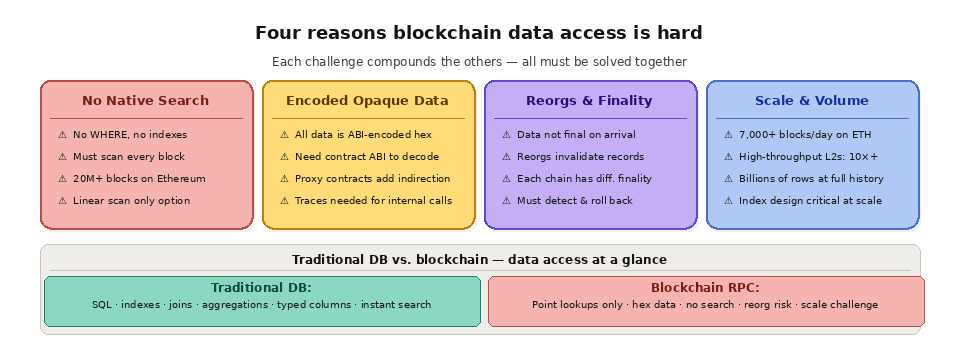
TL;DR: Blockchains sind auf Sicherheit und Unveränderlichkeit optimiert, nicht auf den Datenabruf. Es gibt keine integrierten Suchfunktionen, keine SQL-Abfragen, keine Indizes und keine Möglichkeit, Daten blockübergreifend mithilfe von Standard-RPC-Methoden zu filtern oder zu aggregieren. Selbst einfache Abfragen wie „Zeige alle Transaktionen aus dieser Wallet an“ erfordern das sequenzielle Durchsuchen von Millionen von Blöcken. Rechnet man dazu noch Kettenreorganisationen, unterschiedliche Finalitätsmodelle, verschlüsselte Datenformate und riesige Datenmengen hinzu, wird deutlich, warum der Zugriff auf Blockchain-Daten eine erhebliche technische Herausforderung darstellt.
Die einfache Erklärung
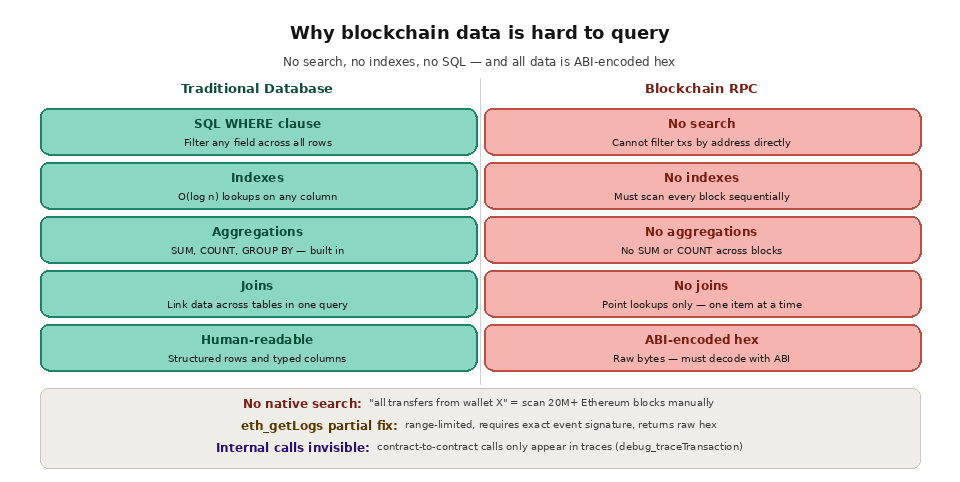
Wenn Sie schon einmal mit einer herkömmlichen Datenbank gearbeitet haben, wissen Sie, wie einfach es ist, Abfragen zu Ihren Daten durchzuführen. Eine einzige SQL-Abfrage kann alle Bestellungen der letzten 30 Tage zurückgeben – gruppiert nach Kunden, sortiert nach Gesamtwert und gefiltert, sodass nur Beträge über 100 Dollar berücksichtigt werden. Die Datenbank-Engine übernimmt die Hauptarbeit, da relationale Datenbanken von Grund auf für flexible und effiziente Abfragen konzipiert sind. Sie verwalten Indizes, unterstützen Verknüpfungen, ermöglichen Aggregationen und optimieren die Ausführungspläne für Abfragen automatisch.
Blockchains sind für genau den gegenteiligen Zweck konzipiert. Ihre Hauptaufgabe besteht darin, Transaktionen in einem manipulationssicheren, dezentralen Hauptbuch zu erfassen, das von Tausenden unabhängiger Knoten überprüft und bestätigt werden kann. Bei jeder Designentscheidung in der Architektur einer Blockchain stehen Konsens, Sicherheit und Unveränderlichkeit im Vordergrund. Der Datenabruf ist bestenfalls ein nachträglicher Einfall. Das Ergebnis ist eine Datenstruktur, die für ihren vorgesehenen Zweck unglaublich leistungsfähig ist, bei der Abfrage von Daten, die über einfache Punktabfragen hinausgehen, jedoch frustrierend ist.
Keine integrierte Such- oder Filterfunktion
Die grundlegendste Herausforderung besteht darin, dass Blockchains keine Suchfunktion bieten. Es gibt keinen „Find“-Befehl. Es gibt kein Äquivalent zur WHERE-Klausel in SQL. Die RPC-Schnittstelle stellt eine Handvoll Low-Level-Methoden bereit: Abrufen eines Blocks anhand seiner Nummer, Abrufen einer Transaktion anhand ihres Hash-Werts, Abrufen des Kontostands eines Kontos bei einem bestimmten Block. Dabei handelt es sich ausschließlich um punktuelle Abfragen, bei denen man bereits genau wissen muss, wonach man sucht.
Wenn Sie alle Transaktionen einer bestimmten Wallet-Adresse finden möchten, können Sie diese Frage nicht direkt an die Blockchain richten. Sie müssen beim Genesis-Block beginnen, jeden Block der Reihe nach abrufen, jede Transaktion aus jedem Block extrahieren, die Felder „Von“ und „An“ jeder Transaktion überprüfen und die Übereinstimmungen sammeln. Auf Ethereum bedeutet dies, über 20 Millionen Blöcke durchzugehen, von denen jeder zwischen null und mehreren hundert Transaktionen enthält. Auf Solana sind die Zahlen sogar noch atemberaubender: Die Historie der Blockchain umfasst Milliarden von Slots und Transaktionen. Ohne einen vorgefertigten Index ist dieser lineare Scan die einzige Möglichkeit, die Frage zu beantworten.
Die Methode „eth_getLogs“ bietet eine Teillösung, da sie es Ihnen ermöglicht, Ereignisprotokolle innerhalb eines Blockbereichs abzufragen, der nach Vertragsadresse und Thema gefiltert ist. Allerdings gelten strenge Beschränkungen für den Blockbereich (in der Regel einige Tausend Blöcke pro Anfrage), Sie müssen die genaue Ereignissignatur kennen, nach der Sie suchen, und es werden rohe, ABI-kodierte Daten zurückgegeben, die Ihre Anwendung dekodieren muss. Um ein vollständiges Bild der Aktivitäten über mehrere Verträge, Ereignistypen und lange Zeiträume hinweg zu erhalten, sind Hunderte oder Tausende von paginierten Protokollabfragen erforderlich, die in Ihrem Anwendungscode miteinander verknüpft werden müssen.
Kodierte und undurchsichtige Datenformate
Blockchain-Daten sind standardmäßig nicht für Menschen lesbar. Transaktions-Eingabedaten, Parameter des Ereignisprotokolls und Werte im Vertragsspeicher werden ABI-kodiert in hexadezimale Byte-Zeichenketten umgewandelt. Um eine Transaktion zu verstehen, benötigt Ihre Anwendung die ABI des Vertrags, um den Funktionsaufruf und dessen Parameter zu dekodieren. Um ein Ereignisprotokoll zu interpretieren, benötigen Sie die ABI, um Themen-Hashes wieder den Ereignisnamen zuzuordnen und die Datenfelder in typisierte Werte zu dekodieren.
Erschwerend kommt hinzu, dass nicht jeder Vertrag seine ABI veröffentlicht. Nicht verifizierte Verträge in Block-Explorern liefern keine Informationen zur Dekodierung, sodass ihre Transaktionen und Ereignisse für externe Beobachter undurchsichtig bleiben. Selbst bei einer verifizierten ABI erfordern Proxy-Verträge (die Aufrufe an Implementierungsverträge delegieren), dass Ihre Anwendung die Proxy-Beziehung auflöst, bevor sie die zugrunde liegenden Funktionsaufrufe dekodieren kann. Diese Ebenen der Indirektion machen die automatisierte, breit angelegte Verarbeitung von Blockchain-Daten deutlich komplexer als die Arbeit mit einer gut dokumentierten REST-API.
Interne Transaktionen sorgen für zusätzliche Undurchsichtigkeit. Wenn ein Smart Contract einen anderen aufruft, erscheint dieser interne Aufruf nicht in der Transaktionsliste des Blocks. Er taucht lediglich in Ausführungsablaufverfolgungen auf (abgerufen über die Methoden `debug_traceTransaction` oder `trace_block`), deren Erstellung rechenintensiv ist und die nicht auf allen Knotentypen verfügbar sind. Ein einfacher Token-Tausch auf einer DEX kann ein Dutzend interner Vertragsaufrufe umfassen, bei denen jeweils Token übertragen, der Status aktualisiert und Ereignisse ausgelöst werden. Um ein vollständiges Bild der Abläufe zu erhalten, sind Trace-Daten erforderlich, was das Datenvolumen und die Komplexität der Verarbeitung drastisch erhöht.
Kettenreorganisationen und Finalität
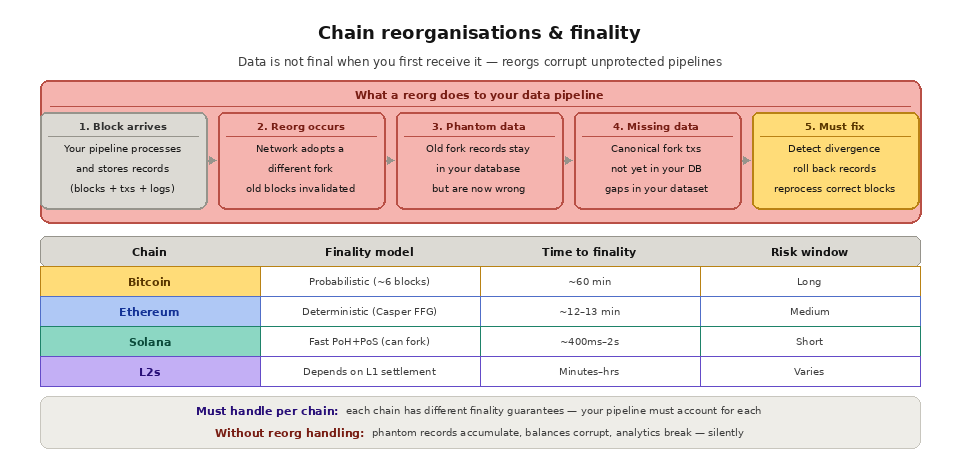
Blockchain-Daten sind nicht immer endgültig, wenn Sie sie zum ersten Mal erhalten. Zu einer Reorganisation der Blockchain (Reorg) kommt es, wenn das Netzwerk vorübergehend einem Zweig der Blockchain folgt und dann zu einem anderen Zweig wechselt, der zum kanonischen Zweig wird. Wenn eine Reorg stattfindet, werden Blöcke, die Ihre Anwendung bereits verarbeitet hat, ungültig. Transaktionen, die als bestätigt erschienen, existieren möglicherweise nicht mehr in der kanonischen Blockchain oder tauchen in einem anderen Block an einer anderen Position auf.
Für Datenpipelines und Indexer sind Reorganisationen ein Albtraum. Alle Datensätze, die aus reorganisierten Blöcken stammen, müssen erkannt, rückgängig gemacht und durch Daten aus den korrekten Blöcken ersetzt werden. Wenn Ihr System Reorganisationen nicht verarbeitet, sammeln sich in Ihrer Datenbank Phantomdatensätze (Daten aus verworfenen Verzweigungen) an und es gehen legitime Datensätze (Daten aus der kanonischen Verzweigung) verloren, was zu falschen Salden, doppelten Übertragungen und fehlerhaften Analysen führt.
Verschiedene Blockchains weisen unterschiedliche Finalitätsmerkmale auf, was das Problem noch verschärft. Bitcoin Transaktionen gelten nach etwa sechs Bestätigungen (ca. 60 Minuten) als probabilistisch endgültig. Ethereum erreicht Finalität nach zwei Epochen (etwa 12–13 Minuten). L2-Blockchains wie Arbitrum und Base verfügen über eigene Finalitätsmechanismen, die davon abhängen, wann Daten an Ethereum L1 übermittelt werden. Solana erreicht eine schnelle Finalität, kann jedoch dennoch von Slot-Skipping und Fork-Auflösung betroffen sein. Ihre Datenpipeline muss das spezifische Finalitätsmodell jeder Kette berücksichtigen, die sie verarbeitet.
Skalierbarkeit und Leistung
Das schiere Volumen der Blockchain-Daten ist überwältigend und wächst rasant. Ethereum erzeugt täglich etwa 7.000 Blöcke, von denen jeder Hunderte von Transaktionen und Tausende von Ereignisprotokollen enthält. Hochdurchsatz-Blockchains wie Solana, Base und Arbitrum erzeugen um Größenordnungen mehr Daten. Die Erfassung, Dekodierung und Speicherung all dieser Daten in Echtzeit bei gleichzeitiger Pflege eines vollständigen historischen Indexes erfordert erhebliche Rechen- und Speicherressourcen.
Die Leistung verschlechtert sich bei steigendem Umfang auf subtile Weise. Datenbanktabellen mit Milliarden von Zeilen erfordern eine sorgfältige Indexgestaltung, Partitionierungsstrategien und Abfrageoptimierung, um akzeptable Antwortzeiten aufrechtzuerhalten. Gleichzeitige Schreibvorgänge aus der Echtzeit-Datenerfassung konkurrieren mit Lesevorgängen aus benutzerseitigen Abfragen. Die Speicherkosten steigen exponentiell, wenn Sie weitere Ketten, weitere Datensätze (Traces, Protokolle, Zustandsdifferenzen) und eine größere historische Tiefe hinzufügen. Was als überschaubare Datenpipeline mit 100 Blöcken pro Tag beginnt, wird bei 100.000 Blöcken pro Tag über 10 Blockchains hinweg zu einer infrastrukturellen Herausforderung.
Was sind die wichtigsten Methoden zur Abfrage von Blockchain-Daten?
Es gibt kein einheitliches Tool zum Auslesen von Blockchain-Daten. Die Teams wählen aus verschiedenen Ansätzen aus, je nachdem, ob sie eine schnelle Punktabfrage, einen Echtzeit-Feed oder umfassende historische Analysen benötigen. Die folgende Tabelle fasst die gängigen Methoden zusammen.
Vorgehensweise
So funktioniert es
Am besten geeignet für
Direkte RPC-Aufrufe
Einen Block, eine Transaktion oder einen Kontostand anhand eines Schlüssels abrufen
Punktsuche und Live-Status
Ereignisprotokolle (eth_getLogs)
Protokolle nach Adresse und Thema in einem Blockbereich filtern
Verfolgung bestimmter Vertragsereignisse
Indexierer
On-Chain-Daten dekodieren und in einer abfragbaren Datenbank speichern
Suche, Verknüpfungen und Aggregation
Streaming-Pipelines
Übertragen Sie neue und historische Daten in Ihren eigenen Shop
Kontinuierliche Datenerfassung in großem Maßstab
SQL- und Analyseplattformen
Abfragen in vorindizierten Tabellen mit Standard-SQL
Dashboards und Ad-hoc-Analysen
Die meisten Produktions- stacks en kombinieren mehrere dieser Ansätze. Sie nutzen RPC-Anfragen für Live-Lesevorgänge und eine separate Indizierungs- oder Streaming-Schicht für alles, was Such- und Verlaufsfunktionen erfordert. Um die unterste Schicht besser zu verstehen, sehen Sie sich an, was ein RPC- endpoint tatsächlich tut.
Warum kann man SQL nicht direkt auf einer Blockchain verwenden?
Eine Blockchain speichert Daten als eine Abfolge kryptografisch miteinander verknüpfter Blöcke und nicht als indizierte Tabellen. Daher gibt es keinen Abfrageplaner, keine WHERE-Klausel und keine Möglichkeit, in einem einzigen Aufruf „alle Swaps über 1.000 Dollar der letzten Woche“ abzufragen. Um diesen Grad an Zugriff zu erreichen, müssen zunächst die Rohdaten extrahiert und dekodiert und anschließend in ein System geladen werden, das strukturierte Abfragen unterstützt. Genau diese Schritte – Extrahieren, Dekodieren und Laden – werden bei der Blockchain-Indizierung durchgeführt.
Sollten Sie für die Abfrage von Daten einen RPC-Knoten oder einen Indexer verwenden?
RPC-Knoten und Indexer lösen unterschiedliche Probleme. Ein RPC-Knoten eignet sich ideal für direkte Abfragen und das Senden von Transaktionen, während ein Indexer für Such-, Filter- und Aggregationsaufgaben ausgelegt ist, die reine Knoten nicht bewältigen können. Der folgende Vergleich zeigt, wo die jeweiligen Komponenten zum Einsatz kommen.
Faktor
RPC-Knoten
Indexierer
Abfragestil
Punktsuche nach Schlüssel
Flexible Such- und Filterfunktionen
Aggregation
Wird nicht unterstützt
Eingebaut
Historische Tiefe
Es wird ein Archivknoten benötigt
Einmal gespeichert, schnell abgerufen
Aufwands für die Einrichtung
Low, ruf einen endpoint
Höher, eine Pipeline bauen oder kaufen
Optimale Verwendung
Live-Status und Transaktionen
Analysen und komplexe Abfragen
Eine detailliertere Aufschlüsselung, wann die jeweilige Methode vorteilhaft ist, finden Sie unter „RPC vs. Indexierung“.
Wie kann man historische Blockchain-Daten abfragen?
Der aktuelle Status kann von jedem Full Node ausgelesen werden, während für ältere Zustände und den vollständigen Transaktionsverlauf in der Regel ein Archiv-Node oder eine Backfill-Pipeline erforderlich sind. Die Unterscheidung zwischen aktuellen und historischen Daten prägt Ihre gesamte Architektur, was in den Abschnitten „Echtzeit- vs. historische Blockchain-Daten“ und „Full Node vs. Archiv-Node“ behandelt wird. Für einmalige detaillierte Abfragen eignet sich eine Archiv- endpoint ; für wiederholte Analysen ist es weitaus effizienter, den Verlauf einmalig zu indizieren.
Häufig gestellte Fragen
Kann man eine Blockchain wie eine normale Datenbank abfragen?
Nicht direkt. Standard-RPC-Methoden unterstützen nur Punktabfragen anhand der Blocknummer, des Transaktions-Hashs oder der Adresse. Um Abfragen im Stil einer Datenbank mit Filterung und Aggregation durchzuführen, müssen Sie die Daten zunächst in einem System indizieren, das diese Funktionen unterstützt.
Wie lassen sich alle Transaktionen einer Wallet am schnellsten abrufen?
Verwenden Sie einen Indexer oder eine vorgefertigte Daten-API. Das Block-für-Block-Durchsuchen der Blockchain mit rohem RPC ist hierfür zu langsam, während ein indizierter Datensatz den vollständigen Verlauf einer Wallet mit einer einzigen Abfrage zurückgeben kann.
Warum benötigen dekodierte Blockchain-Daten eine ABI?
Transaktions-Inputs und Ereignisprotokolle werden als ABI-kodierte Hexadezimalwerte gespeichert. Die Vertrags-ABI ist das Schema, das diese Bytes wieder Funktionsnamen, Ereignisnamen und typisierten Werten zuordnet; ohne sie bleiben die Daten daher undurchsichtig.
Wie wirken sich Reorgs auf Blockchain-Abfragen aus?
Eine Reorganisation kann bereits gelesene Daten ungültig machen, sodass Abfrageergebnisse near am Ende der Blockchain nicht endgültig sind. Robuste Pipelines warten auf die Endgültigkeit oder senden Korrektur-Updates, wenn sich die kanonische Blockchain ändert.
Müssen Sie einen eigenen Knoten betreiben, um Blockchain-Daten abzufragen?
Nein. Mit verwalteten RPC-Anbietern, Streaming-Diensten und Analyseplattformen können Sie Blockchain-Daten lesen und abfragen, ohne selbst Knoten oder Indexer betreiben zu müssen.
Wie „ Quicknode “ den Zugriff auf Blockchain-Daten vereinfacht
QuicknodeDie Produktpalette des Unternehmens ist darauf ausgelegt, jede dieser Herausforderungen direkt anzugehen. Die Core-API bietet schnellen, zuverlässigen RPC-Zugriff für Punktabfragen und die Übermittlung von Transaktionen, mit erweiterten API-Methoden, die gängige mehrstufige Abfragen in einzelne Aufrufe zusammenfassen. Der Zugriff auf das Archiv ist in allen Tarifen enthalten, sodass Abfragen zum historischen Status ohne separate Infrastruktur oder zusätzliche Kosten funktionieren.
Quicknode Streams beseitigt die Herausforderungen bei der Datenerfassung vollständig. Anstatt benutzerdefinierte Skripte zu erstellen und zu warten, die RPC-Endpunkte abfragen, die Paginierung verwalten, Wiederholungsversuche steuern und Reorganisationen erkennen, konfigurieren Sie einen Stream, der genau die Blockchain-Daten, die Sie benötigen, an Ihre Datenbank oder Ihr Data Warehouse überträgt. „ Streams “ liefert Daten in der Reihenfolge ihrer Endgültigkeit mit „Exactly-Once“-Garantien, verarbeitet Kettenreorganisationen automatisch durch das Senden von Korrekturdaten und unterstützt sowohl Echtzeit-Streaming als auch das Nachladen historischer Daten über dieselbe Pipeline. JavaScript-basierte Filter laufen auf der Infrastruktur von „ Quicknode “, um Daten vor der Übermittlung zu dekodieren, zu transformieren und aufzubereiten, sodass Ihr Zielsystem saubere, strukturierte Datensätze erhält, die sofort für Abfragen bereit sind.
Für Teams, die indexierte Blockchain-Daten benötigen, ohne selbst eine Pipeline aufbauen zu müssen, bietet der Marketplace von Quicknode Partnerintegrationen mit Indexierungsprotokollen und Datendiensten, die vorgefertigte, abfragbare Datensätze für gängige Anwendungsfälle bereitstellen.