TL;DR: Bei der Blockchain-Indizierung werden Rohdaten aus einer Blockchain extrahiert, in ein strukturiertes Format umgewandelt und in einer Datenbank gespeichert, die für schnelle Abfragen optimiert ist. Blockchains sind auf Sicherheit und Unveränderlichkeit ausgelegt, nicht auf die Suche. Ohne Indizierung erfordert die Beantwortung selbst einfacher Fragen wie „Zeige mir alle Transaktionen aus dieser Wallet“ das Durchsuchen jedes einzelnen Blocks seit dem Genesis-Block, was im großen Maßstab unpraktikabel ist. Indexer lösen dieses Problem, indem sie abfragbare Datenbanken erstellen, die On-Chain-Daten für Anwendungen in Echtzeit zugänglich machen.
Die einfache Erklärung
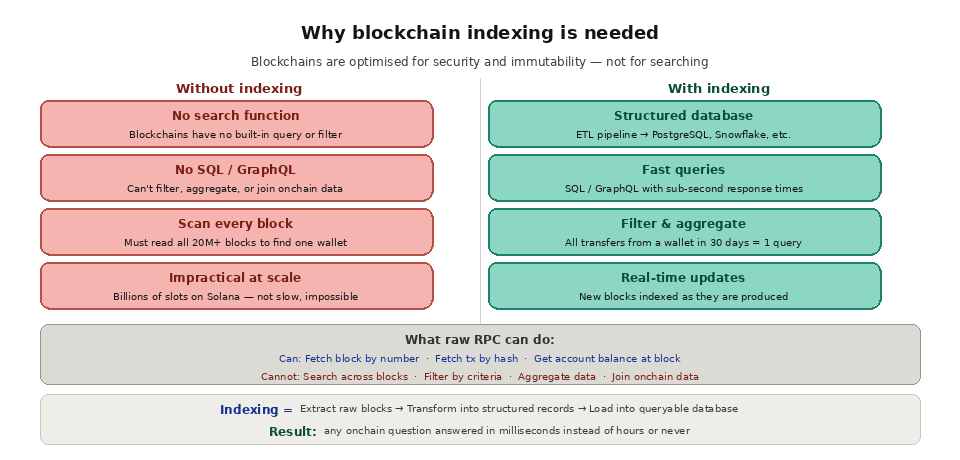
Blockchains sind Ledger, in die nur Daten hinzugefügt werden können. Sie eignen sich hervorragend dazu, Transaktionen in einer manipulationssicheren Reihenfolge aufzuzeichnen, sind jedoch völlig ungeeignet, um Fragen zu diesen Transaktionen zu beantworten. Es gibt keine integrierte „Suchfunktion“. Es gibt keine SQL-Abfragen. Es gibt keine Möglichkeit, allein mit Standard-RPC-Methoden zu sagen: „Finde alle ERC-20-Transfers der letzten 30 Tage, an denen diese Adresse beteiligt war.“
Die über RPC-Endpunkte verfügbaren grundlegenden Tools sind von ihrer Konzeption her sehr einfach gehalten. Sie können einen bestimmten Block anhand seiner Nummer abrufen. Sie können eine bestimmte Transaktion anhand ihres Hash-Werts abrufen. Sie können den Kontostand zu einem bestimmten Block abrufen. Sie können jedoch nicht blockübergreifend suchen, nach Kriterien filtern, Daten aggregieren oder Informationen aus verschiedenen Teilen der Blockchain zusammenführen. Um alle Transaktionen einer bestimmten Wallet zu finden, müssten Sie jeden jemals erzeugten Block abrufen, jede Transaktion aus jedem Block extrahieren, prüfen, ob der Absender oder Empfänger mit Ihrer Zieladresse übereinstimmt, und die Übereinstimmungen sammeln. Auf Ethereum bedeutet das, über 20 Millionen Blöcke zu durchsuchen. Auf Solana bedeutet es, Milliarden von Slots zu durchsuchen. Ohne Indizierung ist das nicht nur langsam. Es ist innerhalb eines vernünftigen Zeitrahmens unmöglich.
Die Blockchain-Indizierung löst dieses Problem durch einen Prozess, der kontinuierlich neue Blöcke von einem Knoten liest, die Rohdaten (Transaktionen, Ereignisprotokolle, Zustandsänderungen, Traces) dekodiert, in strukturierte Datensätze umwandelt und diese Datensätze in eine Datenbank mit entsprechenden Indizes schreibt. Sobald sich die Daten in einer Datenbank befinden, kann Ihre Anwendung sie mit vertrauten Tools wie SQL oder GraphQL abfragen – und das mit Antwortzeiten im Subsekundenbereich.
So funktioniert die Indizierung
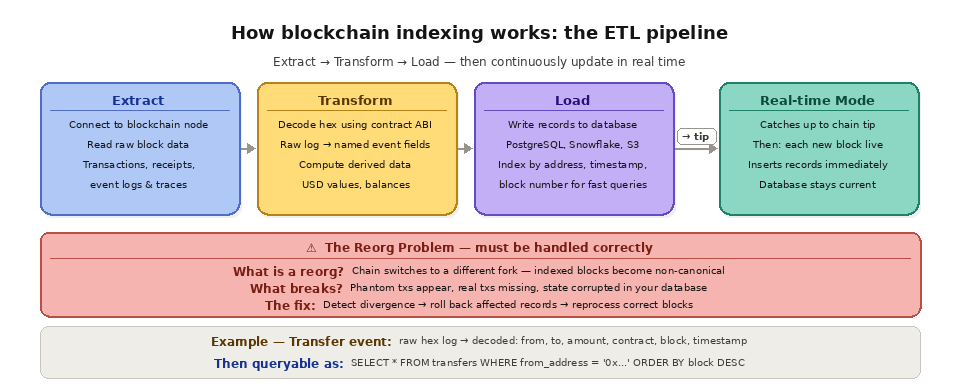
Die Indizierungspipeline folgt einem „Extract, Transform, Load“ (ETL)-Muster. In der Extraktionsphase stellt der Indizierer eine Verbindung zu einem Blockchain-Knoten her und liest die Rohdaten der Blöcke ein. Dazu gehören Block-Header, Transaktionen, Transaktionsbelege (die Ereignisprotokolle enthalten) und optional Trace-Daten (die interne Aufrufe zwischen Verträgen erfassen). Der Indizierer verarbeitet die Blöcke nacheinander, beginnend mit einem konfigurierten Startblock und fortlaufend durch die gesamte Historie der Blockchain.
In der Transformationsphase dekodiert der Indexer die Rohdaten in aussagekräftige Strukturen. Rohe Ereignisprotokolle sind beispielsweise als Hex-Zeichenfolgen mit Themen-Hashes und Datenfeldern kodiert. Der Indexer nutzt die ABI (Application Binary Interface) des Smart Contracts, um diese in für Menschen lesbare Ereignisse mit benannten Parametern und korrekten Datentypen zu dekodieren. Aus einem rohen Transfer-Ereignisprotokoll wird ein strukturierter Datensatz mit einer „Von“-Adresse, einer „An“-Adresse, einem Token-Betrag und einer Vertragsadresse. In der Transformationsphase können auch abgeleitete Daten berechnet werden, beispielsweise die Ermittlung von USD-Werten zum Zeitpunkt der Übertragung, die Aggregation des Volumens nach Token oder die Verfolgung der aktuellen Salden.
In der Einlese-Phase werden die strukturierten Datensätze in eine Datenbank geschrieben, sei es PostgreSQL, MongoDB, Snowflake, Elasticsearch oder ein anderes Speichersystem. Die Datenbank erstellt Indizes für die Felder, auf die Anwendungen abfragen (wie Wallet-Adressen, Token-Verträge, Zeitstempel und Blocknummern), was schnelle Suchvorgänge und komplexe Abfragen über den gesamten Datensatz hinweg ermöglicht.
Sobald der Indexer die Spitze der Blockchain eingeholt hat, wechselt er zum Echtzeit- mode, bei dem jeder neue Block sofort nach seiner Erstellung verarbeitet und die daraus resultierenden Datensätze umgehend eingefügt werden. Dadurch bleibt die Datenbank stets auf dem aktuellen Stand der Blockchain.
Das Problem der Umstrukturierung
Eine der größten Herausforderungen bei der Indizierung von Blockchains ist der Umgang mit Kettenreorganisationen. Eine Reorganisation tritt auf, wenn sich die kanonische Kette der Blockchain ändert – in der Regel, weil konkurrierende Blöcke auf derselben Höhe erzeugt wurden und sich das Netzwerk schließlich auf eine andere Verzweigung einigt als die, die Ihr Indexer ursprünglich verarbeitet hat. In diesem Fall sind die Blöcke, die Ihr Indexer bereits verarbeitet hat, nicht mehr kanonisch, und alle aus diesen Blöcken abgeleiteten Datensätze sind fehlerhaft.
Ein robuster Indexer muss Reorganisationsvorgänge erkennen, die betroffenen Datensätze zurücksetzen und die korrekten Blöcke erneut verarbeiten. Werden Reorganisationsvorgänge nicht korrekt behandelt, führt dies dazu, dass in Ihrer Datenbank Phantomtransaktionen auftreten (Transaktionen, die in der alten Verzweigung vorhanden waren, in der neuen jedoch nicht), Transaktionen fehlen (Transaktionen in der neuen Verzweigung, die in der alten Verzweigung nicht enthalten waren) und ein fehlerhafter Zustand entsteht. Für Finanzanwendungen ist diese Art von Datenkorruption inakzeptabel.
Die Verarbeitung von Reorgs erhöht die Komplexität der Indizierungspipeline erheblich. Der Indizierer muss nachverfolgen, welche Blöcke bereits verarbeitet wurden, die ihm vorliegende Kette mit den bereits gespeicherten Daten abgleichen, Abweichungen erkennen und Rollbacks sauber durchführen. Dies ist einer der Hauptgründe, warum Teams verwaltete Indizierungslösungen dem Aufbau eigener Indizierer von Grund auf vorziehen.
Ansätze zur Indizierung
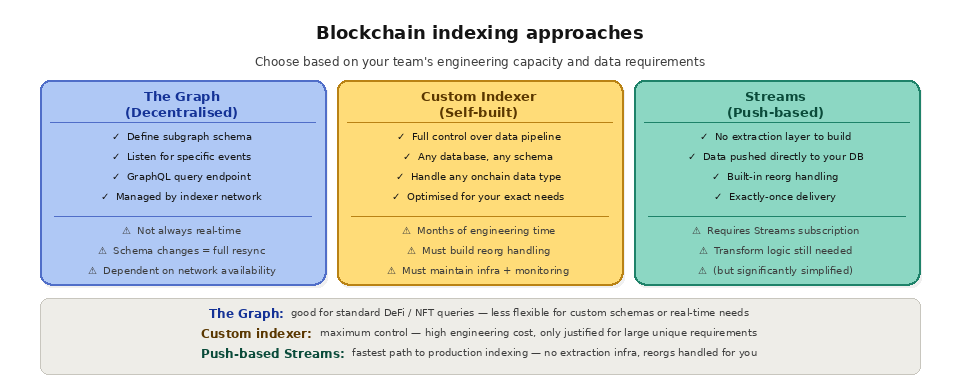
The Graph ist das am weitesten verbreitete dezentrale Indizierungsprotokoll. Entwickler erstellen „Subgraphs“ – Konfigurationsdateien, die festlegen, welche Smart Contracts überwacht werden sollen, auf welche Ereignisse abgehört werden soll und wie Ereignisdaten in ein abfragbares Schema abgebildet werden. Unabhängige Knotenbetreiber, sogenannte „Indexer“, betreiben die Verarbeitungsinfrastruktur und bedienen Abfragen über GraphQL-Endpunkte. The Graph eignet sich gut für Standardanwendungsfälle wie die Abfrage von DeFi-Protokolldaten, der NFT-Eigentumsgeschichte und der DAO-Governance-Aktivität. Zu seinen Einschränkungen zählen Latenz (Subgraph-Aktualisierungen erfolgen nicht immer in Echtzeit), mangelnde Flexibilität des Schemas (eine Änderung des Schemas erfordert oft eine Neubereitstellung und Neusynchronisierung) sowie die Abhängigkeit von der Verfügbarkeit des dezentralen Netzwerks.
Maßgeschneiderte Indexer geben Teams die volle Kontrolle über ihre Datenpipeline, erfordern jedoch einen erheblichen technischen Aufwand. Die Entwicklung eines produktionsreifen, maßgeschneiderten Indexers umfasst die Programmierung der Logik zur Blockerfassung, die Dekodierung von Ereignissen, die Gestaltung des Datenbankschemas, die Handhabung von Reorganisationen, die Fehlerbehebung, die Überwachung sowie die Skalierung der Infrastruktur. Für groß angelegte Anwendungen mit besonderen Datenanforderungen kann sich dieser Aufwand lohnen, doch für die meisten Teams bedeutet dies monatelangen Entwicklungsaufwand, der stattdessen für ihr Kernprodukt genutzt werden könnte.
Das Push-basierte Streaming stellt einen neueren Ansatz dar, der die Indizierung vereinfacht, indem gefilterte Blockchain-Daten direkt an Ihr Speichersystem übermittelt werden, sodass Sie die Extraktionsschicht nicht mehr selbst aufbauen und warten müssen. Anstatt dass Ihr Indizierer Daten von einem Knoten abruft, übermittelt ein Streaming-Dienst genau die Daten, die Sie benötigen, an Ihre Datenbank, Ihren Webhook oder Ihr Data Warehouse.
Wie „ Quicknode “ die Indizierung von Blockchain-Daten ermöglicht
Quicknode Streams wurde speziell für die Indizierung von Blockchain-Daten entwickelt. „ Streams “ bietet eine Push-basierte Datenpipeline, die Rohdaten oder gefilterte Blockchain-Daten direkt an den Zielort Ihrer Wahl übermittelt, darunter PostgreSQL, Snowflake, Amazon S3, Azure Storage und webhooks. Anstatt eine RPC-Polling-Infrastruktur zum Extrahieren von Daten aus der Blockchain aufzubauen und zu warten, konfigurieren Sie einen Stream mit dem gewünschten Netzwerk, dem Datensatz (Blöcke, Transaktionen, Belege, Traces) und optionalen JavaScript-Filtern – den Rest übernimmt „ Quicknode “.
Streams liefert Daten in der Reihenfolge ihrer endgültigen Feststellung mit einer „Exactly-Once“-Zustellungsgarantie. Das bedeutet, dass Ihre Datenbank stets mit der kanonischen Blockchain konsistent bleibt, ohne dass Ihr Code die Blockreihenfolge oder die Deduplizierung verwalten muss. Die integrierte Reorg-Verarbeitung erkennt automatisch Reorganisationen der Blockchain und sendet Korrekturdaten, sodass Ihre indizierten Daten stets den tatsächlichen Zustand der Blockchain widerspiegeln. Für historische Daten ermöglicht Ihnen die „Backfill“-Funktion von Streams, Ihre Datenbank mit beliebigen Bereichen vergangener Blöcke zu füllen – und zwar bis zu siebenmal schneller als herkömmliche RPC-basierte Indizierungspipelines, bei gleichen Filter- und Übertragungsgarantien wie beim Echtzeit-Streaming.
Quicknode Außerdem veröffentlicht das Unternehmen eine Schritt-für-Schritt-Anleitung zum Aufbau eines Blockchain-Indexers unter Streams, in der gezeigt wird, wie man einen vollständigen ERC-20-Transfer-Indexer auf Basis von PostgreSQL mit einer REST-API erstellt – von der Konfiguration bis zur Abfrage. Für Teams, die eine noch ausgefeiltere Datenverarbeitung benötigen, lässt sich Streams in Quicknode Functions integrieren, um serverlose Transformationen, Anreicherung und Automatisierung auf Basis der Streaming-Datenpipeline zu ermöglichen.
Was ist der Unterschied zwischen Indizierung und Raw-RPC?
Raw RPC und Indizierung dienen der Beantwortung unterschiedlicher Arten von Fragen. RPC ist für punktuelle Abfragen und Schreibvorgänge konzipiert: diesen Block abrufen, diesen Kontostand lesen, diese Transaktion senden. Die Indizierung ist für Such- und Analysezwecke ausgelegt: alle Überweisungen für eine Wallet, das Gesamtvolumen pro Token, die Besitzhistorie einer Sammlung. Die folgende Tabelle stellt die beiden Verfahren gegenüber, damit Sie für jede Aufgabe das richtige Werkzeug auswählen können.
Dimension | Raw RPC | Indizierte Datenbank |
|---|---|---|
Am besten in | Punktabfragen und Transaktionsübermittlung | Suche, Filterung und Aggregation |
Abfragesprache | JSON-RPC-Methoden | SQL oder GraphQL |
Historische Scans | Langsam, Block für Block | Schnell, vorverarbeitet und indexiert |
Einen gezielten Vergleich der beiden Ansätze finden Sie unter „RPC vs. Indexierung“, und um das zugrunde liegende Anfragemodell zu verstehen, lesen Sie den Artikel „So funktionieren RPC-Anfragen“.
Welche Arten von Abfragen werden durch die Indizierung ermöglicht?
Sobald Daten in einer strukturierten Datenbank indiziert sind, werden Abfragen, die über rohe RPC-Daten unmöglich sind, zum Kinderspiel. Sie können alle Transaktionen für eine Adresse auflisten, die gesamte Besitzhistorie eines NFTs nachverfolgen, das Handelsvolumen pro Token und Tag aggregieren, Wallets nach ihrem Bestand sortieren oder Ereignisse über mehrere Verträge hinweg verknüpfen. Genau diese Abfragen bilden die Grundlage für Dashboards, Explorer und Analyseprodukte. Warum diese Abfragen ohne Indizierung so schwierig sind, erfahren Sie unter „Abfragen von Blockchain-Daten“.
Wie funktionieren Indizierung und Streaming zusammen?
Streaming und Indizierung sind sich ergänzende Ebenen. Streaming ist der Übertragungsmechanismus, der neue Blöcke und Ereignisse in Echtzeit an Ihre Infrastruktur weiterleitet, während die Indizierung dafür sorgt, dass diese eingehenden Daten in einem abfragbaren Speicher organisiert werden. Eine gängige moderne Architektur nutzt eine Streaming-Pipeline, um Datensätze in eine indizierte Datenbank einzuspeisen, wodurch die anfällige Polling-Ebene vollständig entfällt. Lesen Sie die Artikel „Was ist Blockchain-Daten-Streaming? “ und „Polling vs. Streaming“, um zu erfahren, wie die Daten überhaupt zum Indizierer gelangen.
Wie füllen Indexer historische Daten nach?
Unter „Backfilling“ versteht man den Vorgang, bei dem die Datenbank mit historischen Blöcken befüllt wird, bevor auf Live-Daten umgeschaltet wird. Eine gute Pipeline beginnt bei einem ausgewählten historischen Block, arbeitet sich durch die Blockchain vorwärts und wechselt dann nahtlos in den Echtzeitbetrieb, sobald sie die Spitze erreicht hat, sodass historische und Live-Datensätze dasselbe Schema nutzen. Bei korrekter Umsetzung ist das Backfilling weitaus schneller als ein erneutes Scannen der Blockchain über rohes RPC. Erfahren Sie, wie Sie auf historische Blockchain-Daten zugreifen können, und informieren Sie sich über die Vor- und Nachteile von Echtzeit- gegenüber historischen Blockchain-Daten.
Häufig gestellte Fragen
Warum kann ich nicht einfach RPC anstelle der Indizierung verwenden?
RPC eignet sich hervorragend zum Abrufen eines bestimmten Blocks, einer bestimmten Transaktion oder eines bestimmten Guthabens, bietet jedoch keine Möglichkeit, die gesamte Blockchain zu durchsuchen, zu filtern oder zu aggregieren. Die Beantwortung einer Frage wie „Alle Transfers aus dieser Wallet“ über RPC würde bedeuten, Millionen von Blöcken nacheinander zu durchsuchen, was unpraktisch ist. Durch die Indizierung werden diese Daten vorab in einer Datenbank verarbeitet, sodass dieselbe Frage mit einer einzigen Abfrage beantwortet werden kann.
Was ist ein Teilgraph?
Ein Subgraph ist eine von The Graph verwendete Konfiguration, die festlegt, welche Kontrakte und Ereignisse indiziert werden sollen und wie diese in ein abfragbares GraphQL-Schema abgebildet werden. Dies ist eine beliebte Methode zum Erstellen eines Indexes, die sich gut für Standarddaten aus den Bereichen DeFi, NFT und Governance eignet, wobei im Vergleich zu benutzerdefinierten oder streamingbasierten Pipelines jedoch Kompromisse hinsichtlich der Echtzeit-Latenz und der Schemaflexibilität eingegangen werden müssen.
Wie gehen Indexer mit Kettenreorganisationen um?
Ein robuster Indexer erkennt, wenn sich die kanonische Kette ändert, macht die aus den verwaisten Blöcken abgeleiteten Datensätze rückgängig und verarbeitet die korrekten Datensätze erneut. Ohne diese Funktion sammeln sich in Ihrer Datenbank Phantom- oder fehlende Transaktionen an. Verwaltete Pipelines wickeln Reorgs automatisch ab, indem sie Korrekturdaten senden. Weitere Informationen finden Sie unter „Was ist eine Blockchain-Reorg?“.
Soll ich meinen eigenen Indexer entwickeln oder einen Managed Service nutzen?
Die Entwicklung eines benutzerdefinierten Indexers bietet zwar volle Kontrolle, erfordert jedoch die Programmierung von Datenaufnahme, Dekodierung, Schema-Design, Umgang mit Reorganisationen, Überwachung und Skalierung – was oft mehrere Monate Arbeit in Anspruch nimmt. Eine verwaltete Pipeline übernimmt für Sie die Extraktion, Sortierung, Reorganisationen und Bereitstellung, sodass die meisten Teams schneller in die Produktion gehen können, indem sie einen Dienst konfigurieren und ihre technischen Ressourcen auf ihr Kernprodukt konzentrieren.
In welchen Datenbanken können indizierte Blockchain-Daten gespeichert werden?
Indizierte Daten werden in der Regel in PostgreSQL, MongoDB, Snowflake, Elasticsearch oder in Objektspeichern wie Amazon S3 gespeichert, je nachdem, ob Sie transaktionale Abfragen, Volltextsuche oder Analysen in großem Maßstab benötigen. Eine Streaming-Pipeline kann Datensätze direkt an diese Ziele übermitteln. Umfassende Tutorials zu diesem Thema finden Sie im „Builders Guide“, der gängige Indizierungsmuster erläutert.
Weiterführende Literatur
So erstellen Sie einen Blockchain-Indexer mit „ Streams “ – Leitfadenvon „ Quicknode “
Erste Schritte mit „ Streams “ – Dokumentationvon „ Quicknode “
Nachträgliche Erfassung von Blockchain-Daten – Dokumentation von „ Quicknode “
Web3-Daten mit Blockchain-ETL meistern – Blog von „ Quicknode “
