TL;DR: Blockchain-Daten-Streaming ist ein Push-basierter Ansatz für den Zugriff auf Blockchain-Daten, bei dem neue Blöcke, Transaktionen und Ereignisse automatisch an Ihre Anwendung oder Datenbank übermittelt werden, sobald sie in der Blockchain erzeugt werden. Anstatt dass Ihre Anwendung den Knoten wiederholt fragt: „Gibt es schon etwas Neues?“ (Polling), sendet Ihnen ein Streaming-Dienst die Daten in dem Moment, in dem sie verfügbar sind. Streaming reduziert die Latenz, verhindert, dass Ereignisse übersehen werden, vereinfacht Ihre Backend-Architektur und lässt sich weitaus effizienter skalieren als herkömmliche Request-Response-Muster.
Die einfache Erklärung
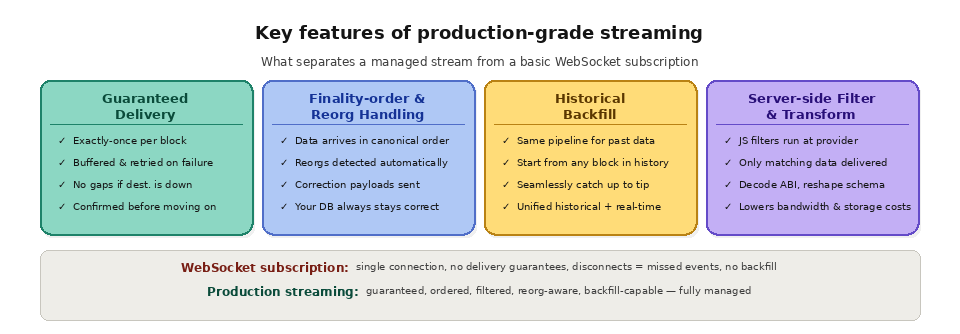
Es gibt zwei grundlegende Möglichkeiten, Daten aus einem beliebigen System abzurufen: Man kann sie anfordern (Pull) oder sie werden einem zugesandt (Push). Während des größten Teils der Geschichte der Blockchain haben Entwickler das Pull-Modell verwendet. Ihre Anwendung sendet eine RPC-Anfrage an einen Knoten, der Knoten sendet eine Antwort zurück, und Ihre Anwendung entscheidet, wann sie erneut eine Anfrage stellt. Dies ist das Polling-Muster. Es ist einfach zu implementieren, aber ineffizient, insbesondere wenn Ihre Anwendung mit dem aktuellen Zustand der Blockchain synchron bleiben muss.
Streaming kehrt dieses Modell um. Anstatt dass Ihre Anwendung tausende Male am Tag fragt: „Was ist im letzten Block passiert?“, richten Sie einmalig eine Datenpipeline ein, und der Streaming-Dienst liefert die Daten jedes neuen Blocks an Ihre Anwendung oder Datenbank, sobald diese erzeugt werden. Ihre Anwendung wird so zum Empfänger eines kontinuierlichen Datenstroms und nicht mehr zum Anforderer einzelner Daten-Snapshots.
Die Analogie lässt sich mit dem Unterschied zwischen dem alle fünf Minuten erfolgenden Aktualisieren einer Nachrichten-Website und dem Abonnieren einer Push-Benachrichtigung vergleichen, die Sie sofort benachrichtigt, sobald eine story veröffentlicht wird. Bei beiden erhalten Sie letztendlich dieselben Informationen, doch das Push-Modell ist schneller, ressourcenschonender und zuverlässiger.
So funktioniert das Streaming von Blockchain-Daten
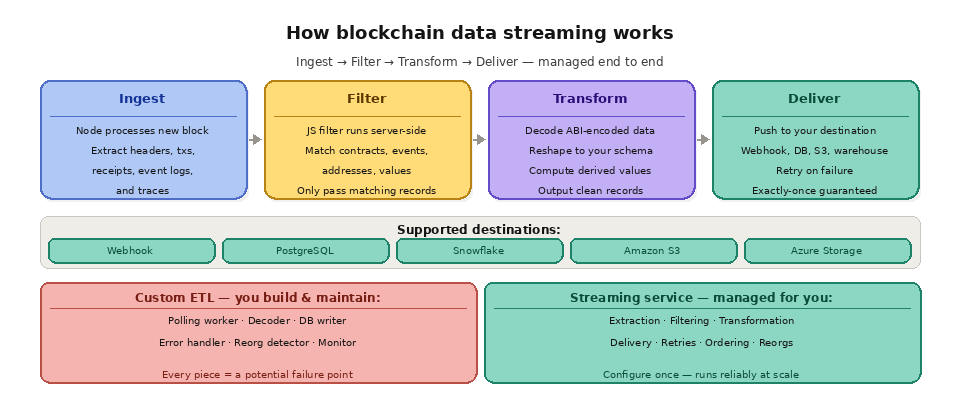
Ein Streaming-Dienst fungiert als Vermittler zwischen den Blockchain-Knoten und Ihrer Anwendung oder Dateninfrastruktur. Auf der Erfassungsseite stellt der Dienst eine Verbindung zu Knoten in den unterstützten Netzwerken her und verarbeitet jeden neuen Block, sobald dieser finalisiert ist. Er extrahiert die Rohdaten des Blocks, einschließlich Header, Transaktionen, Transaktionsbelege (mit Ereignisprotokollen) und optional Ausführungsabläufe. Diese Rohdaten stellen die vollständige Aufzeichnung aller Ereignisse dar, die in diesem Block stattgefunden haben.
Auf der Verarbeitungsseite wendet der Streaming-Dienst alle von Ihnen konfigurierten Filter oder Transformationen an. Vielleicht interessieren Sie sich nur für ERC-20-Übertragungsereignisse aus einer bestimmten Gruppe von Kontrakten. Ein in JavaScript oder einer anderen unterstützten Sprache geschriebener Filter wird auf die Daten jedes Blocks angewendet und lässt nur die Datensätze durch, die Ihren Kriterien entsprechen. Diese serverseitige Filterung ist entscheidend für die Effizienz, da dadurch Ihr Zielsystem nur die Daten empfängt und speichert, die Sie tatsächlich benötigen, und nicht den gesamten Block.
Auf der Ausgabeseite werden die gefilterten Daten an das von Ihnen konfigurierte Ziel gesendet. Dies kann eine Webhook-URL sein, auf die Ihre Anwendung wartet, eine PostgreSQL-Datenbank, ein Snowflake-Data-Warehouse, ein Amazon S3-Bucket, Azure Blob Storage oder ein anderes unterstütztes endpoint. Der Streaming-Dienst übernimmt die Zustellungsgarantien, einschließlich Wiederholungsversuchen bei Fehlern, Deduplizierung und korrekter Reihenfolge, sodass Ihr Ziel einen lückenlosen, sequenziellen Feed mit Blockchain-Daten erhält.
Streaming im Vergleich zu herkömmlichen ETL-Ansätzen
Herkömmliche Blockchain-ETL-Pipelines (Extract, Transform, Load) erfordern von Entwicklern den Aufbau und die Wartung einer umfangreichen Infrastruktur. Eine typische benutzerdefinierte ETL-Konfiguration umfasst einen Polling-Worker, der nach einem festgelegten Zeitplan RPC-Endpunkte aufruft, um neue Blöcke abzurufen, eine Verarbeitungsschicht, die die Rohdaten dekodiert und transformiert, einen Datenbank-Writer, der Datensätze einfügt, einen Fehlerhandler, der Wiederholungsversuche und Fehler verwaltet, einen Reorg-Detektor, der Daten aus aufgegebenen Forks identifiziert und zurückrollt, sowie eine Überwachung, die Alarm auslöst, wenn eine dieser Komponenten ausfällt. Jede dieser Komponenten erhöht die Komplexität und stellt eine potenzielle Fehlerquelle dar.
Streaming-Dienste bündeln all dies in einer einzigen verwalteten Pipeline. Die Extraktion, Filterung, Transformation, Bereitstellung, Wiederholungslogik, Sortierung und die Behandlung von Reorganisationen erfolgen vollständig auf der Infrastruktur des Anbieters. Ihre Aufgabe beschränkt sich darauf, zu konfigurieren, welche Daten Sie benötigen, wohin diese gesendet werden sollen und wie sie aufbereitet werden sollen. Dies reduziert den technischen Aufwand für den Aufbau und die Wartung einer Blockchain-Dateninfrastruktur erheblich.
Auch der Leistungsunterschied ist erheblich. Eine auf Polling basierende Pipeline weist naturgemäß eine Latenz auf, die dem Polling-Intervall entspricht. Wenn Ihr Worker alle 5 Sekunden nach neuen Blöcken sucht, könnten Sie selbst bei einwandfreiem Betrieb bis zu 5 Sekunden hinter der Chain-Tip zurückliegen. Verpasste Polls (aufgrund von Fehlern, Ratenbeschränkungen oder Neustarts des Workers) vergrößern diese Lücke. Streaming beseitigt die Polling-Latenz, da Daten sofort übertragen werden, sobald sie verfügbar sind. Bei Ketten mit hohem Durchsatz, bei denen alle paar hundert Millisekunden neue Blöcke erzeugt werden, ist dieser Unterschied für latenzempfindliche Anwendungen von großer Bedeutung.
Wichtigste Merkmale des Produktions-Streamings
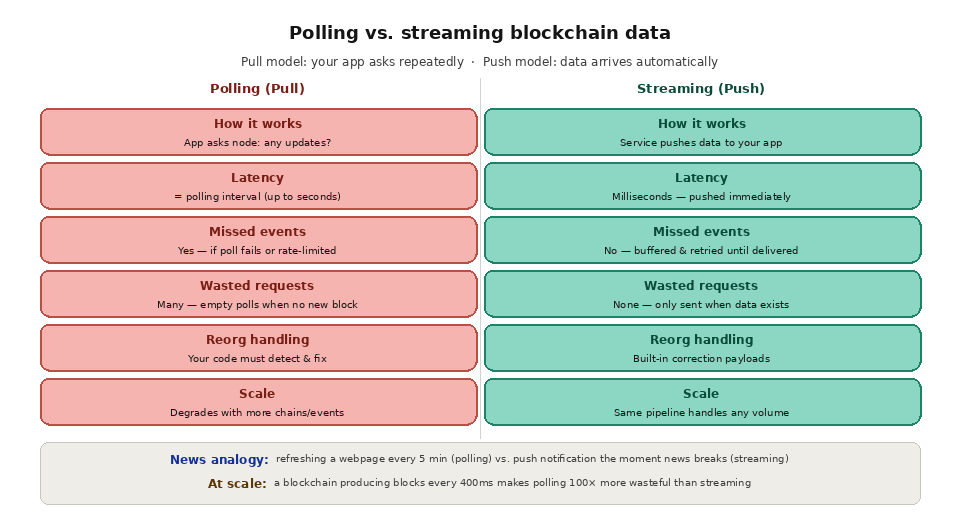
Mehrere Funktionen unterscheiden Streaming auf Produktionsniveau von einem einfachen WebSocket-Abonnement. Die garantierte Zustellung stellt sicher, dass die Daten jedes Blocks genau einmal ihr Ziel erreichen, selbst wenn die Verbindung vorübergehend unterbrochen wird oder am Zielort ein kurzer Ausfall auftritt. Der Streaming-Dienst puffert die Daten und wiederholt den Versuch so lange, bis die Zustellung bestätigt wird, sodass niemals Lücken in Ihren Daten entstehen.
Die Übermittlung in der Reihenfolge der Finalität bedeutet, dass Daten in der Reihenfolge ankommen, die die Blockchain als kanonisch betrachtet. Bei Blockchains mit variablen Finalitätszeiten wartet der Streaming-Dienst, bis ein Block ausreichend bestätigt ist, bevor er ihn übermittelt. Dadurch wird verhindert, dass Ihre Anwendung Daten verarbeitet, die später durch eine Reorganisation ungültig werden könnten. Wenn es doch zu Reorganisationen kommt, erkennt der Dienst die Abzweigung, ermittelt, welche Blöcke nicht mehr kanonisch sind, und sendet Korrekturdaten, damit Ihr Zielsystem die entsprechenden Aktualisierungen vornehmen kann.
Durch das historische Backfilling können Sie dieselbe Streaming-Pipeline nicht nur für neue Blöcke, sondern auch für historische Daten nutzen. Anstatt einen separaten ETL-Prozess für historische Daten und einen weiteren für Echtzeitdaten zu erstellen, konfigurieren Sie einen einzigen Stream mit einem Startblock in der Vergangenheit und lassen ihn die Historie abarbeiten, um dann nahtlos in den Echtzeitbetrieb überzugehen, sobald er die Spitze der Blockchain erreicht hat. Diese einheitliche Pipeline vereinfacht Ihre Architektur und gewährleistet die Konsistenz zwischen historischen und Echtzeitdaten.
Serverseitige Filterung und Transformation reduzieren das Datenvolumen, das Ihr Ziel erreicht, und senken so die Bandbreitenkosten, Speicherkosten und den Verarbeitungsaufwand. Filter können anhand von Adressen, Ereignissignaturen, Funktionsselektoren, Transaktionswerten oder beliebigen anderen Eigenschaften der Blockdaten abgeglichen werden. Transformationen können Nutzdaten umgestalten, ABI-kodierte Daten dekodieren, abgeleitete Werte berechnen und Datensätze in einem Schema ausgeben, das Ihren Datenbanktabellen entspricht.
Wie Quicknode Streams Blockchain-Datenstromübertragung bereitstellt
Quicknode Streams ist ein speziell entwickelter Blockchain-Daten-Streaming- und ETL-Dienst, der Echtzeit- und historische Daten aus über 80 Blockchains bereitstellt – mit integrierten Filter- und Transformationsfunktionen sowie garantierter Zustellung. „ Streams “ unterstützt verschiedene Datensatztypen (Blöcke, Transaktionen, Belege, Ereignisprotokolle, Traces) und zahlreiche Zielsysteme (webhooks, PostgreSQL, Snowflake, Amazon S3, Azure Storage und weitere).
Streams verarbeitet Daten in der Reihenfolge ihrer Endgültigkeit mit einer „Exactly-Once“-Zustellungsgarantie, bewältigt Kettenreorganisationen automatisch durch das Senden von Korrekturdaten und unterstützt konfigurierbares Batching und Komprimierung für einen optimalen Durchsatz bei der Nachvervollständigung historischer Daten. JavaScript-Filter werden auf der Infrastruktur von Quicknode ausgeführt und ermöglichen es Ihnen, Ereignisse zu dekodieren, Muster abzugleichen, auf externe Schlüssel-Wert-Speicher zuzugreifen und Ausgabedaten zu gestalten, bevor die Daten ihr Ziel erreichen. Ein-Klick-Backfill-Vorlagen bieten vorkonfigurierte Pipelines für gängige Datensätze über mehr als 20 Blockchains hinweg, wobei vor dem Start transparente Schätzungen zu Kosten und Fertigstellungszeit angezeigt werden.
Für noch komplexere Arbeitsabläufe lässt sich „ Streams “ mit „ Quicknode Functions“ integrieren, um eine serverlose Automatisierung auf Basis von Streaming-Daten zu ermöglichen. Mit „Functions“ können Datensätze mit zusätzlichen On-Chain-Daten angereichert, externe APIs aufgerufen, Benachrichtigungen ausgelöst oder beliebige Geschäftslogik als Reaktion auf Streaming-Ereignisse ausgeführt werden. Zusammen bilden „ Streams “ und „Functions“ eine vollständige Blockchain-Datenplattform, die eine maßgeschneiderte ETL-Infrastruktur durch eine verwaltete, skalierbare Lösung ersetzt.
Was ist der Unterschied zwischen Streaming und Polling?
Polling und Streaming sind die beiden Methoden, mit denen eine Anwendung über die Aktivitäten in der Blockchain auf dem Laufenden bleibt, und sie liegen an entgegengesetzten Enden eines Spektrums. Polling ist pull-basiert: Ihre Anwendung fragt einen Knoten wiederholt ab, ob neue Daten vorliegen. Streaming ist push-basiert: Ein Dienst liefert Ihnen neue Daten in dem Moment, in dem sie verfügbar sind. Die folgende Tabelle vergleicht beide Methoden anhand der Aspekte, die bei der Wahl eines Ansatzes am wichtigsten sind.
Dimension | Umfrage | Streaming |
|---|---|---|
Daten flow | Die Anwendung ruft Daten nach einem Zeitplan ab | Der Dienst sendet Push-Benachrichtigungen, sobald Daten generiert werden |
Latenz | Begrenzt durch das Abfrageintervall | Near Echtzeit, ohne Zeitverzögerung |
Risiko durch fehlende Daten | Lücken, wenn eine Umfrage fehlschlägt oder übersprungen wird | Garantierte, lückenlose Lieferung |
Einen ausführlicheren Vergleich der beiden Übertragungsmodelle und Informationen dazu, wann welches Modell sinnvoll ist, finden Sie unter „Polling vs. Streaming“.
Was sind gängige Anwendungsfälle für Blockchain-Datenströme?
Streaming eignet sich für alle Workloads, die schnell auf On-Chain-Aktivitäten reagieren oder eine Datenbank kontinuierlich synchronisieren müssen. Zu den gängigen Beispielen zählen die Echtzeit-Verfolgung von Wallets und Portfolios, DeFi-Dashboards, Handels- und Liquidations-Bots, die Überwachung der Erstellung und des Verkaufs von NFTs, Warnmeldungen zu Betrug und Compliance sowie Analytics-Warehouses, die jeden Block erfassen. Alle diese Anwendungen profitieren von geringer Latenz und lückenloser Datenübertragung anstelle von periodischen Snapshots. Eine umfassendere Übersicht über Anwendungsmuster finden Sie unter „Anwendungsfälle für Blockchain-Streaming“.
Wie werden bei Streaming-Diensten Echtzeitdaten im Vergleich zu historischen Daten behandelt?
Eine leistungsstarke Streaming-Pipeline behandelt Echtzeit- und historische Daten als eine einzige fortlaufende Zeitachse und nicht als zwei getrennte Systeme. Sie können einen Stream von einem Block aus der fernen Vergangenheit starten, ihn vorwärts durch die Historie nachholen lassen und dann nahtlos zu Live-Blöcken übergehen, sobald er die Spitze der Blockchain erreicht hat. Dadurch wird vermieden, dass zwei Pipelines mit zwei unterschiedlichen Codepfaden gepflegt werden müssen. Um die Vor- und Nachteile von aktuellen und archivierten Daten zu verstehen, lesen Sie den Abschnitt „Echtzeit- vs. historische Blockchain-Daten“, und Informationen zu Nachholstrategien finden Sie unter „Zugriff auf historische Blockchain-Daten“.
Wie geht das Streaming mit Kettenreorganisationen um?
Reorganisationen stellen die größte Herausforderung bei der Nutzung von Live-Blockchain-Daten dar, da ein Block, den Ihre Anwendung bereits verarbeitet hat, durch einen konkurrierenden Block ersetzt werden kann. Produktions-Streaming-Dienste bewältigen dies, indem sie Daten in der Reihenfolge ihrer Endgültigkeit bereitstellen und bei einer Reorganisation Korrekturdaten senden, die Ihrem Zielsystem mitteilen, welche Blöcke nicht mehr kanonisch sind, damit es die betroffenen Datensätze zurückrollen kann. Dadurch wird einer der fehleranfälligsten Aspekte benutzerdefinierter Pipelines beseitigt. Erfahren Sie mehr unter „Was ist eine Blockchain-Reorganisation?“.
Inwiefern unterscheidet sich Streaming von der Indizierung?
Streaming und Indizierung lösen verwandte, aber unterschiedliche Probleme. Beim Streaming geht es um die Übermittlung: On-Chain-Daten werden in Echtzeit an ihren Bestimmungsort weitergeleitet. Bei der Indizierung geht es um die Organisation: Diese Daten werden in einer abfragbaren Datenbank strukturiert, sodass Sie schnelle Abfragen zu historischen Daten und aggregierten Werten durchführen können. Viele Teams nutzen Streaming, um einen Index zu füllen, und fragen diesen Index anschließend für Analysen ab. Lesen Sie die Artikel „Was ist Blockchain-Indizierung? “ und „Abfragen von Blockchain-Daten“, um zu erfahren, wie die einzelnen Teile zusammenpassen.
Häufig gestellte Fragen
Ist das Streaming von Blockchain-Daten dasselbe wie ein WebSocket-Abonnement?
Nicht ganz. Ein WebSocket-Abonnement ist eine Low-Level-Verbindung, über die Ereignisse gepusht werden, solange der Socket offen bleibt; es bietet jedoch keine Zustellungsgarantien und wird unterbrochen, wenn die Verbindung abbricht. Das Produktions-Streaming ergänzt dieses grundlegende Push-Modell um „Exactly-Once“-Zustellung, Finalitätsreihenfolge, Reorg-Korrekturen, serverseitige Filterung und das Nachholen historischer Daten.
Garantiert das Streaming, dass ich keinen Block verpasse?
Ja, mit einem Produktionsdienst. Garantierte Übertragung bedeutet, dass der Anbieter die Daten zwischenspeichert und die Übertragung wiederholt, bis die Daten jedes Blocks an Ihrem Zielort bestätigt wurden, sodass Sie einen lückenlosen Feed erhalten, selbst wenn Ihr endpoint kurzzeitig ausfällt. Push-basierte Ereignisdienste wie Quicknode Webhooks wenden dieselben Zuverlässigkeitsprinzipien auf Ereignisbenachrichtigungen an.
Kann ich Streaming-Daten filtern, bevor sie ihr Ziel erreichen?
Ja. Mit der serverseitigen Filterung können Sie nach Adressen, Ereignissignaturen, Funktionsselektoren, Werten oder beliebigen anderen Eigenschaften des Blocks filtern, sodass nur die Datensätze geliefert werden, die für Sie von Interesse sind. Dies senkt die Kosten für Bandbreite, Speicherplatz und Verarbeitung, da Sie niemals Daten erhalten, die Sie nicht benötigen.
Kann Streaming eine maßgeschneiderte ETL-Pipeline ersetzen?
Für die meisten Teams trifft das zu. Ein verwalteter Streaming-Dienst bündelt die Extraktion, Filterung, Transformation, Bereitstellung, Wiederholungsversuche, Sortierung und die Behandlung von Reorganisationen in einer einzigen Pipeline und beseitigt so die vielen einzelnen Komponenten eines selbst entwickelten ETL-Stacks. Sie legen fest, welche Daten Sie benötigen und wohin diese geleitet werden sollen – den Rest übernimmt der Anbieter.
An welche Ziele können Streaming-Daten übertragen werden?
Zu den gängigen Zielen zählen unter anderem Webhook-URLs, PostgreSQL, Snowflake, Amazon S3 und Azure Blob Storage. Auf diese Weise können Sie Streaming-Daten direkt in Ihr Anwendungs-Backend, Ihr Data Warehouse oder Ihren Objektspeicher einbinden, ohne für jedes Ziel eigene Konnektoren entwickeln zu müssen.
Weiterführende Literatur
Erste Schritte mit „ Streams “ – Quicknode Docs
Kosten senken und Blockchain-Datenpipelines vereinfachen – Quicknode Blog
Beschleunigen Sie Ihre Produkte mit gestreamten, indizierten Daten – Quicknode Blog
Quicknode Streams
