TL;DR: Der Zugriff auf historische Blockchain-Daten erfordert entweder einen Archivknoten (der jeden Zustands-Snapshot seit der Genesis speichert) oder ein Tool zum Nachfüllen von Daten, das vergangene Blöcke abruft und in einer abfragbaren Datenbank speichert. Standardmäßige Full Nodes behalten nur die letzten 128 Blöcke mit Zustandsdaten bei und löschen alles Ältere; daher schlägt die Abfrage des Guthabens einer Wallet von vor sechs Monaten auf einem Full Node fehl. Die beiden wichtigsten Ansätze sind der RPC-Zugriff auf Archivknoten für Abfragen des Zustands zu einem bestimmten Zeitpunkt und Streaming-Backfills zum Aufbau umfassender historischer Datenbanken.
Die einfache Erklärung
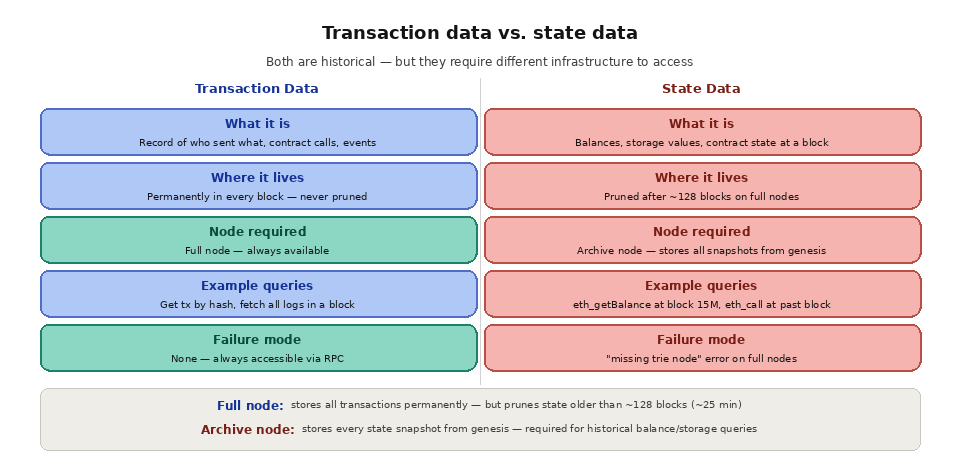
Blockchains zeichnen jede Transaktion auf, die jemals stattgefunden hat, doch das bedeutet nicht, dass alle historischen Daten leicht zugänglich sind. Der Unterschied liegt zwischen Transaktionsdaten und Zustandsdaten. Transaktionsdaten (die Aufzeichnung darüber, wer was an wen gesendet hat, welche Verträge aufgerufen wurden und welche Ereignisse ausgelöst wurden) sind dauerhaft und in jedem Block verfügbar. Zustandsdaten (die Guthaben, Speicherwerte und Vertragszustände zu einem bestimmten Zeitpunkt) sind ein anderes story.
Vollknoten, bei denen es sich um die Standardknoten handelt, die von den meisten RPC-Anbietern betrieben werden, speichern die vollständige Historie der Blöcke und Transaktionen, verwalten jedoch nur den aktuellen Zustand und ein rollierendes Fenster mit aktuellen Zustands-Snapshots (in der Regel die letzten 128 Blöcke auf Ethereum, was etwa 25 Minuten entspricht). Um Speicherplatz zu sparen, werden ältere Zustandsdaten bereinigt. Das bedeutet, dass ein Vollknoten Ihnen zwar mitteilen kann, welche Transaktionen in Block 15.000.000 stattgefunden haben, Ihnen jedoch nicht sagen kann, wie hoch der Kontostand einer Wallet in Block 15.000.000 war, es sei denn, dieser Block liegt innerhalb des aktuellen Aufbewahrungsfensters.
Wenn Ihre Anwendung einen RPC-Aufruf wie „eth_getBalance“ mit einer historischen Blocknummer an einen Full Node sendet, gibt der Node den Fehler „missing trie node“ zurück, da die Zustandsdaten für diesen Block bereinigt wurden. Dies ist die häufigste Überraschung, auf die Entwickler stoßen, wenn sie zum ersten Mal mit historischen Daten arbeiten. Die Blockchain „merkt“ sich zwar alles in dem Sinne, dass alle Transaktionen aufgezeichnet werden, doch die Wiederherstellung des Zustands zu einem beliebigen Zeitpunkt in der Vergangenheit erfordert eine spezielle Infrastruktur.
Was ist der Unterschied zwischen einem Full-Node und einem Archiv-Node?
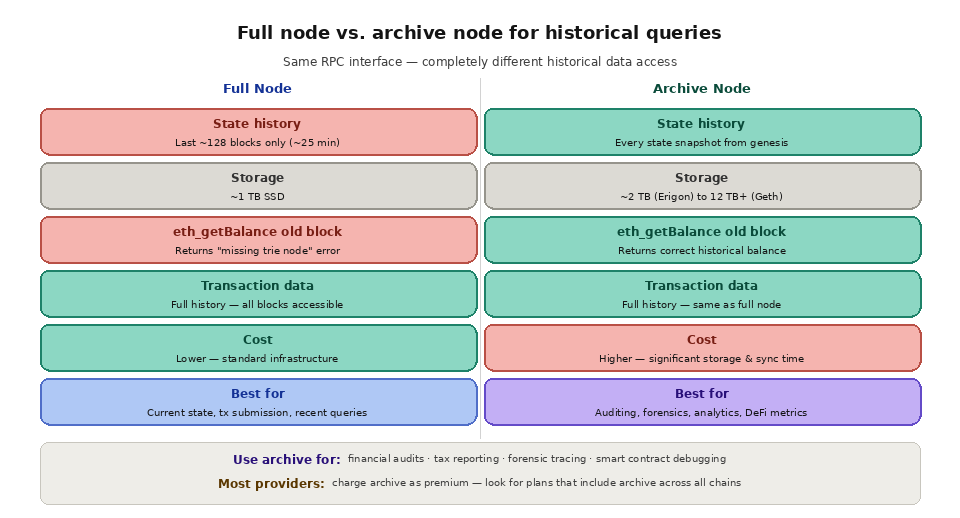
Der schnellste Weg, den Zugriff auf historische Daten zu verstehen, besteht darin, die beiden Knotentypen zu vergleichen, die von den meisten Anbietern betrieben werden. Ein Vollknoten speichert die vollständige Historie der Blöcke und Transaktionen, bereinigt jedoch alte Zustände, während ein Archivknoten jeden historischen Zustands-Snapshot aufbewahrt. Wenn Sie nur aktuelle Daten benötigen, ist ein Vollknoten kostengünstiger und schneller; für Abfragen zum historischen Zustand zu einem bestimmten Zeitpunkt ist jedoch ein Archivknoten erforderlich. Eine ausführlichere Erläuterung finden Sie in unserem Leitfaden zum Thema „Vollknoten vs. Archivknoten“ sowie in der Übersicht darüber, was ein Blockchain-Knoten ist.
Fähigkeit | Vollknoten | Archivknoten |
|---|---|---|
Staatliche Einbehaltung | Die letzten ~128 Blöcke (etwa 25 Minuten auf Ethereum) | Alle Zustände von den Anfängen bis heute |
Lagerfläche | Etwa 1 TB auf Ethereum | 12 TB oder mehr auf Ethereum |
Abfragen zum historischen Status | Schlägt mit der Fehlermeldung „Trie-Knoten fehlt“ fehl | Gibt den Status bei einer beliebigen Blockhöhe zurück |
Archivknoten für Point-in-Time-Abfragen
Archivknoten lösen das Problem der Zustandsbereinigung, indem sie jeden Zustands-Snapshot ab dem Genesis-Block aufbewahren. Ein Ethereum -Archivknoten speichert mehr als 12 TB an Daten, während ein Vollknoten etwa 1 TB benötigt, was den Betrieb und die Wartung deutlich teurer macht. Dafür ermöglicht er jedoch eine entscheidende Funktion: die Abfrage des genauen Zustands eines beliebigen Kontos, Vertrags oder Speicherplatzes bei jeder beliebigen historischen Blockhöhe.
Dies ist für eine Vielzahl von Anwendungsfällen unerlässlich. Bei der Finanzprüfung müssen Kontostände zu bestimmten Stichtagen rekonstruiert werden. Für die Steuerberichterstattung muss der Wert der Bestände zum Jahresende ermittelt werden. Bei der forensischen Analyse wird der flow von Geldmitteln anhand historischer Zustandsübergänge nachverfolgt. Beim Debugging von Smart Contracts werden historische Zustände genutzt, um vergangene Fehler oder Exploits zu reproduzieren und zu analysieren. Bei der Analyse von DeFi-Protokollen werden historische TVL-, APY- und andere Kennzahlen berechnet, indem Pool-Zustände bei vergangenen Blockhöhen abgefragt werden.
Der Betrieb eines eigenen Archivknotens ist ressourcenintensiv. Die anfängliche Synchronisierung dauert Wochen, die Speicherkosten sind hoch, und der Knoten erfordert fortlaufende Wartung, Client-Updates und Überwachung. Die meisten Teams greifen über Infrastrukturanbieter auf Archivdaten zu, anstatt eigene Knoten zu betreiben. Bei der Bewertung von Anbietern ist vor allem zu berücksichtigen, ob der Zugriff auf das Archiv in Ihrem Tarif enthalten ist oder als Premium-Zusatzfunktion in Rechnung gestellt wird und ob der Anbieter Archivdaten für alle Blockchains unterstützt, die Ihre Anwendung benötigt.
Wie weit zurück kann man historische Blockchain-Daten abfragen?
Mit einem Archivknoten können Sie den Status jedes Kontos, Vertrags oder Speicherplatzes bis zurück zum Genesis-Block abfragen. Transaktions- und Ereignisdaten sind aus jedem Block verfügbar, selbst auf einem normalen Vollknoten, doch historische Guthaben und Vertragsspeicher sind nur über einen Archivknoten abrufbar. Diese Unterscheidung ist wichtig, wenn Sie entscheiden, ob Sie den Zustand zu einem bestimmten Zeitpunkt oder eine vollständige Aufzeichnung vergangener Aktivitäten benötigen – ein Kompromiss, den wir im Artikel „Echtzeit- vs. historische Blockchain-Daten“ behandeln. Wenn Ihre Abfragen immer wieder fehlschlagen, liegt das in der Regel daran, dass die Anfrage einen Full-Node erreicht hat. Daher hilft Ihnen das Verständnis der Funktionsweise von RPC-Anfragen dabei, diese korrekt weiterzuleiten.
Streaming-Nachvervollständigungen für historische Datenbanken
Archivknoten beantworten Abfragen zum Zustand zu einem bestimmten Zeitpunkt, doch viele Anwendungsfälle im Bereich historischer Daten erfordern etwas anderes: eine vollständige, abfragbare Datenbank mit vergangenen Blöcken, Transaktionen, Ereignisprotokollen und Ablaufverfolgungen. Die Erstellung eines Blockchain-Analyse-Dashboards, einer API für die Token-Übertragungshistorie oder eines umfassenden Block-Explorers erfordert die Verarbeitung und Speicherung historischer Blockdaten in einer strukturierten Datenbank und nicht nur die Abfrage eines Archivknotens bei Bedarf.
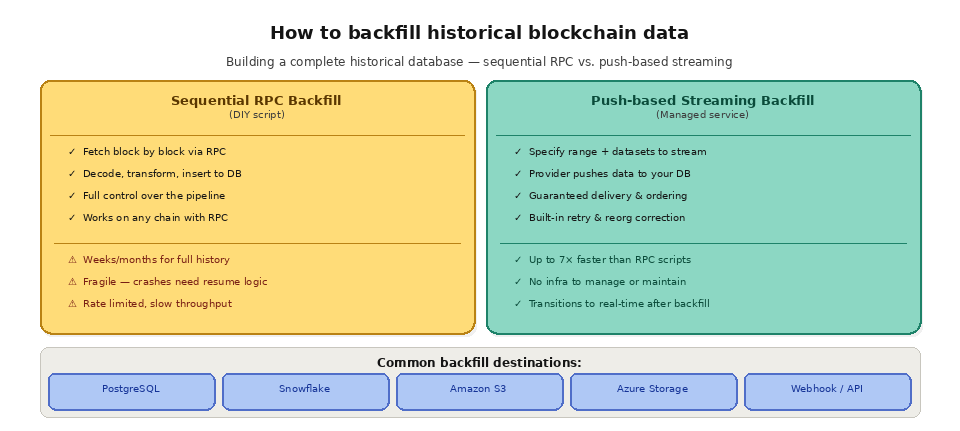
Der herkömmliche Ansatz zum Aufbau dieser Datenbank besteht darin, ein Skript zu schreiben, das die Blöcke nacheinander durchläuft, die Daten jedes Blocks über RPC abruft, die Transaktionen und Protokolle dekodiert und die Ergebnisse in Ihre Datenbank einfügt. Das funktioniert zwar, ist aber äußerst langsam und bei großem Umfang anfällig für Ausfälle. Das Nachholen der gesamten Historie von Ethereum(über 20 Millionen Blöcke) über sequenzielle RPC-Aufrufe kann Wochen oder Monate dauern. Das Skript muss Ratenbegrenzungen, Verbindungsausfälle, Knoten-Timeouts, Wiederholungsversuche und die Reihenfolge der Blöcke berücksichtigen. Wenn das Skript auf halbem Weg abstürzt, benötigen Sie eine Logik, um den Vorgang an der Stelle fortzusetzen, an der er unterbrochen wurde, ohne Lücken oder Duplikate in Ihren Daten zu erzeugen.
Push-basierte Backfilling-Tools lösen diese betrieblichen Probleme, indem sie die Komplexität der Infrastruktur auf Anbieterseite übernehmen. Sie geben einen Blockbereich an, wählen die benötigten Datensätze aus (Blöcke, Transaktionen, Belege, Traces, Protokolle), wenden optional Filter an, und das System überträgt die Daten an Ihr Ziel – mit garantierter Zustellung, korrekter Reihenfolge und automatischen Wiederholungsversuchen bei Fehlern. Sobald die historische Nachvervollständigung abgeschlossen ist, kann dieselbe Pipeline auf Echtzeit-Streaming umgestellt werden, um Ihre Datenbank auf dem neuesten Stand zu halten, sobald neue Blöcke erzeugt werden.
Wie lange dauert die Nachvervollständigung historischer Daten?
Die Dauer des Backfills hängt von der Blockchain, dem Blockbereich und den von Ihnen angeforderten Datensätzen ab. Ein sequenzielles Skript, das Blöcke einzeln über Standard-RPC abruft, kann Wochen oder Monate benötigen, um 20 Millionen Blöcke abzudecken, und muss dabei Wiederholungsversuche, die Reihenfolge und die Wiederaufnahme selbstständig verwalten. Verwaltete, push-basierte Backfills parallelisieren die Arbeit und können bis zu siebenmal schneller abgeschlossen werden, wobei Kosten- und Fertigstellungsschätzungen vor dem Start angezeigt werden. Der Durchsatz Ihrer zugrunde liegenden RPC-Infrastruktur ist der Hauptengpass bei jedem „Do-it-yourself“-Ansatz.
Weitere Methoden für historische Daten
The Graph und andere Indizierungsprotokolle stellen über Subgraphs vorab indizierte historische Daten für bestimmte Smart Contracts bereit. Wenn bereits ein Subgraph für das Protokoll bereitgestellt wurde, aus dem Sie Daten benötigen (wie Uniswap, Aave oder Lido), können Sie historische Daten über dessen GraphQL-API abfragen, ohne eine eigene Pipeline aufbauen zu müssen. Die Einschränkung besteht darin, dass Subgraphs kontraktspezifisch und schemaspezifisch sind, sodass Sie nur das abfragen können, was der Autor des Subgraphs zur Indizierung ausgewählt hat.
Drittanbieter von Daten wie Dune Analytics, Flipside Crypto und Nansen unterhalten umfassende historische Datenbanken für die wichtigsten Blockchains und stellen diese über SQL-Schnittstellen oder APIs zur Verfügung. Diese sind zwar praktisch für Analysen und Forschungszwecke, führen jedoch zu einer Abhängigkeit von der Aktualität, Genauigkeit und Verfügbarkeit der Daten eines Drittanbieters. Für Produktionsanwendungen, die über eine eigene Datenpipeline verfügen müssen, bietet der Aufbau auf Basis von Rohdaten aus der Blockchain (über Archivknoten oder Backfill- streams) mehr Kontrolle und Zuverlässigkeit.
Blockchain-spezifische Explorer und APIs (wie die API von Etherscan) bieten einen weiteren Zugriffsweg auf historische Daten, wenden jedoch in der Regel strenge Ratenbeschränkungen für kostenlose Tarife an und bieten möglicherweise nicht die Detailgenauigkeit oder Vollständigkeit, die Produktionsanwendungen erfordern.
Welche Methode sollten Sie verwenden, um auf historische Blockchain-Daten zuzugreifen?
Es gibt keine allgemein beste Methode: Die richtige Wahl hängt davon ab, ob Sie einen Momenzustand, eine vollständig abfragbare Datenbank oder vorab aggregierte Analysen benötigen. Die folgende Tabelle fasst die wichtigsten Optionen zusammen. Wenn Ihr Ziel eher der effiziente wiederholte Zugriff als einmalige Abfragen ist, sollten Sie RPC und Indizierung vergleichen und sich vor einer Entscheidung darüber informieren, was Blockchain-Indizierung ist, da die Abfrage von Blockchain-Daten in großem Maßstab schwieriger ist, als es zunächst den Anschein hat.
Verfahren | Am besten geeignet für | Hauptbeschränkung |
|---|---|---|
RPC-Knoten „Archiv“ | Zustand zu einem bestimmten Zeitpunkt in einem beliebigen Block | Keine Massendatenbank |
Streaming-Nachfüllung | Aufbau einer vollständigen, abfragefähigen Datenbank | Erfordert einen Speicherort für die Daten |
Indizierungsprotokolle und Teilgraphen | Vertragsbezogene historische Daten | Beschränkt auf das, was indexiert wurde |
Wie „ Quicknode “ den Zugriff auf historische Daten ermöglicht
Quicknode Beinhaltet den Zugriff auf Archivknoten in allen Tarifen, wodurch die separate Verwaltung oder Bezahlung einer Archivinfrastruktur entfällt. Jeder Quicknode RPC- endpoint kann Abfragen zum historischen Status bei jeder Blockhöhe bedienen, vom Genesis-Block bis zum aktuellsten Block. Die QRoute-Technologie von Quicknode leitet Anfragen zum historischen Status automatisch an Archivknoten und Anfragen zum aktuellen Status an Vollknoten weiter und stellt beide über eine einzige endpoint -URL bereit, ohne dass eine Konfiguration erforderlich ist.
Zum Aufbau historischer Datenbanken Quicknode Streams bietet „ Streams “-Vorlagen für das Backfilling mit nur einem Klick, mit denen Sie Ihre Datenbank mit der vollständigen Blockkettenhistorie aus über 20 Netzwerken befüllen können. Sie wählen die Blockkette, den Datensatztyp (Blöcke, Transaktionen, Belege, Traces oder All-in-One-Kombinationen) und das Ziel (PostgreSQL, Snowflake, Amazon S3, Azure Storage, webhooks) aus, und „ “ überträgt die Daten mit garantierter Zustellung, korrekter Blockreihenfolge und integrierter Wiederholungslogik. Kosten- und Zeitaufwandsschätzungen werden vor dem Start angezeigt und bieten Ihnen vollständige Transparenz. Backfills synchronisieren bis zu siebenmal schneller als herkömmliche RPC-basierte Skripte, und nach Abschluss kann derselbe Stream in Echtzeit mode fortgesetzt werden, um Ihre Datenbank auf dem neuesten Stand zu halten.
Weiterführende Literatur
Zugriff auf Archiv-Knoten vs. Vollknoten – Blog von „ Quicknode “
Nachträgliche Eintragung von Blockchain-Daten – Dokumentation zu„ Quicknode “
Vorlagen für die Nachträgliche Eintragung mit einem Klick – Quicknode
Erste Schritte mit „ Streams “ – Dokumentation zu „ “ Quicknode
Häufig gestellte Fragen
Was sind historische Blockchain-Daten?
Historische Blockchain-Daten sind alle Aufzeichnungen vergangener On-Chain-Aktivitäten, darunter Blöcke, Transaktionen, Ereignisprotokolle, Trace-Daten und der Zustand (Guthaben und Vertragsspeicher) bei einer bestimmten Blockhöhe. Transaktionsdaten sind auf jedem Knoten dauerhaft gespeichert, für den historischen Zustand ist jedoch ein Archivknoten oder ein gespeichertes Backfill erforderlich.
Warum schlägt „eth_getBalance“ bei alten Blöcken fehl?
Ein standardmäßiger Full Node entfernt Zustände, die älter sind als etwa die letzten 128 Blöcke, sodass ein historischer „eth_getBalance“-Aufruf einen Fehler wegen eines fehlenden Trie-Knotens zurückgibt. Durch die Abfrage eines Archiv-Nodes, der jeden Zustands-Snapshot beibehält, wird der Fehler behoben.
Benötige ich einen Archivknoten, um auf historische Daten zugreifen zu können?
Für Abfragen zum Zustand zu einem bestimmten Zeitpunkt bei beliebigen Blockhöhen benötigen Sie Zugriff auf das Archiv. Wenn Sie lediglich historische Transaktionen und Ereignisprotokolle benötigen, können Sie diese von Full Nodes abrufen oder sie mittels eines Backfills in Ihrer eigenen Datenbank speichern.
Was ist ein Blockchain-Daten-Backfill?
Bei einem Backfill werden eine Reihe vergangener Blöcke und deren Datensätze abgerufen und in eine Datenbank oder ein Speicherziel geladen. Push-basierte Backfills kümmern sich um die Reihenfolge, Wiederholungsversuche und die garantierte Zustellung und können dann auf Echtzeit-Streaming umschalten, sobald sie den Rückstand aufgeholt haben.
Wie viel Speicherplatz bietet ein Archivknoten von „ Ethereum “?
Ein Archivknoten von „ Ethereum “ speichert etwa 12 TB oder mehr, während ein Vollknoten etwa 1 TB speichert. Der zusätzliche Speicherplatz dient zur Aufbewahrung aller historischen Zustands-Snapshots, weshalb der Betrieb der Archivinfrastruktur mit höheren Kosten verbunden ist.
