Antworten>Erfahren Sie mehr über Überwachung und Observability>Was ist Observability?
Was ist Observability?
// Tags
BeobachtbarkeitÜberwachung der Beobachtbarkeit
TL;DR: Observability ist die Fähigkeit, anhand der externen Ausgaben eines Systems zu verstehen, was in dessen Inneren vor sich geht. In der Blockchain-Infrastruktur bedeutet Observability, über die Metriken, Protokolle und Traces zu verfügen, die erforderlich sind, um Fragen wie „Warum ist meine DApp langsam?“, „Warum ist diese Transaktion fehlgeschlagen?“ und „Ist mein RPC- endpoint -Server in Ordnung?“ zu beantworten. Sie geht über die einfache Überwachung (die lediglich anzeigt, dass etwas nicht stimmt) hinaus, indem sie Ihnen die Daten liefert, mit denen Sie verstehen können, warum etwas nicht stimmt. Beobachtbarkeit ruht auf drei Säulen: Metriken (numerische Messwerte im Zeitverlauf), Protokolle (mit Zeitstempel versehene Ereignisaufzeichnungen) und Traces (End-to-End-Verlauf von Anfragen durch verteilte Systeme).
Die einfache Erklärung
Die Überwachung zeigt Ihnen an, dass die Motorwarnleuchte Ihres Autos leuchtet. Die Beobachtbarkeit gibt Aufschluss darüber, dass die Motorwarnleuchte leuchtet, weil der Lambdasensor in Zylinder 3 bei 2.500 U/min einen mageren Gemischzustand anzeigt – ein Problem, das nach dem Austausch des „ fuel “-Filters in der vergangenen Woche auftrat und dessen Muster mit einem bekannten Problem bei Aftermarket-Filtern übereinstimmt.
In der Softwareentwicklung versteht man unter Observability die Praxis, Systeme so umfassend mit Messinstrumenten auszustatten, dass sich jedes Problem diagnostizieren lässt, ohne dass es nachgestellt werden muss oder nachträglich neue Messinstrumente hinzugefügt werden müssen. Es ist nicht erforderlich, jeden möglichen Fehler mode im Voraus zu antizipieren. Es sind lediglich genügend Rohdaten (Metriken, Protokolle, Traces) erforderlich, damit bei einem unerwarteten Ereignis vom Symptom aus die Ursache zurückverfolgt werden kann.
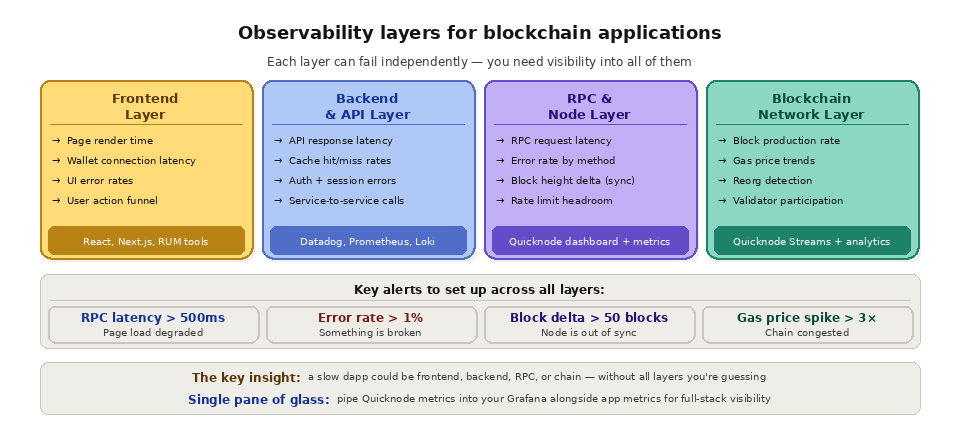
Bei Blockchain-Anwendungen ist Observability besonders wichtig, da die Systeme über mehrere Schichten verteilt sind: Ihr Frontend, Ihr Backend, Ihr RPC-Anbieter, der Blockchain-Knoten, das Konsensnetzwerk und die Blockchain selbst. Wenn ein Nutzer eine langsame Aktualisierung seines Kontostands feststellt, könnte dies an einer langsamen Frontend-Darstellung, einem Caching-Problem im Backend, einer RPC- endpoint -Latenz, einer Verzögerung bei der Knotensynchronisation oder einer Überlastung der Blockchain liegen. Ohne Observability über alle Schichten hinweg ist die Diagnose der tatsächlichen Ursache reine Spekulation.
Die drei Säulen der Observability
Kennzahlen
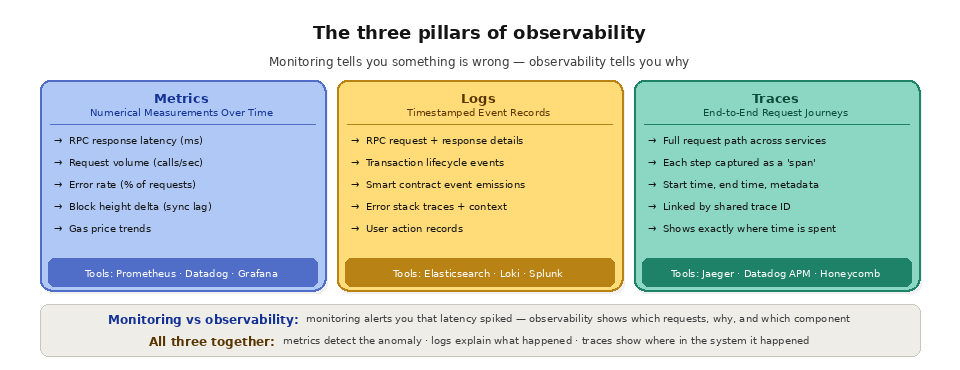
Metriken sind numerische Messwerte, die in regelmäßigen Abständen über einen bestimmten Zeitraum hinweg erfasst werden. Sie bilden die Grundlage für Dashboards und Warnmeldungen. In der Blockchain-Infrastruktur gehören zu den wichtigsten Metriken die RPC-Antwortlatenz (wie lange jeder API-Aufruf dauert), das Anforderungsvolumen (wie viele Aufrufe pro Sekunde Ihre Anwendung tätigt), die Fehlerquote (wie viel Prozent der Anfragen Fehler zurückgeben), das Blockhöhen-Delta (wie weit Ihr Knoten hinter der Kettenspitze zurückliegt), Gaspreis-Trends (aktuelle Höhe der Netzwerkgebühren) und die Transaktionsbestätigungszeit (wie lange es von der Übermittlung bis zur Aufnahme in einen Block dauert).
Metriken eignen sich am besten, um Trends zu erkennen und Anomalien aufzudecken. Ein plötzlicher Anstieg der RPC-Latenz, ein allmählicher Anstieg der Fehlerquote oder ein Rückgang des Anforderungsdurchsatzes sind allesamt Anzeichen dafür, dass sich etwas geändert hat. Metrik-Tools wie Prometheus, Datadog und Grafana erfassen, speichern und visualisieren Metriken im Zeitverlauf und ermöglichen so sowohl Echtzeit-Dashboards als auch historische Trendanalysen.
Die Stärke von Metriken liegt darin, dass sie ressourcenschonend und aggregiert sind, sodass sie mit hoher Frequenz erfasst werden können, ohne dass dabei enorme Datenmengen entstehen. Die Einschränkung besteht darin, dass Metriken zwar Aufschluss darüber geben, was geschieht, aber nicht, warum. Man weiß zwar, dass die Latenz gestiegen ist, aber man weiß nicht, welche konkreten Anfragen langsam waren oder was die Ursache dafür war.
Protokolle
Protokolle sind mit einem Zeitstempel versehene Aufzeichnungen einzelner Ereignisse. Jede wichtige Aktion Ihres Systems, jeder aufgetretene Fehler und jede getroffene Entscheidung kann als Protokolleintrag erfasst werden. In Blockchain-Anwendungen umfassen relevante Protokolle Details zu RPC-Anfragen und -Antworten (Methode, Parameter, Antwortzeit, Status), Ereignisse im Transaktionslebenszyklus (übermittelt, ausstehend, bestätigt, fehlgeschlagen), von Smart Contracts ausgelöste Ereignisse (dekodierte Ereignisdaten aus Ihren Verträgen), Fehlerdetails (Stack-Traces, Fehlercodes, Anfragekontext) sowie Benutzeraktionen (Wallet-Verbindungen, Transaktionsgenehmigungen, Seitennavigationen).
Protokolle eignen sich hervorragend, um die für die Diagnose bestimmter Vorfälle erforderlichen Details zu liefern. Wenn eine Metrik Sie darauf hinweist, dass die Fehlerraten sprunghaft angestiegen sind, geben Protokolle Aufschluss darüber, welche konkreten Fehler auftreten, welche Endpunkte betroffen sind und wie die Anfrageparameter lauteten. Tools zur Protokollanalyse wie Elasticsearch, Loki, Splunk und CloudWatch Logs ermöglichen das Durchsuchen, Filtern und Korrelieren von Protokolleinträgen über verschiedene Dienste und Zeiträume hinweg.
Der Nachteil von Protokollen ist ihr Umfang. Die detaillierte Protokollierung jedes RPC-Aufrufs, jedes Transaktionsereignisses und jeder Benutzeraktion erzeugt enorme Datenmengen. Die Kosten für die Speicherung von Protokollen können schnell steigen, und die Suche nach einem bestimmten Ereignis in Millionen von Protokolleinträgen erfordert effiziente Indizierungs- und Abfragewerkzeuge.
Spuren
Traces verfolgen den Weg einer einzelnen Anfrage durch ein verteiltes System von Anfang bis Ende. Wenn ein Benutzer einen Token-Tausch initiiert, erfasst der Trace jeden Schritt: die Verarbeitungszeit im Frontend, die Latenz des Backend-API-Aufrufs, die RPC-Anfrage an den Knoten, die Verarbeitungszeit des Knotens, die Übermittlung der Transaktion und die abschließende Blockbestätigung. Jeder Schritt wird als „Span“ mit Startzeit, Endzeit und Metadaten aufgezeichnet. Die Spans werden über eine Trace-ID miteinander verknüpft und ergeben so ein vollständiges Bild des Weges der Anfrage.
Traces sind für die Diagnose von Leistungsproblemen in verteilten Systemen unerlässlich.
komplexe Architekturen. Wenn eine Swap-Transaktion vom Klick des Benutzers bis zur Anzeige der Bestätigung 8 Sekunden dauert, zeigt eine Ablaufverfolgung, dass 200 ms auf die Frontend-Darstellung, 100 ms auf die Backend-Verarbeitung, 500 ms auf die RPC-Latenz, 12 Sekunden auf die On-Chain-Bestätigung (auf die Ihre Anwendung gewartet hat) und die verbleibende Zeit auf die Übermittlung von WebSocket-Ereignissen entfielen. Sie wissen nun genau, wo die Zeit verbraucht wurde und welche Komponente optimiert werden muss.
Verteilte Tracing-Tools wie Jaeger, Zipkin, Datadog APM und Honeycomb dienen dazu, Traces dienstübergreifend zu erfassen, zu speichern und zu visualisieren. Sie sind besonders wertvoll für Microservice-Architekturen, bei denen eine einzelne Benutzeranfrage mehrere Dienste, Datenbanken und externe APIs durchläuft.
Warum Observability für Blockchain-Anwendungen wichtig ist
Blockchain-Anwendungen sind naturgemäß über mehrere unabhängige Systeme verteilt: Ihre Infrastruktur, die Infrastruktur Ihres RPC-Anbieters und das Blockchain-Netzwerk selbst. Dadurch entsteht eine größere Anfälligkeit für Ausfälle und Leistungseinbußen als bei einer herkömmlichen Anwendung, die ausschließlich auf ihre eigenen Server und ihre eigene Datenbank angewiesen ist.
Probleme mit dem RPC- endpoint gehören zu den häufigsten Schwierigkeiten, mit denen Blockchain-Entwickler konfrontiert sind. Ein endpoint gibt möglicherweise veraltete Daten zurück (weil der zugrunde liegende Knoten bei der Synchronisierung im Rückstand ist), reagiert langsam (aufgrund der geografischen Entfernung oder der Auslastung) oder gibt Fehler zurück (aufgrund von Ratenbegrenzungen oder Knotenausfällen). Ohne Einblicke in Ihre RPC-Schicht bleiben diese Probleme unsichtbar, bis sich Nutzer beschweren.
On-Chain-Bedingungen wirken sich auf Ihre Anwendung aus, auch wenn Sie keinen Einfluss darauf haben. Eine Überlastung der Blockchain führt zu höheren Gasgebühren und längeren Bestätigungszeiten. Durch Blockreorganisationen können kürzlich bestätigte Transaktionen ungültig werden. Ausfälle von Validatoren auf kleineren Blockchains können zu Verzögerungen bei der Blockproduktion führen. Observability-Tools, die neben Ihren Anwendungsmetriken auch Metriken auf Blockchain-Ebene erfassen, verschaffen Ihnen einen umfassenden Überblick darüber, welche Faktoren sich auf Ihre Nutzer auswirken.
Was ist der Unterschied zwischen Observability und Monitoring?
Überwachung und Beobachtbarkeit sind miteinander verbunden, aber nicht austauschbar. Bei der Überwachung wird eine bekannte Reihe von Signalen beobachtet und gemeldet, wenn eines davon einen Schwellenwert überschreitet: Sie beantwortet die Frage „Stimmt etwas nicht?“. Beobachtbarkeit ist die umfassendere Fähigkeit, mithilfe umfangreicher Daten offene Fragen zu Ihrem System zu stellen, sodass Sie auch bei unerwarteten Ausfällen die Frage „Warum stimmt etwas nicht?“ beantworten können. Überwachung ist eine Untergruppe der Beobachtbarkeit; Sie benötigen Überwachung, um Probleme zu erkennen, und Beobachtbarkeit, um sie zu erklären.
Wie greifen Metriken, Protokolle und Traces ineinander?
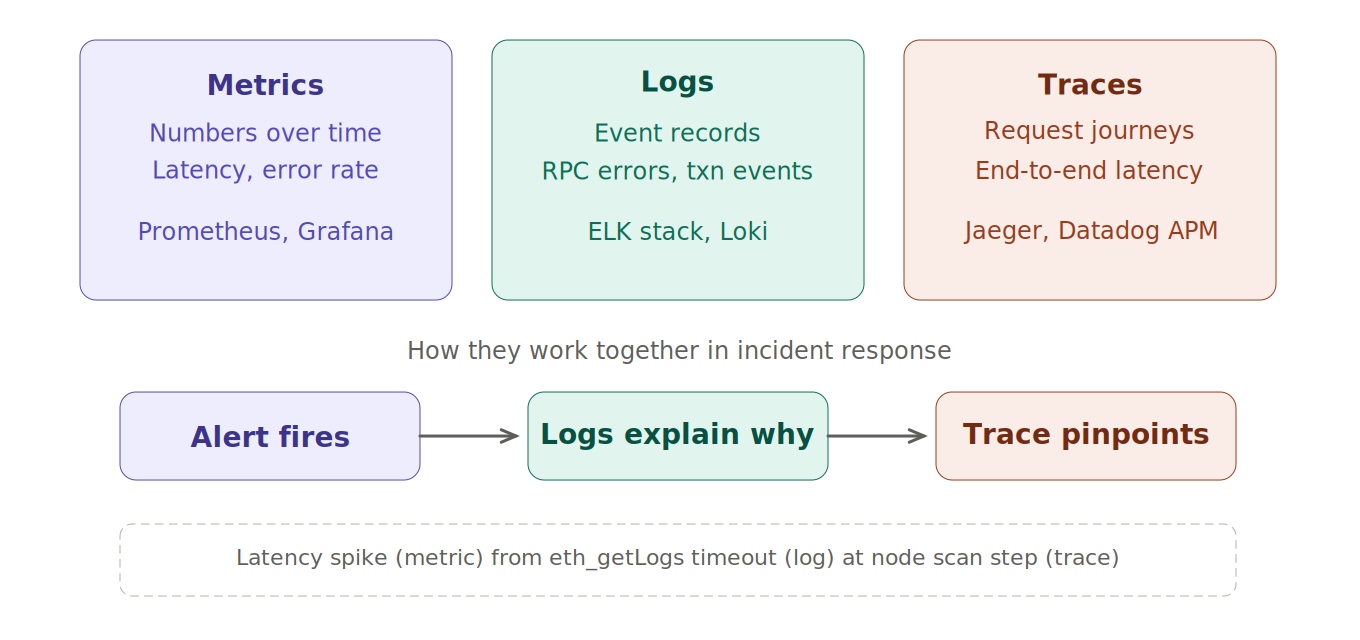
Die drei Säulen ergänzen sich gegenseitig und stehen nicht im Wettbewerb zueinander. Metriken zeigen an, dass sich etwas geändert hat, Protokolle geben Aufschluss darüber, was genau passiert ist, und Traces zeigen, an welcher Stelle einer verteilten Anfrage der Zeitablauf oder der Fehler aufgetreten ist. Ein gut funktionierendes Observability-Konzept nutzt alle drei Komponenten: Eine Metrik löst einen Alarm aus, ein Trace grenzt das Problem auf einen Dienst ein, und Protokolle decken den genauen Fehler auf. Die folgende Tabelle ordnet jede Säule der Frage zu, die sie am besten beantwortet.
Säule
Antworten
Beispiel für eine Blockchain
Gängige Werkzeuge
Kennzahlen
Was hat sich wann geändert?
Die RPC-Latenz stieg um 14:02 Uhr sprunghaft an
Prometheus, Grafana
Protokolle
Was genau ist passiert?
eth_call hat einen Timeout-Fehler zurückgegeben
Loki, Splunk
Spuren
Wofür wurde die Zeit verwendet?
500 ms innerhalb der RPC-Spanne
Jaeger, Datadog APM
Einen ausführlicheren Vergleich der Säulen finden Sie unter „Metriken vs. Protokolle vs. Traces“. Die Erfassung der RPC-Latenz als erstklassige Metrik ist eines der wertvollsten Signale für eine Blockchain-Anwendung.
Wie lässt sich die Blockchain-Infrastruktur transparent machen?
Beginnen Sie damit, die RPC-Schicht zu instrumentieren, da diese zwischen Ihrer App und der Blockchain liegt: Erfassen Sie das Anforderungsvolumen, Latenz-Perzentile und Fehlerraten pro Methode. Fügen Sie Zustandsprüfungen hinzu, die die Blockhöhe Ihres Knotens mit der Spitze der Blockchain vergleichen, damit Sie Synchronisationsverzögerungen frühzeitig erkennen können. Richten Sie dann Warnmeldungen für die Signale ein, die tatsächlich Probleme für die Nutzer vorhersagen, und legen Sie Wert auf Ausfallsicherheit, damit ein einzelner Ausfall Sie nicht blind macht. Kombinieren Sie Observability mit zuverlässigen Knoten, hoher Verfügbarkeit und einem getesteten Failover-Pfad, damit Sie bei einem Ausfall diesen sowohl erkennen als auch umgehen können.
Häufig gestellte Fragen
Ist Observability dasselbe wie Überwachung?
Nein. Bei der Überwachung werden vordefinierte Signale beobachtet und Sie werden benachrichtigt, wenn ein Schwellenwert überschritten wird, während die Beobachtbarkeit Ihnen genügend Daten liefert, um jedes Problem zu untersuchen, einschließlich unerwarteter Ausfälle. Die Überwachung ist ein Teil eines umfassenderen Konzepts der Beobachtbarkeit.
Was sind die drei Säulen der Observability?
Metriken, Protokolle und Traces. Metriken sind numerische Messwerte im Zeitverlauf, Protokolle sind mit Zeitstempeln versehene Aufzeichnungen einzelner Ereignisse, und Traces verfolgen eine einzelne Anfrage durch ein verteiltes System. Zusammen ermöglichen sie es Ihnen, Probleme zu erkennen, zu erklären und zu lokalisieren.
Warum ist die Beobachtbarkeit bei Blockchain-Anwendungen schwieriger?
Blockchain-Anwendungen erstrecken sich über Ihre eigene Infrastruktur, einen externen RPC-Anbieter und die Blockchain selbst, sodass Fehler in Schichten auftreten können, die sich Ihrer Kontrolle entziehen. Aufgrund dieser größeren Angriffsfläche benötigen Sie Transparenz über alle Schichten hinweg, einschließlich der Bedingungen auf Blockchain-Ebene wie Überlastung und Reorgs.
Welche Kennzahlen sind für die RPC-Infrastruktur am wichtigsten?
Antwortlatenz, Anfragemenge, Fehlerquote und die Veränderung der Blockhöhe sind die wichtigsten Kennzahlen. Latenz und Fehler geben Aufschluss über den Zustand der „ endpoint “, die Anfragemenge zeigt die Auslastung an, und die Veränderung der Blockhöhe gibt Auskunft darüber, ob der Knoten mit der Spitze der Blockchain Schritt hält.
Brauche ich für jede Säule ein eigenes Werkzeug?
Nicht unbedingt. Viele Plattformen decken mehr als eine Säule ab, und Anbieter stellen häufig RPC-Analysen und Metrik-Exporter zur Verfügung, die Sie in eine bestehende Infrastruktur integrieren können. Das Ziel ist eine einheitliche Transparenz über Anwendungs- und Blockchain-Ebenen hinweg und nicht eine bestimmte Anzahl von Tools.
Wie „ Quicknode “ die Observability unterstützt
Quicknode bietet integrierte Observability-Funktionen für die Blockchain-Infrastrukturebene. Das Dashboard „ Quicknode “ enthält Echtzeit-Analysen, die das Anforderungsvolumen, die Antwortlatenz, die Fehlerraten sowie Aufschlüsselungen auf Methodenebene für jeden endpoint anzeigen. Dadurch erhalten Entwickler sofort einen Überblick über ihre RPC-Nutzungsmuster, ohne eigene Überwachungsmaßnahmen implementieren zu müssen.
Für Teams mit bestehenden Observability- stacks: Die dedizierten Clusters von Quicknode unterstützen die Integration von Prometheus Exporter, sodass Sie Metriken auf Knotenebene direkt in Ihre Grafana-Dashboards, Datadog oder jedes andere Prometheus-kompatible Überwachungssystem einbinden können. Dies ermöglicht eine einheitliche Observability Ihrer Anwendungsinfrastruktur und Ihrer Blockchain-Infrastruktur über eine zentrale Oberfläche.
Quicknode Streams Erweitert die Beobachtbarkeit Ihrer Datenpipeline-Ebene und liefert für jeden Stream Informationen zum Übermittlungsstatus, Verarbeitungsmetriken sowie Fehlerberichte. In Kombination mit dem RPC-Analytics-Dashboard erhalten Entwickler so einen umfassenden Überblick sowohl über ihren Echtzeit-API-Zugriff als auch über die Erfassung ihrer Streaming-Daten.