TL;DR: Ein effektives Benachrichtigungssystem informiert die richtigen Personen zum richtigen Zeitpunkt über echte Probleme und liefert dabei genügend Kontext, um sofort Maßnahmen ergreifen zu können. Die wichtigsten Grundsätze lauten: Benachrichtigungen sollten sich auf Symptome (Auswirkungen für die Nutzer) statt auf Ursachen (interne Kennzahlen) beziehen, jede Benachrichtigung muss umsetzbar sein (wenn nichts zu tun ist, sollte es keine Benachrichtigung geben), Störsignale müssen konsequent reduziert werden (Benachrichtigungsmüdigkeit führt dazu, dass echte Vorfälle übersehen werden) und es muss Kontext bereitgestellt werden (was ist falsch, wie schlimm ist es, wer ist betroffen und was ist zu tun). Bei Blockchain-Anwendungen muss die Warnung zudem ketten-spezifische Zustände abdecken, wie z. B. Verzögerungen bei der Knotensynchronisation, Gaspreis-Spitzen, Verzögerungen bei der Transaktionsbestätigung und Block-Reorganisationen.
Die einfache Erklärung
Das Alerting bildet die Brücke zwischen Überwachungsdaten und menschlichem Handeln. Überwachungssysteme erfassen Tausende von Kennzahlen und Millionen von Protokolleinträgen. Das Alerting entscheidet, welche dieser Signale es wert sind, jemanden um 3 Uhr morgens aus dem Schlaf zu reißen. Wenn Sie es richtig machen, erkennt Ihr „ equipe “ Probleme, bevor die Benutzer sie bemerken. Wenn Sie es falsch machen, gehen entweder echte Vorfälle in einer Flut von Störsignalen unter (zu viele Alerts) oder kritische Probleme bleiben unentdeckt, bis die Benutzer lautstark protestieren (zu wenige Alerts).
Das Ziel eines gut abgestimmten Warnsystems ist, dass es keine Überraschungen gibt: Jedem Vorfall in der Produktion sollte eine Warnmeldung vorausgehen, und jede Warnmeldung sollte einem tatsächlichen (oder unmittelbar bevorstehenden) Vorfall vorausgehen. Warnmeldungen, die ohne ein entsprechendes Problem ausgelöst werden, führen dazu, dass Ihr „ equipe “ lernt, diese zu ignorieren. Probleme, die ohne vorherige Warnmeldung auftreten, deuten darauf hin, dass Ihre Überwachung Lücken aufweist.
Was ist der Unterschied zwischen Überwachung und Alarmierung?
Überwachung und Alarmierung sind miteinander verbunden, aber nicht identisch. Überwachung ist die kontinuierliche Erfassung von Metriken, Protokollen und Trace-Daten, die den Zustand Ihres Systems beschreiben. Alarmierung ist die darüberliegende Ebene, die entscheidet, welche dieser Signale eine menschliche Reaktion erfordern, und sie an die richtige Person weiterleitet. Man kann überwachen, ohne zu alarmieren, aber man kann nicht gut alarmieren, ohne dass eine solide Überwachung zugrunde liegt. Was die datenseitigen Aspekte dieses Themas betrifft, siehe „Überwachung der Blockchain-Infrastruktur“ und die allgemeinere Praxis der Blockchain-Beobachtbarkeit.
Achten Sie auf Symptome, nicht auf Ursachen
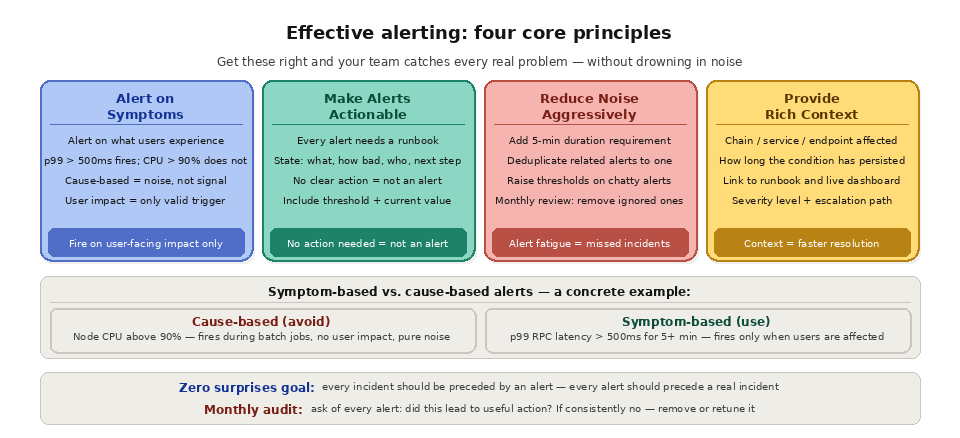
Das wichtigste Prinzip bei der Alarmierung besteht darin, eher auf Symptome (das, was die Benutzer wahrnehmen) als auf Ursachen (das, was intern geschieht) zu reagieren. Ein symptomorientierter Alarm wird ausgelöst, wenn aus Sicht des Benutzers ein Fehler vorliegt. Ein ursachenorientierter Alarm wird ausgelöst, wenn eine interne Kennzahl einen Schwellenwert überschreitet, unabhängig davon, ob Benutzer davon betroffen sind.
Eine ursachenbasierte Warnmeldung wie „CPU-Auslastung des Knotens über 90 %“ könnte während eines normalen Batch-Verarbeitungsauftrags ausgelöst werden, der zwar viel CPU-Leistung beansprucht, aber die Benutzererfahrung nicht beeinträchtigt. Diese Warnmeldung erzeugt „Lärm“ und untergräbt das Vertrauen in das Warnsystem. Eine symptombasierte Warnmeldung wie „p99-RPC-Antwortzeit seit mehr als 5 Minuten über 500 ms“ wird nur ausgelöst, wenn Benutzer tatsächlich langsame Antworten erleben – unabhängig davon, ob die Ursache eine hohe CPU-Auslastung, ein Synchronisationsproblem oder eine Netzwerküberlastung ist.
Das bedeutet nicht, dass Sie interne Kennzahlen niemals überwachen sollten. Interne Kennzahlen sind wertvoll für Dashboards, Trendanalysen und die Untersuchung von Vorfällen im Nachhinein. Sie sollten jedoch keine Benachrichtigungen auslösen, es sei denn, sie stehen in direktem Zusammenhang mit Auswirkungen auf die Nutzer. Reservieren Sie Warnmeldungen für Signale, die darauf hindeuten, dass für echte Nutzer etwas nicht funktioniert oder kurz davor ist, nicht mehr zu funktionieren.
Was ist der Unterschied zwischen symptom- und ursachenbasierten Warnmeldungen?
Symptombasierte Warnmeldungen werden aufgrund der Erfahrungen der Benutzer ausgelöst, während ursachenbasierte Warnmeldungen auf der Grundlage interner Kennzahlen ausgelöst werden, die sich auf die Benutzer auswirken können oder auch nicht. In der folgenden Tabelle werden die beiden Arten gegenübergestellt, damit Sie entscheiden können, bei welchen Signalen eine Benachrichtigung erfolgen soll und welche im Dashboard angezeigt bleiben sollen.
Aspekt | Symptombezogene Warnmeldung | Ursachenbezogene Warnmeldung |
|---|---|---|
Trigger aktiviert | Auswirkungen für die Nutzer | Interner Metrik-Schwellenwert |
Beispiel | S. 99: RPC-Latenz von über 500 ms über einen Zeitraum von 5 Minuten | CPU-Auslastung des Knotens über 90 % |
Risiko eines falsch-positiven Befunds | Niedrig | Hoch |
Am besten geeignet für |
Warnmeldungen umsetzbar machen
Für jede Warnmeldung sollte es eine klare, dokumentierte Vorgehensweise geben. Wenn eine Warnmeldung ausgelöst wird und die erste Reaktion des diensthabenden Technikers lautet: „Was soll ich jetzt tun?“, ist die Warnmeldung nicht umsetzbar.
Jede Warnmeldung sollte folgende Angaben enthalten: die Art des Problems (eine klare Beschreibung des Symptoms), quantitative Angaben (den überschrittenen Schwellenwert und den aktuellen Wert), den Umfang (welcher „ endpoint “, welche Kette oder welcher Dienst betroffen ist), die Dauer (wie lange der Zustand bereits besteht) sowie einen Link zu einem Runbook (eine Schritt-für-Schritt-Anleitung zur Diagnose und Behebung des Problems).
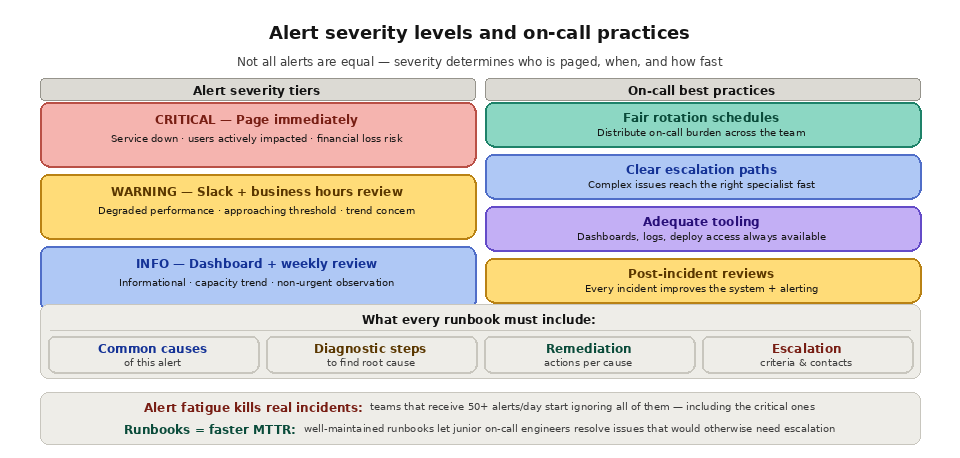
Runbooks sind eine unverzichtbare Dokumentation für jeden Alarm. Ein Runbook sollte den Einsatzmitarbeiter durch die häufigsten Ursachen des Alarms, die Diagnoseschritte zur Ermittlung der Grundursache, die Abhilfemaßnahmen für jede häufige Ursache sowie die Eskalationskriterien (wann jemand anderes hinzugezogen werden muss) führen. Gut gepflegte Runbooks verkürzen die Reaktionszeit bei Vorfällen erheblich und ermöglichen es auch weniger erfahrenen Mitgliedern des „ equipe “, ihre Bereitschaftsdienste effektiv zu bewältigen.
Reduzierung von Alarmgeräuschen
Alarmmüdigkeit ist die größte Bedrohung für ein effektives Alarmsystem. Wenn Teams täglich Dutzende von Alarmen erhalten, von denen die meisten Fehlalarme oder von geringer Priorität sind, fangen sie an, alle Alarme zu ignorieren – auch die kritischen.
Studien im Gesundheitswesen (wo Alarmmüdigkeit als anerkanntes Problem für die Patientensicherheit gilt) zeigen, dass bis zu 99 % der Alarme Fehlalarme sein können, was dazu führt, dass medizinisches Personal sie deaktiviert oder ignoriert.
Zu den Strategien zur Reduzierung von „Lärm“ gehören die Anhebung der Schwellenwerte für häufig ausgelöste, nicht umsetzbare Warnmeldungen, die Festlegung von Daueranforderungen (Warnmeldung erst dann auslösen, wenn der Zustand länger als 5 Minuten anhält, anstatt bei einem kurzzeitigen Anstieg), die Deduplizierung verwandter Warnmeldungen (wenn fünf Endpunkte desselben Anbieters alle langsam sind, wird eine Warnmeldung gesendet, nicht fünf), die Einführung von Schweregraden (kritische Warnmeldungen werden sofort weitergeleitet; Warnmeldungen werden an einen Slack-Kanal gesendet, um dort während der Geschäftszeiten geprüft zu werden) sowie die regelmäßige Überprüfung und Deaktivierung von Warnmeldungen, die durchgängig ignoriert oder ohne Maßnahmen behoben werden.
Eine sinnvolle Vorgehensweise besteht darin, jede im letzten Monat ausgelöste Warnmeldung zu überprüfen und zu fragen: „Hat diese Warnmeldung zu einer sinnvollen Maßnahme geführt?“ Wenn die Antwort durchweg „Nein“ lautet, sollte die Warnmeldung entfernt oder angepasst werden.
Blockchain-spezifische Benachrichtigungen
Blockchain-Anwendungen benötigen Warnmeldungen, die neben den üblichen Anwendungs- und Infrastrukturwarnungen auch Zustände auf Blockchain-Ebene abdecken.
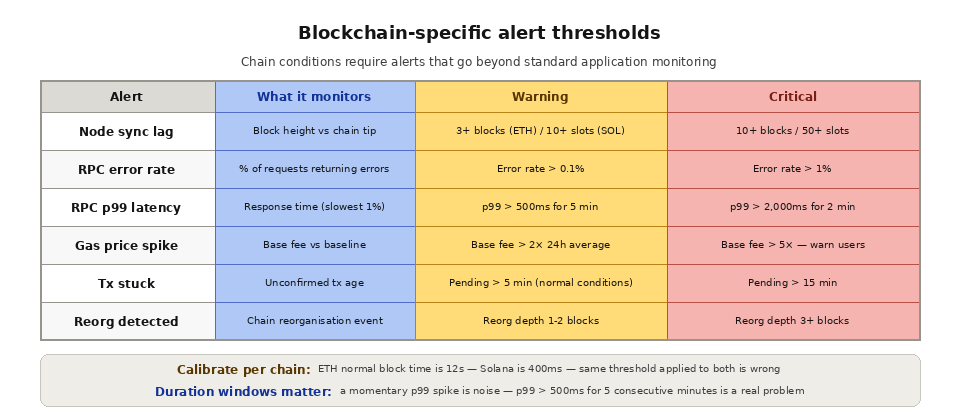
Bei einem Synchronisationsrückstand des Knotens sollte eine Warnmeldung ausgegeben werden, wenn Ihr Knoten (oder der Knoten Ihres Anbieters) mehr als eine konfigurierbare Anzahl von Blöcken hinter der Chain-Spitze zurückfällt. Für Ethereum wird bei einem Rückstand von 3 oder mehr Blöcken eine Warnmeldung ausgegeben. Für Solana wird bei einem Rückstand von 10 oder mehr Slots eine Warnmeldung ausgegeben. Ein Synchronisationsrückstand bedeutet, dass Ihre Anwendung veraltete Daten bereitstellt.
Gaspreis-Spitzen wirken sich auf jede Anwendung aus, die Transaktionen übermittelt. Lassen Sie sich benachrichtigen, wenn die Basisgebühr einen Schwellenwert überschreitet, ab dem Transaktionen für Ihren Anwendungsfall unwirtschaftlich teuer würden. Auf diese Weise kann Ihre Anwendung Nutzer warnen, nicht dringende Transaktionen verschieben oder Gas-Parameter proaktiv anpassen.
Warnmeldungen wegen „Transaction stuck“ werden ausgelöst, wenn eine übermittelte Transaktion nicht innerhalb eines erwarteten Zeitraums bestätigt wurde. Eine Transaktion, die unter normalen Bedingungen seit mehr als 10 Minuten auf Ethereum aussteht, weist wahrscheinlich einen unzureichenden Gaspreis auf und muss mit einer höheren Gebühr erneut übermittelt werden.
Warnmeldungen zur Reorg-Erkennung informieren Sie, wenn in einer Blockchain, auf die Ihre Anwendung angewiesen ist, eine Blockreorganisation stattfindet. Wenn Ihre Datenpipeline Blöcke am Ende der Blockchain verarbeitet, ohne auf die Finalität zu warten, bedeutet eine Reorg, dass kürzlich verarbeitete Daten möglicherweise fehlerhaft sind und korrigiert werden müssen.
Gesundheitswarnungen für Anbieter überwachen den Gesamtzustand Ihres RPC-Anbieters. Wenn die Fehlerraten Ihres Anbieters Ihren Schwellenwert überschreiten, sollte Ihre Anwendung darauf vorbereitet sein, auf einen Backup-Anbieter umzuschalten oder in einen Betriebs mode mit eingeschränkter Leistungsfähigkeit zu wechseln.
Bei welchen Blockchain-Bedingungen sollten Warnmeldungen ausgelöst werden?
Über die üblichen Infrastrukturwarnungen hinaus benötigen Blockchain-Anwendungen Warnmeldungen, die auf den Zustand der Blockchain abgestimmt sind. In der folgenden Tabelle sind gängige Bedingungen und Beispielschwellenwerte aufgeführt. Bedingungen wie Reorgs erfordern eine besondere Behandlung, auf die wir im Abschnitt „Was ist eine Blockchain-Reorg?“ eingehen, und Synchronisationsverzögerungen stehen in direktem Zusammenhang mit der Zuverlässigkeit der Knoten.
Zustand | Beispiel für einen Schwellenwert | Warum das wichtig ist |
|---|---|---|
Verzögerung bei der Knotensynchronisierung | 3 oder mehr Blöcke (Ethereum) oder 10 oder mehr Slots (Solana) | Sie stellen veraltete Daten bereit |
Gaspreisanstieg | Base Gebühr, die über Ihrer finanziellen Belastungsgrenze liegt | Transaktionen werden zu teuer |
Hängende Transaktion | Seit mehr als 10 Minuten in Bearbeitung | Wahrscheinlich unterbewertet und muss erneut eingereicht werden |
Bewährte Vorgehensweisen im Bereitschaftsdienst
Alarmierung ist nur dann wirksam, wenn jemand umgehend und kompetent auf die Alarme reagiert. Zur Etablierung einer gesunden Bereitschaftspraxis gehören faire Rotationspläne, die die Belastung auf das gesamte Team verteilen equipe, klare Eskalationswege, damit komplexe Probleme schnell den richtigen Spezialisten erreichen, angemessene Tools, damit der Bereitschaftstechniker sofortigen Zugriff auf Dashboards, Protokolle und Bereitstellungstools hat, Nachbesprechungen nach Vorfällen, die zu Verbesserungen sowohl am System als auch an der Alarmkonfiguration führen, sowie Vergütungs- oder Freistellungsrichtlinien, die die tatsächlichen Kosten des Bereitschaftsdienstes anerkennen.
Wie funktionieren Alarmierung und Hochverfügbarkeit zusammen?
Warnmeldungen informieren Sie, wenn etwas nicht funktioniert, während Hochverfügbarkeit dafür sorgt, dass der Dienst weiterläuft, während Sie Maßnahmen ergreifen. Beide Aspekte ergänzen sich gegenseitig: Warnmeldungen zum Zustand des Anbieters sind am nützlichsten, wenn Sie über ein Backup verfügen, das sofort einspringen kann. Kombinieren Sie Ihre Warnmeldungen mit einem Hochverfügbarkeitskonzept, automatisiertem Failover und einer redundanten Infrastruktur, die eine schnelle Reaktion ermöglicht.
Wie „ Quicknode “ eine effektive Alarmierung ermöglicht
QuicknodeDie integrierten Analysiefunktionen bilden die Metrikgrundlage für die Alarmierung in der Blockchain-Infrastruktur. Das Dashboard zeigt das Anfragemenge, die Antwortlatenz, die Fehlerraten sowie Aufschlüsselungen auf Methodenebene an, die zur Festlegung von Alarmschwellenwerten genutzt werden können. Für Teams mit einer benutzerdefinierten Alarmierungsinfrastruktur exportieren die „Dedicated Clusters “ von Quicknode Prometheus-kompatible Metriken, die sich direkt in Alertmanager, Grafana Alerts, PagerDuty oder jedes andere Alarmierungssystem in Ihrem Stack integrieren lassen.
Quicknode Streams bietet Kennzahlen zur Übermittlung, die Warnmeldungen bei Problemen in der Datenpipeline ermöglichen: fehlgeschlagene Übermittlungen, Verarbeitungsverzögerungen und Zielfehler. In Kombination mit Warnmeldungen auf RPC-Ebene erhalten Teams so einen umfassenden Überblick sowohl über ihren Echtzeit-API-Zugriff als auch über ihre Streaming-Dateninfrastruktur.
Weiterführende Literatur
Metriken vs. Protokolle vs. Traces – Quicknode Docs
Überwachung der Blockchain-Infrastruktur – Quicknode Glossar
Quicknode Core-API
Quicknode Dedicated Clusters
Häufig gestellte Fragen
Was macht eine Warnmeldung umsetzbar?
Eine Warnmeldung ist umsetzbar, wenn der Bearbeiter genau weiß, was zu tun ist. Sie sollte das Symptom, den überschrittenen Schwellenwert und den aktuellen Wert, den betroffenen Bereich, die Dauer des Zustands sowie einen Link zu einem Runbook mit Diagnose- und Behebungsmaßnahmen enthalten.
Was ist Alarmmüdigkeit?
Von „Alarmmüdigkeit“ spricht man, wenn ein „ equipe “ so viele Alarme erhält – insbesondere Fehlalarme –, dass er beginnt, alle Alarme zu ignorieren, auch die kritischen. Das Anheben von Schwellenwerten, das Festlegen von Zeitvorgaben, die Duplikatsbereinigung und die Verwendung von Schweregraden tragen dazu bei, dies zu verringern.
Sollten Sie bei der CPU-Auslastung eine Warnmeldung auslösen?
In der Regel nicht als Benachrichtigung. Die CPU-Auslastung ist eine ursachenbezogene Kennzahl, die im normalen Betrieb häufig Spitzenwerte erreicht, ohne dass dies Auswirkungen auf die Benutzer hat. Behalten Sie sie im Dashboard im Blick und lösen Sie stattdessen Benachrichtigungen bei benutzersichtbaren Symptomen wie erhöhten Fehlerraten oder Latenzzeiten aus.
Wie kann man auf Blockchain-Reorganisationen hinweisen?
Konfigurieren Sie die Erkennung von Reorgs für die Blockchains, auf die Sie angewiesen sind, und lassen Sie sich benachrichtigen, wenn ein Reorg tiefer liegt als die Anzahl der Bestätigungen, auf die Sie warten. Wenn Ihre Pipeline Blöcke an der Spitze verarbeitet, bedeutet ein Reorg, dass aktuelle Daten korrigiert werden müssen. Informationen zu damit verbundenen Risiken finden Sie unter „Häufige Ausfallmodi von Blockchains “.
Welche Schweregrade sollten Warnmeldungen haben?
Ein einfaches, effektives Modell umfasst zwei Stufen: Bei kritischen Warnmeldungen wird sofort ein Bereitschaftsdienst benachrichtigt, während Warnmeldungen an einen Kanal weitergeleitet werden, der während der Geschäftszeiten überprüft wird. So bleiben die Benachrichtigungen den Problemen vorbehalten, die wirklich eine dringende Reaktion durch einen Mitarbeiter erfordern.
