Antworten>Erfahren Sie mehr über Überwachung und Observability>Metriken vs. Protokolle vs. Traces
Metriken vs. Protokolle vs. Traces
// Tags
Metriken, Protokolle, TracesSäulen der Observability
TL;DR: Metriken, Protokolle und Traces sind die drei grundlegenden Datentypen der Observability, die jeweils einen eigenen Zweck beim Verständnis des Systemverhaltens erfüllen. Metriken sind aggregierte numerische Messwerte, die über einen bestimmten Zeitraum hinweg erfasst werden und sich ideal für Dashboards, Warnmeldungen und Trendanalysen eignen. Protokolle sind mit Zeitstempeln versehene Aufzeichnungen einzelner Ereignisse, die sich am besten zur Fehlerbehebung bei bestimmten Vorfällen und zur Führung von Prüfpfaden eignen. Traces verfolgen den gesamten Weg einer einzelnen Anfrage durch ein verteiltes System und zeigen auf, wo Zeit verbraucht wird und wo Engpässe auftreten. In der Praxis arbeiten alle drei zusammen: Eine Metrik löst eine Warnmeldung aus, Protokolle liefern die Fehlerdetails und ein Trace zeigt den vollständigen Kontext des fehlerhaften Anfragepfads. Eine effektive Observability für Blockchain-Anwendungen erfordert alle drei Säulen, da die verteilte Natur der Blockchain-Infrastruktur Fehlermodi erzeugt, die kein einzelner Datentyp allein diagnostizieren kann.
Die einfache Erklärung
Stellen Sie sich die Diagnose einer Erkrankung vor. Ihre Vitalparameter (Herzfrequenz, Blutdruck, Temperatur) sind Messwerte: Sie zeigen an, dass etwas nicht normal ist. Ihre Krankenakte und Ihre Untersuchungsergebnisse sind Protokolle: Sie liefern die konkreten Details dazu, was vor sich geht. Eine MRT- oder CT-Aufnahme ist eine Darstellung: Sie zeigt das vollständige Bild des Körperinneren, sodass der Arzt genau feststellen kann, wo das Problem liegt.
In der Blockchain-Infrastruktur stehen Sie vor derselben diagnostischen Herausforderung. Ihre Anwendung ist über Frontend, Backend, RPC-Endpunkte, Blockchain-Knoten und die Kette selbst verteilt. Jede Schicht kann unabhängig von den anderen ausfallen oder an Leistung einbüßen. Metriken zeigen Ihnen an, dass etwas nicht stimmt (Latenzsprung). Protokolle zeigen Ihnen, was schiefgelaufen ist (eine bestimmte RPC-Methode gibt Fehler zurück). Traces zeigen Ihnen, an welcher Stelle im Anforderungspfad das Problem entstanden ist (der Knoten benötigte 3 Sekunden, um einen eth_call für einen komplexen Vertrag zu verarbeiten).
Was ist der Unterschied zwischen Überwachung und Observability?
Überwachung und Beobachtbarkeit sind miteinander verbunden, aber nicht identisch. Bei der Überwachung werden bekannte Signale beobachtet und Sie werden benachrichtigt, wenn ein vordefinierter Schwellenwert überschritten wird. Beobachtbarkeit ist die umfassendere Fähigkeit, anhand der von Ihrem System generierten Daten neue Fragen zu stellen – selbst bei Problemen, mit denen Sie nicht gerechnet haben. Metriken, Protokolle und Traces sind die Grundbausteine der Beobachtbarkeit: Zusammen ermöglichen sie Ihnen den Schritt von „Irgendetwas stimmt nicht“ hin zu „Genau das ist der Grund dafür“. Eine ausführlichere Einführung finden Sie in unserer Übersicht über
Wie lassen sich Metriken, Protokolle und Traces miteinander vergleichen?
Jede Säule beantwortet eine andere Frage und ist mit unterschiedlichen Kosten verbunden. Die folgende Tabelle fasst zusammen, wann welche Säule in Frage kommt.
Dimension
Kennzahlen
Protokolle
Spuren
Datentyp
Gesamtzahlen
Ereignisse mit Zeitstempel
Verknüpfte Anforderungsspannen
Die beste Frage
Stimmt etwas nicht?
Was ist schiefgelaufen?
Wo ist es schiefgelaufen?
Lagerkosten
Niedrig
Hoch
Mittel, in der Regel Stichproben
Am besten geeignet für
Dashboards und Benachrichtigungen
Fehlerbehebung an der Ursache
Latenz- und Engpassanalyse
Beispiel-Tools
Prometheus, Grafana
ELK, Loki, Splunk
OpenTelemetry, Jaeger
Bei Blockchain-Systemen bauen diese Säulen auf einer umfassenderen Infrastrukturüberwachung auf, die den Zustand der Knoten, den Synchronisationsstatus und das RPC-Verhalten überwacht.
Kennzahlen im Detail
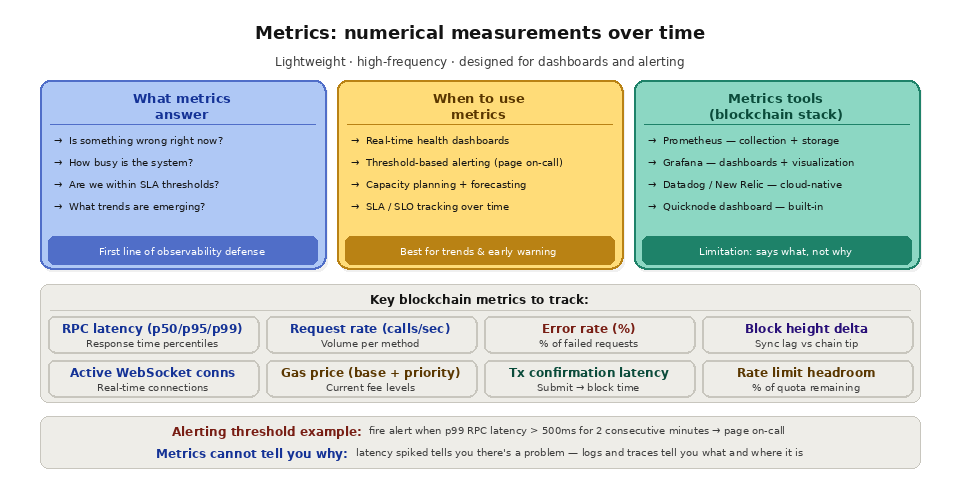
Metriken sind numerische Werte, die in regelmäßigen Abständen erfasst und über einen bestimmten Zeitraum aggregiert werden. Sie sind ressourcenschonend, lassen sich effizient speichern und sind für eine hochfrequente Erfassung ausgelegt. Eine typische Blockchain-Anwendung erfasst Metriken wie die RPC-Anfragefrequenz (Anfragen pro Sekunde nach Methode), die Antwortlatenz (p50, p95, p99-Perzentile), die Fehlerrate (Prozentsatz der Anfragen, die andere Statuscodes als 200 zurückgeben), das Blockhöhen-Delta (Differenz zwischen dem neuesten Block Ihres Knotens und der Kettenspitze), aktive WebSocket-Verbindungen, den Gaspreis (aktuelle Basis- und Prioritätsgebühren) sowie die Latenz bei der Transaktionsbestätigung.
Metriken sind die erste Verteidigungslinie bei der Observability. Sie bilden die Grundlage für Echtzeit-Dashboards, die auf einen Blick zeigen, ob Ihre Systeme einwandfrei funktionieren. Sie steuern Warnregeln, die Ihren Bereitschaftstechniker benachrichtigen, wenn ein Schwellenwert überschritten wird. Und sie ermöglichen die Kapazitätsplanung, indem sie langfristige Trends bei der Ressourcennutzung und den Datenverkehrsmustern aufzeigen.
Der Standard-Metrik-Stack im Blockchain-Ökosystem umfasst in der Regel Prometheus für die Erfassung und Speicherung, Grafana für die Visualisierung und die Erstellung von Dashboards sowie Alertmanager oder PagerDuty für die Weiterleitung von Warnmeldungen. Zu den cloud-nativen Alternativen zählen Datadog, New Relic und AWS CloudWatch. Alle diese Tools sind darauf ausgelegt, die großen Datenmengen und den Zeitreihenscharakter von Metrikdaten zu verarbeiten.
Die Einschränkung von Metriken liegt in ihrem aggregierten Charakter. Eine Metrik gibt zwar an, dass die p99-RPC-Latenz 500 ms überschritten hat, sagt jedoch nichts darüber aus, welche konkreten Anfragen langsam waren, welche Parameter sie hatten oder was der Knoten gerade tat, als es zu Verzögerungen kam. Für diese Detailtiefe benötigen Sie Protokolle und Traces.
Protokollaufzeichnungen im Detail
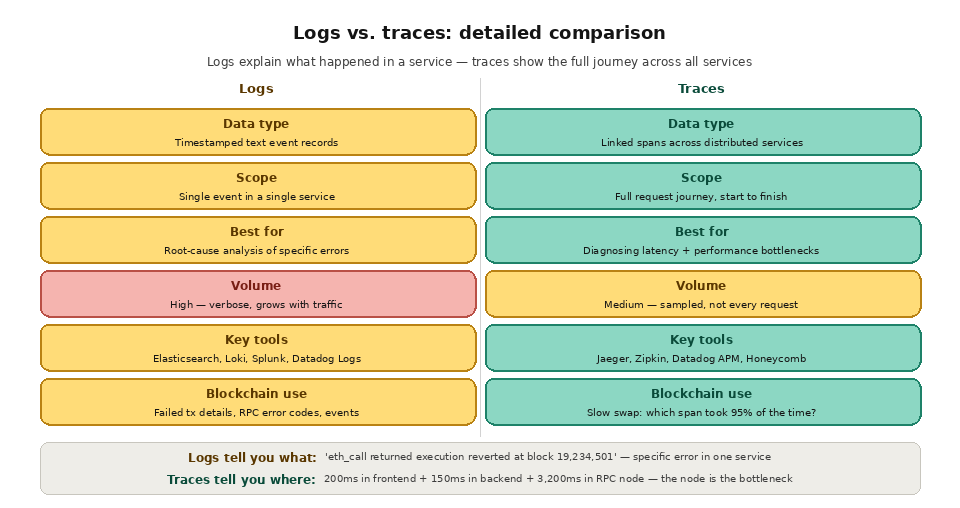
Protokolle sind mit einem Zeitstempel versehene Textaufzeichnungen einzelner Ereignisse. Jedes Mal, wenn Ihre Anwendung einen RPC-Aufruf tätigt, eine Transaktion verarbeitet, auf einen Fehler stößt oder eine Benutzeraktion bearbeitet, werden die Details in einem Protokolleintrag festgehalten. Im Gegensatz zu Metriken (bei denen es sich um über bestimmte Zeitintervalle aggregierte Zahlen handelt) sind Protokolle einzelne Datensätze mit umfangreichem Kontext: die vollständigen Anfrageparameter, die genaue Fehlermeldung, der Stack-Trace, die Benutzer-ID und der Transaktions-Hash.
Zu den wichtigen Protokollkategorien in Blockchain-Anwendungen zählen RPC-Anfrageprotokolle (Methode, Parameter, Antwortcode, Latenz pro Anfrage), Protokolle zum Transaktionslebenszyklus (Hash, Statusübergänge von „ausstehend“ über „bestätigt“ bis „abgeschlossen“), Ereignisprotokolle von Smart Contracts (dekodierte Ereignisse aus Ihren Verträgen mit vollständigen Parameterdaten), Fehlerprotokolle (RPC-Fehler, Timeout-Ausnahmen, Nonce-Konflikte, Fehler bei der Gas-Schätzung) sowie Anwendungsprotokolle (Benutzerauthentifizierungsereignisse, Entscheidungen der Geschäftslogik, Zustandsänderungen).
Protokolle sind das wichtigste Werkzeug für die Ursachenanalyse. Wenn eine Metrik Sie darauf hinweist, dass die Fehlerraten gestiegen sind, durchsuchen Sie Ihre Protokolle nach aktuellen Fehlerträgen, filtern nach Fehlertyp und erkennen das Muster. Möglicherweise gibt eine bestimmte RPC-Methode nun Fehler vom Typ „fehlender Trie-Knoten“ zurück, weil der Knoten Statusdaten bereinigt hat. Möglicherweise schlagen Transaktionsübermittlungen aufgrund von Nonce-Konflikten fehl, die durch einen Fehler bei der parallelen Verarbeitung verursacht werden. Die Protokolle enthalten die Details, die die Metriken nicht liefern können.
Zu den Tools für das Log-Management zählen Elasticsearch mit Kibana (der „ELK-Stack“), Grafana Loki, Splunk, Datadog Logs und AWS CloudWatch Logs. Diese Tools speichern, indizieren und durchsuchen Log-Einträge in großem Umfang und ermöglichen dabei Volltextsuche, strukturierte Abfragen sowie die Korrelation zwischen verschiedenen Diensten.
Der Nachteil von Protokollen liegt im Speicherbedarf und in den Kosten. Die Protokollierung jeder RPC-Anfrage bei einer Anwendung mit hohem Datenaufkommen erzeugt täglich Gigabyte an Daten. Strukturierte Protokollierung (bei der Protokolleinträge als JSON mit einheitlichen Feldnamen formatiert sind) ermöglicht eine effizientere Indizierung und Abfrage als unstrukturierte Textprotokolle, und durch Protokoll-Sampling (die Aufzeichnung nur eines Bruchteils der Routineereignisse) lässt sich das Datenvolumen reduzieren, ohne dass der Überblick über Fehler und Anomalien verloren geht.
Spuren im Detail
Traces erfassen den gesamten Verlauf einer einzelnen Anfrage durch ein verteiltes System. Ein Trace besteht aus mehreren Spans, von denen jeder eine Arbeitseinheit in einem bestimmten Dienst darstellt. Spans sind hierarchisch verschachtelt (ein übergeordneter Span für die gesamte Anfrage, untergeordnete Spans für jede Teiloperation) und durch eine gemeinsame Trace-ID miteinander verknüpft.
Bei einer Blockchain-Anwendung könnte ein einzelner Trace die folgenden Spans erfassen: Der Benutzer klickt im Browser auf „Swap“ (Frontend-Span, 50 ms), das Frontend sendet eine API-Anfrage an das Backend (Netzwerk-Span, 20 ms), das Backend ruft die RPC-Adresse endpoint zur Gas-Schätzung auf (RPC-Span, 150 ms), das Backend ruft den RPC endpoint zur Transaktionsübermittlung auf (RPC-Span, 200 ms), das Backend fragt nach dem Transaktionsbeleg ab (mehrere RPC-Spans, insgesamt 12.000 ms), das Backend sendet eine Bestätigung an das Frontend (Netzwerk-Span, 15 ms) und das Frontend aktualisiert die Benutzeroberfläche (Frontend-Span, 30 ms). Die Ablaufverfolgung zeigt, dass 95 % der Gesamtzeit mit dem Warten auf die On-Chain-Bestätigung verbracht wurden und nicht mit der Ausführung des anwendungsspezifischen Codes.
Die verteilte Ablaufverfolgung wird dadurch umgesetzt, dass in jede Anfrage, die Ihr System durchläuft, ein Ablaufverfolgungskontext (eine Trace-ID und eine Span-ID) eingefügt wird. Jeder Dienst erstellt Spans für seine eigenen Vorgänge und gibt den Ablaufverfolgungskontext an nachgelagerte Dienste weiter. Ablaufverfolgungsbibliotheken wie OpenTelemetry bieten standardisierte Instrumentierungsfunktionen für die meisten Programmiersprachen und Frameworks. Visualisierungstools wie Jaeger, Zipkin und Datadog APM stellen Traces als Wasserfall-Diagramme dar, die den zeitlichen Ablauf und die Verschachtelung jeder Span zeigen.
Traces sind besonders wertvoll für die Diagnose von Latenzproblemen in verteilten Architekturen. Wenn ein Benutzer meldet, dass die Bestätigung einer Transaktion 30 Sekunden gedauert hat, zeigt ein Trace genau, wofür diese 30 Sekunden benötigt wurden: 25 Sekunden Wartezeit auf die Aufnahme in einen Block, 3 Sekunden für RPC-Aufrufe, 1,5 Sekunden für die Backend-Verarbeitung und 500 ms für die Frontend-Darstellung. Sie wissen sofort, dass eine Optimierung Ihres Backend-Codes nicht helfen wird; der Engpass liegt in der Bestätigungszeit auf Kettenebene.
Alle drei zusammen verwenden
Die drei Säulen ergänzen sich gegenseitig und stehen nicht in Konkurrenz zueinander. Ein typischer Workflow zur Reaktion auf Vorfälle nutzt alle drei.
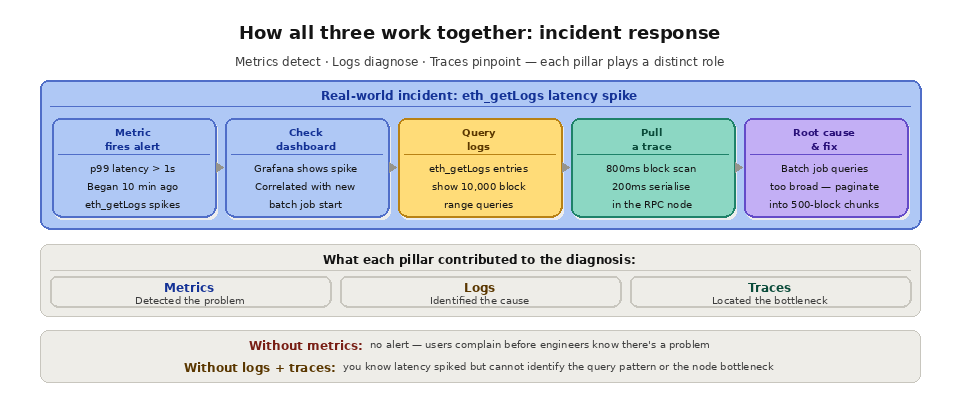
Ein Metrik-Alarm wird ausgelöst: Die p99-RPC-Latenz hat 1 Sekunde überschritten. Sie öffnen Ihr Grafana-Dashboard und stellen fest, dass der Latenzanstieg vor 10 Minuten begann und mit einem Anstieg der eth_getLogs-Aufrufe zusammenhängt. Sie durchsuchen Ihre Protokolle nach aktuellen eth_getLogs-Anfragen und stellen fest, dass zur gleichen Zeit ein neuer Batch-Job gestartet wurde, der umfangreiche Protokollabfragen durchführt, die jeweils 10.000 Blöcke umfassen. Sie rufen einen Trace für eine dieser Anfragen ab und stellen fest, dass der RPC-Knoten 800 ms für das Scannen der Blöcke und 200 ms für die Serialisierung der Antwort benötigt hat. Die Ursache ist klar: Die übermäßig umfangreichen Log-Abfragen des Batch-Jobs beanspruchen unverhältnismäßig viele Ressourcen des Knotens. Die Lösung besteht darin, die Abfragen in kleinere Blockbereiche zu unterteilen.
Ohne Metriken würden Sie erst dann von einem Problem erfahren, wenn sich Nutzer beschweren. Ohne Protokolle würden Sie zwar wissen, dass die Latenz gestiegen ist, aber nicht, welche Anfragen dafür verantwortlich sind. Ohne Traces würden Sie zwar wissen, dass „eth_getLogs“ langsam ist, aber nicht, ob der Engpass in Ihrer Anwendung, im Netzwerk oder beim Blockscan des Knotens liegt.
Mit welcher Säule sollten Sie beginnen?
Wenn Sie die Observability schrittweise aufbauen möchten, beginnen Sie mit Metriken, da deren Erfassung kostengünstig ist und Probleme über Dashboards und Warnmeldungen sofort sichtbar werden. Fügen Sie als Nächstes strukturierte Protokolle hinzu, damit Sie die durch die Metriken aufgedeckten Probleme untersuchen können. Führen Sie verteiltes Tracing ein, sobald Ihr System mehrere Dienste umfasst und Sie genau ermitteln müssen, wo sich Latenz aufstaut. Speziell bei Blockchain deckt die Kombination mit der RPC-Latenzüberwachung die Ebene ab, die Sie im Produktivbetrieb am ehesten überraschen wird.
Wie „ Quicknode “ alle drei Säulen unterstützt
QuicknodeDas Dashboard bietet integrierte Kennzahlen für jeden endpoint: Anfragevolumen, Antwortlatenz, Fehlerraten sowie Aufschlüsselungen auf Methodenebene. Diese Kennzahlen ermöglichen Entwicklern einen sofortigen Einblick in ihre Blockchain-Infrastruktur, ohne dass eine benutzerdefinierte Instrumentierung erforderlich ist.
Für Teams, die Blockchain-Metriken in ihren bestehenden Observability-Stack integrieren, unterstützen die dedizierten „ Clusters “ von Quicknode den Prometheus Exporter und ermöglichen so die direkte Erfassung von Metriken auf Knotenebene in Prometheus, Grafana, Datadog oder jedes andere kompatible System. Dies ermöglicht ein einheitliches Dashboard für Anwendungsmetriken und Metriken der Blockchain-Infrastruktur.
Quicknode Streams bietet Transparenz hinsichtlich des Zustands der Datenpipeline, einschließlich Übertragungskennzahlen, Verarbeitungsstatus und Fehlerberichten. In Kombination mit RPC-Analysen und Ihrer eigenen Protokollierung und Ablaufverfolgung auf Anwendungsebene bietet „ Quicknode “ Entwicklern den umfassenden Überblick, den sie benötigen, um Probleme auf allen Ebenen des Blockchain-Stacks zu diagnostizieren und zu beheben.
Häufig gestellte Fragen
Sind Metriken, Protokolle und Traces dasselbe wie Überwachung?
Nein. Das sind die zugrunde liegenden Datentypen. Bei der Überwachung werden vordefinierte Signale beobachtet und bei Abweichungen Warnmeldungen ausgegeben, während die Observability diese drei Datentypen nutzt, um Probleme zu untersuchen, die man nicht im Voraus vorhergesehen hat.
Welches der drei Produkte ist am teuersten in der Lagerung?
Logs sind in der Regel am teuersten, da sie jedes einzelne Ereignis mit allen Details aufzeichnen. Metriken sind dank der Aggregation am günstigsten, und Traces liegen dazwischen, da sie in der Regel nur stichprobenartig erfasst und nicht bei jeder Anfrage vollständig aufgezeichnet werden.
Brauche ich alle drei für eine kleine Anwendung?
Nicht von Anfang an. Die meisten Teams beginnen mit Metriken und einfachen Protokollen. Verteiltes Tracing lohnt sich erst dann, wenn Anfragen mehrere Dienste durchlaufen und sich die Latenz nur schwer einer einzelnen Komponente zuordnen lässt.
Was ist OpenTelemetry?
OpenTelemetry ist ein offener Standard und eine Sammlung von Bibliotheken zur herstellerunabhängigen Erfassung von Metriken, Protokollen und Traces. Damit können Sie die Instrumentierung einmalig vornehmen und die Daten an zahlreiche Backends wie Prometheus, Jaeger oder Datadog exportieren.
Inwiefern gilt dies konkret für Blockchain-RPC?
RPC-Aufrufe sind eine häufige Ursache für Latenz und Fehler. Daher verschafft Ihnen die Erfassung von Kennzahlen wie Anforderungsrate, Latenz-Perzentilen und Fehlercodes, die Protokollierung fehlgeschlagener Aufrufe sowie die End-to-End-Verfolgung langsamer Anfragen einen umfassenden Überblick. Eine zuverlässige Node-Infrastruktur, die in unserem Leitfaden zur Node-Zuverlässigkeit behandelt wird, reduziert die Anzahl der Vorfälle, die Sie überhaupt erst diagnostizieren müssen.