🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る SOC 2 タイプ II 認証取得・ISO 27001
回答>信頼性 と稼働時間について>フェイルオーバーとは何ですか? // Tags
フェイルオーバー自動フェイルオーバー
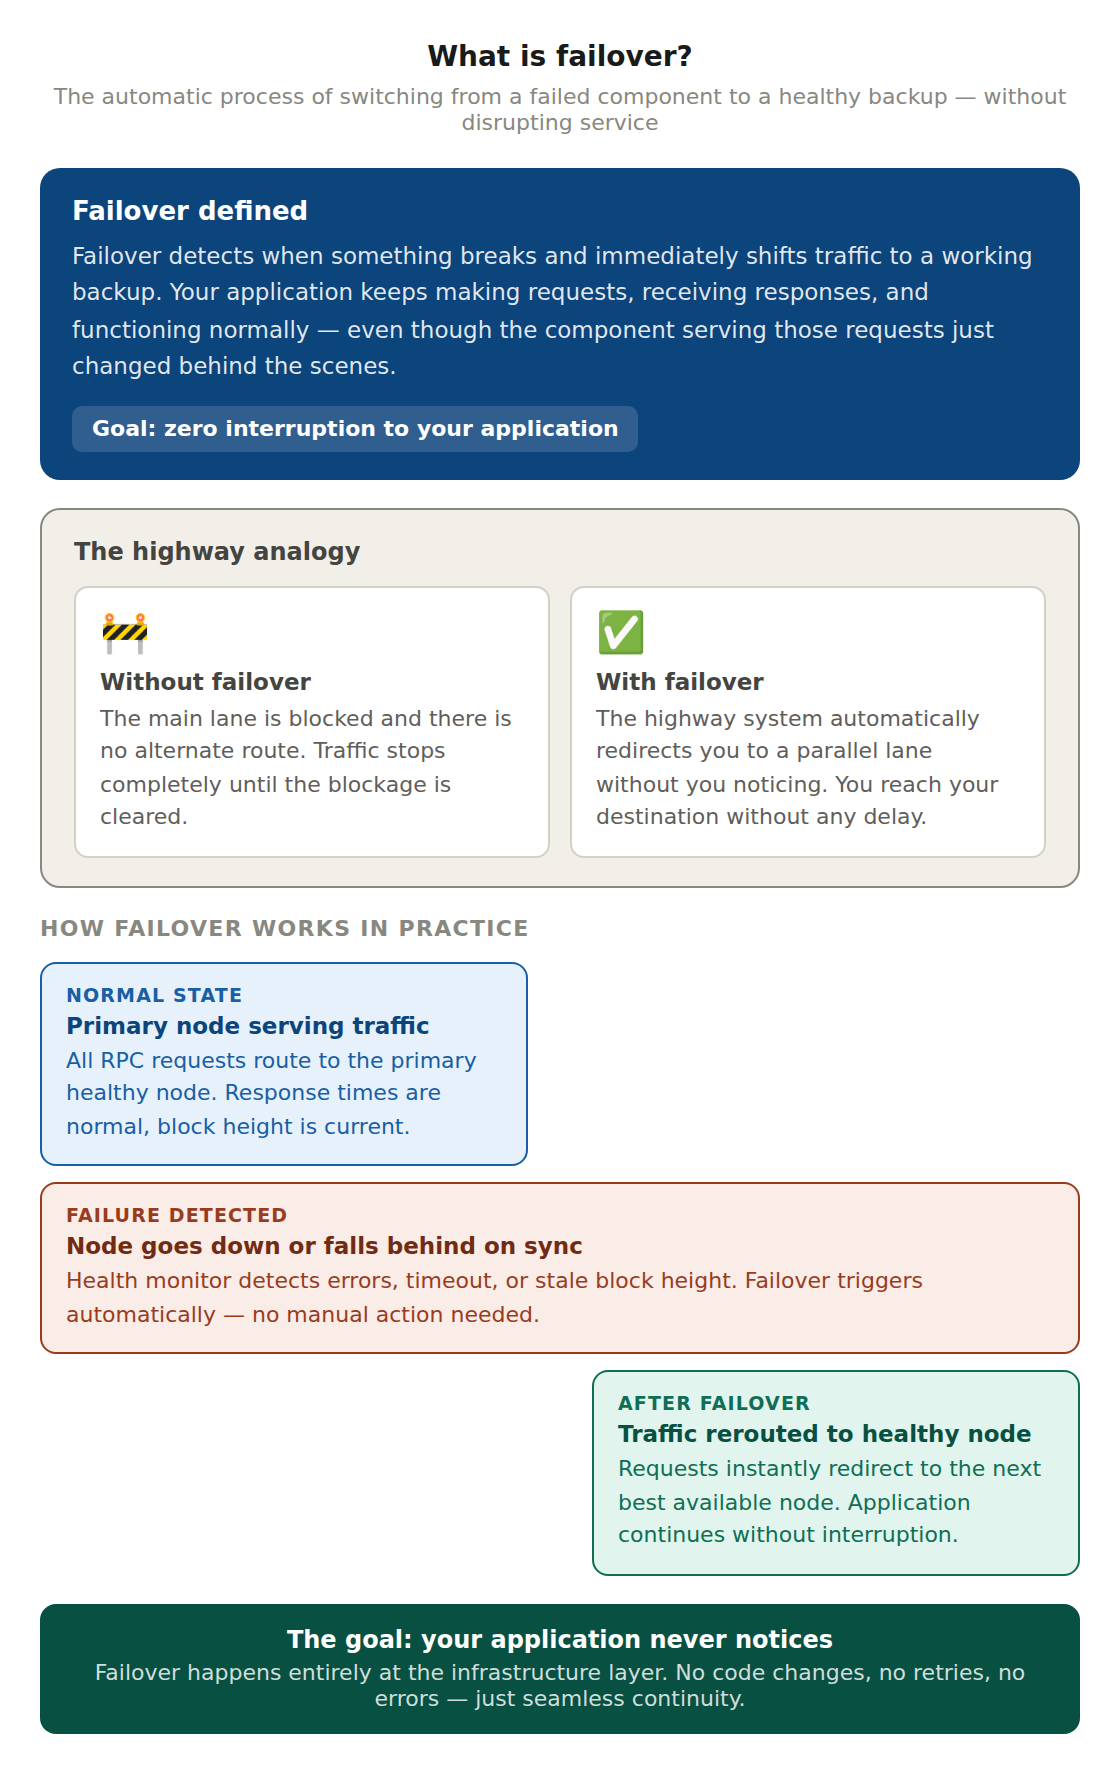
要約:フェイルオーバーとは、 サービスを中断させることなく、障害が発生したコンポーネントから正常なバックアップへ自動的に切り替えるプロセスです。 ブロックチェーン インフラストラクチャにおいて、フェイルオーバーにより、ノード、サーバー、またはデータセンターがダウンした場合でも、アプリケーションのRPCリクエストが別の正常に動作している エンドポイント。
基本概念
高速道路を走行中に、メインの車線が突然通行止めになったと想像してみてください。迂回路がなければ、その場から動けなくなってしまいます。しかし、ドライバーが気づかないうちに、高速道路システムが自動的に並行する車線へ迂回させてくれるなら、それこそがフェイルオーバーの実例です。
インフラの観点から言えば、フェイルオーバーとは、何らかの障害が発生したことを検知し、直ちにトラフィックをバックアップに切り替える仕組みのことです。その目的は、中断をゼロ(あるいはnear ゼロ)にすることです。リクエストを処理していたコンポーネントが裏側で切り替わったとしても、アプリケーションは引き続きリクエストを送信し、レスポンスを受け取り、通常通り動作し続けます。
ブロックチェーン インフラストラクチャにおけるフェイルオーバーの仕組み
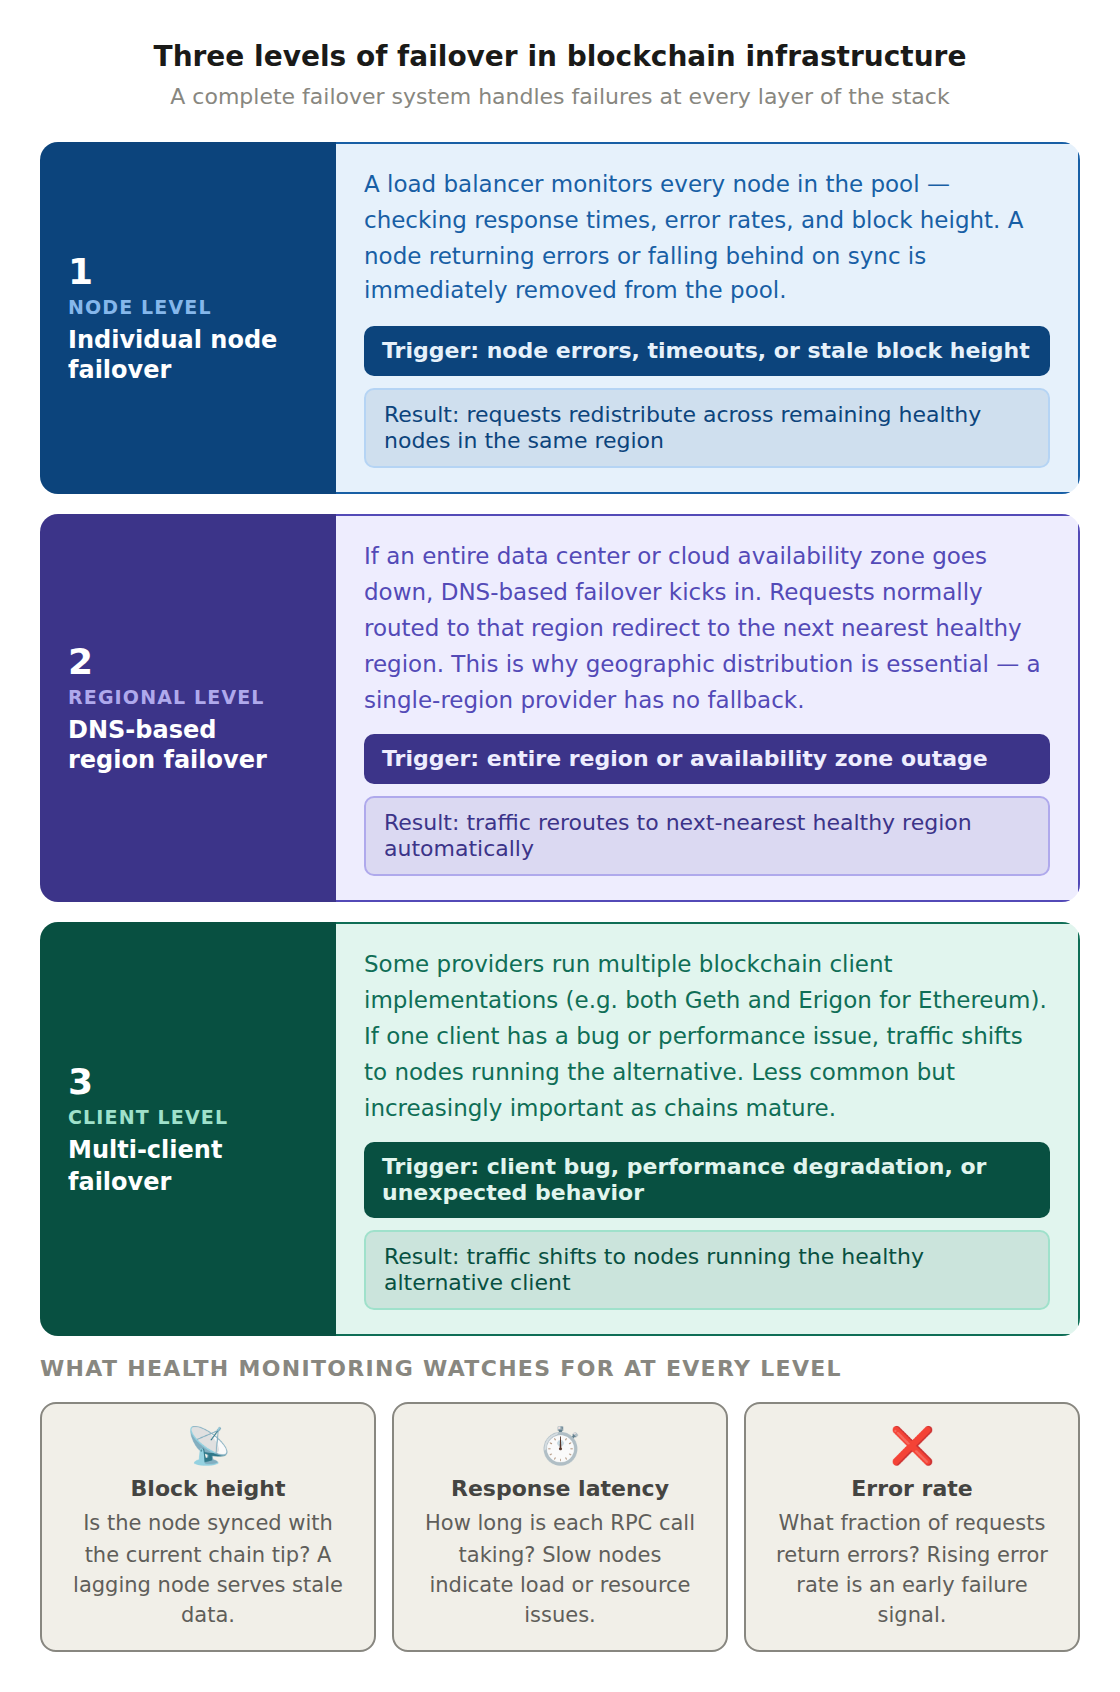
ブロックチェーン インフラストラクチャには、障害が発生する可能性のある特定のコンポーネント群があります。最も一般的なのは、個々のノード、リージョンやデータセンター全体、そして特定のブロックチェーン クライアントの実装です。優れたフェイルオーバーシステムは、これら3つすべてに対応しています。
ノードレベルでは、フェイルオーバーは比較的単純です。ロードバランサーは、プール内のすべてのノードの健全性を継続的に監視し、応答時間、エラー率、ブロック高を確認します。あるノードがエラーを返すようになったり、同期に遅れが生じたりした場合、ロードバランサーはそのノードへのトラフィックの送信を停止し、残りの正常なノードにリクエストを分散させます。
リージョンレベルになると、事態はさらに興味深いものになります。データセンター全体やクラウドの可用性ゾーンで障害が発生した場合、DNS ベースのフェイルオーバーが作動します。通常はそのリージョンにルーティングされるリクエストは、自動的に次に近い正常なリージョンにリダイレクトされます。これが、地理的な分散が重要である理由です。1つのリージョンでのみノードを運用しているプロバイダーの場合、そのリージョンがダウンした際に代替手段がありません。
クライアントレベルでは、一部のプロバイダーが複数のブロックチェーン クライアント実装を稼働させています(例えば、Ethereum ではGethとErigonの両方を稼働させています)。あるクライアント実装にバグやパフォーマンス上の問題が発生した場合、トラフィックは代替クライアントを実行しているノードへと移行することができます。この種の冗長性はそれほど一般的ではありませんが、その重要性はますます高まっています。
アクティブ・フェイルオーバーとパッシブ・フェイルオーバー
フェイルオーバーには大きく分けて2つのアプローチがあり、この違いはパフォーマンスに重要な影響を及ぼします。
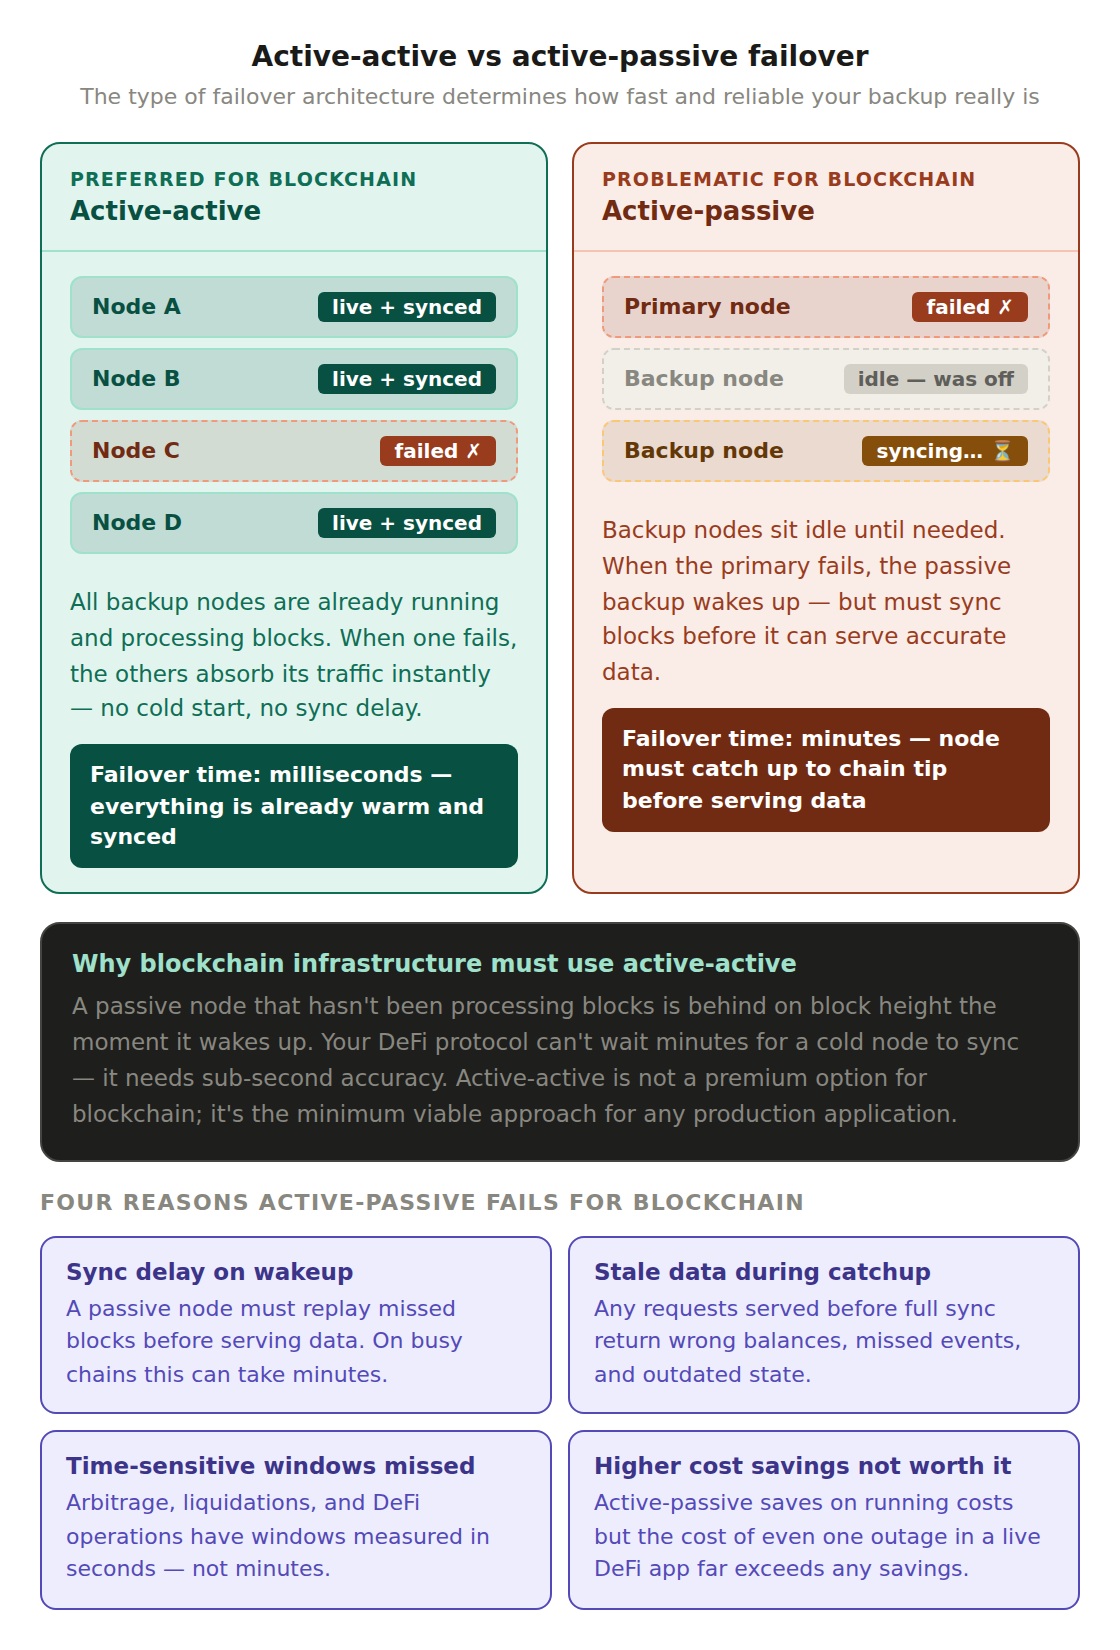
アクティブ・アクティブ構成では、すべてのバックアップコンポーネントがすでに稼働しており、トラフィックを処理しています。いずれかが障害を起こしても、他のコンポーネントがその分担していた負荷を引き継ぐだけです。すべてがすでに稼働状態にあるため、「コールドスタート」による遅延は発生しません。ブロックチェーン インフラストラクチャでは、ノードがチェーンとの同期を維持する必要があるため、このモデルが推奨されます。ブロックの処理を積極的に行っていないノードは、ブロック高で遅れをとってしまい、追いつくまでは機能しません。
アクティブ・パッシブ構成では、バックアップコンポーネントは必要な時まで待機状態にあります。プライマリに障害が発生すると、パッシブなバックアップが起動して処理を引き継ぎます。この方式は運用コストが安くなりますが、遅延が生じます。ブロックチェーン ノードの場合、パッシブノードが正確なデータを提供できるようになる前にブロックの同期を行う必要があるため、この遅延は大きなものになる可能性があります。
まさにこの理由から、実稼働環境のブロックチェーン インフラのほとんどは、アクティブ・アクティブ・フェイルオーバーを採用しています。DeFiプロトコルが1秒未満のデータ精度を必要とする場合、コールドノードが追いつくのを待っている余裕はないからです。
以下の表は、ブロックチェーン のワークロードにおける2つのフェイルオーバーモデルの比較をまとめたものです:
アスペクト | アクティブ-アクティブ | 能動・受動 |
|---|
バックアップ状態 | すべてのノードが稼働しており、トラフィックを処理しています | スタンバイノードは、必要になるまで待機状態のままです |
フェイルオーバーの遅延 | Near ゼロ、コールドスタートなし | 注目すべき点として、バックアップはウォームアップと同期を行う必要があります |
運営コスト | より高いプランでは、フル容量分の料金をお支払いいただきます | 低消費電力モードでは、リソースの使用量が少なくなります |
ブロック高さの同期 | 常に最新の状態 | 遅れが生じたり、遅れを取り戻す必要が生じたりする場合があります |
こんな方に最適 | 本番環境のRPCおよびリアルタイムデータ | コスト重視または重要度の低いワークロード |
フェイルオーバーが不可欠である理由ブロックチェーン アプリ
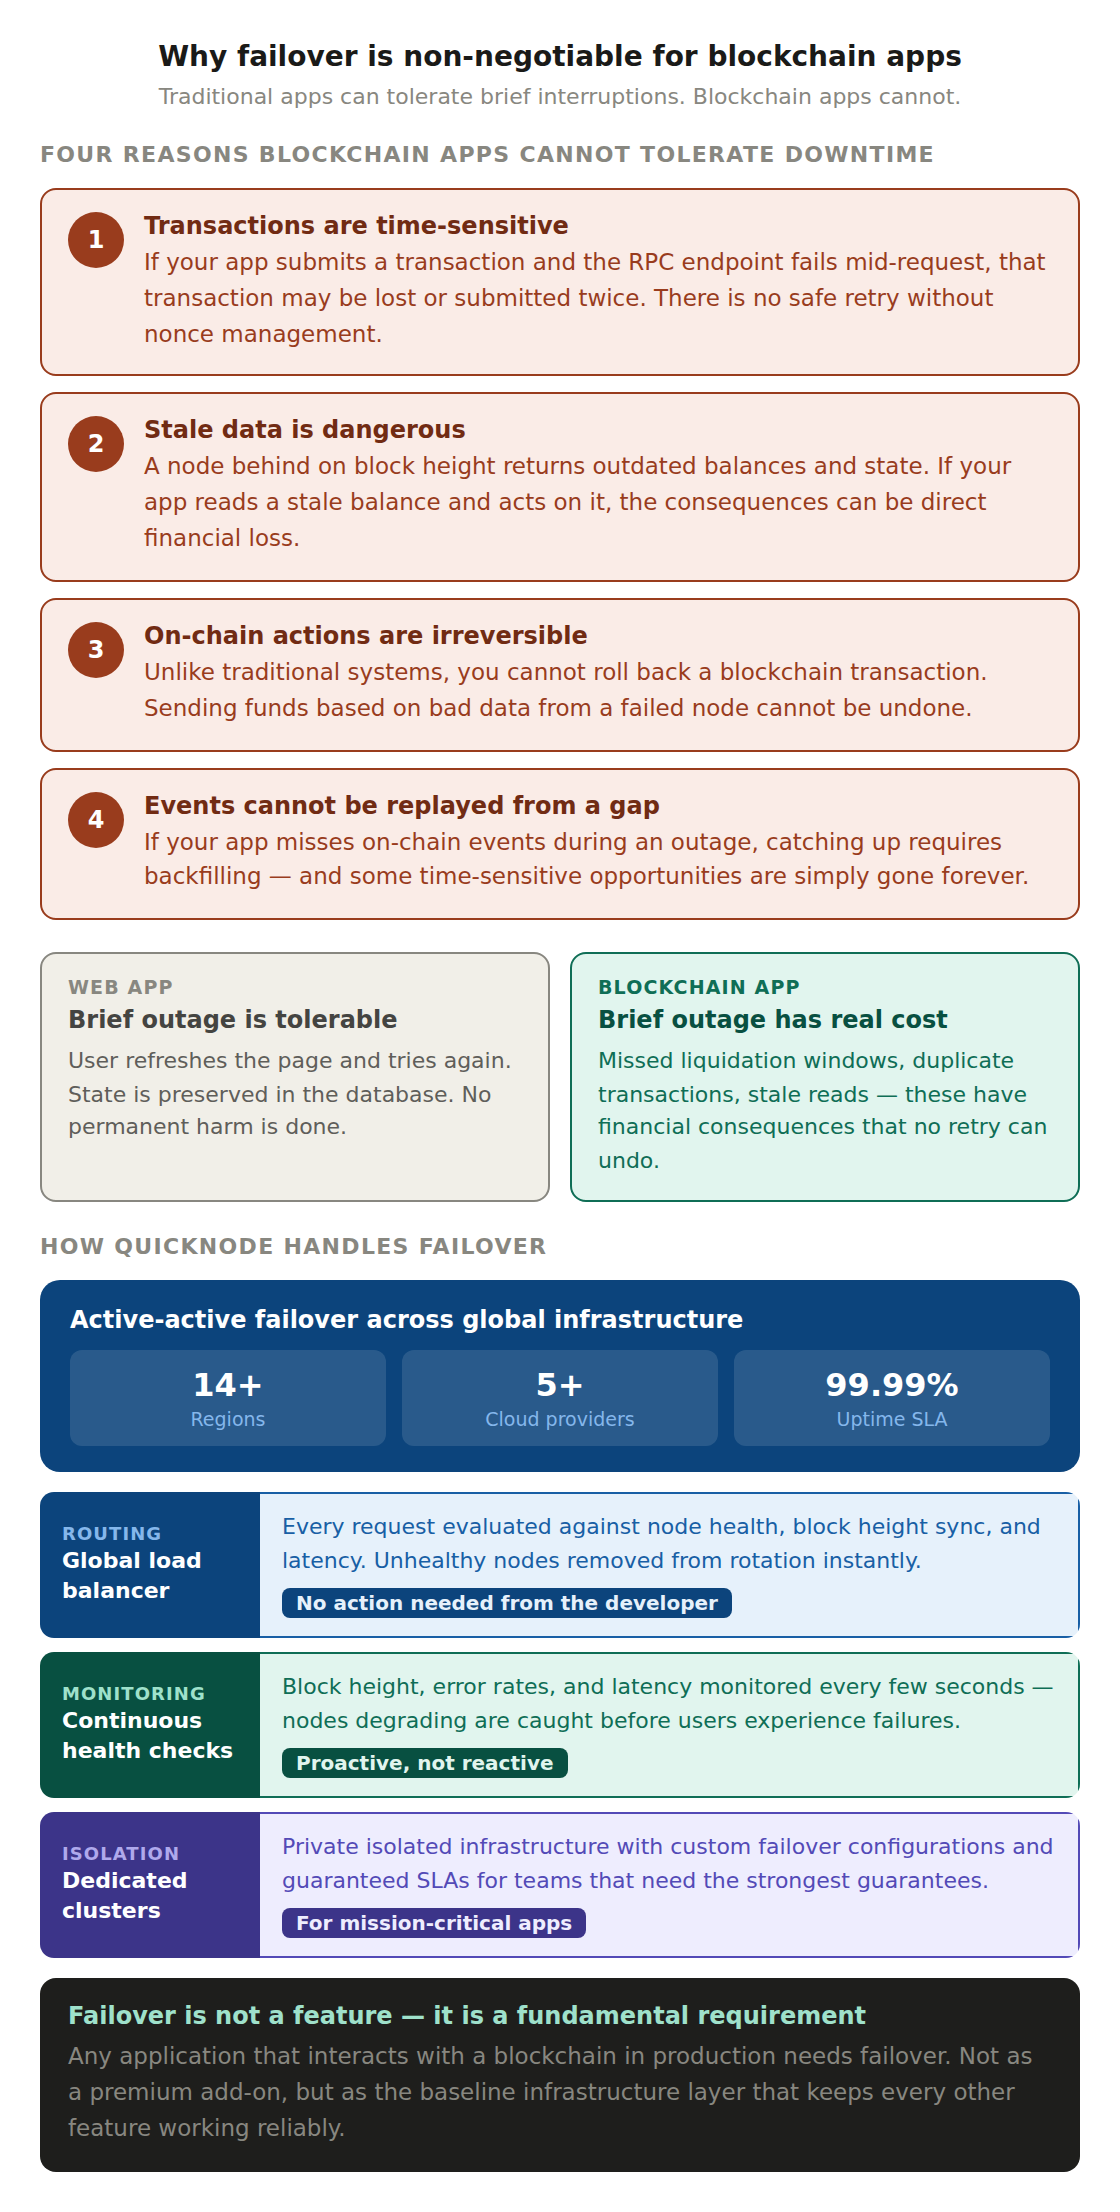
従来のWebアプリケーションは、多くの場合、一時的な中断に耐えることができます。「ユーザー 」を押せばページが更新され、すべてが再び正常に動作するようになります。しかし、ブロックチェーン アプリケーションには、いくつかの理由からそのような余裕がありません。
トランザクションは時間的制約があります。アプリケーションがトランザクションを送信した際、RPCが エンドポイント がリクエストの途中で失敗した場合、そのトランザクションが失われたり、2回送信されたりする可能性があります。古いデータは危険です。ブロック高が最新に追いついていないノードは、古い情報を返します。アプリケーションが古い残高を読み取り、それに基づいて処理を行った場合、金銭的な損失につながる可能性があります。イベントは取り消せません。再試行やロールバックが可能な従来のシステムとは異なり、オンチェーンでの操作は永続的です。障害のあるノードからの誤ったデータに基づいて資金を送金した場合、それを元に戻すことはできません。
だからこそ、フェイルオーバーは「あれば便利」な機能というわけではありません。本番環境でブロックチェーン と連携するあらゆるアプリケーションにとって、これは不可欠な要件なのです。
Quicknode のフェイルオーバー処理方法
Quicknodeのインフラストラクチャは、14以上のリージョンおよび複数のクラウドプロバイダーにまたがるアクティブ・アクティブ・フェイルオーバーを採用しています。すべてのリクエストは、ブロックの高さの同期状況、応答遅延、エラー率など、ノードの健全性を継続的に評価するグローバルなロードバランシング層を経由してルーティングされます。いずれかのノードやリージョンのパフォーマンスが低下した場合、開発者が何らかの操作を行う必要なく、トラフィックは自動的に次善の選択肢へと切り替わります。
最高レベルの保証を必要とするチーム 向けに、専用clusters は、カスタマイズされたフェイルオーバー構成と稼働時間を保証するSLAを備えた、独立したインフラストラクチャを提供します。
フェイルオーバーとロードバランシングの違いは何ですか?
フェイルオーバーとロードバランシングは密接に関連していますが、解決する課題は異なります。ロードバランシングは、着信リクエストを正常なノードのプール全体に分散させることで、個々のノードに過大な負荷がかからないようにします。フェイルオーバーとは、それらのノードのいずれかが正常でなくなった際に発生する処理であり、障害が発生したノードからのトラフィックを引き離し、残りのノードに再分配します。実際には、この2つは連携して機能しており、堅牢な高可用性環境を構築するには、by 側とsideの両方でこれらを実装する必要があります。
機能 | 負荷分散 | フェイルオーバー |
|---|
主な仕事 | トラフィックを均等に分散させる | 障害箇所からトラフィックを迂回させる |
それが作用するとき | すべてのリクエストに対して、継続的に | コンポーネントが劣化したり故障したりした場合にのみ |
主な目標 | パフォーマンスおよび利用率の均一化 | 継続性と稼働率 |
トリガー | リクエスト数 | ヘルスチェックの失敗 |
「単一障害点」とは何を指すのでしょうか?
単一障害点とは、故障するとシステム全体がダウンしてしまうコンポーネントのことです。単一のノード、単一のクラウドリージョン、あるいは単一のクライアント実装のいずれもが、単一障害点となり得ます。フェイルオーバーにより、これらの脆弱な部分を排除し(by )、常に正常に動作する代替手段を準備して引き継ぎできるようにします。一般的な障害モード(ブロックチェーン )を確認することは、スタック内に潜む単一障害点を見つける最も手っ取り早い方法です。
フェイルオーバーが正常に機能しているかどうかを、どのように確認すればよいでしょうか?
フェイルオーバーは、いくつかの具体的な指標を用いて測定します。稼働率はサービスが利用可能だった頻度を示し、復旧時間は障害発生後にトラフィックが切り替わるまでに要した時間を示し、インシデント中のエラー率は切り替えが完了するまでに影響を受けたリクエストの数を示します。 ブロックチェーン インフラストラクチャを継続的に監視することで、これらの数値が明らかになり、フェイルオーバーが正常に機能していることを確認できます。
実際の障害が発生する前に、フェイルオーバーをどのようにテストすればよいでしょうか?
フェイルオーバーを信頼する唯一の方法は、リハーサルを行うことです。チーム では、制御された時間帯に意図的にノードやリージョンをオフラインにし、トラフィックがエラーなく再ルーティングされることを確認しています。このアプローチは、しばしば「カオステスト」と呼ばれます。独自のノードを運用している場合は、プロセスを停止させて、リクエストがどこに送られるかを確認することができます。Quicknode Core APIなどのマネージドプロバイダーを利用している場合、フェイルオーバーは自動的に処理されますが、リージョン間の負荷テストを行ってその動作を検証することは可能です。
よくある質問
フェイルオーバーとは、簡単に言うと何ですか?
フェイルオーバーとは、サービスが継続して稼働できるよう、故障したコンポーネントから正常に動作しているバックアップへ自動的に切り替えることです。ほとんどの場合、ユーザー は切り替えが行われたことに気づくことはありません。
フェイルオーバーと冗長性は同じものですか?
いいえ。冗長性とは、予備のコンポーネントを用意しておくことを指しますが、フェイルオーバーとは、何かが故障した際にトラフィックをそれらの予備に移行させるプロセスのことです。フェイルオーバーを機能させるには、インフラの冗長性が整備されている必要があります。
フェイルオーバーにはどのくらいの時間がかかりますか?
アクティブ-アクティブ方式では、バックアップがすでにトラフィックを処理しているため、フェイルオーバーは多くの場合、near 瞬時に行われます。一方、アクティブ-パッシブ方式では、スタンバイが起動して同期を行う間に、数秒から数分かかる場合があります。
フェイルオーバーによって、すべてのダウンタイムを防ぐことができるのでしょうか?
フェイルオーバーはダウンタイムを大幅に短縮しますが、あらゆる状況において中断を完全にゼロにできるとは限りません。多くのリージョンにまたがる、適切に設計されたアクティブ・アクティブ型のインフラストラクチャであれば、それに非常に近い状態を実現できます。そのため、これが本番環境の標準となっているのです。ブロックチェーン アプリ 。
ブロックチェーン アプリ において、フェイルオーバーがなぜそれほど重要なのでしょうか?
ブロックチェーン 操作には時間的制約があり、多くの場合取り消すことができないため、失敗した エンドポイント は、トランザクションが失われたり、古いデータが返されたりする原因となります。自動フェイルオーバーは、信頼性 およびユーザー の両方の資金を保護します。これは、リアルタイムデータに基づいて構築されたサービスにとって極めて重要です streams 。
参考資料