🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る SOC 2 タイプ II 認証取得・ISO 27001
回答>モニタリングとオブザーバビリティについて学ぶ>ブロックチェーン インフラストラクチャのモニタリング 要約: ブロックチェーン インフラの監視とは、アプリケーションが依存するノード、RPCエンドポイント、データパイプラインの健全性、パフォーマンス、および正確性を継続的に追跡することを意味します。従来のWebサーバーの監視とは異なり、ブロックチェーン の監視では、ブロックの生成レート、同期ステータス、ファイナリティチェックポイント、メンプールの混雑、ガス価格の変動など、ブロックチェーン特有の挙動を考慮する必要があります。 追跡すべき主要な指標は、ブロックハイト(ノードは最新の状態か?)、RPCレイテンシ(リクエストは高速か?)、エラー率(リクエストは成功しているか?)、データの鮮度(アプリケーションは最新の状態を把握しているか?)です。効果的なモニタリングでは、即時の問題に対する自動アラートと、傾向分析やキャパシティプランニングのためのダッシュボード機能を組み合わせます。
わかりやすい説明
アプリケーションがブロックチェーン に依存している場合、そのアプリケーションの健全性は、そのブロックチェーン に接続するインフラストラクチャの健全性に左右されます。たとえ完璧に記述されたスマートコントラクトや見事に設計されたフロントエンドがあったとしても、RPC エンドポイント がダウンしたり、処理が遅れたり、エラーを返したりし始めれば、完璧に記述されたスマートコントラクトや美しく設計されたフロントエンドも無価値になってしまいます。モニタリングを行うことで、ユーザー が機能しなくなる前に、問題の発生を察知することができます。
従来のWebアプリケーションの監視では、サーバーのCPU、メモリ、ディスク、ネットワークに重点が置かれています。ブロックチェーン のインフラ監視では、これらすべてに加え、従来のシステムには存在しないチェーン固有のメトリクスも含まれます。ノードは最新のブロックと同期されていますか?ノードは正規のチェーン上にありますか、それともフォークで立ち往生していますか?RPCの応答は正しいブロック高からのデータを返していますか? mempoolの混雑が、トランザクションの確認時間に影響を及ぼすほど深刻か? こうしたブロックチェーン 特有のシグナルこそが、堅牢な監視環境と、重大な障害モードを見逃してしまう監視環境とを分ける要素なのです。
監視すべき事項
ノードの状態
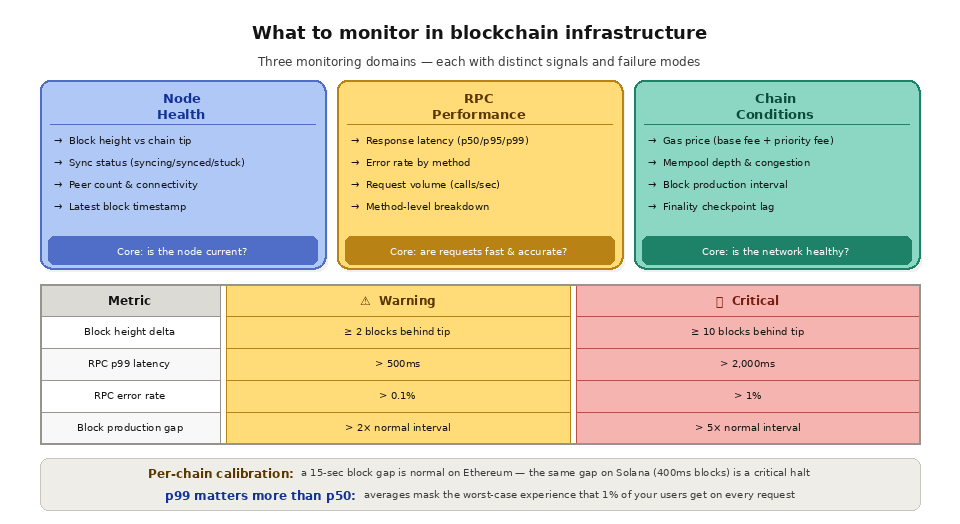
最も基本的な指標はブロック高です。つまり、ノードが処理した最新のブロックはどれか、そしてそれがチェーンの実際の先端(tip)とどのように比較されるかということです。先端に遅れをとったノード(たとえby 数ブロック程度であっても)は、古いデータを提供することになります。その結果、アプリケーションでは古い残高が表示されたり、最近の取引が見落とされたり、確認済みのイベントが検出されなかったりする可能性があります。Solana (ブロック生成時間400ms)のような高速なチェーンでは、わずかな同期の遅れであっても、アプリケーションは現実より複数のブロック分遅れてしまうことになります。
ノードのブロック高さとチェーンの先端との差を監視してください。正常なノードは、常にチェーンの先端から0~1ブロック以内の範囲にあるはずです。差が2ブロック以上ある場合は警告サインです。差が10ブロック以上ある場合は、ノードに同期の問題が発生しており、直ちに調査する必要があります。
同期ステータスは、ノードが現在同期中か、完全に同期済みか、あるいは停止状態にあるかを示します。「同期中」であり、かつ着実に進行しているノードは正常です。「同期中」と報告されているにもかかわらず、数分間ブロック高が進んでいないノードは停止状態にあるため、対応が必要です。
ピア数は、自分のノードが他のノードと何台接続されているかを示す指標です。正常なノードは、データの伝播やコンセンサスへの参加のために、複数のピアとの接続を維持しています。ピア数が減少している場合は、ネットワーク接続の問題や設定上の問題を示している可能性があります。
RPCのパフォーマンス
応答遅延とは、RPCリクエストを送信してから応答を受信するまでの時間のことです。 これを平均値ではなく、パーセンタイル(p50、p95、p99)として追跡してください。平均値では、ユーザー が経験する最悪のパフォーマンスが隠れてしまうからです。p50のレイテンシが50ms、p99が2,000msの場合、ほとんどのリクエストは高速ですが、100件に1件は2秒もかかります。こうした遅いリクエストこそが、ユーザー のユーザーを苛立たせる原因となります。
エラー率は、エラー(HTTPステータスコードが200以外、JSON-RPCのエラー応答、またはタイムアウト)を返すRPCリクエストの割合です。正常な エンドポイント システムのエラー率は0.1%未満であるべきです。1%を超える場合は、直ちに調査が必要な問題が存在することを示しています。一般的なエラーの種類には、429(レート制限)、502/503(ノードが利用不可)、および「missing trie node」(アーカイブデータが利用不可)や「nonce too low」(トランザクション送信の競合)といったJSON-RPCエラーがあります。
メソッド単位の内訳では、by の各RPCメソッド(eth_call、eth_getBalance、eth_sendRawTransactionなど)ごとに指標が分類されています。これは、メソッドごとにパフォーマンスの傾向や障害の発生パターンが異なるためです。例えば、eth_getLogsのレイテンシが急上昇した場合は、ノードがログのフィルタリングに苦労している可能性があり、一方、eth_sendRawTransactionのエラーが急増した場合は、mempoolの混雑を示している可能性があります。
チェーンの条件
ガス価格の追跡は、トランザクションを送信するあらゆるアプリケーションにとって不可欠です。基本手数料と優先手数料の動向を監視することで、アプリケーションは適切なガス価格を見積もることができ、ネットワークが混雑していない時期に過剰な支払いを回避し、ネットワークの混雑によりトランザクションのコストが高騰する見込みがある場合には、ユーザー に通知することができます。
メンプールの深さは、ブロックへの組み込みを待機している未処理のトランザクションの数を示します。メンプールの深さが増加していることは、ネットワークの混雑が深刻化していることを示しており、その結果、手数料が高くなり、確認時間が長くなります。トランザクションの確認が予測可能であることが求められるアプリケーションは、メンプールの深さを監視し、それに応じて動作を調整する必要があります。
ブロックの生成レートはby チェーンによって異なり、ネットワークの問題が発生した際には変動する可能性があります。ブロックの生成間隔を監視することで、チェーンの速度低下や停止がアプリケーションの機能に影響を与える前に、それを検知することができます。
監視の設定
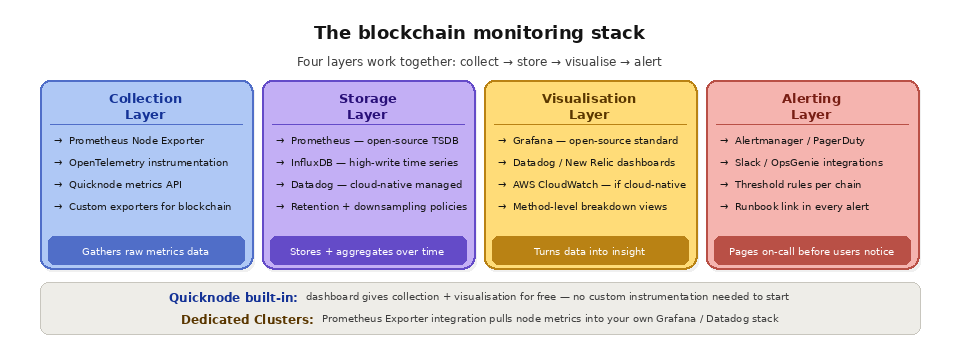
ブロックチェーン の標準的なインフラストラクチャ監視スタックは、収集層、保存層、可視化層、およびアラート層で構成されています。
収集レイヤーは、インフラストラクチャからメトリクスを収集します。セルフホスト型ノードの場合、Prometheus Node Exporter やカスタムメトリクスエクスポーターなどのツールが、システムメトリクスおよびブロックチェーン 固有のメトリクスを収集します。マネージドエンドポイントの場合、ほとんどのプロバイダーが API または Webhook ベースのメトリクスアクセスを提供しています。アプリケーションレベルのメトリクスは、OpenTelemetry、StatsD、またはプロバイダー固有の SDK を使用して収集できます。
ストレージ層は、メトリクスデータ向けに最適化された時系列データベースです。Prometheus、InfluxDB、Datadogが最も一般的な選択肢です。時系列データベースは、書き込み頻度が高く、時間順に並んだメトリクスデータの特性に合わせて設計されており、集計、ダウンサンプリング、保存ポリシーを行うためのサポート が組み込まれています。
可視化レイヤーは、生のメトリクスを実用的なダッシュボードに変換します。Grafanaは、オープンソースの監視可視化における業界標準であり、Prometheus、InfluxDB、その他数十種類のデータソースに対応したネイティブのサポート を備えています。Datadog、New Relic、AWS CloudWatchは、それぞれの監視プラットフォームの一部として統合された可視化機能を提供しています。
アラート層は、メトリクスをしきい値と照らし合わせて評価し、注意が必要な状況が発生した際に適切な担当者に通知します。 効果的なアラートは、実行可能であること(すべてのアラートに対応するランブックが用意されていること)、適切に調整されていること(過度に敏感で頻繁に発動したり、逆に緩すぎて実際の問題を見逃したりしないこと)、ルーティングされていること(PagerDutyやSlackなどを通じて当直担当者に送信されること)、そして文脈に沿ったものであること(ダッシュボードを開かなくても問題の診断を開始できるだけの十分な情報が含まれていること)が求められます。
ブロックチェーン-モニタリングにおける具体的な課題
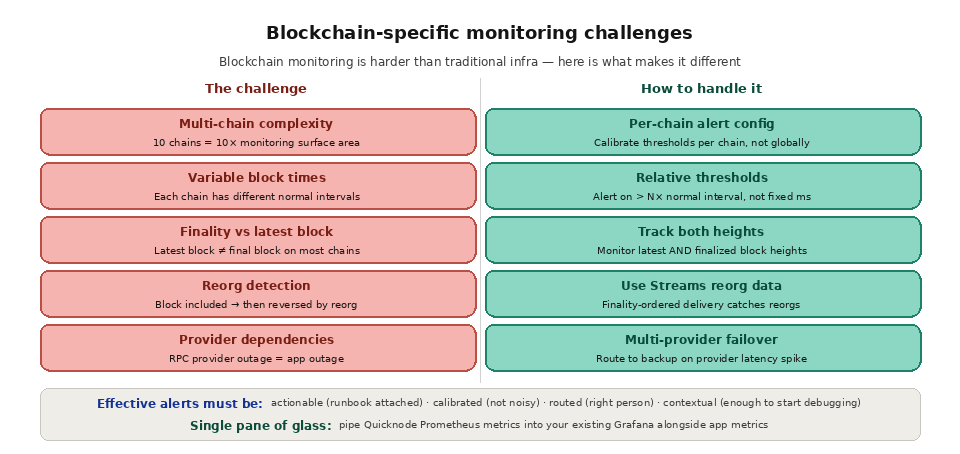
マルチチェーン 環境が増えると、監視の複雑さが増大します。アプリケーションが 10 のチェーンをサポートしている場合、各チェーンについて、ノードの健全性、RPC のパフォーマンス、およびチェーンの状態を追跡する必要があります。各チェーンは、ブロック生成時間、ファイナリティモデル、障害モードが異なります。Ethereum で完璧に機能する監視設定でも、Solana では重要なシグナルを見逃してしまう可能性があり、その逆も同様です。
ブロックの時間が変動するため、固定のアラート閾値を設定することが難しくなります。Ethereum のブロック間に15秒の間隔が生じるのは正常です。一方、Solana (ここでは400ミリ秒ごとにブロックが発生するはず)で15秒の間隔が生じる場合は、深刻な問題です。アラートは一律に設定するのではなく、チェーンごとに調整する必要があります。
データパイプラインの監視においては、ファイナリティの把握が重要です。監視では、ノードが認識している最新のブロックだけでなく、ファイナリティが確定した最新のブロックも追跡する必要があります。まだファイナリティが確定していないブロックからのデータは、再編成(reorg)によって取り消される可能性があります(by )。そのため、ファイナリティが確定したデータに依存するアプリケーションでは、最新のブロック高とファイナリティが確定したブロック高を区別できる監視が必要です。
ブロックチェーン において、追跡すべき最も重要な監視指標は何ですか?
ブロックチェーン のインフラストラクチャの問題の大部分は、いくつかの高信号指標によって検出されます。以下の表には、各指標が示す内容、正常な設定を示す範囲、および当直のエンジニアに連絡すべきタイミングがまとめられています。
メートル法 | 測定対象 | 適正範囲 | いつ警告を発すべきか |
|---|
ブロック高さの差 | チェーンの先端からの距離 | 0~1ブロックの範囲内 | 10ブロック以上遅れている |
RPCのレイテンシ(p99) | 回答のうち最下位1% | 500ミリ秒未満 | 2秒以上 |
エラー率 | リクエストの失敗率 | 0.1%未満 | 1%超 |
ピア数 | 接続済みのネットワークピア | 安定しており、顧客の最低基準を上回っている | 急激な低下または持続的な低下 |
メンプールの深さ | 保留中の取引 | チェーンは安定している | 急速かつ持続的な成長 |
データの新鮮度 | 最新の提供済み状態の経過時間 | 生まれたばかり | ティップから数分遅れて |
これらを単発の測定値ではなく時系列データとして追跡することで、障害が発生する前に傾向を把握できるようになります。特にレイテンシについては、パーセンタイルで測定すべきです。RPCレイテンシの原因や、それがブロックチェーン の包括的な可観測性においてどのような位置づけにあるかについては、こちらをご覧ください。
ブロックチェーン による監視は、従来のインフラ監視とどのように異なるのでしょうか?
標準的なサーバー監視では、マシンが稼働しているかどうかを確認できますが、ブロックチェーン ノードは、すべてのインフラストラクチャチェックに合格しつつ、古いデータや再編成されたデータをひそかに提供し続ける可能性があります。ブロックチェーン の監視機能は、通常のホストメトリクスに加えて、チェーンを意識したシグナルを重ね合わせています。
アスペクト | 従来のインフラ監視 | ブロックチェーン インフラ監視 |
|---|
一次保健指標 | CPU、メモリ、ディスク、ネットワーク | ブロック高、同期状態、ファイナリティ |
よくある不具合mode | サーバーがダウンしているか、過負荷状態です | ノードはオンラインだが、古いデータや再編成されたデータを提供している |
正確性リスク | サーバーからの応答があった時点で低くなる | 有効なデータは、by による再編成で元に戻すことができます。 |
レイテンシの基準値 | サービスごとに固定 | チェーンごと、およびRPCメソッドごとに異なります |
適用範囲 | 1スタック | 複数のチェーンにまたがり、チェーンごとに1つのセットアップ |
最大の違いは、時間の経過に伴う正確性です。レスポンスは返された時点では正確であっても、数秒後には無効になる可能性があります。そのため、モニタリングでは、最新のブロックと確定したブロックを区別する必要があります。この区別がデータパイプラインにとってなぜ重要なのかについては、ブロックチェーン finality を参照してください。
独自のノードを稼働させずに、ブロックチェーン のインフラを監視することはできますか?
はい。マネージド RPC プロバイダーは、ユーザー側で特別な設定を行うことなく、リクエスト数、レイテンシ、エラー率に関するダッシュボードやメトリクスを提供します。これにより、自己ホスト型モニタリングに伴う運用負担の大部分が解消されます。プロバイダーがノードの健全性、スケーリング、冗長性を自動的に管理するため、これは高可用性を実現するための最も迅速な方法となる場合が多いです。Quicknode のCore APIには、エンドポイント 分析機能が標準で搭載されているため、最初のリクエストからインフラストラクチャの状況を把握できます。
マルチチェーン ブロックチェーン のインフラストラクチャは、どのように監視していますか?
マルチチェーン モニタリングとは、チェーンごとに閾値を調整することを意味します。なぜなら、Ethereum では正常とされる遅延でも、1秒未満のチェーンでは深刻なインシデントになり得るからです。すべてのチェーンからのメトリクスを1つのダッシュボードに集約し、チェーンごとのベースラインに基づいてアラートを発信します。データパイプラインについては、 Quicknode Streams チェーンごとの配信成功率と処理レイテンシをレポートすることで、いずれかのネットワークで遅延が発生した瞬間を即座に把握できます。
よくある質問
ブロックチェーン のインフラは、どのくらいの頻度で監視すべきでしょうか?
継続的に。数秒おきにブロックの高さとレイテンシを収集し、near でアラートルールをリアルタイムに評価します。高速なチェーンでは1秒あたり複数のブロックが生成されるため、ポーリング間隔を1分に設定すると、すでに大幅に遅れをとっているノードが見落とされる可能性があります。完全なカバレッジを確保するには、短い収集間隔と、メトリクス、ログ、トレースという3つの柱を組み合わせて活用してください。
RPCのエラー率はどの程度が適切でしょうか?
健全な エンドポイント エラー率は0.1%未満に抑えられます。1%を超える場合は、レート制限、ノードの利用不可、アーカイブデータの欠落など、深刻な問題が発生していることを示しています。常にby メソッドでエラーを詳細に分析し、どの呼び出しが失敗しているか、その原因を把握できるようにしてください。
「最新ブロック監視」と「確定ブロック監視」の違いは何ですか?
「最新のブロック」とは、ノードが認識している最も新しいブロックを指し、「確定済みブロック」とは、元に戻されることがない段階に達したブロックを指します。確定済みのデータに依存するアプリケーションは、確定済みブロックの高さを監視する必要があります。これは、未確定のブロックからのデータは、再編成(reorg)によって消失する可能性があるためです。
ブロックチェーン ノードのダウンタイムはどのように監視していますか?
ブロックの高さの変動、ピア数、エラー率をまとめて監視し、アラートを当直チャネルに通知します。監視と、堅牢なノードの信頼性 (分散管理)の実践、および自動フェイルオーバーを組み合わせることで、ノードのパフォーマンスが低下した瞬間に、トラフィックを正常なノードへ迂回させることができます。
ブロックチェーン のインフラを監視するために、どのようなツールが使用されていますか?
一般的なオープンソースのスタックとしては、収集・保存にPrometheus、ダッシュボードにGrafana、ルーティングにAlertmanagerが用いられます。マネージドサービスプロバイダーは組み込みの分析機能を追加しており、専用Clusters では、ノードレベルのメトリクスを既存のPrometheusやDatadog環境に直接エクスポートすることができます。
Quicknode による監視機能の仕組み
Quicknode すべてのリクエストに対して、組み込みの監視および分析機能が含まれています エンドポイント。Quicknode のダッシュボードには、リクエスト数、応答遅延、エラー率、メソッドごとの内訳など、リアルタイムおよび過去のメトリクスが表示されます。これらのメトリクスは、特別な計測設定を一切行わなくても利用可能であり、開発者 はブロックチェーン インフラストラクチャの状態を即座に把握できます。
既存の監視インフラストラクチャを備えたチーム の場合、Quicknode の専用Clusters (サポート )Prometheusエクスポーター統合をご利用いただけます。これにより、ノードレベルおよび エンドポイント-レベルのメトリクスをPrometheusインスタンス、Grafanaダッシュボード、またはDatadogに直接取り込むことができ、単一のプラットフォーム上でアプリケーションスタックとブロックチェーン インフラストラクチャ全体にわたる統合監視を実現します。また、DedicatedClusters には、詳細なリクエストレベルの分析を可能にする14日間のログ保持機能も含まれています。
Quicknode Streams データパイプラインの健全性を監視し、配信成功率、処理遅延、エラーログなどの情報を提供します。マルチチェーン データパイプラインを実行しているチーム において、Streams による監視機能により、データ欠落がアプリケーションに影響を与える前に、パイプラインの遅延や配信上の問題が発生したことを把握できます。
参考資料