🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る 回答>モニタリングとオブザーバビリティについて学ぶ>アラート設定のベストプラクティス // Tags
アラートに関するベストプラクティス当直
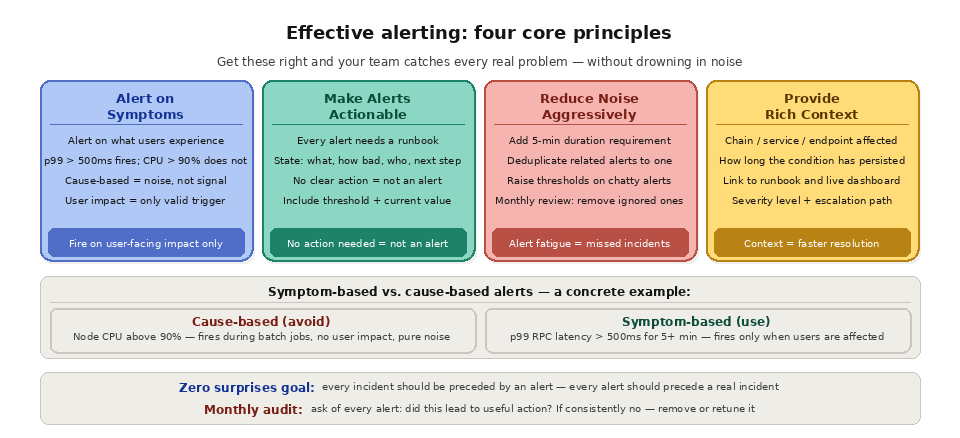
要約:効果的なアラートとは、実際の問題について適切な人物に適切なタイミングで通知し、直ちに行動を起こせるだけの十分な背景情報を提供するものである。 最も重要な原則は、原因(内部メトリクス)ではなく症状(ユーザー への影響)に基づいてアラートを発行すること、すべてのアラートが具体的な対応を可能にするものであること(対応すべきことがなければアラートとして発出されるべきではない)、ノイズを徹底的に削減すること(アラート疲労は実際のインシデントの見落としを招く)、そしてコンテキスト(何が問題か、その深刻度はどの程度か、誰が影響を受けているか、そしてどう対処すべきか)を提供することです。ブロックチェーン アプリケーションの場合、アラートはノードの同期遅延、ガス価格の急騰、トランザクションの確認遅延、ブロックの再編成といったチェーン固有の条件も網羅する必要があります。
わかりやすい説明
アラート機能は、監視データと人間の行動をつなぐ架け橋です。監視システムは、何千ものメトリクスと何百万ものログエントリを収集します。アラート機能は、その中からどのシグナルが午前3時に誰かを起こす価値があるかを判断します。これを適切に行えば、equipe は、ユーザー が気付く前に問題を検知できます。逆に、これを誤ると、実際のインシデントがノイズの洪水(アラートが多すぎる)に埋もれてしまったり、重大な問題がユーザー が悲鳴を上げるまで(アラートが少なすぎる)発見されなかったりすることになります。
適切に調整されたアラートシステムの目標は、「予期せぬ事態をゼロにする」ことです。本番環境でのあらゆるインシデントは、by アラートによって事前に通知されるべきであり、また、あらゆるアラートは、実際の(あるいは差し迫った)インシデントに先立って発生するべきです。問題が発生していないにもかかわらず発動するアラートは、equipe 担当者がそれらを無視するよう慣れてしまう原因となります。アラートが先行せずに問題が発生する場合、それは監視体制に不備があることを意味します。
「監視」と「アラート」の違いは何ですか?
監視とアラートは関連していますが、別物です。監視とは、システムの健全性を示すメトリクス、ログ、トレースを継続的に収集することです。アラートは、その上に位置する層であり、これらのシグナルのうち、どのシグナルに対して人間による対応が必要かを判断し、適切な担当者に通知する役割を担います。アラートなしで監視を行うことは可能ですが、その基盤となる適切な監視がなければ、効果的なアラートは実現できません。この仕組みのデータ面については、以下を参照してください。
SOC 2 タイプ II 認証取得・ISO 27001
ブロックチェーン インフラの監視
そして、より広範な慣行として
.
原因ではなく、症状に注意を払う
アラート設定における最も重要な原則は、原因(内部で何が起きているか)ではなく、症状(ユーザー が経験すること)に基づいてアラートを発することである。症状ベースのアラートは、ユーザー の観点から何かが正常に動作していない場合に発動する。一方、原因ベースのアラートは、ユーザー に影響があるかどうかに関係なく、内部メトリクスが閾値を超えた場合に発動する。
「ノードのCPU使用率が90%を超えている」といった原因ベースのアラートは、CPUを大量に消費するものの、ユーザー のパフォーマンスには影響を与えない通常のバッチ処理ジョブの実行中に発動してしまう可能性があります。このようなアラートはノイズとなり、アラートシステムへの信頼を損なうことになります。 「p99 RPC 応答時間が 5 分以上 500 ミリ秒を超えている」といった症状ベースのアラートは、原因が CPU 使用率の高さ、同期の問題、ネットワークの輻輳のいずれであるかにかかわらず、ユーザー が実際に応答の遅延を経験している場合にのみ発動します。
だからといって、内部メトリクスを監視すべきではないという意味ではありません。内部メトリクスは、ダッシュボードや傾向分析、インシデント発生後の調査において有用です。しかし、ユーザー への影響と直接関連していない限り、アラートを発行すべきではありません。アラートは、実際に何かが故障している、あるいは間もなく故障しそうなことを示すシグナルにのみ限定してくださいユーザー 。
「症状ベースのアラート」と「原因ベースのアラート」の違いは何ですか?
症状ベースのアラートは、ユーザー の動作状況に基づいて発動しますが、原因ベースのアラートは、ユーザー に影響を与える場合とそうでない場合がある内部メトリクスに基づいて発動します。以下の表では、この2つを比較していますので、どのシグナルをページング対象とし、どのシグナルをダッシュボードに表示すべきかを判断する参考にしてください。
アスペクト | 症状に基づくアラート | 原因に基づくアラート |
|---|
トリガーがオン | ユーザー-方向への衝撃 | 内部メトリクスのしきい値 |
例 | p99:RPCのレイテンシが5分間にわたり500msを超えた | ノードのCPU使用率が90%を超えている |
偽陽性のリスク | 低 | 高 |
主に次のような用途に適しています | 人を目覚めさせるページ | ダッシュボードと調査の背景 |
アラートを具体的な行動につなげる
すべてのアラートには、明確かつ文書化された対応手順が定められている必要があります。アラートが発生した際、当直のエンジニアの最初の反応が「これに対してどうすればいいんだ?」であるような場合、そのアラートは実行可能なものではありません。
各アラートには、問題の内容(症状の明確な説明)、定量的な状況(閾値を超えたことおよび現在の値)、範囲(どの エンドポイント、チェーン、またはサービスが影響を受けているか)、継続時間(その状態がどれくらい続いているか)、およびランブックへのリンク(問題の診断と解決のためのステップバイステップの手順:by )を含める必要があります。
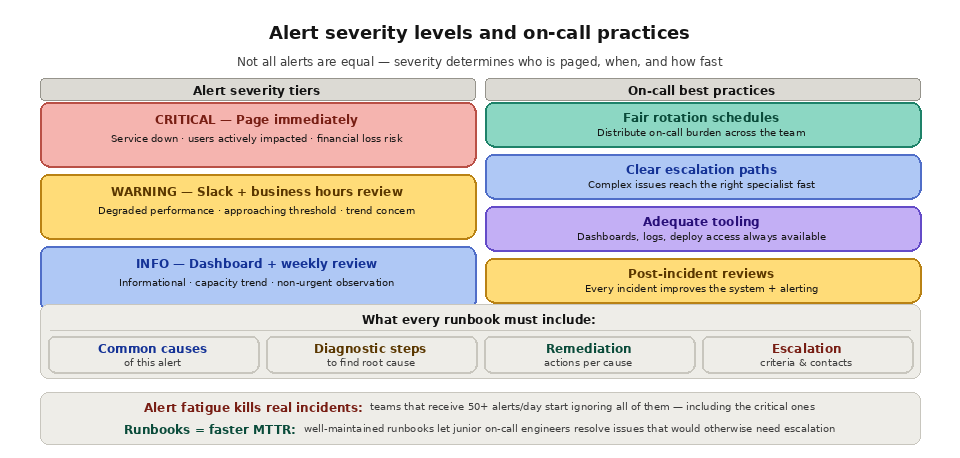
ランブックは、各アラートにとって不可欠なドキュメントです。ランブックには、アラートの一般的な原因、根本原因を特定するための診断手順、各一般的な原因に対する是正措置、およびエスカレーション基準(いつ他の担当者を呼び出すか)が、対応担当者が順を追って確認できるよう記載されている必要があります。適切に管理されたランブックは、インシデント対応時間を大幅に短縮し、経験の浅いequipe のメンバーでも当直業務を効果的に遂行できるようにします。
アラートのノイズを低減する
アラート疲労は、効果的なアラートシステムにとって最大の脅威です。チーム が1日に数十件ものアラートを受け取り、そのほとんどが誤検知や優先度の低いものである場合、彼らは重大なアラートを含め、すべてのアラートを無視し始めてしまいます。
医療分野(アラーム疲労が患者の安全上の問題として認識されている分野)における研究によると、アラームの最大99%が誤警報である可能性があり、その結果、臨床医はアラームを無効にしたり無視したりしてしまうことが示されている。
ノイズを低減するための戦略としては、頻繁に発生する、対応不要なアラートの閾値を引き上げること、継続時間の要件を追加すること(瞬間的なスパイクでアラートを発報するのではなく、状態が5分以上継続した場合にのみアラートを発報する)、関連するアラートの重複を排除すること(同じプロバイダー上の5つのエンドポイントすべてが遅延している場合、5件ではなく1件のアラートを送信する)、深刻度レベルを導入すること (重大アラートは直ちにページング通知、警告アラートは営業時間中に確認できるようSlackチャンネルに送信)の導入、そして一貫して無視されたり、何の対応もせずに解決されたりするアラートを定期的に見直して廃止することなどがあります。
有効な手法として、過去1か月間に発生したすべてのアラートを見直し、「このアラートは有益なアクションにつながったか?」と自問してみてください。答えが一貫して「いいえ」である場合は、そのアラートを削除するか、設定を見直してください。
ブロックチェーン-特定のアラート
ブロックチェーン アプリケーションには、標準的なアプリケーションおよびインフラストラクチャのアラートに加え、チェーンレベルの状況を網羅するアラートが必要です。
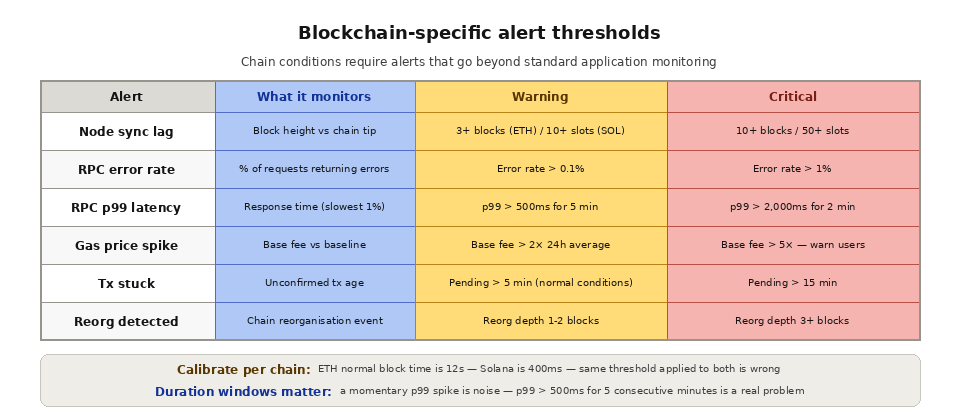
ノードの同期遅延については、自身のノード(またはプロバイダーのノード)がチェーンの先端から設定されたブロック数以上遅れた場合に、アラートを発行するように設定する必要があります。Ethereum の場合、3ブロック以上遅れた時点でアラートを発行します。Solana の場合、10スロット以上遅れた時点でアラートを発行します。同期遅延が発生すると、アプリケーションは古いデータを配信することになります。
ガス価格の急騰は、トランザクションを送信するあらゆるアプリケーションに影響を及ぼします。基本手数料が、ご利用のユースケースにおいてトランザクションのコストが経済的に見合わなくなる閾値を超えた場合にアラートを発信してください。これにより、アプリケーションはユーザー に警告を送信したり、緊急性の低いトランザクションを延期したり、ガスパラメータを先回りして調整したりすることが可能になります。
送信されたトランザクションが予想される時間内に確認されない場合、「トランザクションが停滞中」というアラートが発せられます。通常時において、Ethereum で10分以上保留状態にあるトランザクションは、ガス価格が不足している可能性が高く、手数料を高く設定して再送信する必要があります。
再編成検出アラートは、アプリケーションが依存しているチェーンでブロックの再編成が発生した際に通知します。データパイプラインが、ファイナリティを待たずにチェーンの末端にあるブロックを処理している場合、再編成が発生すると、最近処理されたデータが不正確になっている可能性があり、修正が必要になります。
プロバイダーの健全性アラートは、RPCプロバイダーの全体的な健全性を監視します。プロバイダーのエラー率が閾値を超えて急増した場合、アプリケーションはバックアッププロバイダーに切り替えるか、サービス品質が低下した状態(mode )に移行する準備をしておく必要があります。
ブロックチェーン のどの条件でアラートを発動させるべきですか?
標準的なインフラストラクチャのアラートに加え、ブロックチェーン アプリケーションでは、チェーンの状態に合わせて調整されたアラートが必要です。以下の表には、一般的な条件と閾値の例を記載しています。リオーガナイゼーション(reorg)のような条件には特別な対応が必要ですが、これについては「ブロックチェーン のリオーガナイゼーションとは」で解説しています。また、同期の遅れ(sync lag)は、ノードの信頼性 と直接関連しています。
状態 | しきい値の例 | その重要性 |
|---|
ノードの同期遅延 | 3ブロック以上(Ethereum )または10スロット以上(Solana ) | 古くなったデータを配信しています |
ガソリン価格の高騰 | Base 経済的限界を超える手数料 | 取引コストが高くなりすぎる |
トランザクションが停止している | 10分以上保留中 | おそらく評価が低すぎるため、再提出が必要 |
チェーンの再編成 | 「確認数」よりも深い | 最近処理されたデータには誤りがある可能性があります |
プロバイダーのエラー率 | ベースラインより上 | バックアップへのフェイルオーバーを行う時が来た |
オンコールのベストプラクティス
アラートは、誰かが迅速かつ的確に対応して初めて効果を発揮します。 健全なオンコール体制を確立するには、equipe 全体に負担を分散させる公平なローテーションスケジュール、複雑な問題が迅速に適切な専門家に届くよう明確なエスカレーション手順、オンコール担当エンジニアがダッシュボード、ログ、デプロイメントツールに即座にアクセスできる適切なツール環境、システムとアラート設定の両方の改善につながる事後検証、そしてオンコール業務に伴う実際の負担を適切に評価した報酬や休暇のポリシーが必要です。
アラート機能と高可用性はどのように連携しているのでしょうか?
アラートは障害が発生したことを通知しますが、高可用性により、対応中にサービスを継続して稼働させることができます。この2つは互いに補完し合います。プロバイダーの稼働状況に関するアラートは、引き継ぐ準備が整ったバックアップがある場合に最も有用です。アラートと、高可用性設計、自動フェイルオーバー、そして迅速な対応を可能にするインフラの冗長性を組み合わせてください。
Quicknode が効果的なアラート機能を実現する方法
Quicknodeの組み込み分析機能は、ブロックチェーン インフラストラクチャのアラート機能におけるメトリクスの基盤となります。リクエスト数、応答遅延、エラー率、およびメソッドごとの内訳はダッシュボードで確認でき、アラートのしきい値設定に活用できます。カスタムアラートインフラストラクチャを採用しているチーム の場合、Quicknode のDedicatedClusters は、Prometheus互換のメトリクスをエクスポートし、Alertmanager、Grafana Alerts、PagerDuty、あるいはスタック内のあらゆるアラートシステムと直接連携します。
Quicknode Streams データパイプラインの問題(配信の失敗、処理の遅延、送信先エラーなど)に対してアラートを発信できる配信健全性指標を提供します。これをRPCレイヤーのアラート機能と組み合わせることで、チーム は、リアルタイムAPIアクセスとストリーミングデータインフラストラクチャの両方において、包括的な監視を実現しています。
参考資料
よくある質問
アラートが「実行可能な」ものとなるのは、どのような場合でしょうか?
アラートは、対応担当者が何をすべきかを正確に把握できた場合に、具体的な対応が可能となります。アラートには、症状、閾値を超えたこととその現在の値、影響範囲、状態が継続している期間、および診断と是正措置の手順が記載されたランブックへのリンクを明記する必要があります。
アラート疲労とは何ですか?
アラート疲労とは、equipe が大量のアラート(特に誤検知)を受け取った結果、重大なアラートを含め、すべてのアラートを無視し始めてしまう現象のことです。閾値を引き上げたり、継続時間の要件を追加したり、重複を排除したり、重大度レベルを活用したりすることで、この現象を軽減できます。
CPU使用率についてアラートを設定すべきでしょうか?
通常、ページングの対象とはなりません。CPUは原因ベースのメトリクスであり、ユーザー に影響を与えることなく、通常の業務中に急上昇することがよくあります。ダッシュボードで監視し、代わりに、エラー率の上昇やレイテンシの増加といったユーザー に関連する症状については、ページングを設定してください。
ブロックチェーン の再編成について、どのようにアラートを発行すればよいですか?
依存しているチェーンでリオーガナイゼーションの検出を設定し、リオーガナイゼーションが待機する確認数よりも深い場合にアラートを発行するようにします。パイプラインがブロックの最新部分(tip)を処理している場合、リオーガナイゼーションが発生すると、最近のデータを修正する必要が生じます。関連するリスクについては、「 ブロックチェーン の一般的な障害モード」を参照してください。
アラートにはどの深刻度レベルを設定すべきでしょうか?
シンプルで効果的なモデルは、2段階の仕組みです。重大なアラートは直ちに当直担当者に通知され、警告アラートは営業時間中に確認するためのチャネルに送信されます。これにより、ページングは、真に緊急の人的対応を必要とする問題に限定されます。