要約:メトリクス、ログ、トレースは、オブザーバビリティにおける3つの基本的なデータタイプであり、それぞれがシステムの挙動を理解する上で異なる役割を果たします。メトリクスは、時間の経過とともに追跡される集計された数値データであり、ダッシュボード、アラート、傾向分析に最適です。ログは、個々のイベントのタイムスタンプ付き記録であり、特定のインシデントのデバッグや監査証跡の維持に最適です。 トレースは、分散システム内における単一のリクエストの全経路を追跡し、処理に時間がかかっている箇所やボトルネックが発生している箇所を明らかにします。実際には、これら3つは連携して機能します。メトリクスがアラートをトリガーし、ログがエラーの詳細を提供し、トレースが失敗したリクエストパスの完全なコンテキストを示すのです。ブロックチェーン アプリケーションにおいて効果的な可観測性を実現するには、これら3つの柱すべてが必要です。なぜなら、ブロックチェーン インフラストラクチャの分散的な性質により、単一のデータタイプだけでは診断できない障害モードが生じるからです。
わかりやすい説明
病気の診断を例に考えてみましょう。バイタルサイン(心拍数、血圧、体温)は「指標」であり、何かが異常であることを示します。診療記録や検査結果は「ログ」であり、何が起きているのかという具体的な詳細を提供します。MRIやCTスキャンは「トレース」であり、体内の全体像を映し出すことで、医師が問題の場所を正確に特定できるようにします。
ブロックチェーン インフラストラクチャにおいても、同様の診断上の課題に直面します。 アプリケーションは、フロントエンド、バックエンド、RPCエンドポイント、ブロックチェーン ノード、そしてチェーン自体に分散しています。各レイヤーは独立して障害が発生したり、パフォーマンスが低下したりする可能性があります。メトリクスからは「何かが異常である」(レイテンシが急上昇した)ことがわかります。ログからは「何が問題だったか」(特定のRPCメソッドがエラーを返している)がわかります。トレースからは「リクエストパス内のどこで問題が発生したか」(ノードが複雑なコントラクトに対するeth_callの処理に3秒かかった)がわかります。
「モニタリング」と「オブザーバビリティ」の違いとは?
モニタリングとオブザーバビリティは関連していますが、異なる概念です。モニタリングは既知のシグナルを監視し、あらかじめ定義された閾値を超えた際に通知するものです。一方、オブザーバビリティとは、システムから生成されるデータを活用して、予期していなかった問題についてさえも、システムに関する新たな問いを投げかけることができる、より広範な能力のことです。 メトリクス、ログ、トレースは可観測性の「原材料」であり、これらを組み合わせることで、「何かがおかしい」という状態から「具体的な原因はこちらだ」という段階へと進むことができます。より詳しい入門情報については、ブロックチェーン の可観測性に関する概要をご覧ください。
メトリクス、ログ、トレースはどのように異なるのか?
各柱はそれぞれ異なる疑問に答え、異なるコストを伴います。以下の表は、それぞれの柱をいつ活用すべきかをまとめたものです。
寸法 | 指標 | ログ | トレース |
|---|---|---|---|
データ型 | 集計値 | タイムスタンプ付きのイベント | リンクされたリクエストのスパン |
最高の質問 | 何か問題でも? | 何が問題だったのでしょうか? | どこで間違ってしまったのだろうか? |
保管費用 | 低 | 高 | 中程度、通常はサンプリングされる |
こんな方に最適 | ダッシュボードとアラート機能 | 根本原因の特定によるデバッグ | レイテンシとボトルネックの分析 |
ツールの例 | プロメテウス、Grafana | ELK、Loki、Splunk | OpenTelemetry、Jaeger |
ブロックチェーン システムにおいて、これらの柱は、ノードの健全性、同期状態、およびRPCの動作を監視する、より広範なインフラストラクチャ監視の上に位置づけられています。
指標の詳細
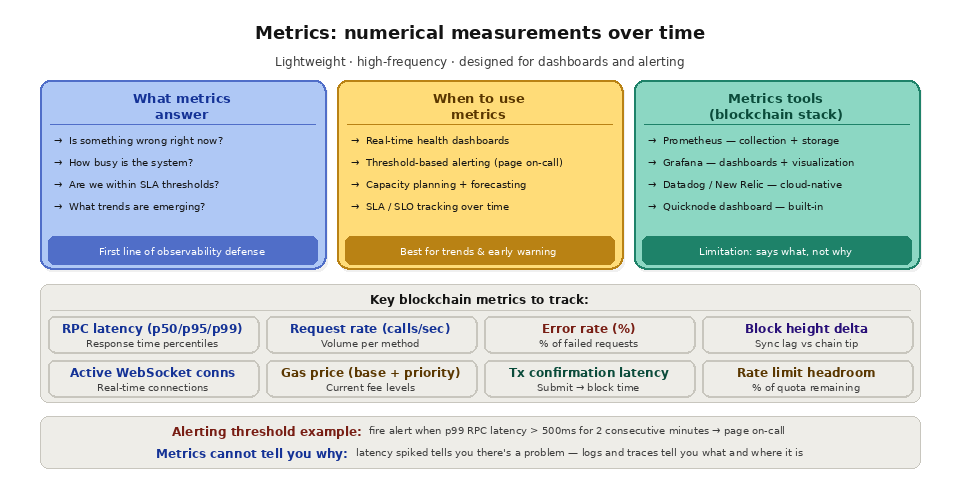
メトリクスとは、一定間隔で収集され、時間の経過とともに集計される数値のことです。軽量で保存効率が高く、高頻度での収集を想定して設計されています。一般的なブロックチェーン アプリケーションでは、RPCリクエスト率(by メソッドあたりのリクエスト数)、応答レイテンシ(p50、p95、 p99パーセンタイル)、エラー率(200以外のステータスコードを返すリクエストの割合)、ブロック高の差(ノードの最新ブロックとチェーンの先端との差)、アクティブなWebSocket接続数、ガス価格(現在の基本手数料および優先手数料の水準)、トランザクションの確認遅延などのメトリクスを追跡します。
メトリクスは、オブザーバビリティにおける第一の防衛線です。メトリクスは、システムの健全性を一目で把握できるリアルタイムのダッシュボードを支えています。また、何らかの値が閾値を超えた際に当直のエンジニアに通知を送るアラートルールを駆動します。さらに、リソース使用量やトラフィックパターンの長期的な傾向を示すことで、by でのキャパシティプランニングを可能にします。
ブロックチェーン エコシステムにおける標準的なメトリクススタックには、通常、収集と保存にPrometheus、可視化とダッシュボード作成にGrafana、アラートルーティングにAlertmanagerまたはPagerDutyが用いられます。クラウドネイティブな代替ツールとしては、Datadog、New Relic、AWS CloudWatchなどが挙げられます。これらのツールはすべて、メトリクスデータが持つ大容量かつ時系列的な特性を処理できるよう設計されています。
メトリクスの限界は、その集計された性質にあります。メトリクスからは、p99のRPCレイテンシが500msを超えたことは分かりますが、具体的にどのリクエストが遅かったのか、それらのリクエストにはどのようなパラメータが含まれていたのか、あるいは遅延が発生した際にノードが何を行っていたのかといった情報は得られません。そのレベルの詳細を知るには、ログやトレースが必要です。
ログの詳細
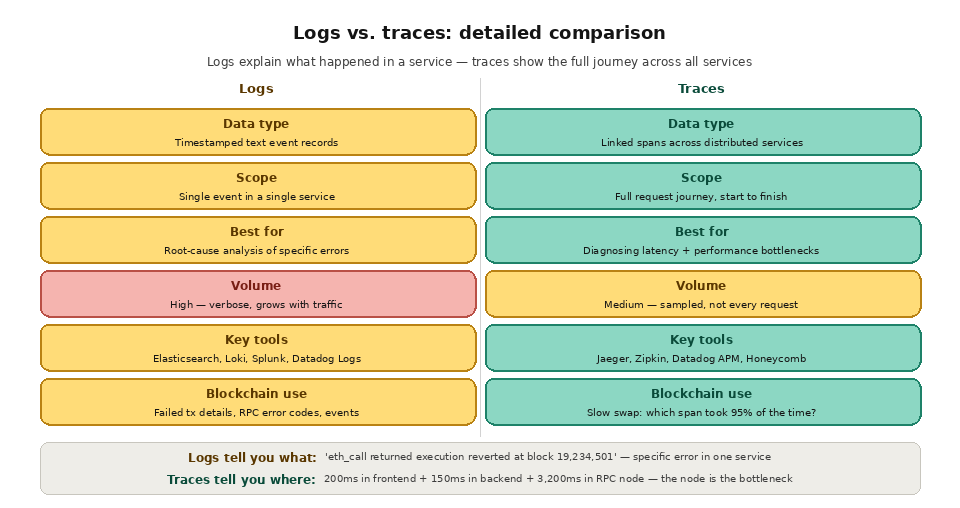
ログとは、個々のイベントに関するタイムスタンプ付きのテキスト記録です。アプリケーションがRPC呼び出しを行ったり、トランザクションを処理したり、エラーが発生したり、ユーザー アクションを処理したりするたびに、その詳細がログエントリとして記録されます。メトリクス(一定期間ごとに集計された数値)とは異なり、ログは豊富なコンテキストを含む個別の記録です。具体的には、リクエストパラメータの全内容、正確なエラーメッセージ、スタックトレース、ユーザー ID、トランザクションハッシュなどが含まれます。
ブロックチェーン アプリケーションにおいて、重要なログカテゴリには、RPCリクエストログ(メソッド、パラメータ、レスポンスコード、リクエストごとのレイテンシ)、トランザクションライフサイクルログ(ハッシュ、保留中→確認済み→完了へのステータス遷移)、スマートコントラクトイベントログ(コントラクトからデコードされたイベントと完全なパラメータデータ)、エラーログ(RPCエラー、タイムアウト例外、ノンスの競合、ガス推定の失敗)、およびアプリケーションログ(ユーザー 認証イベント、ビジネスロジックの決定、状態の変化)が含まれます。
ログは、根本原因分析における主要なツールです。メトリクスによってエラー率の上昇が通知された場合、ログをクエリして最近のエラーエントリを検索し、「by 」というエラータイプでフィルタリングして、そのパターンを特定します。たとえば、ノードが状態データを削除したために、特定の RPC メソッドが「missing trie node」エラーを返すようになった可能性があります。あるいは、並行処理のバグによるノンスの競合が原因で、トランザクションの送信が失敗している可能性もあります。ログには、メトリクスでは把握できない詳細情報が含まれています。
ログ管理ツールには、ElasticsearchとKibana(「ELKスタック」)、Grafana Loki、Splunk、Datadog Logs、AWS CloudWatch Logsなどがあります。これらのツールは、ログエントリを大規模に保存、インデックス化、検索し、全文検索、構造化クエリ、およびサービス間の相関分析を可能にします。
ログに関するトレードオフは、保存容量とコストです。トラフィックの多いアプリケーションにおいて、すべてのRPCリクエストをログに記録すると、1日あたりギガバイト単位のデータが生成されます。構造化ログ(ログエントリが一貫したフィールド名を持つJSON形式で記述されているもの)は、非構造化テキストログよりも効率的なインデックス作成とクエリ実行を可能にし、またログサンプリング(日常的なイベントの一部のみを記録すること)により、エラーや異常の可視性を損なうことなく、ログの容量を削減することができます。
「痕跡」の詳細
トレースは、分散システムを通る単一のリクエストのエンドツーエンドの経過を捉えます。トレースは複数のスパンで構成されており、各スパンは特定のサービスにおける作業単位を表します。スパンは階層的にネストされており(リクエスト全体を表す親スパン、各サブ操作を表す子スパン)、by 共有のトレース ID によって関連付けられています。
ブロックチェーン アプリケーションの場合、1つのトレースには次のようなスパンが記録されることがあります。ユーザー がブラウザで「swap」をクリック(フロントエンドスパン、50ms)、フロントエンドがバックエンドにAPIリクエストを送信(ネットワークスパン、20ms)、バックエンドがガス推定のためにRPCを呼び出す エンドポイント を呼び出してガス料金を見積もる(RPCスパン、150ms)、バックエンドがRPCを呼び出して エンドポイント を呼び出し(RPC スパン、150 ミリ秒)、バックエンドがトランザクションの送信のために RPCを呼び出し(RPC スパン、200 ミリ秒)、バックエンドがトランザクションの受信をポーリングし(複数の RPC スパン、合計 12,000 ミリ秒)、バックエンドがフロントエンドに確認を送信し(ネットワークスパン、15 ミリ秒)、フロントエンドが UI を更新します(フロントエンドスパン、30 ミリ秒)。 このトレースによると、総時間の95%は、アプリケーション自身のコードではなく、オンチェーン の確認を待機している間に費やされていたことがわかります。
分散トレーシングは、by システム内を流れるすべてのリクエストにトレースコンテキスト(トレースIDとスパンID)を注入することで実装されます。各サービスは、自身の処理に対してスパンを作成し、そのトレースコンテキストを下流のサービスへと伝播させます。OpenTelemetry のようなトレーシングライブラリは、ほとんどのプログラミング言語やフレームワーク向けに標準化された計測機能を提供しています。Jaeger、Zipkin、Datadog APM などの可視化ツールは、各スパンのタイミングやネスト構造を示すウォーターフォール図としてトレースを表示します。
トレースは、分散アーキテクチャにおけるレイテンシの問題を診断する上で最も有用です。ユーザー がトランザクションの確認に30秒かかったと報告した場合、トレースを見れば、その30秒がどこで費やされたかが正確にわかります。具体的には、ブロックへの組み込み待ちに25秒、RPC呼び出しに3秒、バックエンド処理に1.5秒、フロントエンドのレンダリングに500ミリ秒といった具合です。 これにより、バックエンドコードを最適化しても意味がないことがすぐにわかります。ボトルネックはチェーンレベルの確認時間にあるのです。
3つを組み合わせて使う
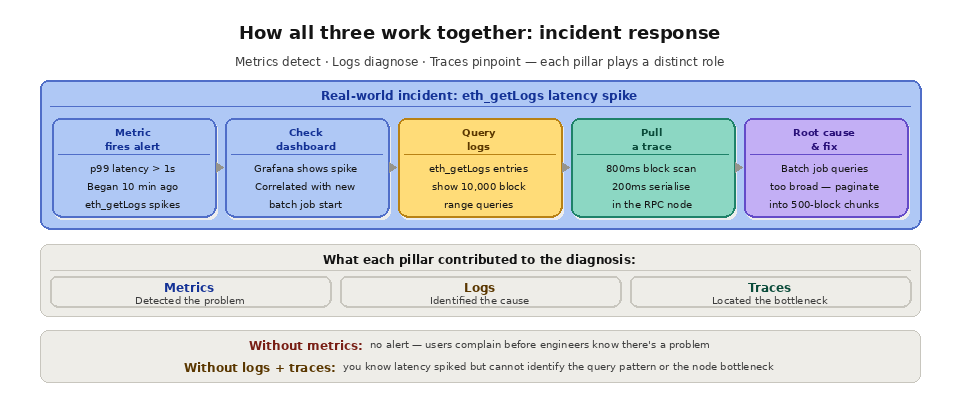
これら3つの柱は、互いに競合するものではなく、相互に補完し合うものです。一般的なインシデント対応のワークフローでは、これら3つすべてが活用されます。
メトリックアラートが発動しました:p99 RPCレイテンシが1秒を超えました。Grafanaダッシュボードを開くと、レイテンシの急上昇が10分前に始まり、eth_getLogs呼び出しの急増と相関していることがわかります。最近のeth_getLogsリクエストについてログを調査したところ、同じタイミングで新しいバッチジョブが開始され、それぞれ10,000ブロックに及ぶ広範囲なログクエリを実行していたことが判明しました。 これらのリクエストのうち1つのトレースを取得したところ、RPCノードがブロックのスキャンに800ms、レスポンスのシリアライズに200msを費やしていたことが判明しました。根本原因は明らかです。バッチジョブによる過度に広範囲なログクエリが、ノードのリソースを不釣り合いに消費しているのです。解決策は、クエリをページネーションして、より狭いブロック範囲に分割することです。
メトリクスがいなければ、ユーザー からエラーが報告されるまで、問題が発生していることに気づくことはできません。ログがなければ、レイテンシが増加したことはわかるものの、どのリクエストが原因なのかは特定できません。トレースがなければ、eth_getLogsの処理が遅いことはわかるものの、ボトルネックがアプリケーションにあるのか、ネットワークにあるのか、それともノードのブロックスキャンにあるのかは特定できません。
どの柱から始めればよいでしょうか?
オブザーバビリティを自力で構築する場合は、まずメトリクスから始めましょう。メトリクスは収集コストが低く、ダッシュボードやアラートを通じて問題を即座に可視化できるからです。次に、構造化ログを追加して、メトリクスによって明らかになった問題を調査できるようにします。システムが複数のサービスにまたがり、レイテンシがどこで蓄積しているかを特定する必要が出てきたら、分散トレーシングを導入しましょう。特にブロックチェーン の場合、これをRPCレイテンシの追跡と組み合わせることで、本番環境で予期せぬ問題が発生しやすいレイヤーをカバーできます。
Quicknode が3つの柱すべてをどのように支えているか
Quicknodeのダッシュボードには、すべての エンドポイント:リクエスト数、レスポンス遅延、エラー率、およびメソッドごとの内訳。これらのメトリクスにより、開発者 は、カスタム計測ツールを導入することなく、ブロックチェーン のインフラストラクチャ層を即座に可視化できます。
チーム がブロックチェーン のメトリクスを既存の可観測性スタックに統合する際、Quicknode の専用Clusters サポート Prometheusエクスポーターを利用することで、ノードレベルのメトリクスをPrometheus、Grafana、Datadog、またはその他の互換性のあるシステムに直接取り込むことが可能になります。これにより、アプリケーションメトリクスとブロックチェーン のインフラストラクチャメトリクスを横断した統一されたダッシュボードを実現できます。
Quicknode Streams データパイプラインの健全性に関する可観測性を提供し、これには配信メトリクス、処理状況、エラー報告などが含まれます。RPC 分析や、お客様独自のアプリケーションレベルのロギングおよびトレーシングと組み合わせることで、Quicknode は、開発者 に対し、ブロックチェーン スタックのあらゆるレイヤーにわたる問題を診断・解決するために必要な、包括的な可観測性の全体像を提供します。
よくある質問
メトリクス、ログ、トレースは、モニタリングと同じものなのでしょうか?
いいえ。それらは基礎となるデータ型です。モニタリングとは、あらかじめ定義されたシグナルを監視し、それに基づいてアラートを発する手法であるのに対し、オブザーバビリティとは、これら3つのデータ型を用いて、事前に予測できなかった問題を調査するものです。
この3つのうち、保管にかかる費用が最も高いのはどれですか?
ログは、個々のイベントをすべて詳細に記録するため、通常最もコストがかかります。メトリクスは集計が行われるため最もコストが低く、トレースは通常、すべてのリクエストについて記録されるのではなくサンプリングされるため、その中間に位置します。
小規模なアプリケーションの場合、これら3つすべてが必要なのでしょうか?
最初はそうではありません。多くのチーム は、メトリクスや基本的なログから始めます。分散トレーシングが有用になるのは、リクエストが複数のサービスにまたがり、レイテンシの原因を単一のコンポーネントに特定することが困難になった場合です。
OpenTelemetryとは何ですか?
OpenTelemetry は、ベンダーに依存しない方法でメトリクス、ログ、トレースを生成するためのオープンスタンダードおよびライブラリ群です。これにより、一度だけ計測設定を行うだけで、Prometheus、Jaeger、Datadog などのさまざまなバックエンドへデータをエクスポートすることができます。
これは、ブロックチェーン のRPCに具体的にどのように適用されるのでしょうか?
RPC呼び出しは、レイテンシやエラーの一般的な原因となります。そのため、リクエストレート、レイテンシのパーセンタイル、エラーコードをメトリクスとして追跡し、失敗した呼び出しをログに記録し、処理に時間がかかるリクエストをエンドツーエンドでトレースすることで、状況を完全に把握することができます。当社のNode.jsガイド『信頼性 』で解説しているような、信頼性の高いNode.jsインフラストラクチャを導入することで、そもそも診断が必要となるインシデントの発生を削減できます。
参考資料
メトリクス、ログ、トレースの比較 - Quicknode ドキュメント
モニタリングブロックチェーン インフラストラクチャ-Quicknode 用語集
Quicknode コア API
Quicknode 専用Clusters