「Node信頼性 」の解説:ブロックチェーン にとってなぜ重要なのか |Quicknode🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る 回答>ブロックチェーン ノードについて学ぶ>信頼性 ノードが重要な理由 // Tags
ノード信頼性ブロックチェーン 稼働時間
要約:Node 信頼性 とは、 ブロックチェーン ノードが、ダウンタイム、エラー、または古いデータの影響を受けることなく、リクエストにどれほど一貫して正確に応答できるかを測る指標です。 ブロックチェーン から読み込みや書き込みを行うあらゆるアプリケーションにおいて、信頼性の低いノードインフラストラクチャは、トランザクションの失敗、残高の不一致、イベントの取りこぼし、そしてユーザー の利用体験の低下につながります。 本番環境において、ノードの信頼性 は単なる「あれば便利なもの」ではありません。それは、他のすべてが依存する基盤そのものです。
わかりやすい説明
アプリケーションとブロックチェーン とのあらゆるやり取りは、ノードを経由して行われます。ユーザー がウォレットの残高を確認する際、ノードがそのクエリに応答します。誰かが分散型取引所でスワップを申請すると、ノードがそのトランザクションをブロードキャストします。バックエンドがスマートコントラクトのイベントをリッスンしている場合、ノードがそれらのイベントを配信します。ノードの応答が遅かったり、ダウンしていたり、古いデータを返したりすると、アプリケーションに不具合が生じ、ユーザー や収益に直接的な影響を及ぼします。
信頼性 ノードについては、従来のウェブアプリケーションにおけるデータベースの稼働時間と同じように考えてください。データベースがオフラインになると、アプリはデータの読み取りや書き込みができなくなります。ユーザー エラーが発生し、トランザクションが失敗し、信頼が損なわれます。ブロックチェーン ノードは、提供するデータが金融関連である点を除けば、データベース層と同じ機能を果たしています。 残高情報が古くなると、ユーザー が当座貸越状態になる可能性があります。トランザクションが失われると、取引の機会を逃すことになりかねません。イベントの遅延は、DeFiプロトコルにおいて誤った清算を引き起こす可能性があります。リスクはより高く、失敗に対する許容度はより低くなっています。
信頼性の低いノードが実際にどれほどのコストをもたらすのか
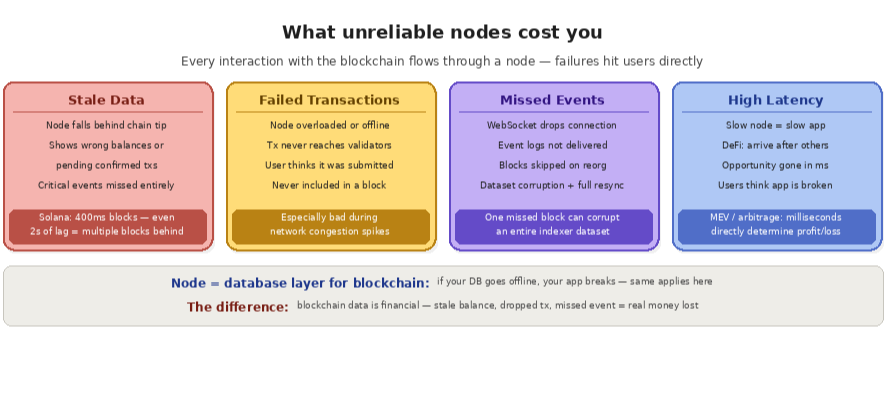
ノードの信頼性 が不十分であることの悪影響はさまざまな形で現れますが、そのほとんどは本番環境で問題が発生するまではすぐには明らかになりません。
古いデータは、最も危険な障害モードの一つです。ノードがチェーンの先端(最も最近確認されたブロック)に遅れをとると、ノードは古い状態を配信し始めます。その結果、アプリケーションがユーザー で既に存在しない残高を表示したり、すでに確認済みのトランザクションを「保留中」として表示したり、重要なスマートコントラクトのイベントを完全に見逃したりする可能性があります。Solana のように400ミリ秒ごとにブロックが生成される高速チェーンでは、わずか数秒の同期遅延でも、アプリケーションが実際の状態より複数のブロック分遅れてしまう可能性があります。
SOC 2 タイプ II 認証取得・ISO 27001
失敗したトランザクションも、もう一つの大きなコストとなります。 ノードを介してトランザクションを送信する際、そのノードはネットワークのメモプール(またはそれに相当するもの)にそれをブロードキャストする必要があります。ノードが過負荷状態にある場合、ピアとの接続が切断されている場合、あるいは設定が不適切な場合、そのトランザクションはバリデーターに到達しない可能性があります。ユーザー は自分のトランザクションが送信されたと認識していますが、実際にはブロックに組み込まれることはありません。高スループットのチェーンやネットワークが混雑している時期には、性能が不十分だったりメンテナンスが不十分なノードにおいて、このような事態が頻繁に発生する可能性があります。
イベントの欠落は、ブロックチェーン のリアルタイムデータに依存するあらゆるアプリケーションに影響を及ぼします。ノードがWebSocket接続を切断したり、イベントログの配信に失敗したり、再編成中にブロックをスキップしたりすると、アプリケーションはデータを失うことになります。インデクサー、分析プラットフォーム、およびオンチェーン のアクティビティに関する完全な記録を必要とするあらゆるシステムにおいて、たった1つのブロックが欠落しただけでもデータセットが破損し、完全な再同期が必要になる可能性があります。
レイテンシは、競争を伴うユースケースに直接影響を及ぼします。DeFi取引 、MEVの抽出、およびアービトラージにおいては、ミリ秒単位の差が重要になります。ノードの応答が遅いと、自分の取引が他人の取引よりも後に到着することになり、機会を逃してしまいます。タイミングがそれほど重要ではないアプリケーションであっても、高いレイテンシはユーザー ユーザー体験を低下させます。ユーザー ユーザーは、ウォレットの残高が即座に更新され、取引が迅速に確認されることを期待しています。ノードの応答が遅いと、ブロックチェーン 自体のパフォーマンスが良好であっても、アプリケーションが正常に動作していないように感じられてしまいます。
ノードの信頼性を左右する要因
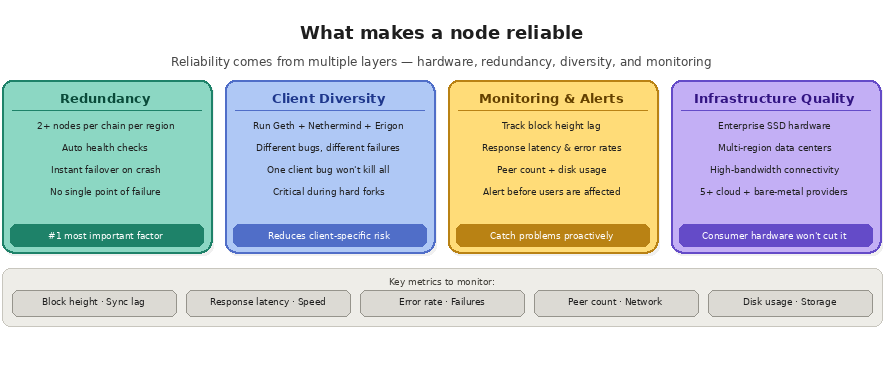
信頼性 これには、ハードウェアの品質、ソフトウェアの設定、ネットワーク接続性、冗長性、運用監視など、複数の要素が関わっています。一般向けのハードウェア上で動作し、家庭用インターネット回線に接続された単一のノードでは、複数のデータセンターやクラウドプロバイダーに分散配置され、専門的に管理されているノードクラスターの信頼性 には到底及ばないでしょう。
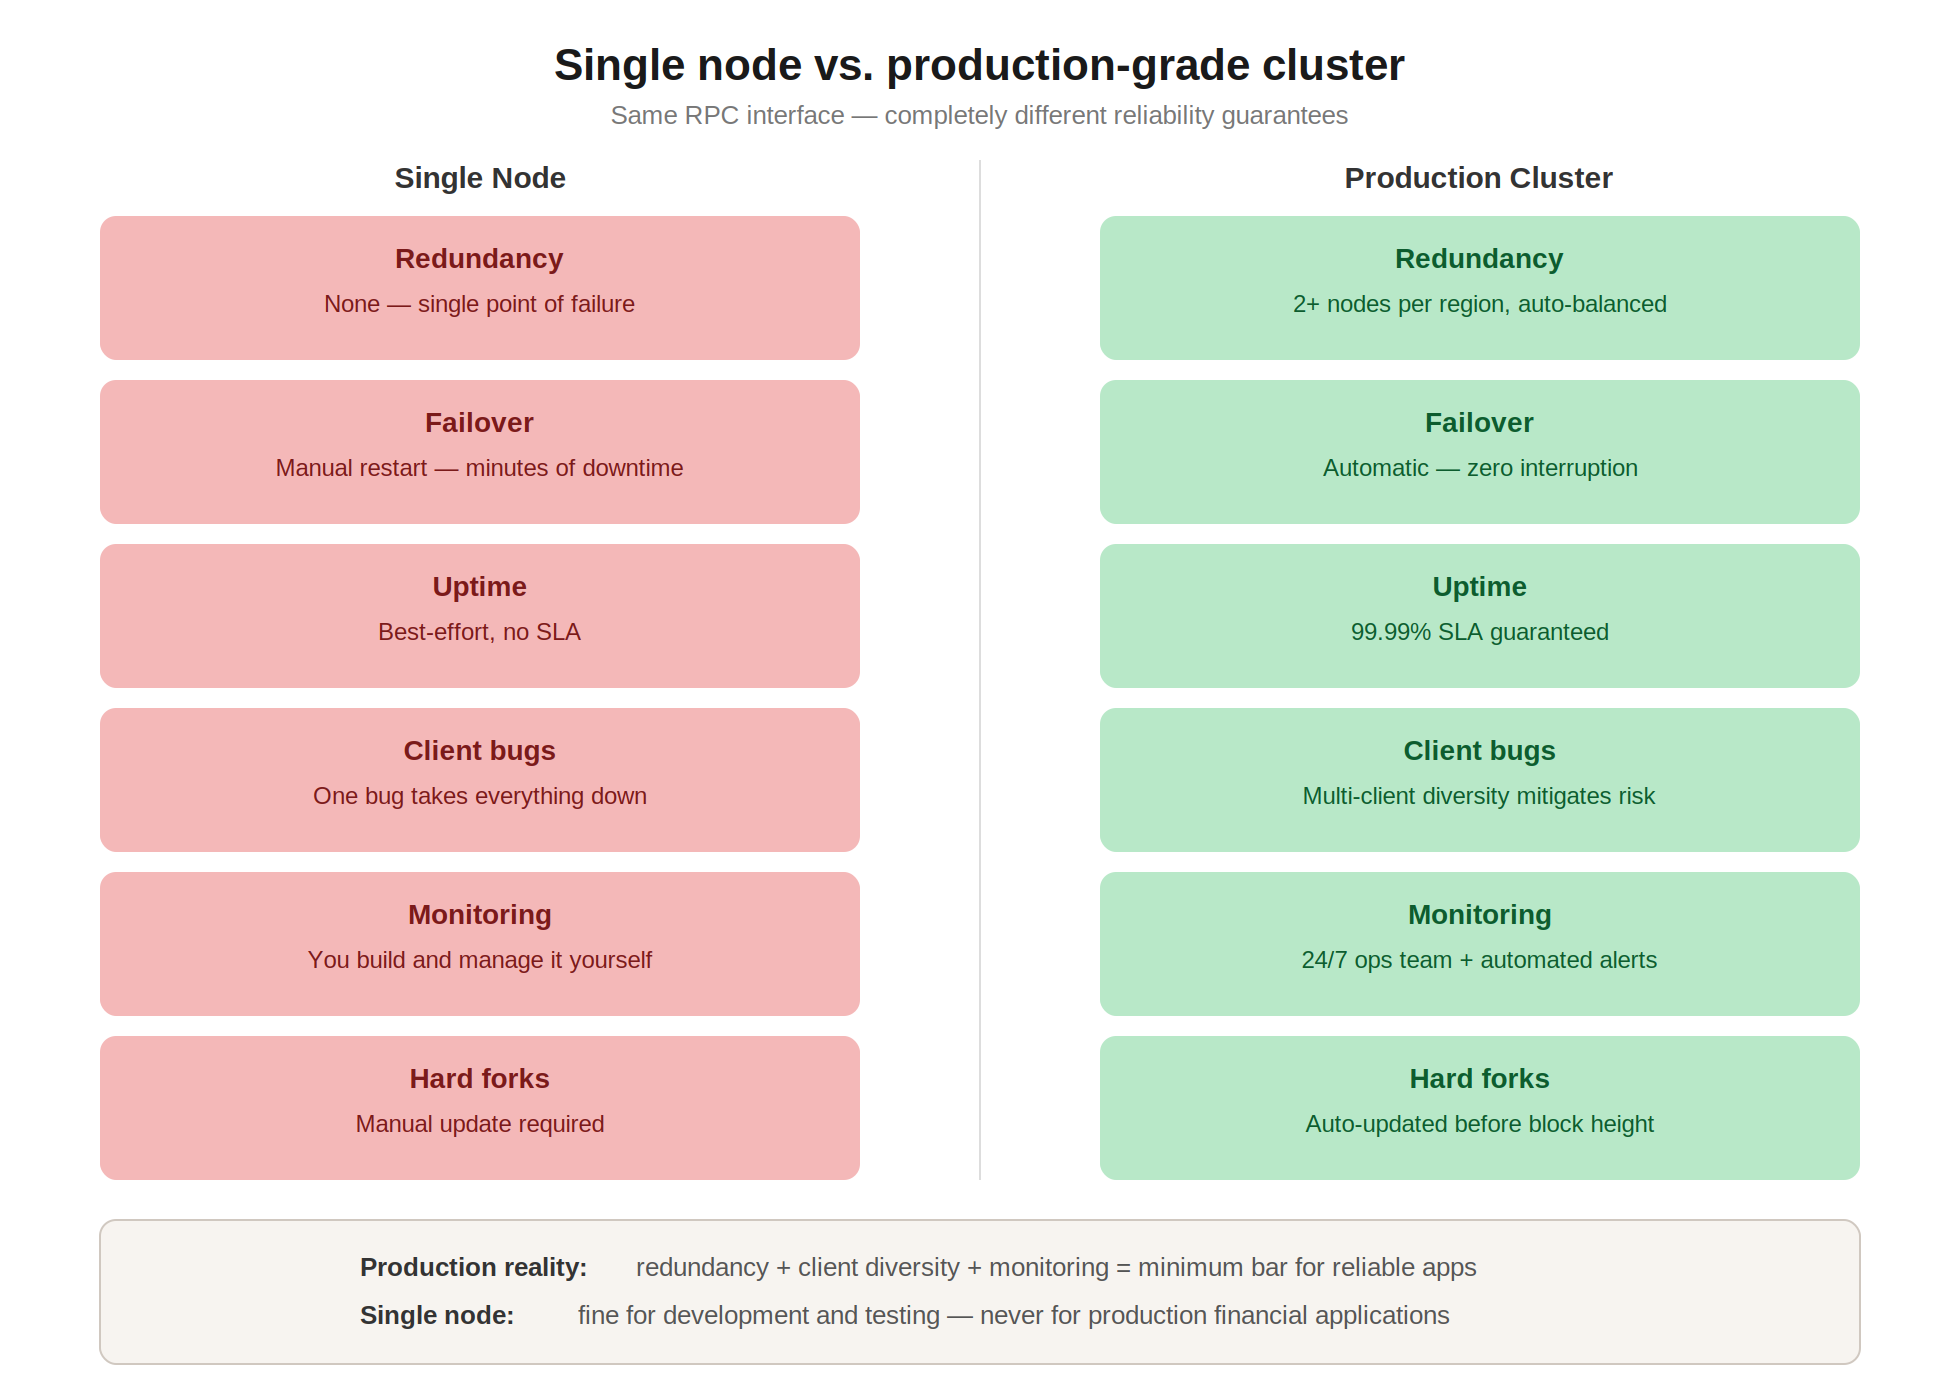
冗長性は最も重要な要素です。1つのノードが(クラッシュ、ディスク障害、またはクライアント側のバグにより)ダウンした場合でも、冗長化されたシステムであれば、アプリケーションに一切の支障をきたすことなく、正常なノードへフェイルオーバーします。冗長性がなければ、単一の障害点によってアプリケーション全体が利用不能になる可能性があります。本番環境向けのインフラストラクチャでは通常、1つのリージョン内で同じチェーンに属する2つ以上のノードを稼働させ、自動ヘルスチェックとトラフィックのルーティングが行われます。
クライアントの多様性も重要です。ブロックチェーン のクライアント実装(例えば、Ethereum にあるGeth、Nethermind、Erigonなど)は、それぞれパフォーマンス特性、バグ、障害発生のパターンが異なります。複数のクライアント実装を稼働させることで、あるクライアントのバグによってインフラ全体がダウンしてしまうリスクを軽減できます。これは、クライアント固有の問題が最も発生しやすいハードフォークやプロトコルアップグレードの際、特に重要です。
ユーザー に悪影響が及ぶ前に問題を早期に発見するためには、監視とアラート機能が不可欠です。適切に運用されているノードインフラストラクチャでは、ブロック高(同期遅延の検出用)、応答遅延、エラー率、ピア数、ディスク使用率などのメトリクスが継続的に追跡されます。いずれかのメトリクスが閾値を超えた場合、自動アラートが発動し、問題が本番環境に波及する前に調査やフェイルオーバーが実行されます。
信頼性 ノードはどのように測定されるのですか?
信頼性 これは単一の数値ではなく、それらを総合して、本番環境でそのノードが信頼できるかどうかを示す一連のシグナルです。以下の表には、最も重要なメトリクス、それぞれの意味、および本番環境向けの設定で維持すべき範囲が示されています。
メートル法 | そこから何がわかるか | 生産目標 |
|---|
稼働時間に関するSLA | 利用可能な時間の割合 エンドポイント 利用可能な時間の割合 | 99.9%以上 |
エラー率 | エラーを返すリクエストの割合 | 0.1%未満 |
同期の遅れ | チェーン先端からの距離 | 0~1ブロックの範囲内 |
応答遅延(p99) | 回答のうち最下位1% | 500ミリ秒未満 |
ピア数 | 安定したネットワーク接続 | 顧客の最低基準を上回って安定している |
稼働時間は最も注目される指標ですが、ノードが「稼働中」であっても、最新の状態から遅れていたり、エラーを返していたりする場合、信頼性は低いと言えます。こうした兆候は、スポットチェックではなく、継続的に監視してください。xml-ph-0000@deepl.internalインフラストラクチャの監視方法に関する全体像については、 エンドポイント ブロックチェーン インフラの監視を参照してください。
ブロックチェーン ノードが障害を起こす原因は何ですか?
ノードの障害は、内部的および外部的な要因の両方によって発生します。 内部要因としては、ディスク容量の不足、メモリリーク、クライアントソフトウェアのバグなどが原因で、ノードがクラッシュしたり動作が停止したりすることがあります。外部要因としては、ネットワークのパーティション、ピアの喪失、ネットワーク輻輳時のトラフィック急増などが、リソースが不足しているノードに過大な負荷をかけ、機能不全に陥らせることがあります。プロトコルのアップグレードやハードフォークは特にリスクの高い局面です。なぜなら、特定のクライアントに固有のバグによって、そのクライアントを実行しているすべてのノードがダウンする可能性があるからです。 ブロックチェーン の一般的な障害モードを理解しておくことで、システムが完全に停止することなく、段階的に機能を低下させるようなインフラストラクチャを設計できるようになります。
フェイルオーバーは、ノードの信頼性 をどのように向上させるのでしょうか?
フェイルオーバーとは、複数の個別のノードを1つの信頼性の高いサービスとして機能させる仕組みです。ヘルスチェックによって各ノードの状態が監視され、いずれかのノードの状態が悪化したりオフラインになったりした場合、トラフィックは自動的に正常なノードに再ルーティングされるため、アプリケーション側ではサービス停止が全く感じられません。これが高可用性の核心であり、インフラの冗長性、つまり常にバックアップが利用できるよう、複数のノードを稼働させることに依存しています。フェイルオーバーの仕組みと、実際の運用においていかにシームレスな切り替えが行われるかについては、「フェイルオーバーとは」をご覧ください。
独自のノードを運用すべきか、それともプロバイダーを利用すべきか?
独自のノードを運用すれば完全な制御が可能になりますが、信頼性 の負担すべてがequipe に課せられます。具体的には、ハードウェア、冗長性、監視、アップグレード、そして24時間365日のオンコール対応などです。 マネージドプロバイダーを利用すれば、その運用負荷を肩代わりしてもらい、最初のリクエストから分散型で冗長化されたノード群を利用できます。適切な選択は、規模、予算、運用リスクに対する許容度によって異なり、by のワークロードによっても異なる可能性があります。アーカイブノードはフルノードに比べて自己ホスティングの負担がはるかに大きいためです。判断の指針となるフレームワークについては、「構築か購入か」を参照してください。
Quicknode の提供方法信頼性
Quicknodeのインフラストラクチャは、大規模な信頼性 の運用を目的として構築されています。このプラットフォームは、80以上のブロックチェーン ネットワークを介して毎日数十億件のAPIリクエストを処理し、99.99%の稼働率をSLAとして保証しています。この信頼性 は、14以上のリージョンと5以上のクラウドおよびベアメタルプロバイダーにまたがるグローバルに分散されたアーキテクチャ、チェーンごとの複数のクライアント実装、自動フェイルオーバーとロードバランシング、24時間365日の監視by 、および専任のブロックチェーン 運用チームequipe によって実現されています。
Quicknode 用途に特化したノードclusters を使用しており、これにより、トラフィックは行われるリクエストの種類に最適化されたノードへとルーティングされます。読み取りが中心のワークロード、アーカイブクエリ、トランザクションのブロードキャストは、それぞれその特定のパターンに合わせて調整されたインフラストラクチャに処理されます。このアプローチにより、トラフィックが急増してもパフォーマンスが低下することなく、変動する負荷の下でも一貫したパフォーマンスを実現します。
最も厳しい信頼性 要件を持つチーム 向けに、QuicknodeのDedicatedClusters は、完全に分離されたプライベートノードインフラストラクチャを提供します。各クラスターは、リージョン内で独立した配信経路を持つ冗長化されたノードを稼働させているため、他の顧客からの共有トラフィックがお客様のパフォーマンスに影響を与えることはありません。DedicatedClusters には、稼働時間を保証するSLA、カスタムモニタリング用のPrometheus Exporterサポート 、および運用状況を完全に可視化するための14日間のログ保持機能が含まれています。このレベルのインフラストラクチャは、Web3における最大規模のウォレット、取引所、およびDeFiプロトコルのいくつかを支えています。
よくある質問
ブロックチェーン にあるノード「信頼性 」とは何ですか?
ノードの信頼性 とは、ブロックチェーン ノードが、ダウンタイム、エラー、または古いデータの影響を受けることなく、リクエストにどれほど一貫して正確に応答できるかを示す指標です。信頼性の高いノードは、チェーンの先端と常に同期を保ち、迅速に応答し、常に利用可能な状態を維持するため、アプリケーションはブロックチェーン のデータを中断なく読み書きすることができます。
ブロックチェーン ノードにとって、適切な稼働率SLAとはどのようなものでしょうか?
本番環境のアプリケーションは、99.9%以上の稼働率を目標とすべきであり、これにより年間ダウンタイムはおよそ9時間未満に抑えられます。取引所やDeFiプロトコルなどの要求の厳しいワークロードでは、多くの場合99.99%のSLAが求められ、年間ダウンタイムは1時間未満に制限されます。
信頼性 ノードをどのように監視しますか?
ブロックの高さの差、エラー率、応答遅延、およびピア数を継続的に追跡し、いずれかが閾値を超えた場合にアラートを発行します。これらのメトリクスをログやトレースと組み合わせることで、ノードのパフォーマンスが低下していることだけでなく、その原因も把握できるため、ユーザー が気付く前にフェイルオーバーを行ったり、問題を修正したりすることができます。
「ノードの信頼性 」と「ノードのパフォーマンス」の違いは何ですか?
パフォーマンスとは速度、つまりノードがどれほど速く応答するかを指します。信頼性 とは一貫性、つまりノードが正しく応答し、長期にわたって可用性を維持できるかどうかを指します。ノードは高速であっても頻繁にクラッシュすれば信頼性が低く、逆に信頼性が高くても処理能力が低ければ動作が遅くなります。本番環境のインフラストラクチャには、この両方が必要です。
複数のノードを使用することで、信頼性 のパフォーマンスは向上しますか?
はい。自動フェイルオーバー機能を備えた冗長ノードを運用することで、単一障害点が排除されるため、1つのノードがダウンしてもアプリケーションが停止することはありません。この冗長性は、ブロックチェーン インフラストラクチャにおける高可用性の基盤となっています。
参考資料