要約: ブロックチェーン は3つのレイヤーで障害が発生する。コンセンサス層の障害には、バリデーターのバグ、ネットワークの分断、51%攻撃などが含まれる。アプリケーション層の障害には、スマートコントラクトのバグ、オラクルの操作、ガバナンスの悪用などが含まれる。インフラ層の障害には、ノードのクラッシュ、プロバイダーのサービス停止、クラウドのインシデントなどが含まれる。各レイヤーには独自の防御策が必要である。ブロックチェーン アプリ では実在の資金が動いているため、これらの障害は重大であり、障害が発生した場合の損失は一般的なソフトウェアの場合よりもはるかに大きくなる。
わかりやすい説明
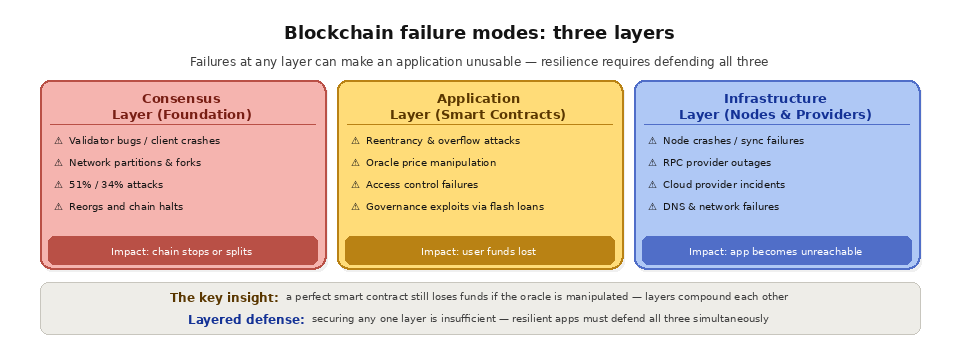
ブロックチェーン これらはしばしば「トラストレス」かつ「immutable 」と呼ばれる。しかし、だからといって故障しないわけではない。他の複雑な分散システムと同様、ブロックチェーン もさまざまな形で、またさまざまなレベルで障害が発生する可能性がある。
開発者 の重要なポイントは、障害が層ごとに積み重なるという点です。たとえセキュアなスマートコントラクトであっても、データを供給するオラクルが誰かに操作された場合、ユーザー の資金を失う可能性があります。また、適切に作成されたアプリであっても、その基盤となるノードがダウンすれば機能しなくなる可能性があります。
これを建物に例えて考えてみてください。基礎(コンセンサス層)にひびが入る可能性があります。配管や配線(アプリケーション層)から水漏れやショートが発生する可能性があります。管理会社(インフラ層)が倒産する可能性があります。それぞれの障害には異なる種類の保護対策が必要ですが、耐障害性の高いシステムは、これら3つすべてに対して同時に防御します。
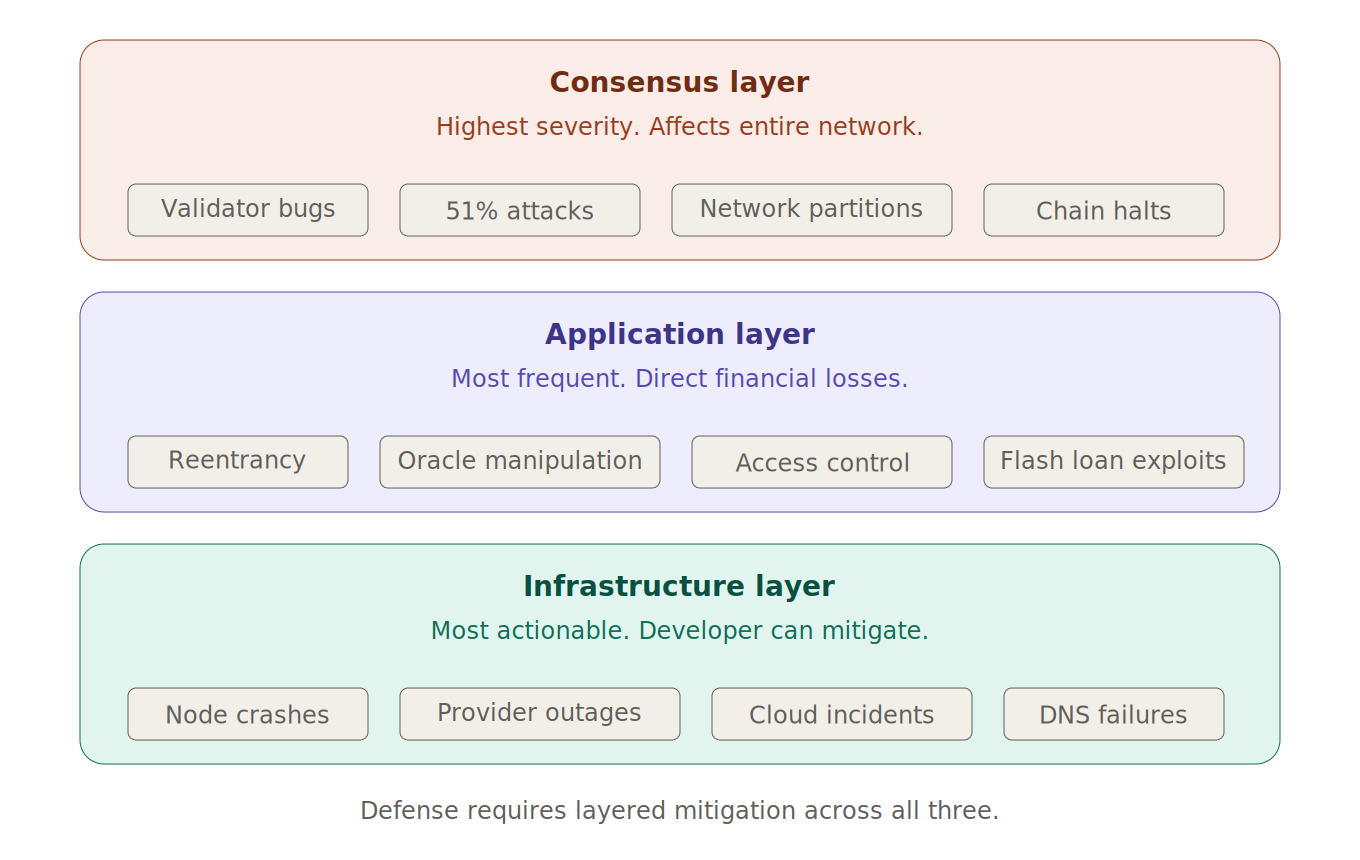
コンセンサス層の障害
コンセンサス層は、あらゆるブロックチェーン の基盤です。これは、バリデーターがどのトランザクションが有効か、どのブロックがチェーンに追加されるかについて合意を形成する仕組みです。コンセンサスが成立しない場合、その被害はどの層よりも甚大であり、チェーンが停止したり、再編成されたり、矛盾するブロックが生成されたりする可能性があります。
バリデーターのバグは、コンセンサス障害の中で最も一般的なもののひとつです。ブロックチェーン のクライアントソフトウェアは複雑です。ブロックの生成、認証ロジック、または状態遷移にバグがあると、バリデーターが無効なブロックを生成したり、ラウンドの途中でクラッシュしたり、正しい状態について意見が一致しなくなったりする可能性があります。
あるクライアントがネットワークを支配すると、リスクが高まります。もしバリデーターの70%が同じクライアントを実行しており、そのクライアントにバグがあった場合、ネットワークの70%が一斉に機能しなくなります。そのため、ブロックチェーン のセキュリティにおいて、クライアントの多様性、つまり同じプロトコルに対する複数の独立した実装が、頻繁に話題に上るのです。
ネットワークの分断は、バリデーターのグループ同士が通信できなくなった際に発生します。一般的な原因としては、インターネット回線の障害、標的型DDoS攻撃、ルーティングの障害などが挙げられます。
スプリットのいずれの側も合意の閾値(通常はステークされたウェイトの3分の2)に達しない場合、ブロックの生成は停止します。
もし双方が依然として閾値に達することができる場合、チェーンは一時的に分岐し、それぞれの側が独自のブロックを生成することになります。
ネットワークが再接続されると、再編成によってフォークが解消されます。短い方のフォーク上のトランザクションは取り消されます。
51%攻撃(あるいはBFTベースのチェーンに対する34%攻撃)により、過半数のコンセンサス権限を持つ攻撃者は、直近の取引履歴を書き換えることができます。その仕組みは以下の通りです:
攻撃者は、パブリックチェーンから分岐したプライベートチェーンを構築する。
プライベートチェーンは、パブリックチェーンよりも多くのプルーフ・オブ・ワークやバリデーターの認証を集めます。
攻撃者はそれをブロードキャストします。そのブロードキャストの方が重みが高いため、ネットワークはそれを受け入れ、パブリックチェーンの直近のブロックを破棄します。
これにより、二重支払いが可能になります。攻撃者はパブリックチェーン上で資金を送金し、確認を待ちます。その後、その取引を省いたプライベートチェーンを公開します。こうして攻撃者は商品を受け取り、資金も手元に残すことになります。
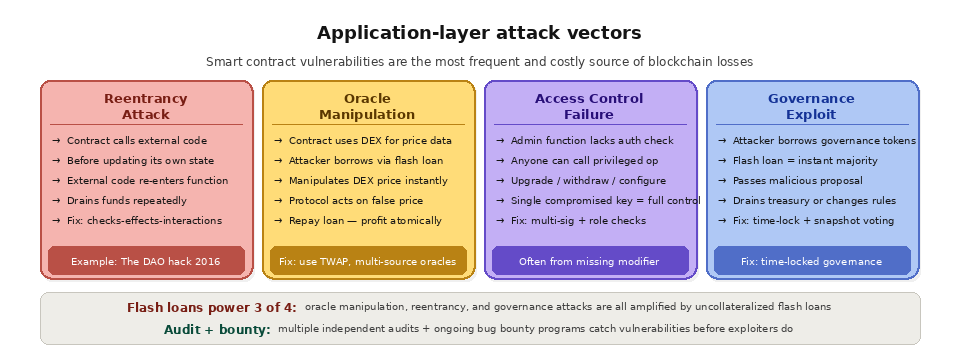
アプリケーション層の障害
アプリケーション層には、スマートコントラクト、DeFiプロトコル、オラクル、そして数十億ドル規模のユーザー 資金を管理するオンチェーン ロジックが含まれます。この層での障害は最も頻繁に発生し、最も大きな損害をもたらします。
再入攻撃は、自身の状態を更新する前に別のコントラクトを呼び出すコントラクトを標的とします。呼び出されたコントラクトは、元のコントラクトに「再入」し、更新が反映される前に同じ関数を再度実行することができ、その結果、資金が流出し得るのです。
2016年のDAOハッキング事件は、再入攻撃によるものでした。この事件は約6,000万ドルの損失をもたらし、Ethereum とEthereum Classicの分裂につながりました。この脆弱性は長年にわたり広く知られていましたが、依然として「チェック・効果・相互作用」のパターンを省略した新しいスマートコントラクトに見受けられます。
整数のオーバーフローおよびアンダーフローは、算術演算の結果、そのデータ型が保持できる範囲外の数値が生成され、値がラップオーバーした際に発生します。本来は負の数になるはずの減算が、代わりに巨大な正の数を返す可能性があり、これにより攻撃者が自身が所有する以上のトークンを請求できてしまう恐れがあります。Solidity 0.8.0 では、オーバーフローが発生した場合にトランザクションをリバートする組み込みのチェック機能が追加されました。しかし、古いバージョンで構築されたコントラクトや、unchecked math ブロックを使用しているコントラクトは、依然としてこのリスクにさらされています。
アクセス制御の失敗は、管理用関数が呼び出し元を確認しない場合に発生します。その結果、契約の所有者や特定のロールのみが実行できるはずの関数を、誰でも実行できてしまいます。一般的な例としては、次のようなものがあります:
誰でもコントラクトのロジックを置き換えられてしまう、保護されていないアップグレード機能
所有権チェックのない引出関数
誤って設定されたロールベースのアクセス制御
オラクル操作は、オンチェーン とオフチェーンデータの間の橋渡しとなる部分を攻撃するため、特に危険です。貸付、清算、またはデリバティブ取引に価格オラクルを使用している契約は、偽の価格に基づいて動作するように仕向けられる可能性があります。
フラッシュローンが最も一般的な手法です。単一のアトミックトランザクションにおいて、攻撃者は以下の操作を行います:
大量のトークンを借り入れる
これらを利用して、オラクルが読み取るDEXの価格を動かす
偽の価格で、対象プロトコル上で利益をもたらすアクションをトリガーする
ローンを返済する
対象のスマートコントラクトは、その設計通りの機能を正確に果たしました。問題はオラクルの設計にあり、短期的な価格変動が考慮されていなかったのです。
ガバナンスの脆弱性を悪用する攻撃は、DAOやDeFiプロトコルの投票システムを標的としています。攻撃者は、多くの場合フラッシュローンを利用して十分な量のガバナンストークンを入手し、悪意のある提案を可決させます。その提案によって、トレジャリーの資金が流用されたり、プロトコルの設定が変更されて脆弱性が生じたり、あるいは攻撃者に管理者権限が渡されたりする可能性があります。
インフラストラクチャ層の障害
インフラの障害は、ブロックチェーン 自体を停止させるわけではありません。アプリ やユーザー がそのサーバーにアクセスできなくなるだけです。開発者やエンドユーザーユーザー にとっては、その結果はチェーンの障害と何ら変わりなく、アプリが動作しなくなるように見えます。
ノードのクラッシュや同期の失敗により、ノードがオフラインになったり、古いデータを配信したりすることがあります。チェーンの先端から数ブロック遅れをとったノードは、古い残高を返したり、最近のトランザクションを見逃したり、最新の状態に依存する有効なトランザクションを拒否したりする可能性があります。フェイルオーバー機能を持たずに単一のノードに依存しているアプリは、そのノードがダウンすると、それとともに動作しなくなります。
プロバイダーのサービス停止は、そのプロバイダーを利用するすべての顧客に同時に影響を及ぼします。主要なRPCプロバイダーがダウンすると、そのエンドポイントを使用しているすべてのアプリがチェーンへのアクセスを失います。これは、本来は分散化されるべきシステム内に存在する集中化のリスクです。つまり、何千ものアプリ が1つのプロバイダーを共有している場合、そのプロバイダーが単一障害点となってしまうのです。
クラウドプロバイダーでの障害は、他のクラウドサービスと同様に、ブロックチェーン のノードにも影響を及ぼします。AWS、GCP、あるいはその他のクラウドでリージョン全体の障害が発生すると、そのリージョン内のすべてのノードがオフラインになります。ブロックチェーン のノードの大部分は、ごく少数のクラウドプロバイダー上で稼働しているため、1つのクラウドで障害が発生しただけで、ネットワークの状態やアプリケーションの稼働時間に、予想以上に大きな悪影響が及ぶ可能性があります。
DNS やネットワークの障害が発生すると、エンドポイント自体が正常に動作していても、アプリ がRPCエンドポイントに到達できなくなる可能性があります。DNSハイジャック、BGPルーティングの問題、TLS証明書の問題などは、いずれもアプリとそのインフラストラクチャ間の接続を遮断する原因となります。
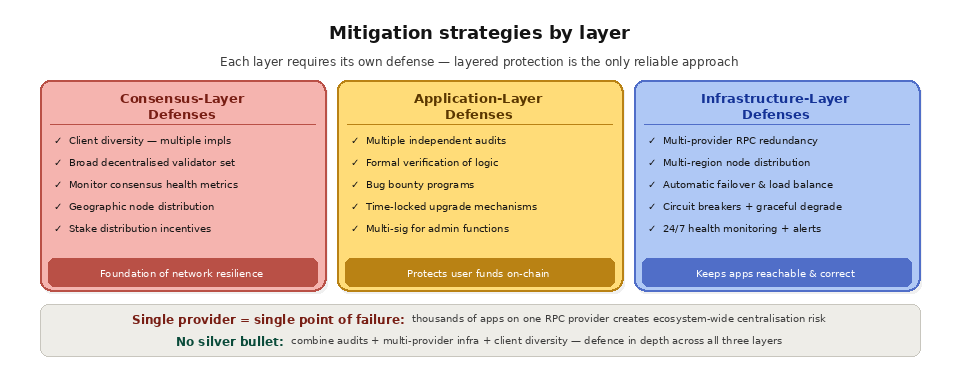
緩和策
こうした障害に対処するには、これら3つのレベルすべてを網羅した多層的なアプローチが必要となります。
コンセンサス層においては、クライアントの多様性が最も効果的な防御策となります。複数のクライアント実装が存在すれば、そのうちの一つにバグがあってもネットワーク全体がダウンすることはありません。ステークの分散も重要です。広範で分散化されたバリデーターセットがあれば、協調的な障害や51%攻撃のリスクを低減できます。
アプリケーション層における主な防御策は、セキュリティ監査、形式検証、およびバグ報奨金制度です:
スマートコントラクトの展開前に、複数の独立した監査機関に監査を依頼してください。
形式検証を用いて、コードが仕様と一致していることを数学的に証明します。これにより、手動によるレビューでは見逃されがちなバグを検出できます。
ホワイトハットハッカーに対し、脆弱性を発見し、責任を持って開示した際に報酬を支払うバグ報奨金プログラムを実施する。
タイムロック機能により、変更が有効になる前にコミュニティが内容を確認できるようになります。これにより、悪意のあるアップグレードやバグを含むアップグレードが即座に公開されるのを防ぎます。
管理機能にはマルチシグネチャによる承認を必須とし、1つの鍵が盗まれただけでは特権操作を実行できないようにする。
インフラストラクチャ層においては、プロバイダー、リージョン、クラウドをまたぐ冗長性が基盤となります。単一のRPCプロバイダー、データセンター、またはクラウドに依存してはいけません。
回路遮断器は、故障した部品が、それに依存しているシステム全体をダウンさせる前に、その部品の電源を遮断します。
グレイスフル・ディグラデーションにより、一部のコンポーネントがダウンしている場合でも、残高の表示といった主要な機能は引き続き動作します。
Quicknode どのように耐障害性をQuicknode
Quicknodeのインフラストラクチャは、インフラストラクチャ層での障害を吸収できるよう構築されています:
14以上の地域および5以上のクラウド・ベアメタルプロバイダーにわたる地理的展開
可能な範囲での顧客の多様性
正常に動作していないノードへのリクエストを迂回させる自動フェイルオーバー
24時間365日の監視by 専任のブロックチェーン 運用チームequipe
Quicknode Streams データパイプラインの耐障害性を高め、配信の保証、ファイナリティ順の処理、および再編成の自動処理を実現します。再編成が発生した場合、Streams は影響を受けたデータを自動的に検出し、修正します。アプリケーション層の監視については、Streams を使用することで、特定のコントラクトイベント、異常なトランザクションパターン、およびエクスプロイトの進行を示唆する可能性のある状態の変化を監視できます。
稼働時間の要件が最も厳しいチーム 向けに、Quicknode の専用Clusters は、共有トラフィックとは分離された、稼働時間を保証するSLAを備えた独立したインフラストラクチャを提供します。他の顧客のトラフィック急増によってお客様のパフォーマンスが低下することはないため、ミッションクリティカルなアプリ に必要な分離性が確保されます。
ブロックチェーン で最もよく見られる不具合にはどのようなものがありますか?
上記の障害は、発生したレイヤーごとにby グループに分類されます。また、各レイヤーには、それぞれの障害に対する防御責任者が明記されています。以下の表には、最も一般的な障害、それぞれの例、および修正箇所が記載されています。
レイヤー | よくある不具合 | 例 | 緩和策の現場 |
|---|---|---|---|
コンセンサス | 51%攻撃または再編成 | 多数派が近現代史を書き換える | プロトコルとバリデータセット |
コンセンサス | ネットワークの分割または停止 | バリデーターが閾値に達することができない | プロトコルとクライアントの多様性 |
ブロックチェーン の障害が損失につながる前に、どのように検知すればよいでしょうか?
検知の有無が、インシデントの封じ込めと大惨事の分かれ目となります。 ブロックチェーン インフラストラクチャを継続的に監視することで、ノードの遅延、エラーの急増、同期のずれなどをリアルタイムで把握できます。より広範な可観測性により、これらのシグナルをアプリケーションの挙動と関連付けることができるため、ユーザー が影響を受ける前に、エクスプロイトやサービス停止を早期に発見できます。
「チェーン・ハルト」と「チェーン・リオーガナイゼーション」の違いは何ですか?
これら2つのコンセンサス失敗は、混同されがちです。チェーンハルト(chain halt)は、バリデーターがコンセンサス閾値に達できないためブロックの生成が完全に停止し、その結果、新しいトランザクションが一切確認されなくなります。一方、ブロックチェーン による再編成(reorg)では、ブロックの生成は継続されますが、直近のブロックが競合するチェーンのものに置き換えられます。これにより、確認済みと思われていたトランザクションが取り消される可能性があります。
インフラの冗長化は、どのようにして障害リスクを低減するのでしょうか?
インフラの障害の多くは、単一障害点に起因しています。インフラの冗長性がなぜ重要なのかを理解すれば、設計の方向性は自ずと定まります。つまり、複数のプロバイダーやリージョンを活用し、リクエストが失敗し始める前に、正常に動作していないノードを迂回してトラフィックを転送する自動フェイルオーバーを導入することです。
よくある質問
ブロックチェーン の障害には、どのような3つの層がありますか?
障害は、コンセンサス層(バリデーターのバグ、パーティション、51%攻撃)、アプリケーション層(スマートコントラクトのバグ、オラクルの改ざん、ガバナンスの悪用)、あるいはインフラ層(ノードのクラッシュ、プロバイダーやクラウドのサービス停止)で発生します。耐障害性の高いシステムは、これら3つすべてに対処します。
ブロックチェーン の損失の最も一般的な原因は何ですか?
アプリケーション層の障害、とりわけスマートコントラクトの脆弱性やオラクルの改ざんは、最も頻繁に発生し、最も多大な損害をもたらすものです。多くの場合、基盤となるブロックチェーンは設計通りに正常に動作しているにもかかわらず、欠陥のあるコントラクトやオラクルのロジックが悪用されるのです。
RPCプロバイダーの1つがダウンしただけで、私のアプリが利用できなくなることはありますか?
はい。アプリケーションが1つのプロバイダー、1つのデータセンター、または1つのクラウドリージョンに依存している場合、そこで障害が発生するとサービスが停止してしまいます。冗長化されたプロバイダーやリージョンにトラフィックを分散させ、自動フェイルオーバーを設定することで、この単一障害点を排除できます。
51%攻撃はネットワークパーティションと同じものですか?
いいえ。51%攻撃とは、コンセンサス権限の過半数が意図的に履歴を書き換えようとする行為であるのに対し、ネットワークの分断とは、バリデーター間の通信が偶発的に途絶える現象です。どちらもリオーガナイゼーションを引き起こす可能性がありますが、その原因や防御策は異なります。
オラクル攻撃からどのように防御すればよいでしょうか?
複数の情報源や時間帯にわたる価格を集約するオラクルを使用し、単一のDEXのスポット価格に依存することを避け、妥当性チェックやサーキットブレーカーを導入してください。これらの対策により、価格フィードを一時的に歪めるフラッシュローン攻撃の被害を軽減できます。
参考資料
「チェーン・ホルト」とは何ですか?- 『Quicknode 』用語集
チェーンフォークとは?-Quicknode 用語集
「ブロックチェーン の再編成」とは?- 『Quicknode 』用語集
Quicknode チェーン-Quicknode 対応チェーン
Node.信頼性 が重要な理由- 「Quicknode 」用語集
