要約:冗長性とは、インフラストラクチャのあらゆる層にバックアップ用のコンポーネントを用意し、何かが故障した際に複製が自動的に引き継ぐようにすることです。『ブロックチェーン 』において、ノード、リージョン、クラウドプロバイダー、およびクライアント実装にわたる冗長性こそが、本番環境向けのシステムと脆弱なシステムを区別する要素となっています。
「冗長性」とは実際に何を意味するのか
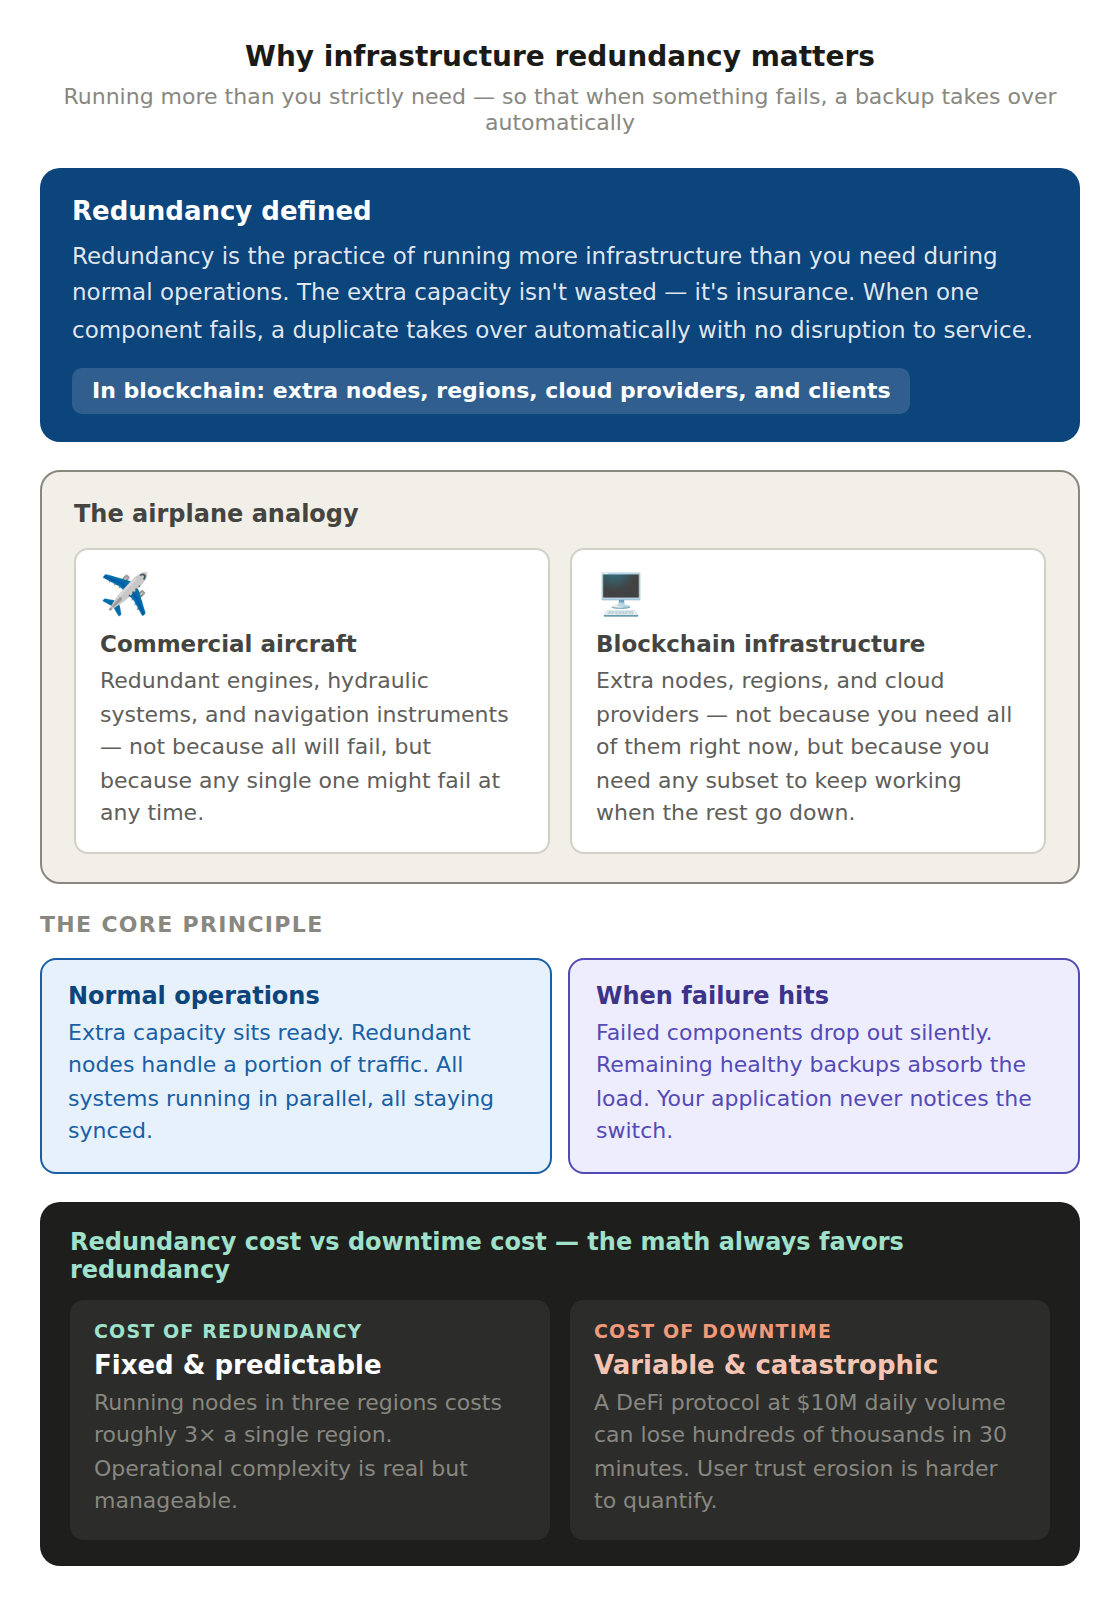
冗長性とは、通常の運用において、厳密に必要な量よりも多くのリソースを稼働させておくことを指します。この余剰な容量は無駄になるわけではありません。これは一種の保険なのです。
これを飛行機に例えて考えてみてください。民間航空機には、予備のエンジン、予備の油圧システム、そして予備の航法計器が備わっています。これらは、すべてが同時に故障することを想定しているからではなく、いずれかがいつでも故障する可能性があるからです。こうした冗長なシステムがあることで、何かが故障しても飛行機は飛行を続けられるのです。
インフラの冗長化も同様の原理に基づいています。追加のリージョンや追加のクラウドプロバイダー上で、余分なノードを稼働させるのは、現時点でそれらすべてが必要だからではなく、残りのノードがダウンしても、その一部が引き続き機能し続ける必要があるからです。
冗長性の階層
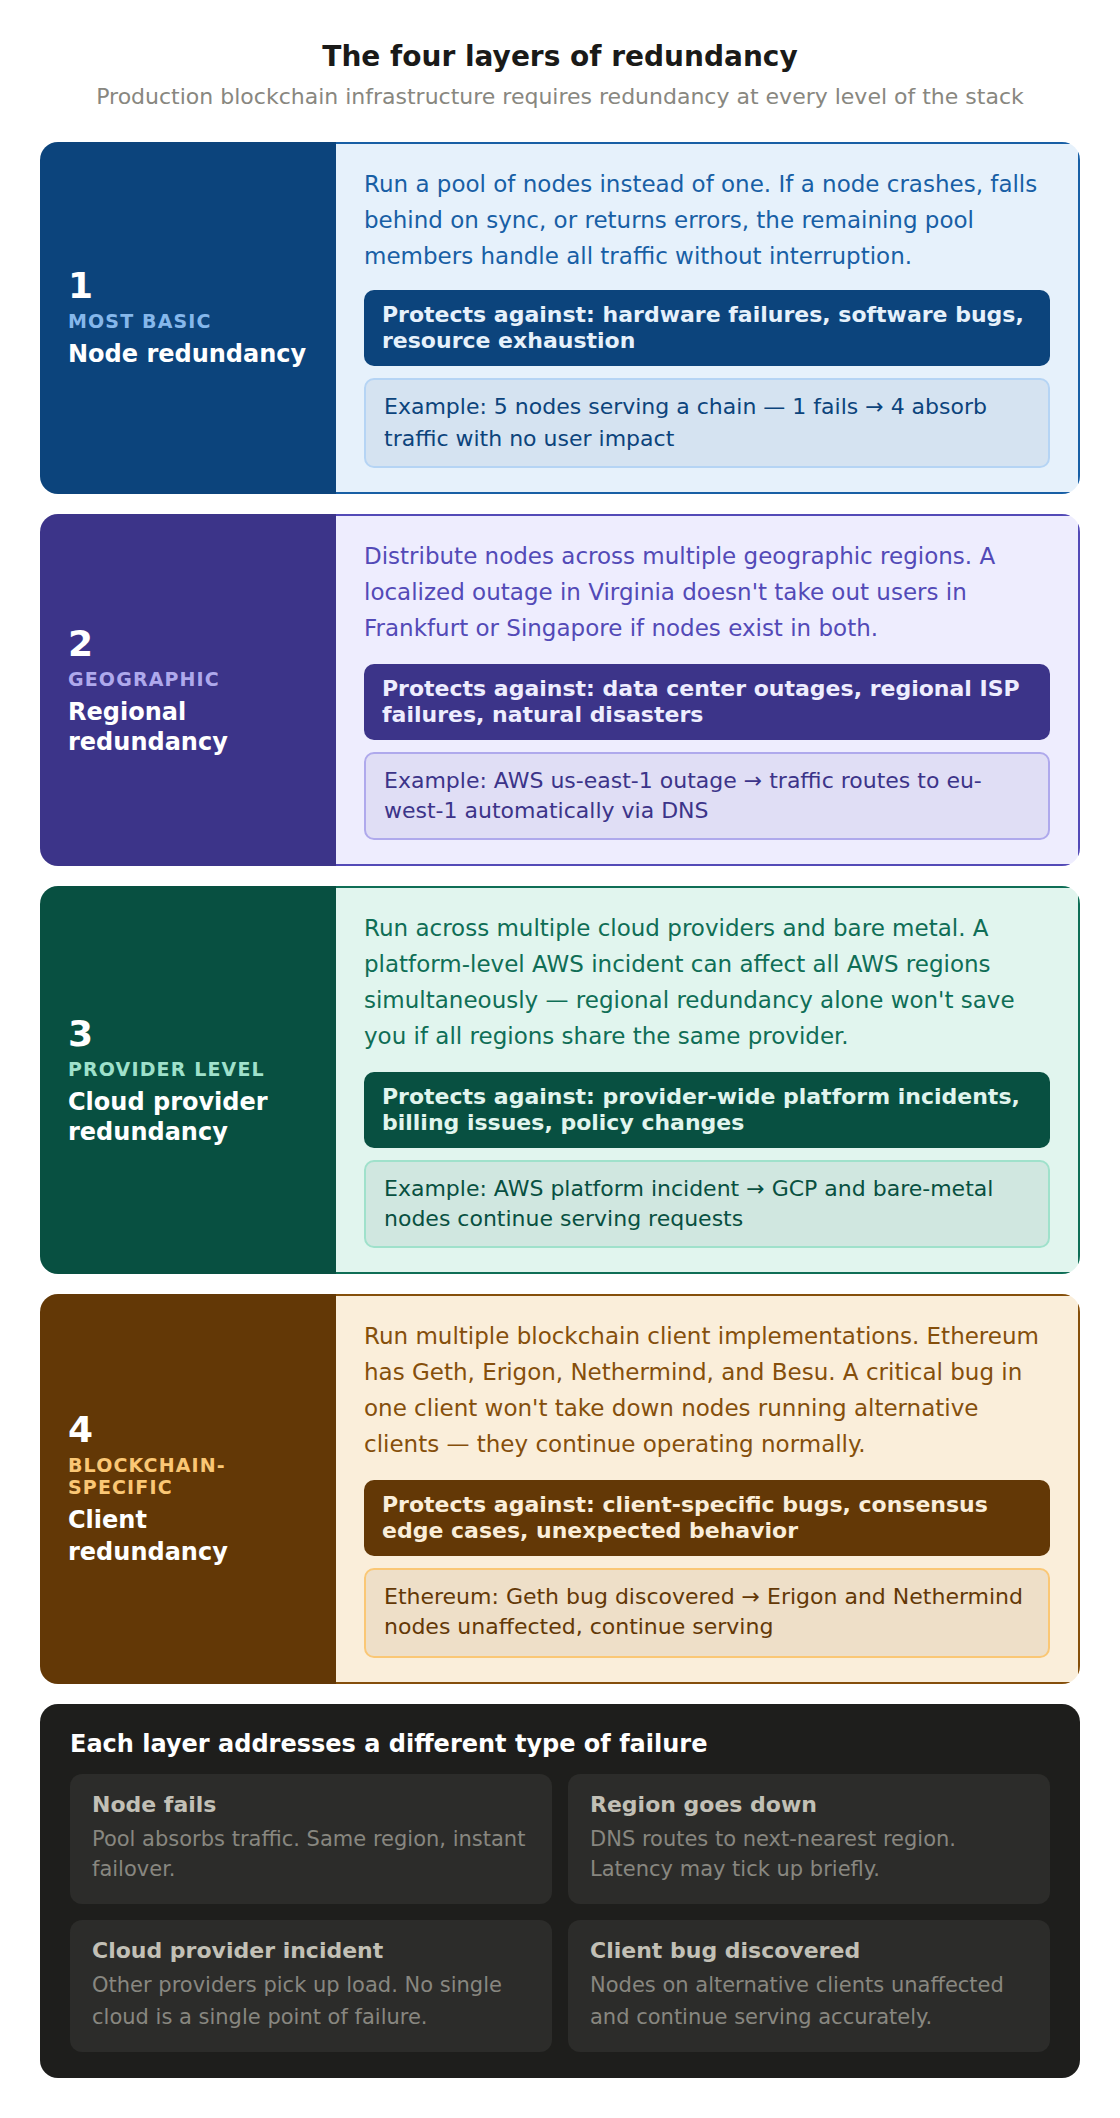
ブロックチェーン のインフラストラクチャを運用するには、複数のレベルでの冗長性が必要です。各レイヤーは、それぞれ異なる種類の障害に対処します。
ノードの冗長性は最も基本的なものです。特定のブロックチェーン について、単一のノードに依存するのではなく、ノードのプールを運用します。1つのノードがクラッシュしたり、同期に遅れをとったり、エラーを返したりした場合でも、プール内の残りのノードがトラフィックを処理します。これにより、個々のハードウェア障害、特定のノードプロセスにおけるソフトウェアのバグ、あるいは単一のマシンにおけるリソースの枯渇からシステムを保護することができます。
リージョン間の冗長性により、大規模な障害からシステムを保護できます。すべてのノードが単一のAWSリージョンで稼働しており、そのリージョンでサービス停止が発生した場合(これは多くの人が思っているよりも頻繁に起こります)、システム全体が同時にダウンしてしまいます。ノードを複数の地理的リージョンに分散させることで、バージニア州で発生した局所的な事象によって、フランクフルトやシンガポールにあるユーザー が影響を受けることを防ぐことができます。
クラウドプロバイダーの冗長化は、これをさらに一歩進めたものです。もしすべてのインフラが単一のクラウドプロバイダー上で稼働しており、そのプロバイダーでプラットフォームレベルの障害が発生した場合、リージョン間の冗長化だけでは事態を救うことはできません。複数のプロバイダー(AWS、GCP、ベアメタルなど)にまたがって運用することで、特定のプロバイダーでの障害が自社の障害に直結することを防ぐことができます。
クライアントの冗長性はブロックチェーン 固有のものです。主要なブロックチェーン のほとんどには、複数のノードクライアントの実装があります。Ethereum には、Geth、Erigon、Nethermind、Besuがあります。Solana には、バリデータクライアントとFiredancerがあります。あるクライアントに重大なバグが発生した場合でも、別のクライアントを実行しているノードは通常通り動作し続けます。多様なクライアントを実行しているプロバイダーは、ソフトウェアレベルの障害に対してより高い耐性を持ちます。
冗長性がないとどうなるか
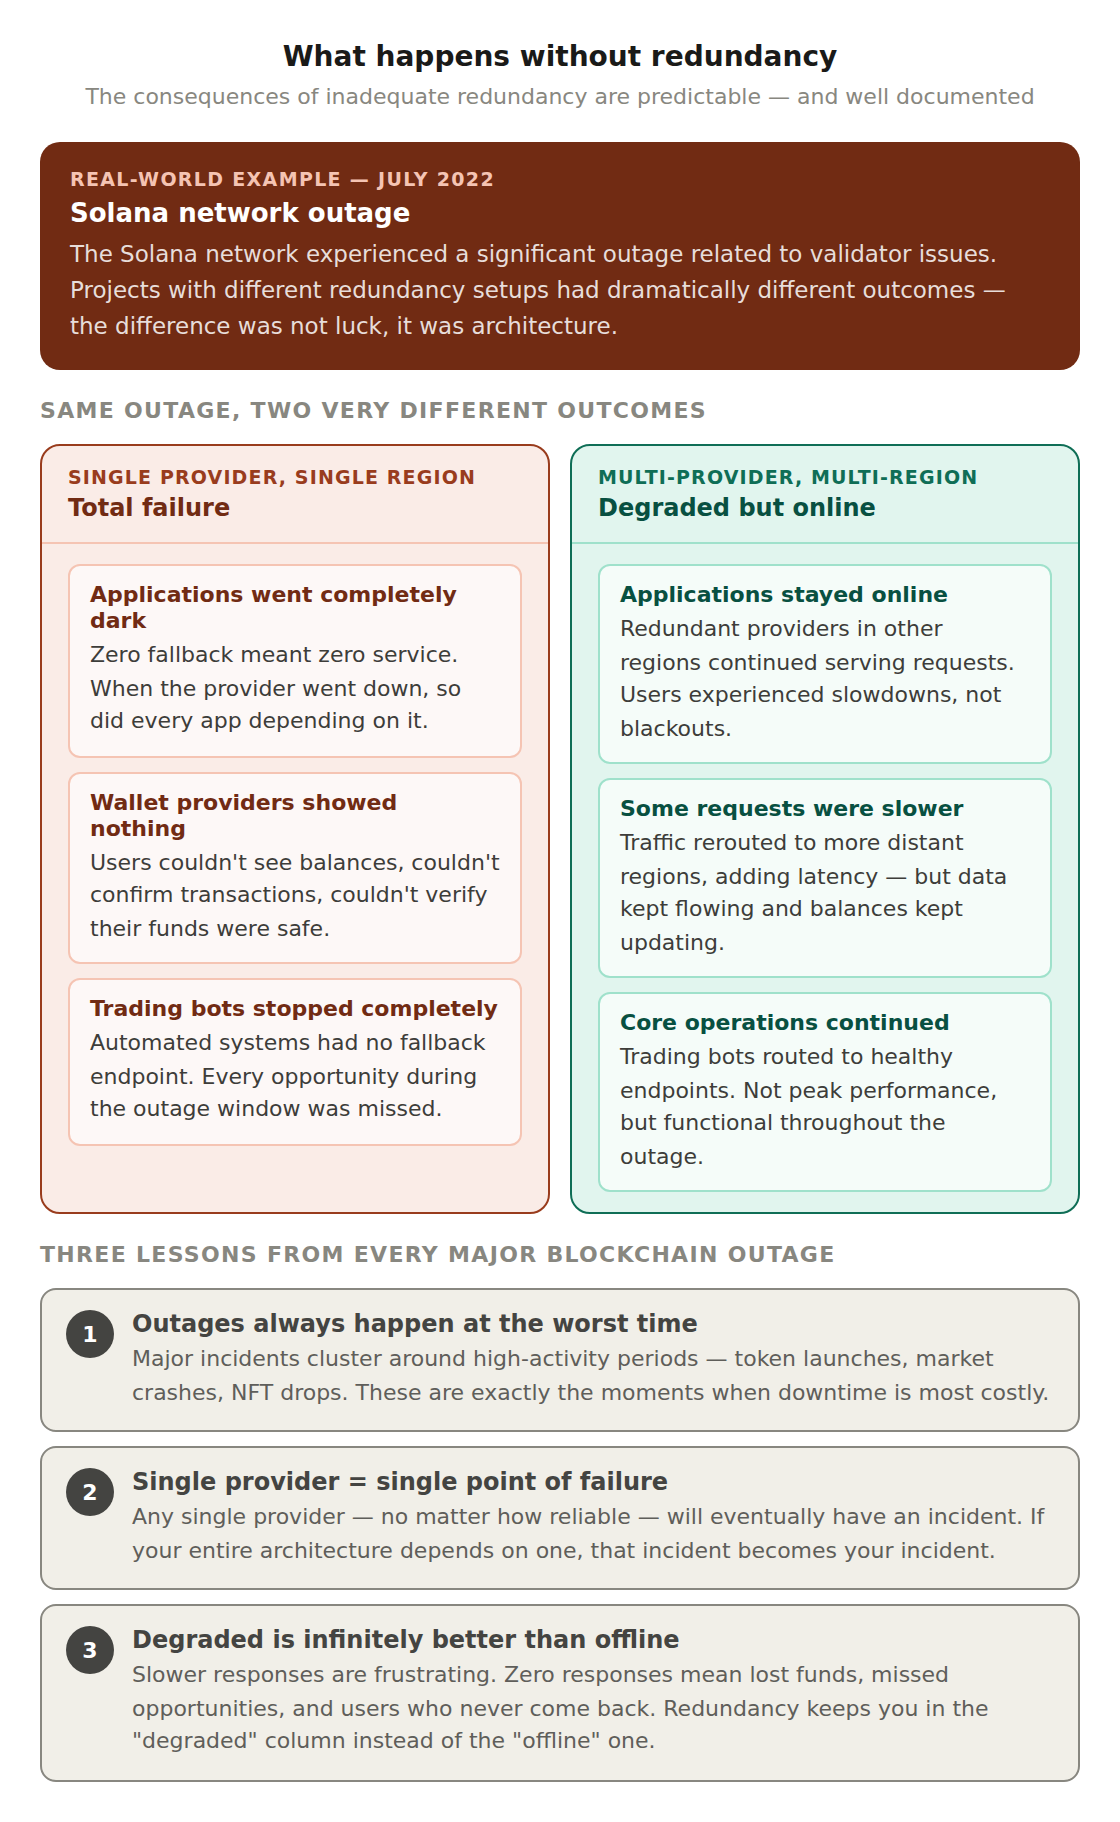
冗長性の不足がもたらす結果は予測可能であり、多くの事例が報告されています。
2022年7月、Solana ネットワークは、バリデーターの問題も一因となって大規模なサービス停止に見舞われました。単一のリージョンにある単一のRPCプロバイダーに依存していたプロジェクトには、フォールバック手段がまったくありませんでした。それらのアプリケーションは完全に機能停止状態に陥りました。ウォレットプロバイダーは残高を表示できなくなり、取引 のボットは実行を停止し、監視ダッシュボードには何も表示されなくなりました。
これに対し、複数のプロバイダーや複数のリージョンを跨ぐ構成のプロジェクトでは、パフォーマンスの低下は見られたものの、完全な障害には至りませんでした。一部のリクエストの処理速度は低下しましたが、アプリケーションは稼働し続けました。
この違いは運によるものではありませんでした。冗長性のおかげだったのです。
冗長化のコストとダウンタイムのコストの比較
冗長性に対する一般的な反論として、コストが挙げられます。3つのリージョンでノードを運用する場合、1つのリージョンで運用する場合に比べて、コストはおよそ3倍になります。2つのクラウドプロバイダーにまたがって運用すると、運用上の複雑さとコストがさらに増大します。
しかし、ダウンタイムによるコストについても考慮する必要があります。1日の取引高が1,000万ドルに達するDeFiプロトコルにとって、ピーク時間帯にわずか30分のダウンタイムが発生しただけでも、取引機会の喪失、清算の失敗、そしてユーザー における信頼の低下により、数十万ドルの損失につながる可能性があります。また、大幅な価格下落時にNFTマーケットプレイス が数分間アクセス不能になると、ユーザー といったユーザー層全体を、サービスを維持していた競合他社に奪われてしまう恐れがあります。
本番環境のアプリケーションにおいては、ほとんどの場合、冗長性を確保する方が経済的に有利です。インフラコストは固定的で予測可能ですが、ダウンタイムによるコストは変動的であり、しばしば壊滅的なものとなるからです。
「冗長化」と「フェイルオーバー」の違いは何ですか?
冗長性とフェイルオーバーは連携して機能しますが、同じものではありません。冗長性とは、予備のノード、リージョン、プロバイダーといった余剰容量を常時用意しておくことです。フェイルオーバーとは、実際に障害を検知し、トラフィックをその余剰容量に切り替える仕組みのことです。フェイルオーバーのない冗長性とは、誰も切り替えないバックアップがあるのと同じであり、冗長性のないフェイルオーバーとは、切り替える先がない切り替え機能があるのと同じです。真の耐障害性を実現するには、この両方が必要です。
アスペクト | 冗長性 | フェイルオーバー |
|---|---|---|
概要 | 予備・冗長化された容量 | それに切り替えるという行為 |
この質問が扱う内容 | バックアップはありますか? | どれくらいの速さでそれを使うのですか? |
もう一方がいなければ | 誰もルーティングしないバックアップ | ターゲットのないスイッチ |
要するに、冗長性は基盤であり、フェイルオーバーはその上に構築された自動化機能です。これら二つが相まって、高可用性を支える構成要素となります。
冗長化はどのように稼働時間を向上させるのでしょうか?
冗長化の各層は、それぞれ異なる単一障害点を解消するため、独立した層を積み重ねれば積み重ねるほど、いずれかの障害が発生してもシステムが完全に停止するリスクは低くなります。以下の表は、各冗長化層と、それが防ぐ障害との対応関係を示しています。
冗長化層 | ~から保護します | 失敗例 |
|---|---|---|
ノードの冗長性 | 単一のノードの障害 | クラッシュ、同期の遅れ、またはエラー |
地域的な冗長性 | 地域全体が衰退しつつある | クラウドリージョンのサービス停止 |
クラウドプロバイダーの冗長性 | プロバイダー全体に及ぶインシデント | プラットフォーム全体の障害 |
プロバイダーは、これらのレイヤーを積み重ねることで、非常に高い稼働率目標を達成しています。これは、ノードの信頼性 (監視・診断・修復)の実践や、 ブロックチェーン の一般的な障害モードに対する理解と自然に連携するため、各レイヤーが実際のリスクに対処できるようになっています。
どの程度の冗長性が必要ですか?
唯一の正解というものはなく、目標は冗長性をダウンタイムによるコストに見合うように調整することです。趣味のプロジェクトであれば、時折のダウンタイムは許容でき、フォールバックさえあれば十分かもしれません エンドポイントで十分かもしれませんが、実際の価値を扱うDeFiプロトコルや取引所では、自動フェイルオーバー機能を備えたマルチリージョン・マルチプロバイダーによるカバーが必要です。冗長性の固定的で予測可能なコストと、ダウンタイムによる変動的で壊滅的な可能性のあるコストを天秤にかけ、by に基づいて判断してください。これは根本的には「自社開発か外部調達か」という判断であり、障害の発生を予見できる場合にのみ効果を発揮するため、インフラの強力な可観測性と 監視体制と組み合わせる必要があります。
よくある質問
インフラの冗長性とは何ですか?
インフラの冗長性とは、通常の運用において厳密に必要な数よりも多くのコンポーネントを稼働させ、何かが故障した際にバックアップが引き継げるようにすることです。ブロックチェーン においては、これは複数のリージョン、クラウドプロバイダー、およびクライアント実装にわたってノードを重複配置することを意味します。
冗長化とバックアップは同じものですか?
そうとは限りません。バックアップとは通常、障害発生後に復元するためのデータのコピーを指しますが、冗長性とは、障害発生時にも中断をほとんど、あるいは全く生じさせることなくトラフィックを処理し続ける、稼働中の予備容量のことです。冗長性は、事後の復旧ではなく、常にオンライン状態を維持することを目的としています。
なぜ複数のノードクライアントを実行するのですか?
クライアントの多様性は、ソフトウェアのバグからシステムを守ります。あるクライアントの実装に重大なバグが発生しても、別のクライアントを実行しているノードは正常に動作し続けるため、1つのバグのあるリリースによってシステム全体がダウンすることはありません。
冗長化によってダウンタイムは完全に解消されるのでしょうか?
完璧な稼働率を実現できるシステムなど存在しませんが、多層的な冗長化により、個別の障害のほとんどは完全な停止ではなく、パフォーマンスの低下にとどまります。その目的は、単一障害点を排除し、単一の事象によってシステム全体が停止することのないようにすることです。
冗長化には、その分の追加コストをかける価値があるのでしょうか?
本番環境では、ほぼ常にそうです。冗長性には固定的で予測可能なコストがかかる一方で、ダウンタイムには変動コストがかかり、ピーク時の1回の停止だけで、取引機会の損失やユーザー の損失により、数十万ドルに達することもあります。
Quicknode が冗長性をどのように構築しているか
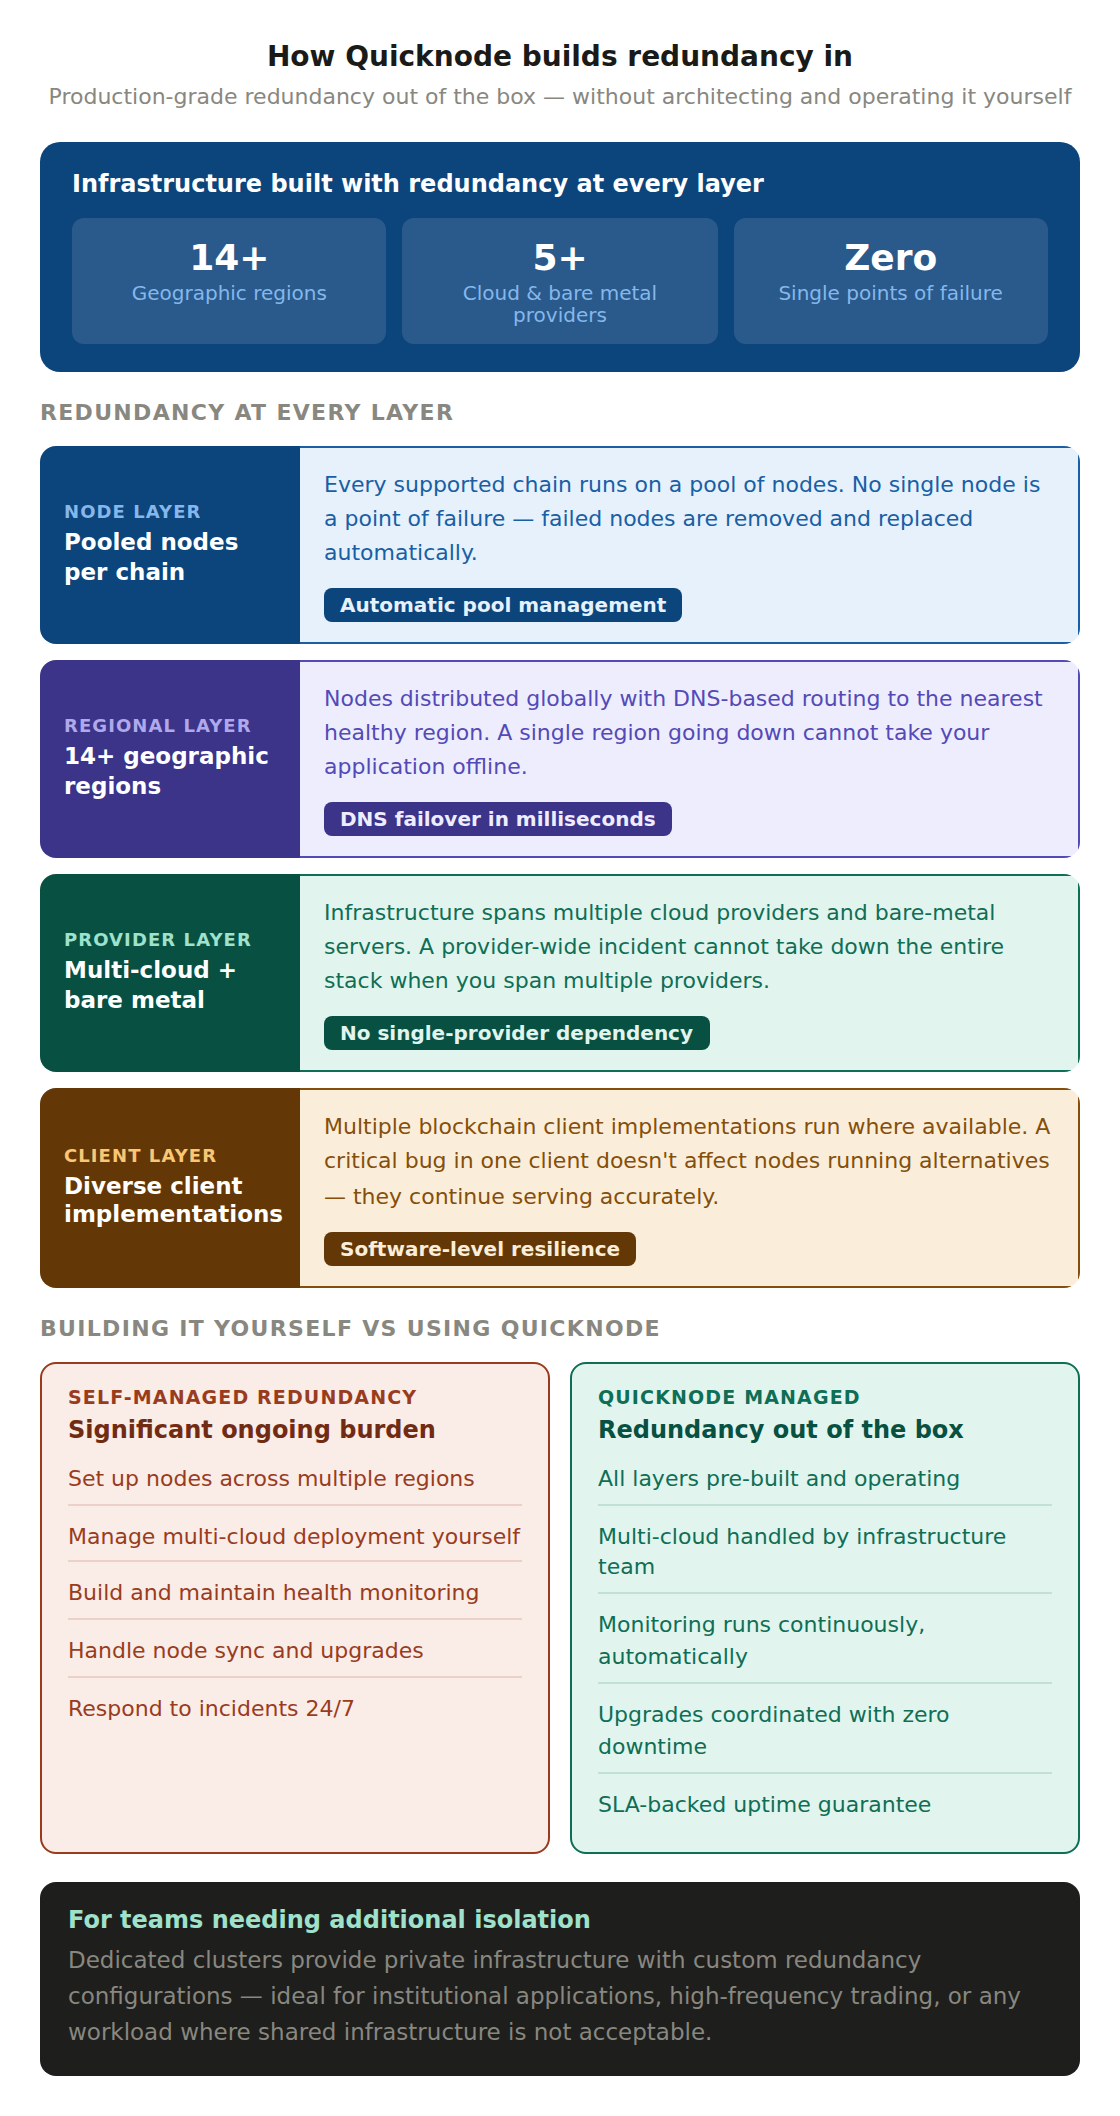
Quicknode ブロックチェーン のインフラストラクチャを、複数のクラウドおよびベアメタルプロバイダーの14以上のリージョンにまたがって運用しています。サポートされているすべてのチェーンは、可能な限り多様なクライアント実装を備えたノードプール上で実行されます。このシステムは、単一のノード、リージョン、またはクラウドプロバイダーが単一障害点とならないように設計されています。
つまり、開発者 のユーザーは、自らアーキテクチャを設計・運用することなく、導入直後から本番環境レベルの冗長性を活用できます。さらに高度な分離が必要なチーム のユーザーには、専用のclusters が、カスタマイズされた冗長性構成を備えたプライベートインフラストラクチャを提供します。
参考資料
ブロックチェーン インフラにおける「高可用性」とは何か?
フェイルオーバーとは何か?
ブロックチェーン のサービス停止はどのように発生するのか
フルノードとアーカイブノードの比較
Quicknode ドキュメント
