ブロックチェーン における高可用性:信頼性の高いノードとRPC |Quicknode🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る SOC 2 タイプ II 認証取得・ISO 27001
回答>信頼性 と稼働時間について>ブロックチェーン インフラストラクチャにおける高可用性とは何ですか? ブロックチェーン インフラにおける高可用性とは何ですか?
// Tags
高可用性ブロックチェーンブロックチェーン 稼働時間
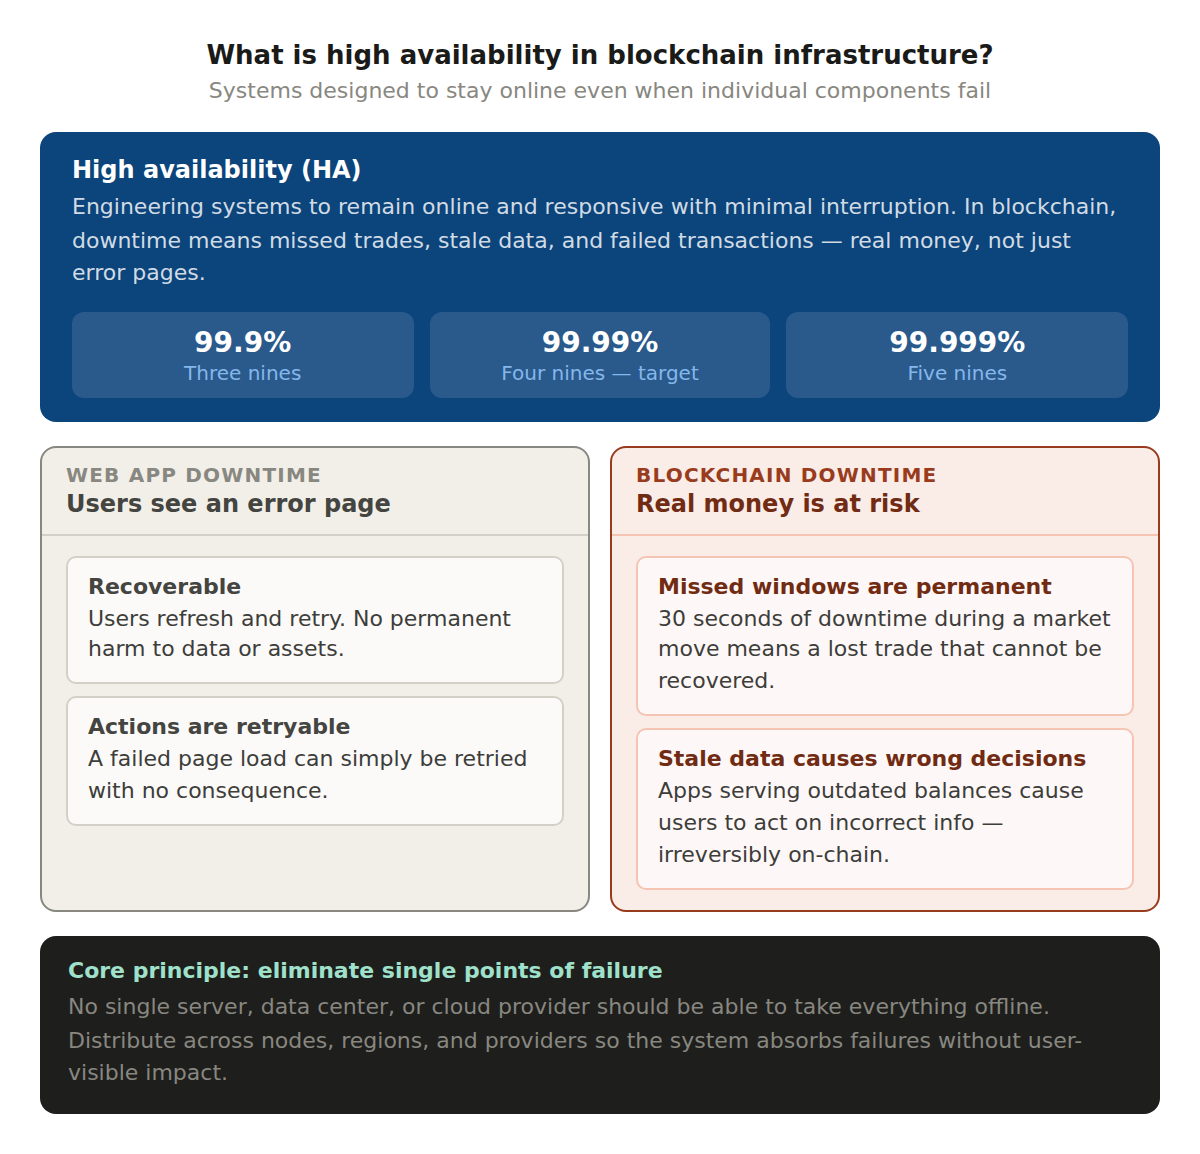
要約:高可用性(HA)とは、個々のコンポーネントに障害が発生した場合でも、ダウンタイムを最小限に抑え、システムを常時稼働させ、応答性を維持するように設計されたシステムを指します。 ブロックチェーン インフラストラクチャにおいて、HAとは、RPCエンドポイント、ノード、およびデータパイプラインがリクエストに確実に応答し続け、通常は99.9%以上の稼働率を目指すことを意味します。
稼働率が想像以上に重要な理由
従来のWebアプリがダウンすると、ユーザー にはエラーページが表示されます。一方、ブロックチェーン のインフラがダウンした場合、その影響ははるかに深刻なものになり得ます。取引の未処理、データの古さ、取引の失敗、イベントの未処理などは、単にユーザー のユーザーを苛立たせるだけではありません。それらは実際の金銭的損失につながります。
取引 RPCを利用して エンドポイント を利用してトランザクションを送信するDeFiボットを想定してみましょう。もし エンドポイント 市場が激しく変動している最中に、たとえ30秒間でもオフラインになれば、ボットはそのチャンスを完全に逃してしまいます。あるいは、ノードプロバイダーのサービス停止により残高を取得できないウォレットアプリを想像してみてください。ユーザー は自分の資金が安全かどうか分からなくなり、サポート のキューは爆発的に膨れ上がります。
高可用性とは、こうした事態を防ぐための技術的アプローチのことです。つまり、単一の障害が発生してもシステム全体が停止しないようなシステムを設計することを意味します。
ブロックチェーン における高可用性とは何ですか?
ブロックチェーン における高可用性とは、個々のコンポーネントに障害が発生した場合でも、ノード、RPCエンドポイント、およびデータパイプラインをオンライン状態に保ち、応答性を維持する手法です。高可用性構成では、単一のノードやリージョンに依存するのではなく、冗長化されたコンポーネント間で処理を分散させるため、単一の障害によってサービス全体が停止することはありません。これは、正常かつ同期されたノードに大きく依存しているため、ノードの信頼性と自動フェイルオーバーが中核となる構成要素となっています。
高可用性の仕組み
本質的に、HAとは単一障害点を排除することを目的としています。単一のサーバー、単一のデータセンター、あるいは単一のクラウドプロバイダーに依存するのではなく、高可用性システムでは、ワークロードを複数の冗長化されたコンポーネントに分散させます。
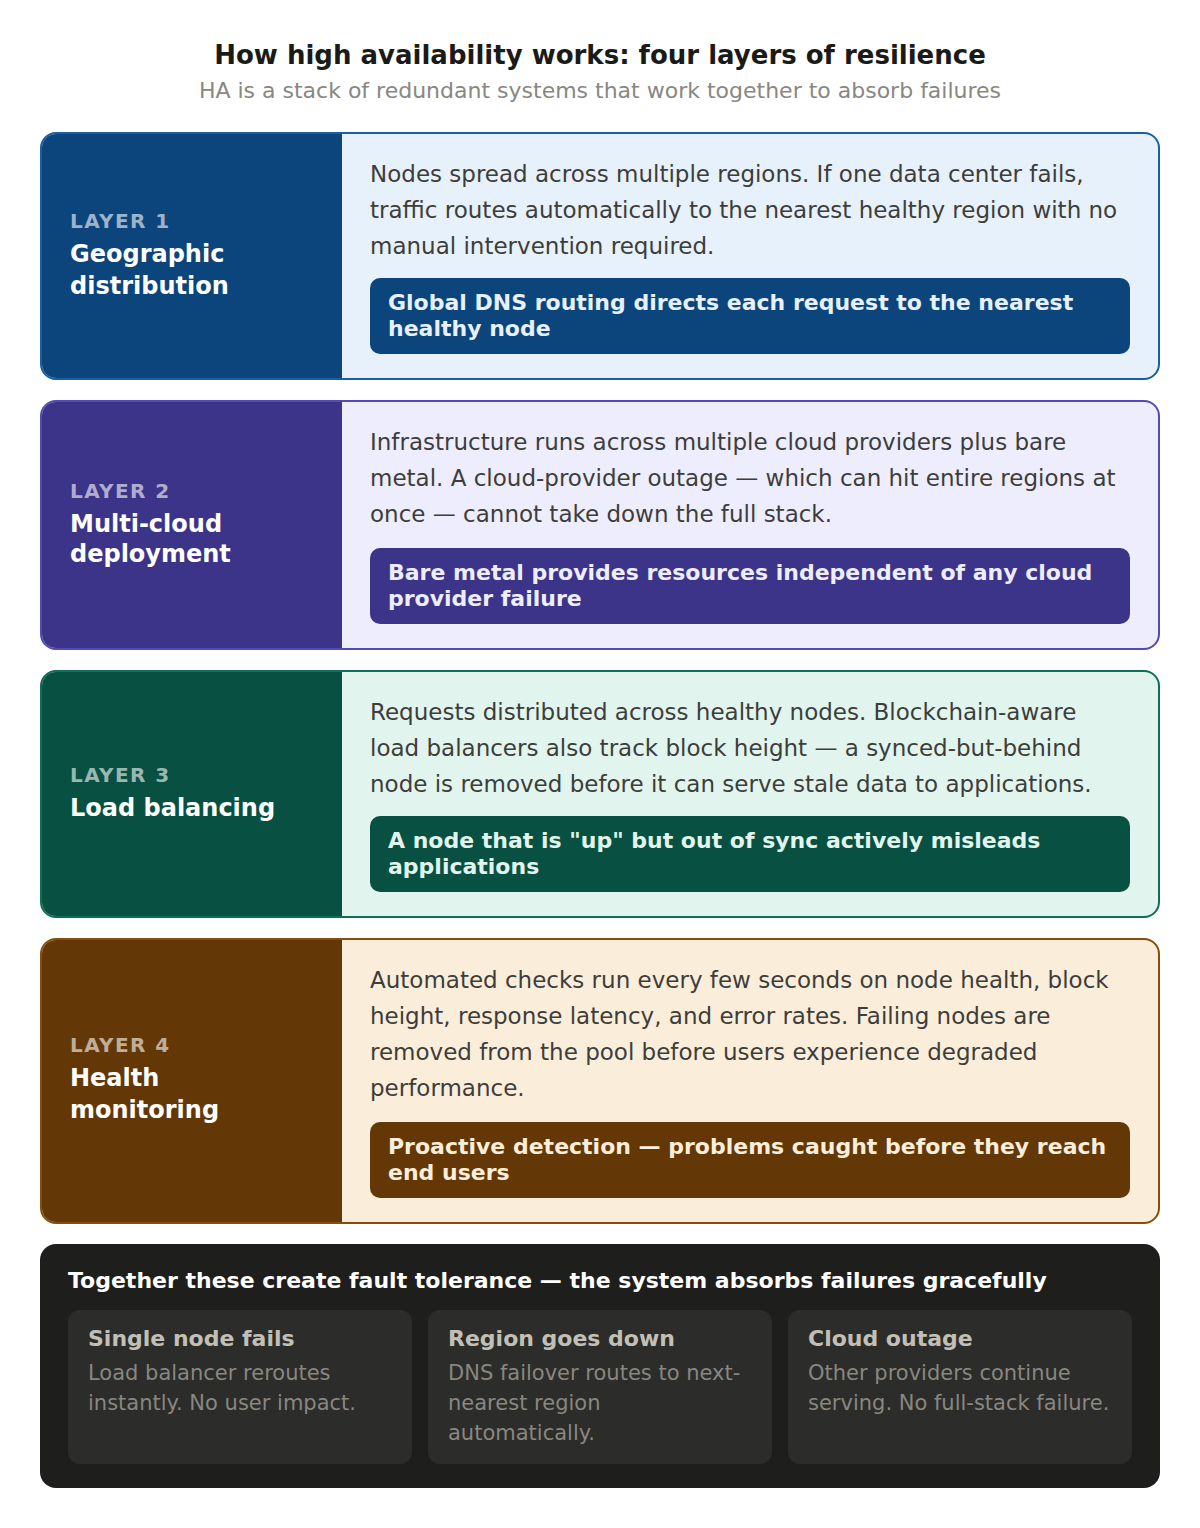
ブロックチェーン インフラストラクチャでは、これには通常、いくつかの層が関わります。1つ目は地理的分散であり、ノードを複数のリージョンに分散させることで、あるデータセンターで問題が発生した場合でも、トラフィックが自動的に最も近い正常な代替先へルーティングされるようにします。2つ目はマルチクラウド展開です。 複数のクラウドプロバイダー(場合によってはベアメタル)上で稼働させることで、特定のクラウドでの障害によってスタック全体がダウンすることを防ぎます。3つ目はロードバランシングです。これは、受信したRPCリクエストを正常なノードのプールに分散させ、処理が遅いノードや応答のないノードを自動的に迂回させてルーティングする仕組みです。4つ目はヘルスモニタリングです。自動化されたシステムがノードの健全性、ブロックの高さ、応答時間を継続的にチェックし、ユーザー に影響が及ぶ前に問題を検知します。
これらのコンポーネントが連携して、エンジニアが「フォールトトレランス」と呼ぶ機能を実現しています。このシステムは、ダウンすることなく、障害を円滑に吸収します。
可用性の測定
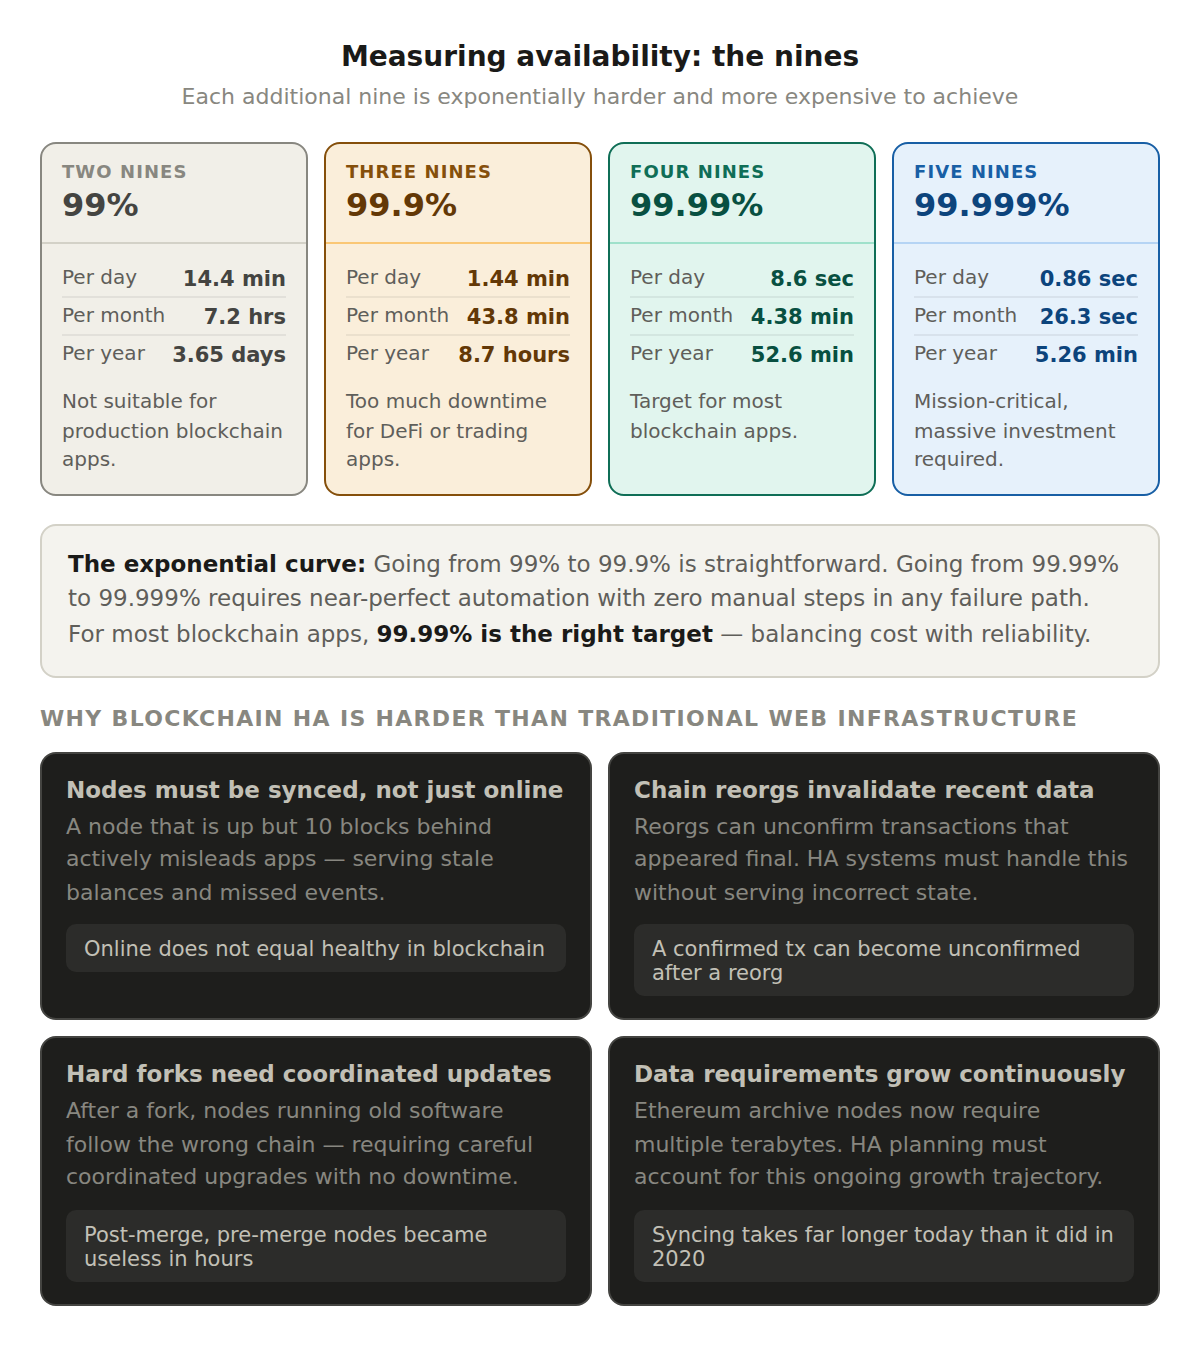
可用性は通常、一定期間における稼働時間の割合(パーセンテージ)として表されます。「スリーナイン」(99.9%)や「フォーナイン」(99.99%)といった用語をよく耳にするでしょう。
では、これらの数値が実際にはどのような意味を持つのか、具体的に見てみましょう。稼働率が99.9%の場合、年間のダウンタイムはおよそ8.7時間になります。99.99%の場合、それは年間約52分にまで減少します。99.999%(ファイブ・ナインズ)の場合、1年間を通じたダウンタイムは5分強となります。
9が1つ増えるごとに達成難易度は指数関数的に高まり、冗長性、監視、自動化への投資も大幅に増える必要があります。ブロックチェーン のアプリケーションのほとんどにおいて、99.99%という数値は、コストと信頼性 とのバランスが取れた目標値となります。
稼働率の目標値はどの程度に設定すべきでしょうか?
稼働率の目標値は「ナイン」で表されます。ナインが1つ増えるごとに、許容されるダウンタイムは劇的に削減されますが、その達成にはより多くのコストがかかります。以下の表は、各レベルが1年を通じて実際にどのような意味を持つかを示しています。
稼働時間 | 名前 | 年間のダウンタイム |
|---|
99.9% | スリー・ナインズ | 約8.7時間 |
99.99% | 4つの9 | 約52分 |
99.999% | ファイブ・ナインズ | 5分強 |
高可用性とフォールトトレランスは、どのように異なるのでしょうか?
これらの用語はしばしば混同されて使われますが、同じものではありません。高可用性(High Availability)は、フェイルオーバー時の短時間の中断を許容しつつ、ダウンタイムを最小限に抑えることを目的としています。一方、耐障害性(Fault Tolerance)は、完全に冗長化されたコンポーネントを並列で稼働させることで、ダウンタイムをゼロにすることを目指していますby 。多くの場合ブロックチェーン チーム 、妥当なコストで高い稼働率を実現できるため、高可用性が採用されています。
アスペクト | 高可用性 | フォールトトレランス |
|---|
目標 | ダウンタイムを最小限に抑える | ダウンタイムゼロ |
アプローチ | 冗長性と高速フェイルオーバー | 並列冗長構成のコンポーネント |
費用 | 中程度 | 高 |
代表的なターゲット | 99.9%~99.99%の稼働率 | 連続運転 |
なぜそれが難しいのかブロックチェーン
従来のWebサービスでは、ロードバランサーの背後でサーバーを単純に増設するだけで済みます。ブロックチェーン のインフラは、ノードがネットワークと同期を保つ必要があるため、より複雑です。ブロックの高さで遅れをとってしまったノードは、たとえ技術的には「オンライン」であっても、実質的に役に立ちません。
ブロックチェーン また、従来のインフラには存在しない特有の障害モードも生じます。チェーンの再編成により、最新のデータが一時的に無効になる可能性があります。ネットワークのアップグレードやハードフォークには、ノードの更新を連携して行う必要があります。クライアントの実装が異なると、負荷がかかった際の挙動も異なる場合があります。さらに、データそのものが絶えず増加しているため、時間の経過とともにストレージや同期の要件も増大していきます。
こうした理由から、ブロックチェーン のHAは、単にサーバークラスターの前にロードバランサーを配置するだけの場合よりも、より複雑な要素が絡んできます。これには、プロトコルに対する深い理解と、継続的な運用への投資が求められます。
高可用性を実現するRPC環境をどのように設計すればよいでしょうか?
耐障害性の高い構成には、いくつかの手法が組み合わされています。具体的には、ノードを複数のリージョンやプロバイダーに分散させ、正常なノードのプールの前にロードバランサーを配置し、ブロックの高さとレイテンシを監視して同期が取れていないノードを自動的に排除し、フェイルオーバーに備えてバックアッププロバイダーを常時待機させることです。アプリケーション側からは、これは依然として単一のRPCエンドポイント として見えますが、その背後には、システムをオンライン状態に維持するための冗長性が備わっています。 ブロックチェーン インフラストラクチャを継続的に監視することで、自動的なルーティング決定が可能になります。
Quicknode の高可用性への取り組み
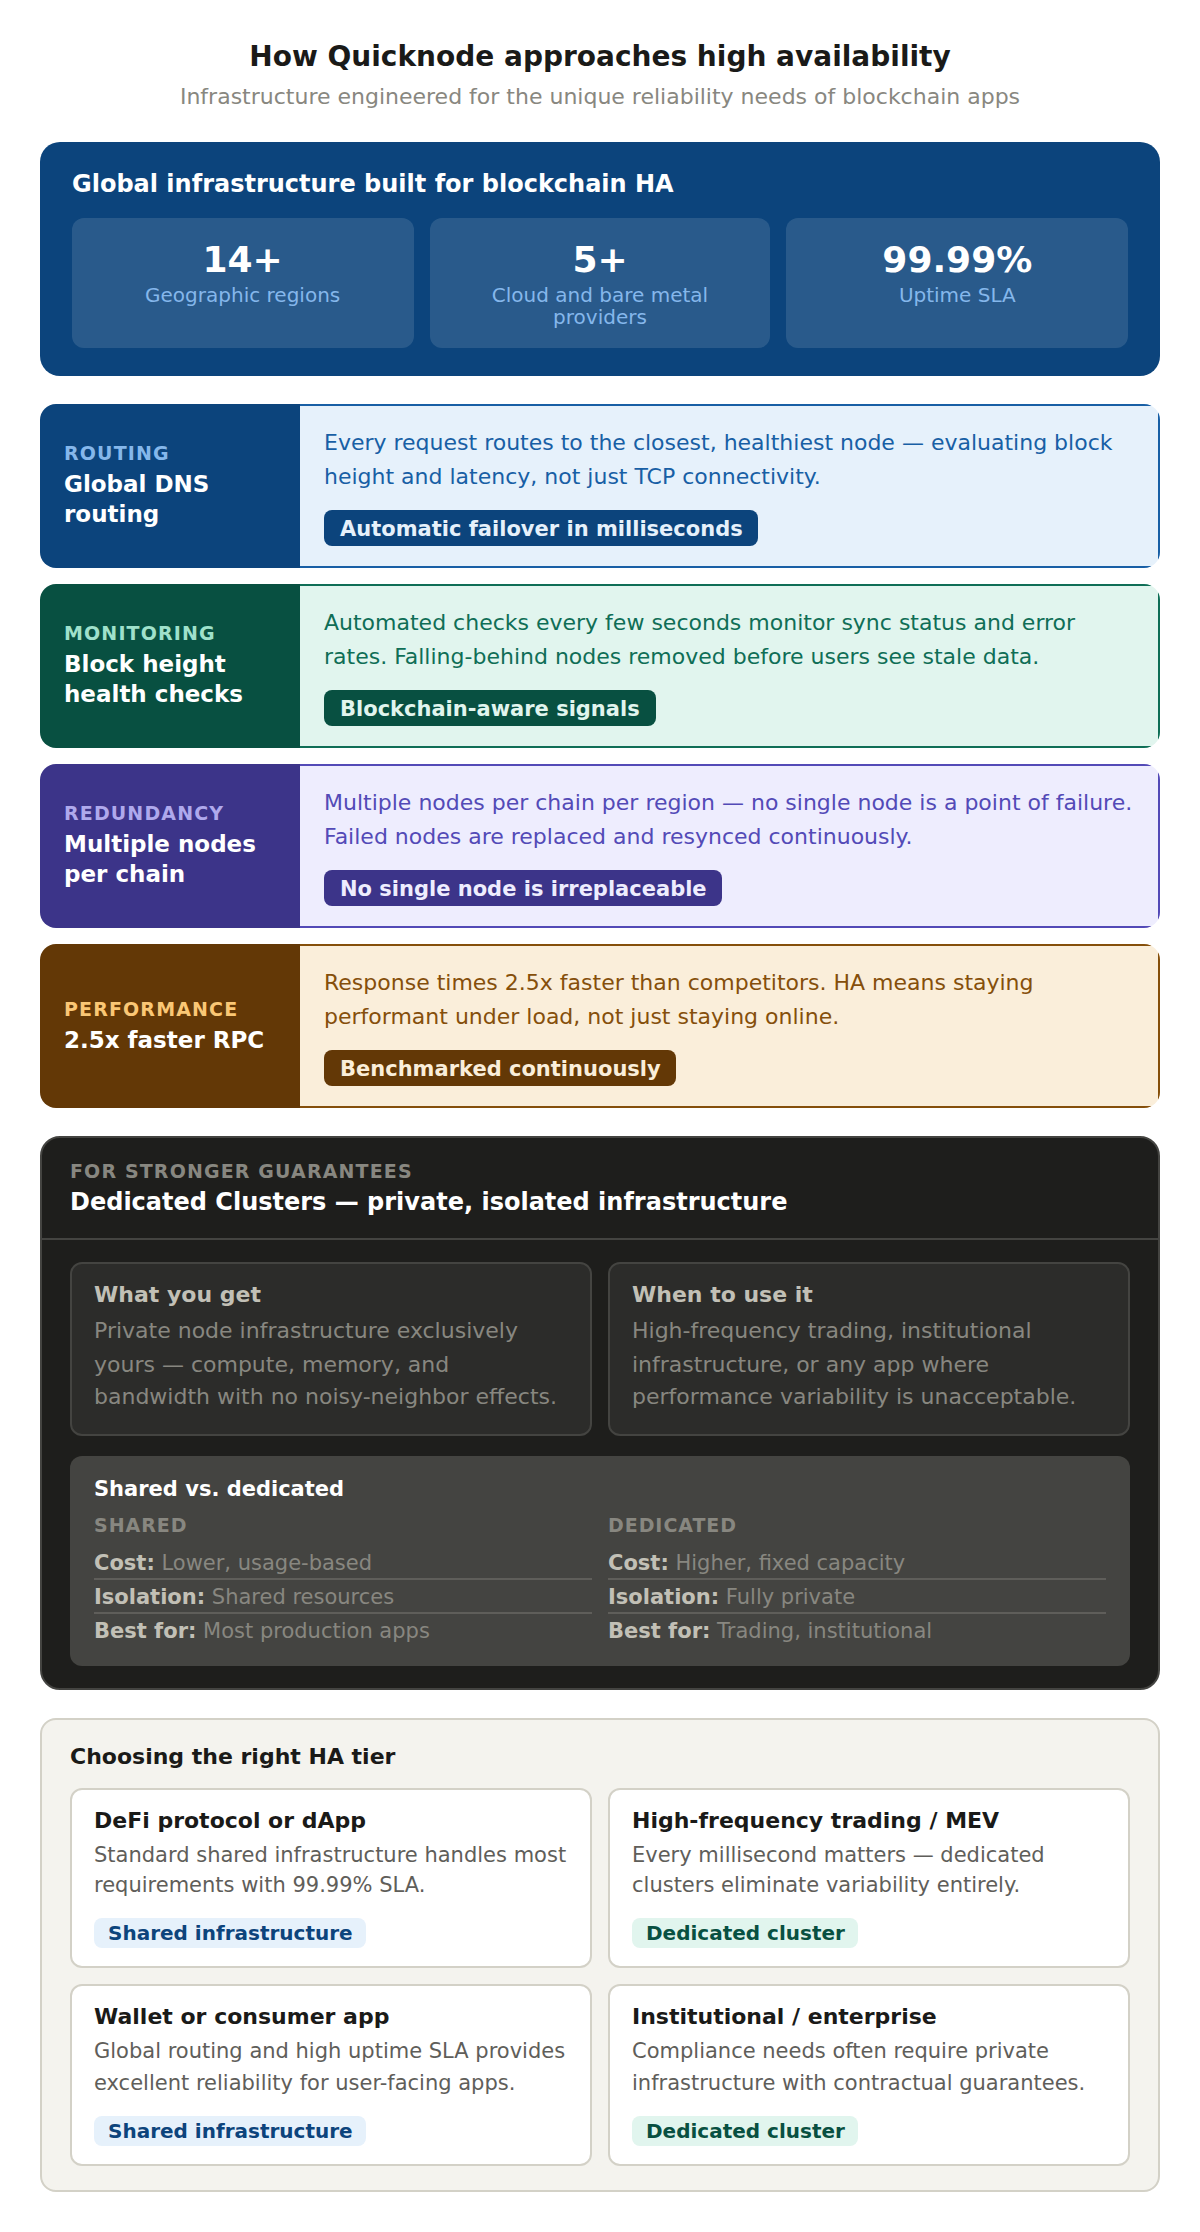
Quicknode 複数のクラウドおよびベアメタルプロバイダーが提供する14以上のリージョンにまたがってインフラストラクチャを運用しています。すべてのRPCリクエストは、グローバルDNSベースのルーティングを通じて最も近い正常なノードにルーティングされ、システムはブロックの高さ、レイテンシ、エラー率を継続的に監視することで、リクエストが常にオンラインかつ完全に同期されたノードに確実に到達するようにしています。
さらに強力な保証が必要なチーム の場合、Quicknode では、プライベートで隔離されたインフラストラクチャと稼働時間のSLAが保証された専用clusters を提供しています。
参考資料
よくある質問
RPCにおいて、「高可用性」とはどういう意味でしょうか エンドポイント?
つまり、 エンドポイント 個々のノード、リージョン、またはプロバイダーに障害が発生した場合でも、リクエストへの応答を継続します。トラフィックは正常で同期が取れているノードに自動的にルーティングされるため、アプリケーション側ではエラーが発生することなく、一貫した稼働時間が確保されます。
ブロックチェーン インフラにおいて、どの程度の稼働率が適切でしょうか?
ほとんどの生産用アプリケーションは、稼働率99.99%を目標としており、これにより年間約52分のダウンタイムが許容されます。99.999%を達成することも可能ですが、冗長化や自動化にかかるコストが大幅に増加します。
なぜ、ブロックチェーン では、webアプリ よりも高可用性の実現が難しいのでしょうか?
ノードはネットワークと同期を保つ必要があるため、オンラインであってもブロック高が遅れているノードは依然として使用できません。ブロックチェーン 特有のイベントも状況を複雑にしていますが、これについては「 ブロックチェーン の一般的な障害モード」で解説しています。
チェーンの再編成は可用性にどのような影響を与えるのでしょうか?
高可用性が実現されれば、バックアッププロバイダーは不要になるのでしょうか?
いいえ。単一のプロバイダーによる高可用性はリスクを軽減しますが、独立したバックアッププロバイダーを確保しておくことで、プロバイダー全体に及ぶインシデントから身を守ることができ、これは耐障害性の高い設計において一般的な要素です。