ブロックチェーン のオブザーバビリティとは:メトリクス、ログ、トレース |Quicknode 🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る
ニュースレターでは、無料のリソース、Quicknodeの最新情報、Web3に関するインサイトなどをお届けします。
CLI、Admin API 、MCP、SDK 、および75以上のチェーンに対応したAIネイティブツール。by 開発者 を構築し、開発者 向けに提供しています。
Python、Ruby、JavaScriptの最新コード例。スマートコントラクト、NFT、dAppsに関する詳細なガイド。
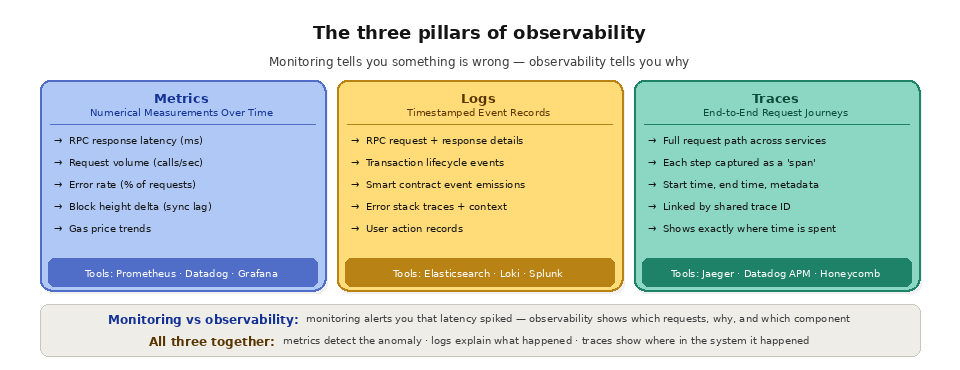
回答 > モニタリングとオブザーバビリティについて学ぶ > オブザーバビリティとは? 要約: オブザーバビリティとは、 システムの外部出力を検証することで、システム内部で何が起きているかを把握する能力のことです。 by ブロックチェーン インフラストラクチャにおいて、オブザーバビリティとは、「なぜ自分のDappの動作が遅いのか?」「なぜこのトランザクションが失敗したのか?」「自分のRPCは エンドポイント は正常か?」といった疑問に答えるために必要なメトリクス、ログ、トレースを備えていることを意味します。これは、単に「何かが異常である」ことを知らせるだけの単純なモニタリング(by )にとどまらず、なぜ異常なのかを理解するためのデータを提供します。オブザーバビリティは、メトリクス(経時的な数値測定値)、ログ(タイムスタンプ付きのイベント記録)、トレース(分散システムを通じたエンドツーエンドのリクエストの経路)という3つの柱に基づいています。
わかりやすい説明 モニタリングでは、車のエンジン警告灯が点灯していることがわかります。オブザーバビリティにより、エンジン警告灯が点灯している原因は、第3シリンダーのO2センサーが2,500 RPMで「混合気希薄」を示しているためであることが判明します。この現象は先週のfuel フィルター交換後に発生し始め、そのパターンはアフターマーケット製フィルターに関する既知の問題と一致しています。
ソフトウェア工学において、「オブザーバビリティ」とは、システムに徹底的な計測機能を組み込むことで、問題を再現したり、事後に新たな計測機能を追加したりすることなく、あらゆる問題を診断できるようにする手法のことです。mode あらゆる可能性のある障害を事前に予測する必要はありません。重要なのは、予期せぬ事態が発生した際に、その症状から根本原因まで遡って追跡できるだけの十分な生データ(メトリクス、ログ、トレース)を確保することです。
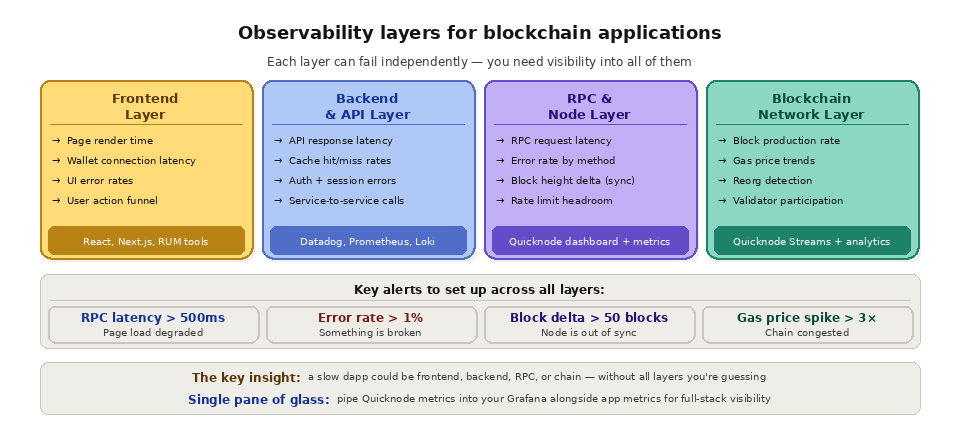
ブロックチェーン アプリケーションにおいて、可観測性は特に重要です。なぜなら、システムはフロントエンド、バックエンド、RPCプロバイダー、ブロックチェーン ノード、コンセンサスネットワーク、そしてチェーン自体といった複数のレイヤーに分散しているからです。残高の更新が遅延しているユーザー は、by フロントエンドのレンダリング遅延、バックエンドのキャッシュ問題、RPC エンドポイント の遅延、ノードの同期遅れ、あるいはチェーンの輻輳などが考えられます。すべてのレイヤーにわたる可観測性がなければ、実際の原因を特定するには当て推量に頼らざるを得ません。
オブザーバビリティの3つの柱 指標
SOC 2 タイプ II 認証取得・ISO 27001
メトリクスとは、一定の間隔で継続的に収集される数値データのことです。これらはダッシュボードやアラート機能の基盤となります。ブロックチェーン のインフラストラクチャにおいて、主要なメトリクスには、RPC応答レイテンシ(各API呼び出しにかかる時間)、リクエスト量(アプリケーションが1秒あたりに発行する呼び出し数)、エラー率(エラーを返すリクエストの割合)、ブロック高の差(ノードがチェーンの先端からどれだけ遅れているか)、ガス価格の推移(現在のネットワーク手数料の水準)、およびトランザクションの確認時間(送信からブロックへの組み込みまでの時間)などが含まれます。
メトリクスは、傾向を把握したり、異常を検知したりするのに最適です。RPCのレイテンシが急激に上昇したり、エラー率が徐々に上昇したり、リクエストのスループットが低下したりすることは、いずれも何らかの変化が生じたことを示す兆候です。Prometheus、Datadog、Grafanaなどのメトリクスツールは、メトリクスを収集・保存・可視化し、リアルタイムのダッシュボード表示と過去の傾向分析の両方を可能にします。
メトリクスの強みは、軽量かつ集計済みであるため、膨大なデータ量を発生させることなく、高頻度で収集できる点にあります。一方、メトリクスには「何が起きているか」は示しても、「なぜ起きているか」までは示さないという限界があります。レイテンシが増加したことは分かりますが、具体的にどのリクエストが遅かったのか、あるいは何が原因で遅くなったのかまでは分かりません。
ログ ログとは、個別のイベントにタイムスタンプが付けられた記録のことです。システムが行う重要なアクション、遭遇するエラー、下す決定のすべてが、ログエントリとして記録されます。ブロックチェーン アプリケーションにおいて、関連するログには、RPCリクエストおよびレスポンスの詳細(メソッド、パラメータ、応答時間、ステータス)、トランザクションのライフサイクルイベント(送信済み、保留中、確認済み、失敗)、スマートコントラクトのイベントエミッション(コントラクトからデコードされたイベントデータ)、エラーの詳細(スタックトレース、エラーコード、リクエストコンテキスト)、およびユーザー のアクション(ウォレット接続、トランザクションの承認、ページ遷移)などが含まれます。
ログは、特定のインシデントを診断するために必要な詳細情報を提供する点で優れています。メトリクスによってエラー率が急上昇したことが通知された場合、ログを確認することで、具体的にどのエラーが発生しているか、どのエンドポイントが影響を受けているか、そしてリクエストのパラメータがどのようなものであったかがわかります。Elasticsearch、Loki、Splunk、CloudWatch Logs などのログ分析ツールを使用すると、サービスや時間範囲をまたいでログエントリの検索、フィルタリング、相関分析を行うことができます。
ログに関するトレードオフは、その量にあります。すべてのRPC呼び出し、すべてのトランザクションイベント、およびすべてのユーザー アクションを詳細にログに記録すると、膨大な量のデータが生成されます。ログの保存コストは急速に膨れ上がる可能性があり、数百万件ものログエントリの中から特定のイベントを検索するには、効率的なインデックス作成およびクエリツールが必要となります。
トレース トレースは、分散システム内における単一のリクエストの経路を最初から最後まで追跡します。ユーザー がトークンスワップを開始すると、トレースはそのすべてのステップ(フロントエンドの処理時間、バックエンドAPI呼び出しのレイテンシ、ノードへのRPCリクエスト、ノードの処理時間、トランザクションの送信、そして最終的なブロックの確認)を記録します。 各ステップは、開始時刻、終了時刻、およびメタデータを含む「スパン」として記録されます。スパンはトレースIDby によって相互にリンクされ、リクエストの経路全体像を形成します。
Tracesは、分散システムにおけるパフォーマンスの問題を診断するために不可欠です。
分散アーキテクチャ。スワップ取引が「ユーザー 」のクリックから確認画面の表示まで8秒かかった場合、トレース結果を見ると、200msがフロントエンドのレンダリング、100msがバックエンドの処理、500msがRPCの遅延、12秒がオンチェーン による確認(アプリケーションが待機していた時間)、残りの時間がWebSocketによるイベント配信であったことがわかります。これにより、時間がどこに費やされたか、どのコンポーネントを最適化すべきかが正確に把握できます。
Jaeger、Zipkin、Datadog APM、Honeycomb などの分散トレースツールは、サービス横断的なトレースを収集、保存、可視化するように設計されています。これらは、単一のユーザー リクエストが複数のサービス、データベース、外部 API を経由するマイクロサービスアーキテクチャにおいて、特に有用です。
ブロックチェーン アプリケーションにおいてオブザーバビリティが重要な理由 ブロックチェーン アプリケーションは本質的に、複数の独立したシステム(お客様のインフラストラクチャ、RPCプロバイダーのインフラストラクチャ、そしてブロックチェーン ネットワーク自体)に分散しています。これにより、自社のサーバーやデータベースのみに依存する従来のアプリケーションに比べ、障害やパフォーマンス低下の発生リスクが高まります。
RPC エンドポイント の問題は、ブロックチェーン 開発者 が直面する最も一般的な問題の一つです。 エンドポイント ノードが同期に遅れをとっているために古いデータを返したり、地理的な距離や負荷のせいで応答が遅くなったり、レート制限やノードの障害によってエラーを返したりする可能性があります。RPCレイヤーの可観測性がなければ、ユーザー からエラーが報告されるまで、これらの問題は把握できません。
オンチェーン こうした状況は、たとえユーザーの制御の及ばないものであっても、アプリケーションに影響を及ぼします。チェーンの混雑はガス料金の上昇や確認時間の増加につながります。ブロックの再編成により、最近確認されたトランザクションが無効になる可能性があります。小規模なチェーンにおけるバリデーターのダウンタイムは、ブロック生成の遅延を引き起こす可能性があります。アプリケーションのメトリクスに加え、チェーンレベルのメトリクスも追跡する可観測性ツールを使用することで、ユーザー に影響を与えている要因を包括的に把握することができます。
「オブザーバビリティ」と「モニタリング」の違いは何ですか? モニタリングとオブザーバビリティは関連していますが、互いに置き換え可能なものではありません。モニタリングは、既知のシグナルのセットを監視し、そのうちの1つが閾値を超えた際に通知するものです。つまり、「何か問題があるか?」という問いに答えるものです。一方、オブザーバビリティとは、豊富なデータを用いてシステムについて自由度の高い質問を投げかけることができる、より広範な機能であり、予期していなかった障害であっても「なぜ問題が発生したのか?」という問いに答えることを可能にします。モニタリングはオブザーバビリティの一部分であり、問題を検知するにはモニタリングが必要であり、その原因を解明するにはオブザーバビリティが必要となります。
アスペクト
モニタリング
オブザーバビリティ
核心的な問い
何か問題でも?
なぜそれが間違っているのですか?
適用範囲
定義済みの信号と閾値
システムの状態に関する自由な探索
故障の種類
既知の、予見可能な不具合
既知および未知の不具合
一次データ
ダッシュボードとアラート
メトリクス、ログ、トレースの統合
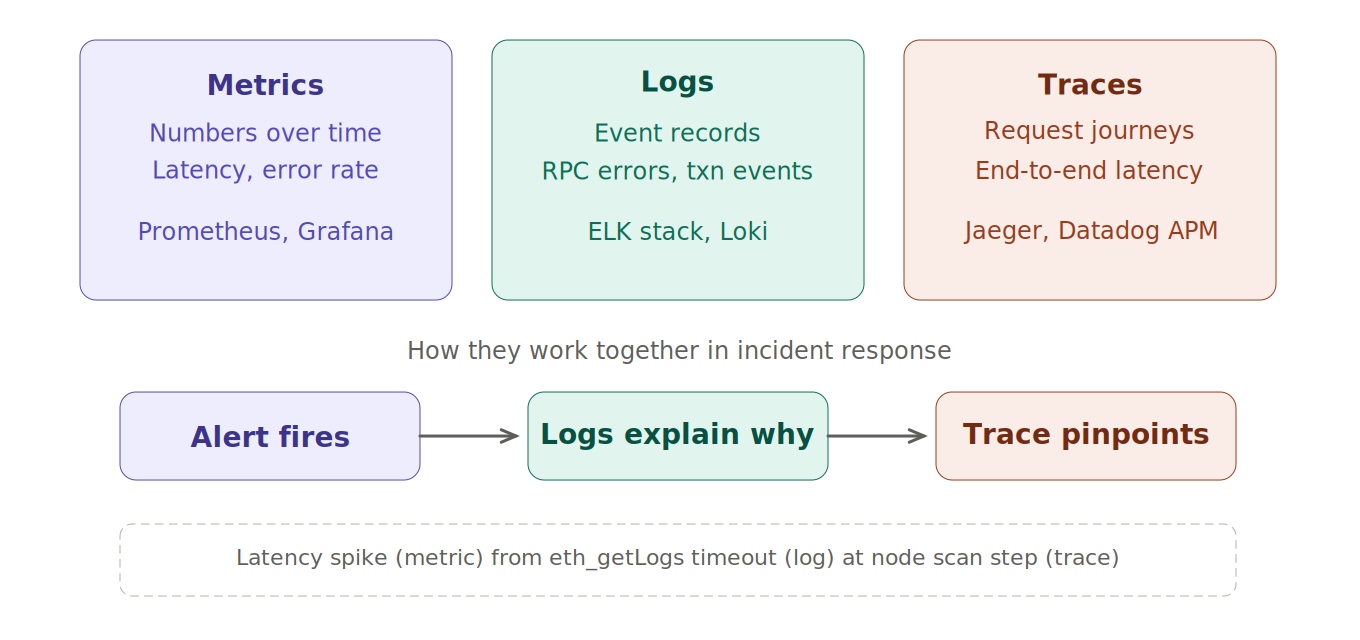
メトリクス、ログ、トレースはどのように連携しているのでしょうか? これら3つの柱は、互いに競合するものではなく、相互に補完し合うものです。メトリクスは「何かが変化した」ことを示し、ログは「具体的に何が起きたか」を明らかにし、トレースは「分散リクエストのどの段階で時間のかかりやエラーが発生したか」を特定します。健全なオブザーバビリティの実践では、これら3つすべてを活用します。つまり、メトリクスに基づいてアラートが発報され、トレースによって問題が特定のサービスに絞り込まれ、ログによって正確なエラー内容が明らかになるのです。以下の表は、各柱が最も適切に答えられる質問を対応付けています。
柱
回答
ブロックチェーン 例
一般的なツール
指標
何が、いつ変わったのですか?
14時02分にRPCのレイテンシが急上昇した
プロメテウス、Grafana
ログ
一体何が起きたのでしょうか?
eth_call がタイムアウトエラーを返しました
ロキ、スプランク
トレース
その時間はどこに費やされたのでしょうか?
RPCスパンが500ミリ秒
Jaeger、Datadog APM
ブロックチェーン のインフラストラクチャをどのように可視化しますか? by でRPCレイヤーの計測を開始しましょう。RPCレイヤーはアプリとブロックチェーンの間に位置しているため、メソッドごとのリクエスト数、レイテンシのパーセンタイル、エラー率を記録します。また、ノードのブロック高とブロックチェーンの先端を比較するヘルスチェックを追加し、同期の遅れを早期に検知できるようにします。 次に、ユーザー のトラブルを実際に予測するシグナルにアラートを紐付け、単一の障害によって状況が把握できなくなることがないように、回復力を考慮した設計を行います。可観測性を、信頼性の高いノード 、高可用性 、および検証済みのフェイルオーバー経路と 組み合わせることで、何かが故障した際にもそれを把握し、迂回できるようになります。
よくある質問
オブザーバビリティとは、モニタリングと同じものなのでしょうか? いいえ。モニタリングはあらかじめ定義されたシグナルを監視し、閾値を超えた場合にアラートを発するものです。一方、オブザーバビリティは、予期していなかった障害を含め、あらゆる問題を調査するために十分なデータを提供します。モニタリングは、より広範なオブザーバビリティの実践の一部に過ぎません。
オブザーバビリティの3つの柱とは何ですか? メトリクス、ログ、トレース。メトリクスとは時間の経過に伴う数値的な測定値であり、ログとは個別のイベントのタイムスタンプ付き記録であり、トレースとは分散システム内を流れる単一のリクエストを追跡したものです。これらを組み合わせることで、問題の検出、原因の特定、および問題箇所の特定が可能になります。
なぜブロックチェーン ではオブザーバビリティの実現が難しいのでしょうか?アプリ? ブロックチェーン アプリケーションは、自社のインフラストラクチャ、サードパーティのRPCプロバイダー、そしてチェーン自体にまたがっているため、障害は自分が管理できないレイヤーで発生する可能性があります。このように影響範囲が広いため、輻輳や再編成といったチェーンレベルの状況を含め、すべてのレイヤーにわたる可視性が必要となります。
RPCインフラにおいて、最も重要な指標はどれでしょうか? 応答遅延、リクエスト量、エラー率、ブロック高の差が主要な指標となります。遅延とエラーからは エンドポイント 健全性を示し、リクエスト量は負荷を示し、ブロック高の差は、そのノードがチェーンの先端に追いついているかどうかを示します。
柱ごとに別の工具が必要ですか? 必ずしもそうとは限りません。多くのプラットフォームは複数の柱を網羅しており、プロバイダーは、既存のスタックに取り込むことができるRPC分析機能やメトリクスエクスポーターを提供していることがよくあります。重要なのは、特定の数のツールを揃えることではなく、アプリケーション層とブロックチェーン 層にわたる統一された可視性を実現することです。
Quicknode がオブザーバビリティをどのようにサポートするか Quicknode ブロックチェーン のインフラストラクチャ層向けに、組み込みの可観測性機能を提供します。 ダッシュボードには、リクエスト数、応答遅延、エラー率、および各リクエストごとのメソッド別内訳を示すリアルタイム分析が含まれていますQuicknode エンドポイント。これにより、開発者 は独自のモニタリングを構築することなく、RPCの利用パターンを即座に把握できるようになります。
既存の可観測性機能stacks を備えたチーム 向けに、Quicknode の専用Clusters サポート Prometheusエクスポーター統合機能により、ノードレベルのメトリクスをGrafanaダッシュボード、Datadog、またはPrometheus互換の監視システムに直接取り込むことが可能になります。これにより、アプリケーションインフラストラクチャとブロックチェーン インフラストラクチャ全体にわたる可観測性を、単一の画面で一元的に把握できるようになります。
Quicknode Streams データパイプライン層の可観測性を高め、すべてのストリームについて配信状況、処理メトリクス、エラーレポートを提供します。RPC分析ダッシュボードと組み合わせることで、開発者 はリアルタイムAPIへのアクセス状況とストリーミングデータの取り込み状況の両方について、包括的な可視性を得ることができます。
参考資料 // Publisher
Quicknode
2026年6月2日更新
2026年3月20日 — 読了時間10分