🤖 最新推出:《Quicknode 人工智慧實戰手冊》 10 個經過實測的 AI 程式設計食譜agents 。
查看食譜 存取歷史區塊鏈資料:節點與資料回填的比較 |Quicknode
我們的電子報內容豐富,包含免費資源、Quicknode 最新動態、Web3 洞見等。
CLI、Admin API 、MCP、SDK ,以及適用於 75 條以上區塊鏈的 AI 原生工具。由開發者打造,為開發者而生。
涵蓋 Python、Ruby 及 JavaScript 的最新程式碼範例。關於智慧合約、NFT 及去中心化應用程式(dApps)的深入指南。
已通過 SOC 2 Type II 認證 · ISO 27001
答案 > 了解索引與區塊鏈資料 > 如何存取歷史區塊鏈資料 簡而言之: 要存取區塊鏈的歷史資料,必須使用存檔節點(該節點儲存從創世區塊開始的每個狀態快照),或是使用資料回填工具,將過去的區塊擷取並儲存至可查詢的資料庫中。標準的全節點僅保留最近的 128 個區塊的狀態資料,並會刪除所有更早的資料,因此若在全節點上查詢六個月前的錢包餘額,將會失敗。 主要有兩種方法:透過存檔節點的 RPC 存取進行特定時間點的狀態查詢,以及透過串流式資料補全來建立全面的歷史資料庫。
VIDEO
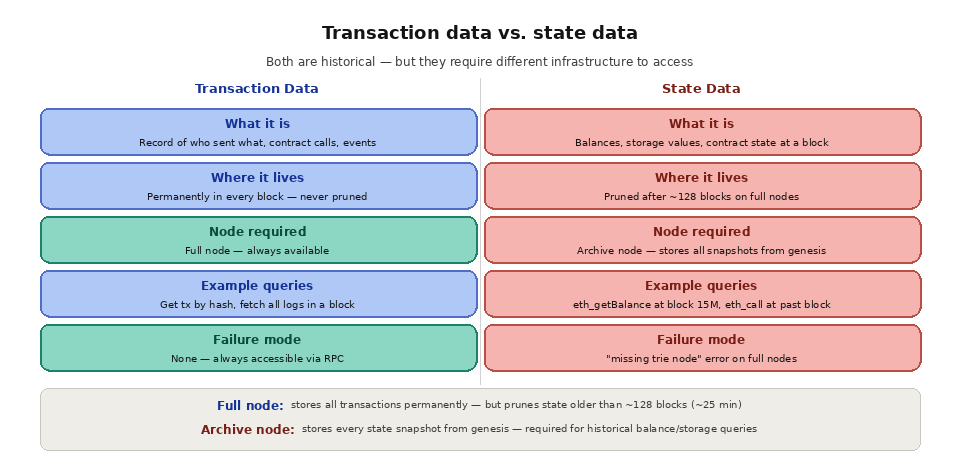
簡單的解釋 區塊鏈會記錄所有曾發生的交易,但這並不意味著每項歷史資料都能輕易取得。關鍵在於交易資料與狀態資料之間的區別。交易資料(記錄了誰向誰發送了什麼、調用了哪些合約、觸發了哪些事件)是永久性的,且存在於每個區塊中。狀態資料(任何特定時刻的餘額、儲存值及合約狀態)則屬於另一種story 。
全節點(即大多數 RPC 提供者所運行的標準節點)會儲存區塊與交易的完整歷史紀錄,但僅維護當前狀態以及近期狀態快照的滾動視窗(通常為Ethereum 上的最後 128 個區塊,約 25 分鐘)。 為了節省儲存空間,它們會修剪較舊的狀態資料。這意味著全節點可以告訴您第 15,000,000 個區塊中發生了哪些交易,但除非該區塊位於最近的保留視窗內,否則無法告訴您某個錢包在第 15,000,000 個區塊時的餘額。
當您的應用程式向全節點發送包含歷史區塊號的 RPC 呼叫(例如「eth_getBalance」)時,由於該區塊的狀態資料已被修剪,節點會回傳「缺失 trie 節點」錯誤。這是開發人員初次處理歷史資料時最常遇到的意外狀況。從所有交易皆被記錄這一點來看,區塊鏈確實「記住」了一切,但若要還原歷史上任意時間點的狀態,則需要特殊的基础設施。
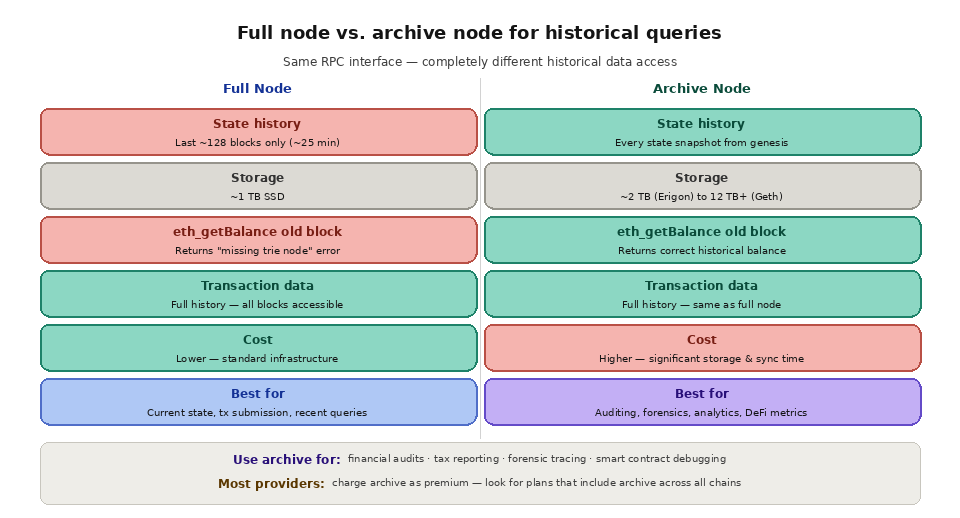
全節點與存檔節點之間有什麼區別? 要理解歷史資料存取的最快方法,就是比較大多數服務供應商所運行的兩種節點類型。全節點會保存區塊和交易的完整歷史紀錄,但會修剪舊的狀態;而存檔節點則會保存每個歷史狀態快照。若您僅需近期資料,全節點的成本較低且速度較快;但若要查詢特定時間點的歷史狀態,則需要使用存檔節點。如需更深入的解析,請參閱我們關於「全節點與存檔節點比較」 的指南,以及「什麼是區塊鏈節點 」的概述。
能力
完整節點
存檔節點
州級留任
最近的 ~128 個區塊(在Ethereum 上約 25 分鐘)
從最初到最新,每個階段
儲存佔用空間
約 1TB 的Ethereum
12TB 或以上Ethereum
歷史狀態查詢
因缺少 trie 節點而發生錯誤
回傳任何區塊高度時的狀態
營運成本
較低
顯著更高
最適合
當前餘額與近期交易紀錄
審計、稅務申報、法證、分析
用於特定時間點查詢的存檔節點 存檔節點透過保留從創世區塊開始的所有狀態快照,來解決狀態修剪問題。一個Ethereum 存檔節點儲存的資料量超過 12TB,相較於全節點的大約 1TB,這使得其運作與維護成本高出許多。但它提供了一項關鍵功能:能夠查詢任何帳戶、合約或儲存槽在任何歷史區塊高度下的確切狀態。
這對於多種使用情境而言至關重要。財務稽核需要重建特定日期時的帳戶餘額;稅務申報則需確定年終時的資產價值;鑑識分析則透過歷史狀態轉變來追蹤資金的flow ;智慧合約除錯則利用歷史狀態來重現並分析過去的錯誤或漏洞;而 DeFi 協議分析則透過查詢過去區塊高度時的池狀態,來計算歷史 TVL、APY 及其他指標。
自行運作存檔節點會消耗大量資源。初始同步需耗時數週,儲存成本高昂,且該節點需要持續維護、客戶端更新及監控。多數團隊是透過基礎設施供應商存取存檔資料,而非自行運作節點。在評估供應商時,關鍵考量在於:存檔存取功能是否已包含在您的方案中,或是作為付費附加服務計費;以及該供應商是否支援您應用程式所需的所有區塊鏈上的存檔資料。
您可以查詢多早的區塊鏈歷史資料? 透過存檔節點,您可以查詢任何帳戶、合約或儲存槽的狀態,其追溯範圍可一直回溯至創世區塊。即使在標準的全節點上,每個區塊的交易和事件資料皆可取得,但歷史餘額與合約儲存資料僅能透過存檔節點恢復。當您決定需要「特定時間點的狀態」還是「過去活動的完整記錄」時,這項區別至關重要——這項權衡取捨,我們已在「即時與歷史區塊鏈資料 」一文中進行探討。 若您的查詢持續失敗,通常是因為請求送達了全節點;因此,了解RPC 請求的運作原理 ,有助於您正確地路由這些請求。
歷史資料庫的串流補存 存檔節點可回應特定時間點的狀態查詢,但許多歷史資料的應用場景需要的是另一種解決方案:一個包含過往區塊、交易、事件日誌及追蹤紀錄的完整且可查詢的資料庫。要建置區塊鏈分析儀表板、代幣轉帳歷史紀錄 API 或全面的區塊瀏覽器,必須將歷史區塊資料處理並儲存於結構化資料庫中,而不僅是按需查詢存檔節點。
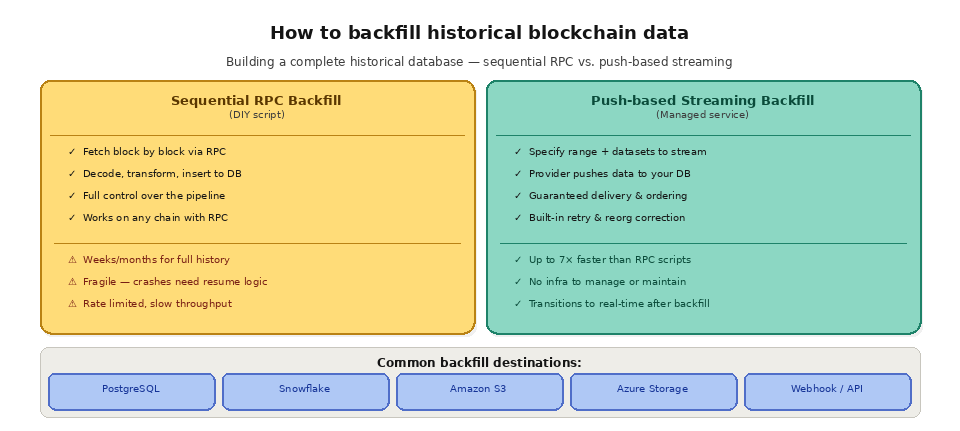
建立此資料庫的傳統做法是撰寫一個腳本,逐個遍歷區塊,透過 RPC 擷取每個區塊的資料,解碼交易和日誌,並將結果插入您的資料庫中。這種方法雖然可行,但在大規模運作時卻既緩慢又脆弱。 若透過序列化的 RPC 呼叫來補全Ethereum 的完整歷史紀錄(超過 2,000 萬個區塊),可能需要數週甚至數月。該腳本必須處理速率限制、連線失敗、節點超時、重試以及區塊排序等問題。若腳本在執行中途當機,您需要一套邏輯來從中斷處繼續處理,同時確保資料中不會產生缺口或重複項。
基於推送的資料回填工具透過處理供應商端基礎架構的複雜性,來解決這些營運上的難題。 您只需指定區塊範圍、選取所需資料集(區塊、交易、收據、追蹤紀錄、日誌),並可選擇套用篩選條件,系統便會將資料推送至您的目標位置,並保證送達、順序正確,以及在發生錯誤時自動重試。一旦歷史資料補填完成,同一條資料管線即可轉為即時串流模式,隨著新區塊產生,持續保持您的資料庫處於最新狀態。
歷史資料的回填需要多久時間? 資料補填所需的時間取決於區塊鏈、區塊範圍以及您所請求的資料集。若使用標準 RPC 逐個擷取區塊的順序式腳本,要處理 2,000 萬個區塊可能需要數週甚至數月,且必須自行處理重試、排序及恢復等作業。託管式推送型資料補填則能將工作並行化,完成速度最高可提升七倍,且在開始前便會顯示預估成本與完成時間。 底層RPC 基礎架構 的吞吐量,是任何自行處理方案的主要限制因素。
歷史資料的其他方法 The Graph 及其他索引協定會透過子圖(subgraphs)提供特定智慧合約的預先索引歷史資料。若已有使用者為您需要資料的協定(例如 Uniswap、Aave 或 Lido)部署了子圖,您便無需自行建置資料管線,即可透過其 GraphQL API 查詢歷史資料。其限制在於,子圖是針對特定合約及特定資料結構設計的,因此您只能查詢該子圖作者選擇索引的內容。
像 Dune Analytics、Flipside Crypto 和 Nansen 這樣的第三方資料供應商,會維護涵蓋各大區塊鏈的全面歷史資料庫,並透過 SQL 介面或 API 提供存取。這些資料庫雖便於分析與研究,但會導致系統對第三方資料的新鮮度、準確性及可用性產生依賴。對於需要自主掌控資料管道的生產環境應用程式而言,直接基於原始區塊鏈資料(透過存檔節點或資料回填streams )進行建構,能提供更高的控制權與可靠性。
特定區塊鏈的區塊鏈瀏覽器與 API(例如 Etherscan 的 API)提供了獲取歷史資料的另一種途徑,但這些服務通常對免費方案實施嚴格的速率限制,且可能無法提供生產環境應用程式所需的細緻程度或完整性。
您應該使用哪種方法來存取區塊鏈的歷史資料? 並沒有單一的最佳方法:正確的選擇取決於您需要的是特定時間點的狀態、可完整查詢的資料庫,還是預先彙總的分析結果。下表概述了主要選項。若您的目標是高效的重複存取,而非一次性查詢,請在決定前比較RPC 與索引技術 ,並了解何謂區塊鏈索引 ,因為大規模查詢區塊鏈資料的 難度比表面上看起來更高。
方法
最適合
主要限制
存檔節點 RPC
任何區塊的特定時間點狀態
並非大型資料庫
串流補播
建立一個完整且可查詢的資料庫
需要一個儲存資料的目標位置
索引協定與子圖
特定合約的歷史資料
僅限於已被索引的內容
第三方資料 API
分析與研究
對供應商的依賴
區塊鏈瀏覽器 API
快速查詢
嚴格的速率限制與有限的細粒度
Quicknode 如何提供歷史資料存取功能 Quicknode 包含所有方案皆可存取存檔節點的功能,無需另行管理或支付存檔基礎架構的費用。每個Quicknode RPCendpoint 皆可處理任何區塊高度(從創世區塊到最新區塊)的歷史狀態查詢。Quicknode 的 QRoute 技術會自動將歷史狀態請求路由至存檔節點,將當前狀態請求路由至全節點,並透過單一endpoint 網址傳遞兩者,無需任何設定。
在建立歷史資料庫方面,Quicknode Streams 提供一鍵式回填範本,讓您能將 20 多個區塊鏈網路的完整鏈上歷史資料匯入資料庫。您只需選擇區塊鏈、資料集類型(區塊、交易、收據、追蹤紀錄,或全功能組合),以及目標儲存位置(PostgreSQL、Snowflake、Amazon S3、Azure Storage、webhooks ),Streams 便會推送資料,並保證資料送達、正確的區塊排序,以及內建的重試邏輯。 系統會在您開始前顯示成本與完成時間的預估,讓您完全掌握狀況。資料回填的速度最高可比傳統基於 RPC 的腳本快七倍,且一旦完成,同一條資料流可繼續進行即時mode ,以確保您的資料庫始終保持最新狀態。
延伸閱讀
常見問題
什麼是區塊鏈歷史資料? 區塊鏈歷史資料是指任何關於過去鏈上活動的記錄,包括區塊、交易、事件日誌、追蹤紀錄,以及特定區塊高度下的狀態(餘額與合約儲存內容)。交易資料在每個節點上皆為永久儲存,但歷史狀態則需要仰賴存檔節點或已儲存的補全資料。
為什麼在舊區塊上執行 eth_getBalance 會失敗? 標準的全節點會修剪大約最後 128 個區塊之前的老舊狀態,因此對歷史上的 eth_getBalance 呼叫會返回「缺少 trie 節點」的錯誤。查詢保留了所有狀態快照的存檔節點,即可解決此錯誤。
我需要一個存檔節點才能存取歷史資料嗎? 若要在任意區塊高度進行特定時間點狀態查詢,您需要存取存檔。若您僅需歷史交易紀錄和事件日誌,可從全節點讀取,或透過回填功能將其儲存至您自己的資料庫中。
什麼是區塊鏈資料回填? 回填功能會擷取過去某個區間內的區塊及其資料集,並將其載入資料庫或儲存目標。基於推送的回填機制會處理排序、重試及保證傳送等事宜,待資料擠平後,即可切換至即時串流模式。
Ethereum 存檔節點的儲存容量是多少? 一個Ethereum 存檔節點的儲存容量約為 12TB 或更多,相較之下,完整節點的儲存容量則約為 1TB。這額外的儲存空間用來存放所有歷史狀態快照,這也是為何存檔基礎設施的運作成本較高的原因。
// Publisher
Quicknode
更新於 2026 年 6 月 2 日
2026年2月3日 — 閱讀時間 10 分鐘