Réponses>En savoir plus sur les RPC et les API>Qu'est-ce que la latence RPC ?
Qu'est-ce que la latence RPC ?
// Tags
Latence RPCLatence de la blockchainTemps de réponse de l'API
En bref : la latence RPC correspond au temps nécessaire à votre application pour envoyer une requête à un nœud de blockchain et recevoir une réponse. Elle est mesurée en millisecondes et influe directement sur la rapidité perçue de votre dapp par les utilisateurs. Une latence élevée se traduit par des mises à jour de solde lentes, des confirmations de transactions retardées et des opportunités de trading manquées. Une faible latence garantit une expérience réactive et en temps réel. La latence RPC dépend de la distance du réseau, des performances des nœuds, de la complexité des requêtes et de la qualité de votre fournisseur d'infrastructure.
L'explication simple
Chaque fois que votre application interagit avec la blockchain, il y a un délai entre le moment où la requête est envoyée et celui où la réponse est reçue. Ce délai correspond à la latence. Lorsqu’un utilisateur ouvre votre application de portefeuille et attend une demi-seconde pour voir son solde, ce temps d’attente est principalement dû à la latence RPC. Lorsqu’un bot de trading envoie une transaction d’échange et qu’il faut 200 millisecondes pour recevoir la confirmation que le nœud l’a acceptée, ces 200 ms correspondent à la latence. Ce chiffre peut sembler insignifiant, mais dans les applications blockchain, en particulier dans les domaines de la DeFi, des jeux et du trading, ces millisecondes s’additionnent pour faire une réelle différence en termes d’expérience utilisateur et de résultats financiers.
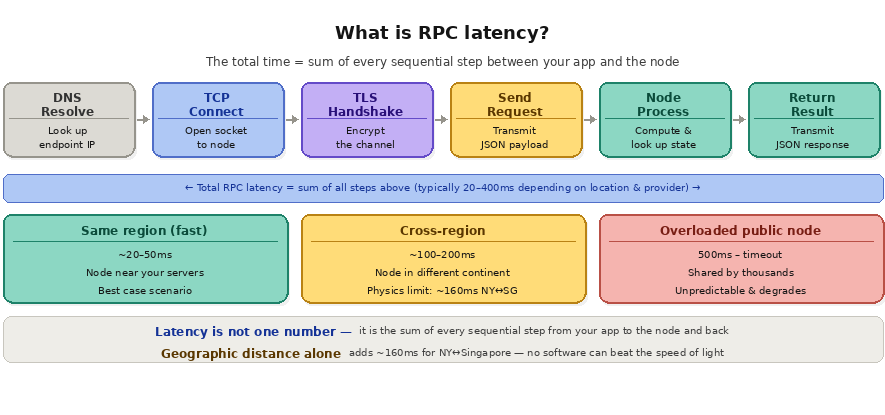
La latence ne se résume pas à un simple chiffre. Elle correspond à la somme de plusieurs étapes successives : la résolution DNS (recherche de l'adresse IP de endpoint), l'établissement de la connexion TCP, la négociation TLS (chiffrement de la connexion), la transmission de la requête, le temps de traitement par le nœud, la transmission de la réponse et l'analyse de la réponse. Chaque étape ajoute du temps. Une requête adressée à un nœud situé dans la même région géographique peut s'exécuter en 20 à 50 ms. Une requête adressée à un nœud situé à l'autre bout du monde peut prendre entre 200 et 400 ms. La même requête adressée à un nœud surchargé ou mal entretenu peut prendre plusieurs secondes, voire aboutir à un délai d'expiration.
Pourquoi la latence est plus importante que vous ne le pensez
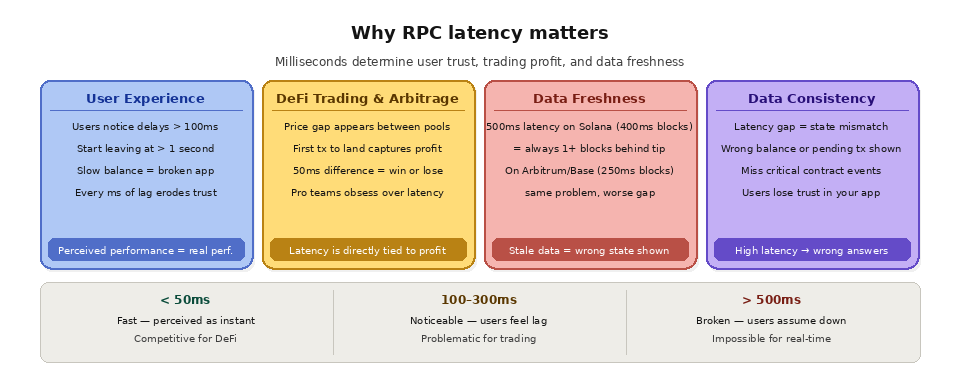
Pour les applications destinées aux utilisateurs, la latence est le facteur qui influence le plus la perception des performances. Des études menées sur diverses applications web montrent systématiquement que les utilisateurs remarquent les délais supérieurs à 100 ms et commencent à abandonner leurs interactions dès que le délai dépasse 1 seconde. Il en va de même pour les applications blockchain. Si la consultation d’un solde prend deux secondes parce que votre fournisseur RPC est lent, les utilisateurs penseront que votre application est défectueuse, et non que l’infrastructure sous-jacente est lente.
Dans le domaine du trading et de l'arbitrage DeFi, la latence est directement liée à la rentabilité. Lorsqu'un écart de prix apparaît entre deux pools de liquidité, le premier bot à conclure une transaction empoche le bénéfice. Une différence de 50 ms dans le temps de réponse RPC peut déterminer si votre transaction sera traitée avant celle d'un concurrent. C'est pourquoi les équipes de trading professionnelles accordent une importance capitale à la latence de leur infrastructure et utilisent souvent des points de terminaison dédiés situés à proximité géographique des validateurs.
En matière de cohérence des données, la latence crée un décalage entre l'état réel de la blockchain et ce qu'affiche votre application. Sur Solana, où les blocs sont générés toutes les 400 ms, un fournisseur RPC présentant une latence moyenne de 500 ms signifie que votre application accuse toujours un retard d'au moins un bloc par rapport à la pointe de la chaîne. Sur les couches 2 (L2) d’ Ethereum , telles que Arbitrum ou Base, qui produisent des blocs toutes les 250 ms, le même problème se pose. Quicknode a introduit un indicateur appelé « Latency Freshness Score » (score de fraîcheur de la latence) qui compare le temps de réponse RPC au taux de production de blocs d’une chaîne, offrant ainsi aux développeurs une mesure précise du degré de proximité de leurs données par rapport au temps réel.
Quels sont les facteurs qui déterminent la latence des RPC ?
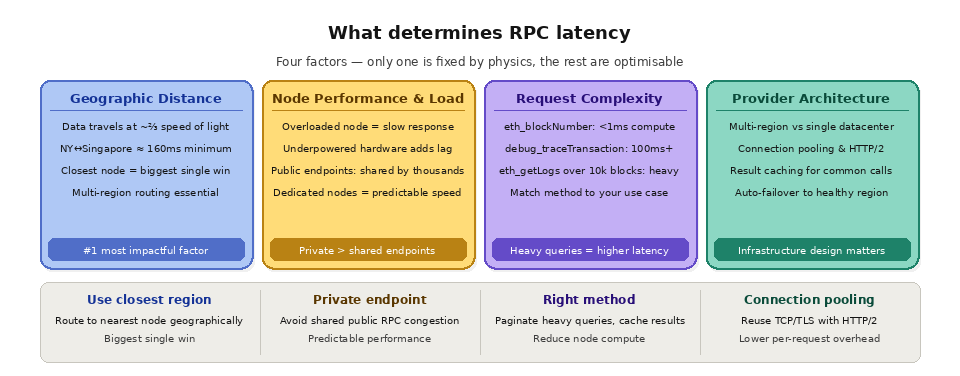
La distance géographique est le facteur le plus déterminant. Les données circulent dans les câbles à fibre optique à environ deux tiers de la vitesse de la lumière, ce qui signifie qu’un aller-retour entre New York et Singapour ajoute environ 160 ms de latence purement physique qu’aucune optimisation logicielle ne peut éliminer. Se connecter à un nœud géographiquement proche de vos serveurs d’applications (ou de vos utilisateurs) est la mesure la plus efficace que vous puissiez prendre pour réduire la latence.
Les performances et la charge d'un nœud constituent le deuxième facteur. Un nœud qui traite des milliers de requêtes simultanées, qui accuse un retard dans la synchronisation des blocs ou qui fonctionne sur du matériel sous-dimensionné répondra plus lentement qu'un nœud correctement provisionné et peu sollicité. C'est là le problème fondamental des points de terminaison RPC publics : ils sont partagés par des milliers d'utilisateurs, ce qui rend leurs temps de réponse imprévisibles et entraîne une dégradation des performances lors des pics de trafic.
La complexité de la requête a également son importance. Un simple appel « eth_blockNumber » ne nécessite pratiquement aucun calcul et renvoie une réponse minime. Un appel « debug_traceTransaction » oblige le nœud à réexécuter une transaction dans son intégralité et à renvoyer une trace d’exécution détaillée, ce qui peut prendre des centaines de millisecondes, voire plus. Une requête « eth_getLogs » couvrant des milliers de blocs oblige le nœud à analyser des volumes importants de données. Comprendre la charge de calcul de vos appels RPC vous aide à définir des attentes réalistes et à optimiser vos modèles de requêtes.
L'architecture de l'infrastructure du fournisseur constitue le dernier facteur. Les fournisseurs qui exploitent des clusters de nœuds répartis à l'échelle mondiale, dotées d'un routage intelligent des requêtes, d'un pool de connexions et d'une mise en cache des résultats, offrent une latence plus faible et plus constante que ceux dont les nœuds sont regroupés dans un seul centre de données. Les architectures multirégionales offrent également une meilleure résilience : si une région rencontre des problèmes, le trafic est automatiquement redirigé vers la région opérationnelle la plus proche.
Quelle est une bonne latence RPC ?
Un bon objectif de latence dépend de la chaîne que vous servez et de la localisation de vos utilisateurs. Le critère de référence utile n’est pas une valeur absolue en millisecondes, mais la façon dont votre temps de réponse se compare au rythme de production des blocs de la chaîne : si vous répondez plus lentement que la chaîne ne produit de blocs, vos données sont toujours obsolètes d’au moins un bloc. Le tableau ci-dessous présente des objectifs concrets pour une réactivité en temps réel.
Contexte
Durée du bloc
Objectif de latence pour le temps réel
Solana
intervalle d'environ 400 ms
Moins de ~100 ms
Ethereum L2 (Base, Arbitrum)
environ 250 ms
Moins de ~100 ms
Ethereum L1
environ 12 secondes
Moins de ~250 ms
Demande concernant la même région
Sans objet
20 à 50 ms
Demande internationale
Sans objet
200 à 400 ms
En règle générale, les utilisateurs perçoivent les délais supérieurs à 100 ms ; ainsi, en maintenant les temps de réponse RPC typiques en dessous de ce seuil, la réponse semble instantanée. Pour comprendre les mécanismes qui se cachent derrière ces chiffres, découvrez le fonctionnement des requêtes RPC et le rôle de l'endpoint.
Quelle est la différence entre la latence et le débit ?
On confond souvent la latence et le débit, alors qu'ils mesurent des choses différentes. La latence correspond au temps nécessaire à une requête pour aller de son envoi à la réponse. Le débit, quant à lui, correspond au nombre de requêtes que le système peut traiter par unité de temps. Un fournisseur peut présenter une faible latence mais un débit limité, ou un débit élevé mais une latence irrégulière en cas de charge importante. Ces deux paramètres sont importants, et l'optimisation de l'un n'améliore pas automatiquement l'autre.
Aspect
Latence
Débit
Mesures
C'est l'heure d'une demande
Nombre de requêtes traitées par seconde
Unité
Millisecondes
Nombre de requêtes par seconde
Perçu comme
Quelle est la réactivité perçue de l'application ?
Quelle charge peut-il supporter ?
Blessé par
Distance et charge des nœuds
Limites de capacité et plafonds tarifaires
Pour une analyse plus approfondie de ce compromis, voir « Débit vs latence ». Un volume élevé de requêtes peut également déclencher une limitation du débit RPC, ce qui entraîne des tentatives de réémission et une mise en file d'attente qui se traduisent par une latence effective plus élevée.
Comment réduire la latence RPC ?
Les gains les plus importants proviennent de la réduction de la distance et de l’allègement de la charge. Connectez-vous à un nœud géographiquement proche de vos utilisateurs, utilisez un fournisseur multirégional avec routage automatique et réutilisez les connexions afin d’éviter les coûts répétés liés à la configuration DNS, TCP et TLS. Regroupez ou simplifiez les appels lourds, et remplacez les boucles d’interrogation serrées par une diffusion de type « push » afin de ne pas payer à plusieurs reprises la latence des requêtes pour les mêmes données. Privilégier le streaming au polling, s'appuyer sur des nœuds fiables et disposer d'un chemin de basculement permettent de maintenir une latence faible et constante, même en cas de dégradation d'un itinéraire.
Foire aux questions
La latence RPC correspond-elle au temps de confirmation d'un bloc ?
Non. La latence RPC correspond au temps aller-retour nécessaire pour interroger un nœud et obtenir une réponse, mesuré en millisecondes. Le temps de confirmation d’un bloc correspond au temps que met la chaîne pour inclure et finaliser une transaction, ce qui est régi par le protocole. Même une endpoint RPC rapide ne peut pas permettre à une chaîne de confirmer des blocs plus rapidement que son temps de bloc.
Pourquoi mon endpoint RPC est-il lent ?
Les causes les plus courantes sont la distance géographique par rapport au nœud, un nœud fortement sollicité ou sous-dimensionné, ainsi que des types de requêtes coûteuses telles que les requêtes de traçage ou les requêtes portant sur des journaux volumineux. Les points de terminaison publics partagés par de nombreux utilisateurs sont particulièrement exposés à des pics de latence imprévisibles lors des pics de trafic.
La latence a-t-elle une incidence sur le trading DeFi ?
Oui, directement. Lorsqu'une opportunité d'arbitrage se présente, la première transaction validée permet de réaliser le bénéfice ; ainsi, même un avantage de 50 ms sur le temps de réponse RPC peut déterminer si votre transaction sera prise en compte avant celle d'un concurrent.
Comment mesure-t-on la latence RPC ?
Il s'agit du temps écoulé entre l'envoi d'une requête et la réception de la réponse, qui englobe la résolution DNS, l'établissement de la connexion, la négociation TLS, la transmission, le traitement par les nœuds et l'analyse de la réponse. Les équipes ont généralement pour habitude de suivre les percentiles de latence, tels que le p50 et le p99, plutôt qu'une simple moyenne.
Une faible latence est-elle synonyme de données récentes ?
Pas en soi. Une « fast- endpoint » en retard sur la synchronisation des blocs peut rapidement renvoyer des résultats obsolètes. Pour garantir l'actualité en temps réel, il faut à la fois une faible latence et un nœud étroitement synchronisé avec la pointe de la chaîne ; c'est pourquoi le temps de réponse doit être comparé au taux de production des blocs.
Comment « Quicknode » garantit une faible latence
QuicknodeSon infrastructure est spécialement conçue pour permettre un accès aux données blockchain à faible latence. La plateforme exploite un réseau distribué à l’échelle mondiale couvrant plus de 14 régions réparties sur plus de 5 fournisseurs de services cloud et de serveurs physiques, garantissant ainsi que les requêtes sont acheminées vers le nœud disponible le plus proche, quel que soit l’emplacement de votre application ou de vos utilisateurs. Cette architecture offre des temps de réponse en moyenne 2,5 fois plus rapides que ceux de la concurrence, selon les mesures effectuées par QuickLee, l’outil open source d’ Quicknode dédié au benchmarking RPC, qui fournit des données de latence transparentes et en temps réel sur plusieurs chaînes et régions.
Quicknode garantit une actualité élevée de la hauteur des blocs sur toutes les chaînes prises en charge, ce qui signifie que ses nœuds sont toujours parfaitement synchronisés avec le dernier bloc. Cela est essentiel pour les chaînes à évolution rapide, où un retard de quelques blocs seulement par rapport à la pointe de la chaîne suffit à dégrader la fraîcheur des données. L'infrastructure s'adapte automatiquement en fonction de la demande de trafic et intègre des mécanismes de basculement automatique, ce qui permet de maintenir une latence constante même lors des pics de trafic.
QuicknodePour les applications soumises aux exigences les plus strictes en matière de latence, les services « Dedicated Clusters » d’ Quicknode offrent une infrastructure isolée et privée, sans trafic partagé avec d’autres clients. Les services « Dedicated Clusters » éliminent totalement le problème des « voisins bruyants », garantissant ainsi des performances prévisibles et une faible latence à tout moment. En ce qui concerne spécifiquement les services « Solana », les Yellowstone gRPC utilisent Protocol Buffers à la place de JSON pour la sérialisation des données, ce qui réduit la taille de la charge utile et le temps d’analyse, garantissant ainsi la latence la plus faible possible dans les cas d’utilisation à haute fréquence.