Réponses>En savoir plus sur la fiabilité et la disponibilité>Qu'est-ce que le basculement ?
Qu'est-ce que le basculement ?
// Tags
basculementbasculement automatique
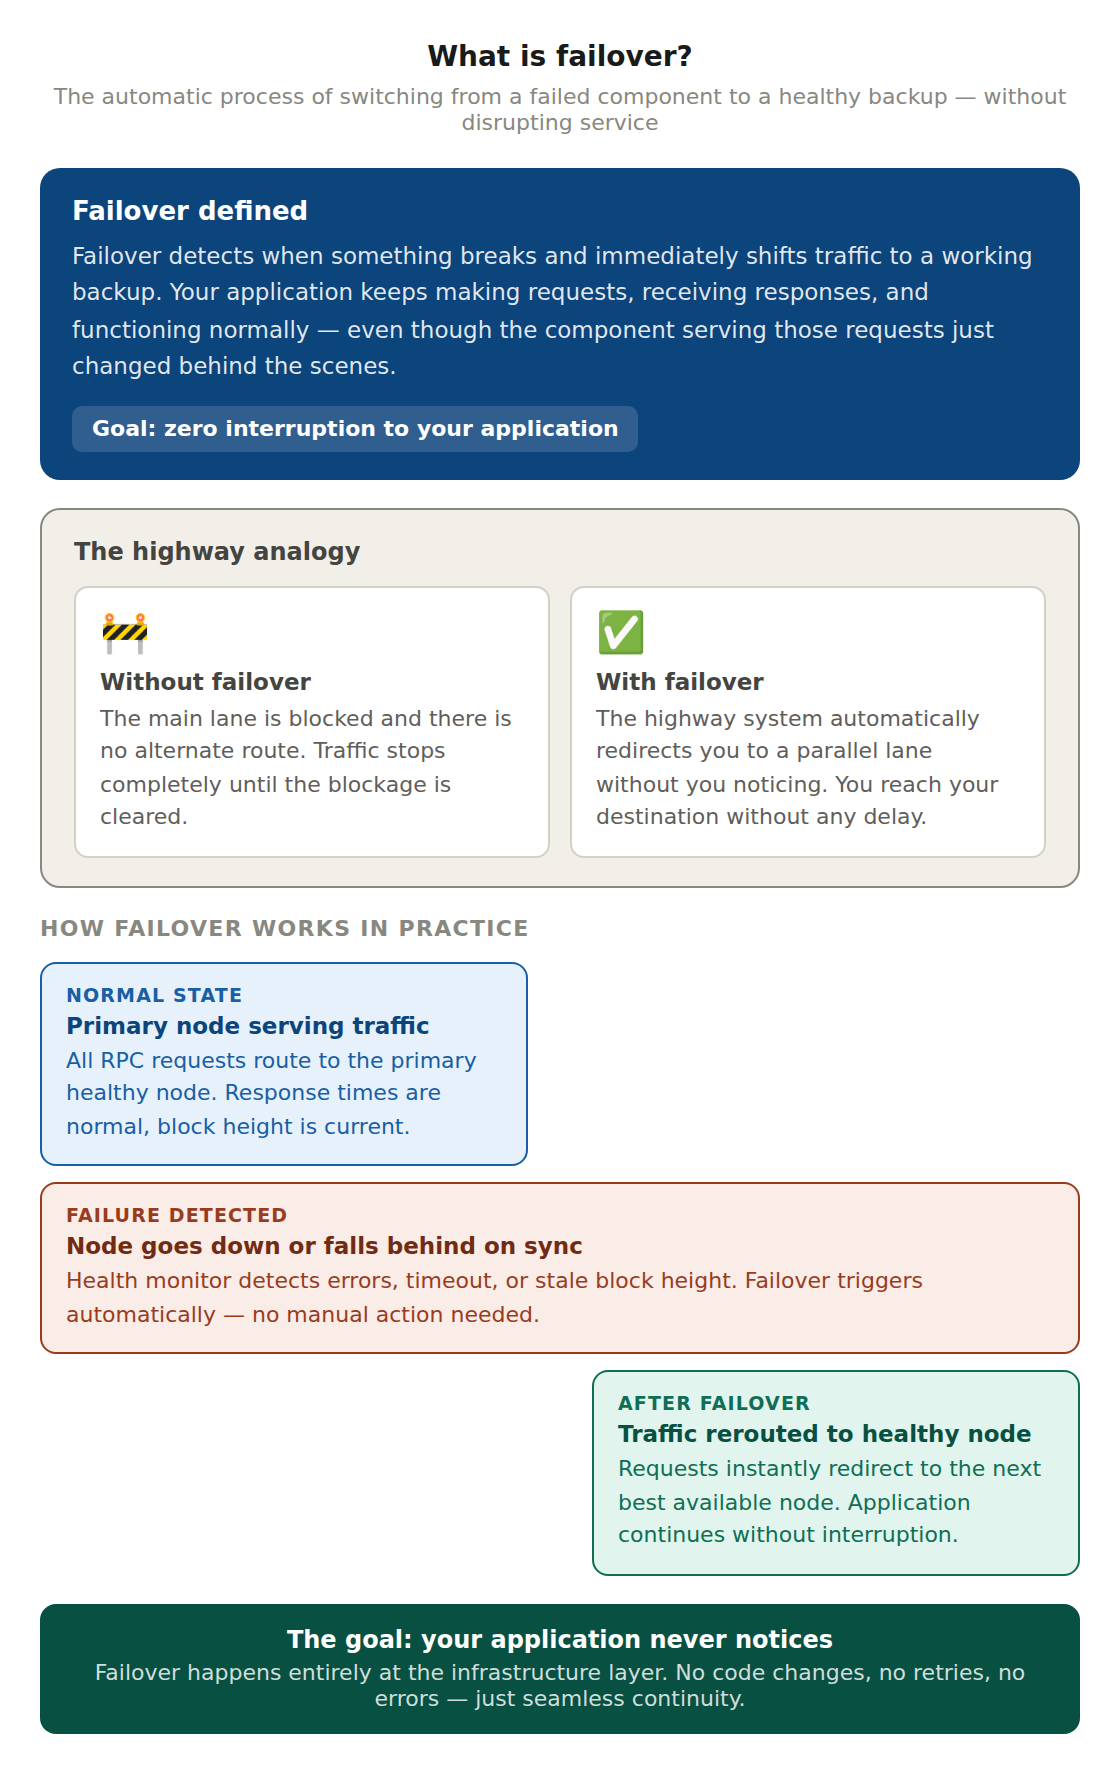
En bref : le basculement (failover) est le processus automatique qui consiste à passer d'un composant défaillant à une solution de secours opérationnelle sans interrompre le service. Dans une infrastructure blockchain, le basculement garantit que, lorsqu'un nœud, un serveur ou un centre de données tombe en panne, les requêtes RPC de votre application sont redirigées de manière transparente vers une autre endpoint opérationnelle.
Le concept de base
Imaginez que vous roulez sur une autoroute et que la voie principale soit soudainement bloquée. S'il n'y a pas d'itinéraire alternatif, vous êtes bloqué. Mais si le réseau autoroutier vous redirige automatiquement vers une voie parallèle sans même que vous vous en rendiez compte, c'est un exemple concret de basculement.
En termes d'infrastructure, le basculement est le mécanisme qui détecte une défaillance et redirige immédiatement le trafic vers une solution de secours. L'objectif est d'atteindre une interruption nulle (ou « near e nulle »). Votre application continue d'envoyer des requêtes, de recevoir des réponses et de fonctionner normalement, même si le composant qui traite ces requêtes vient de changer en arrière-plan.
Fonctionnement du basculement dans une infrastructure blockchain
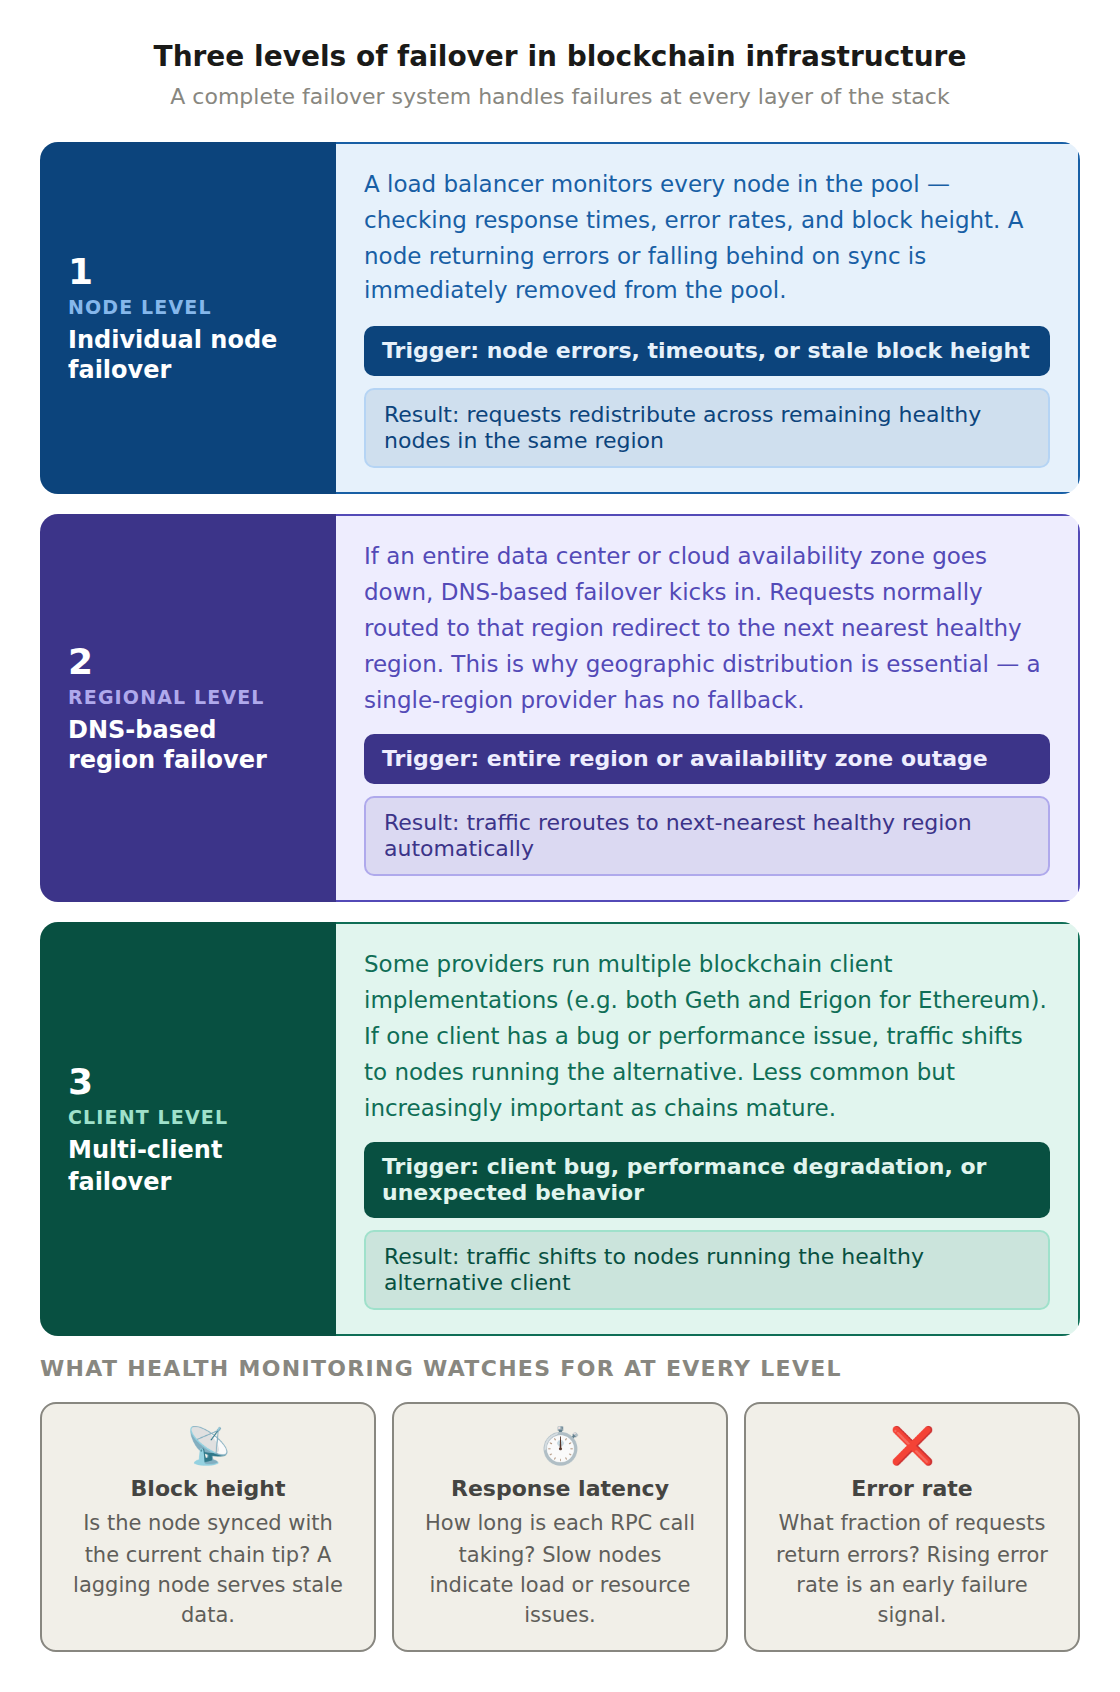
L'infrastructure blockchain comporte un ensemble spécifique de composants susceptibles de tomber en panne. Les plus courants sont les nœuds individuels, des régions ou des centres de données entiers, ainsi que certaines implémentations de clients blockchain. Un bon système de basculement prend en charge ces trois cas de figure.
Au niveau des nœuds, le basculement est relativement simple. Un équilibreur de charge surveille en permanence l'état de chaque nœud du pool, en vérifiant les temps de réponse, les taux d'erreur et la hauteur du bloc. Si un nœud commence à renvoyer des erreurs ou prend du retard dans la synchronisation, l'équilibreur de charge cesse de lui envoyer du trafic et répartit les requêtes entre les nœuds restants en bon état.
Au niveau régional, les choses deviennent plus intéressantes. Si un centre de données entier ou une zone de disponibilité cloud subit une panne, le basculement basé sur le DNS se déclenche. Les requêtes qui seraient normalement acheminées vers cette région sont automatiquement redirigées vers la région opérationnelle la plus proche. C'est pourquoi la répartition géographique est importante. Un fournisseur qui exploite des nœuds dans une seule région ne dispose d'aucune solution de secours lorsque cette région est hors service.
Au niveau des clients, certains fournisseurs exploitent plusieurs implémentations de clients blockchain (par exemple, à la fois Geth et Erigon pour Ethereum). Si une implémentation de client présente un bug ou un problème de performances, le trafic peut être redirigé vers des nœuds exécutant l'autre client. Ce niveau de redondance est moins courant, mais prend de plus en plus d'importance.
Basculement actif vs basculement passif
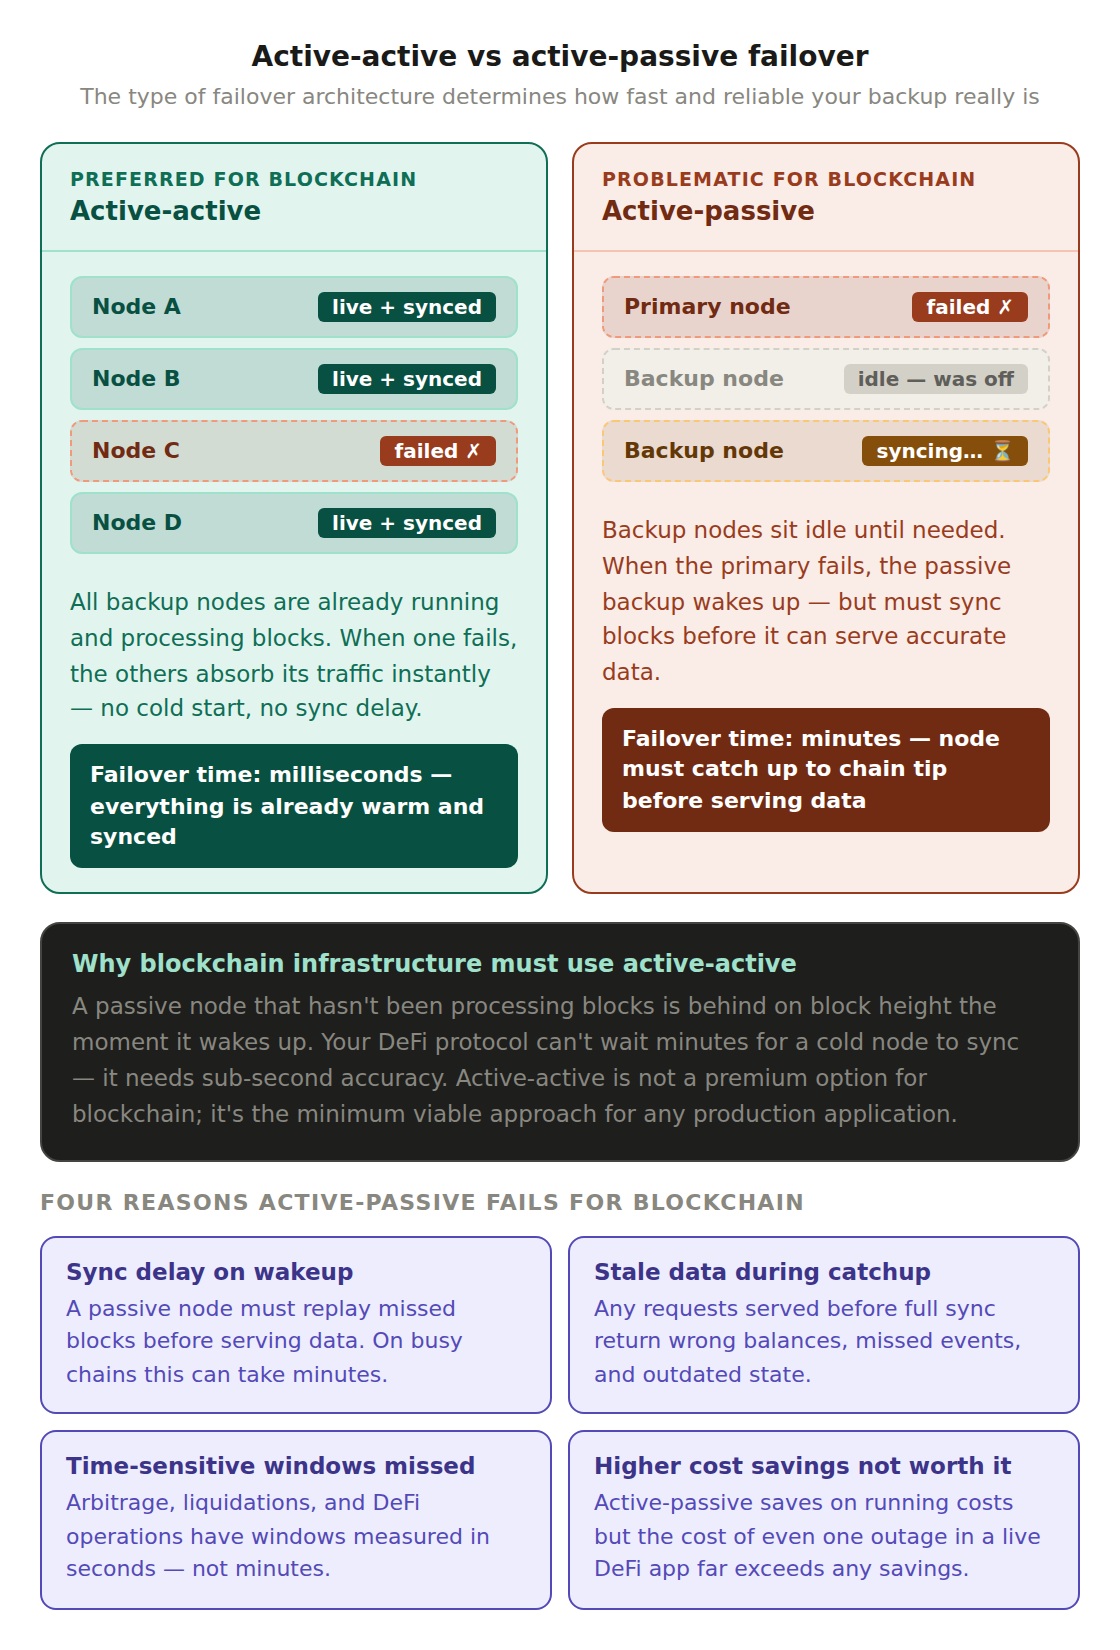
Il existe deux grandes approches en matière de basculement, et cette distinction a une incidence sur les performances.
Dans les configurations « actif-actif », tous les composants de secours sont déjà en fonctionnement et traitent le trafic. Lorsqu’un d’entre eux tombe en panne, les autres prennent simplement en charge sa part de charge. Il n’y a pas de délai de « démarrage à froid », car tout est déjà opérationnel. C’est le modèle privilégié pour les infrastructures de blockchain, car les nœuds doivent rester synchronisés avec la chaîne. Un nœud qui ne traite pas activement les blocs prendra du retard sur la hauteur du bloc et sera inutilisable jusqu’à ce qu’il rattrape son retard.
Dans les configurations actives-passives, les composants de secours restent inactifs jusqu’à ce qu’on en ait besoin. En cas de défaillance du nœud principal, le nœud de secours passif s’active et prend le relais. Ce mode de fonctionnement est moins coûteux, mais entraîne un délai. Pour les nœuds de blockchain, ce délai peut être important, car le nœud passif peut avoir besoin de synchroniser des blocs avant de pouvoir fournir des données exactes.
La plupart des infrastructures blockchain en production utilisent le basculement « actif-actif » précisément pour cette raison. Vous ne pouvez pas vous permettre d’attendre qu’un nœud « froid » rattrape son retard lorsque votre protocole DeFi nécessite une précision des données inférieure à la seconde.
Le tableau ci-dessous présente une comparaison des deux modèles de basculement pour les charges de travail liées à la blockchain :
Aspect
Actif-Actif
Actif-Passif
État de la sauvegarde
Tous les nœuds sont en service et traitent le trafic
Les nœuds de secours restent inactifs jusqu’à ce qu’on en ait besoin
Délai de basculement
Near zéro, pas de démarrage à froid
À noter : la sauvegarde doit s'initialiser et se synchroniser
Coût d'exploitation
Au-delà, vous payez pour la capacité totale
À un niveau inférieur, le mode veille consomme moins de ressources
Synchronisation de la hauteur des blocs
Toujours à jour
Peut prendre du retard et devoir rattraper son retard
Idéal pour
RPC de production et données en temps réel
Charges de travail sensibles au coût ou non critiques
Pourquoi le basculement est indispensable pour les applications blockchain
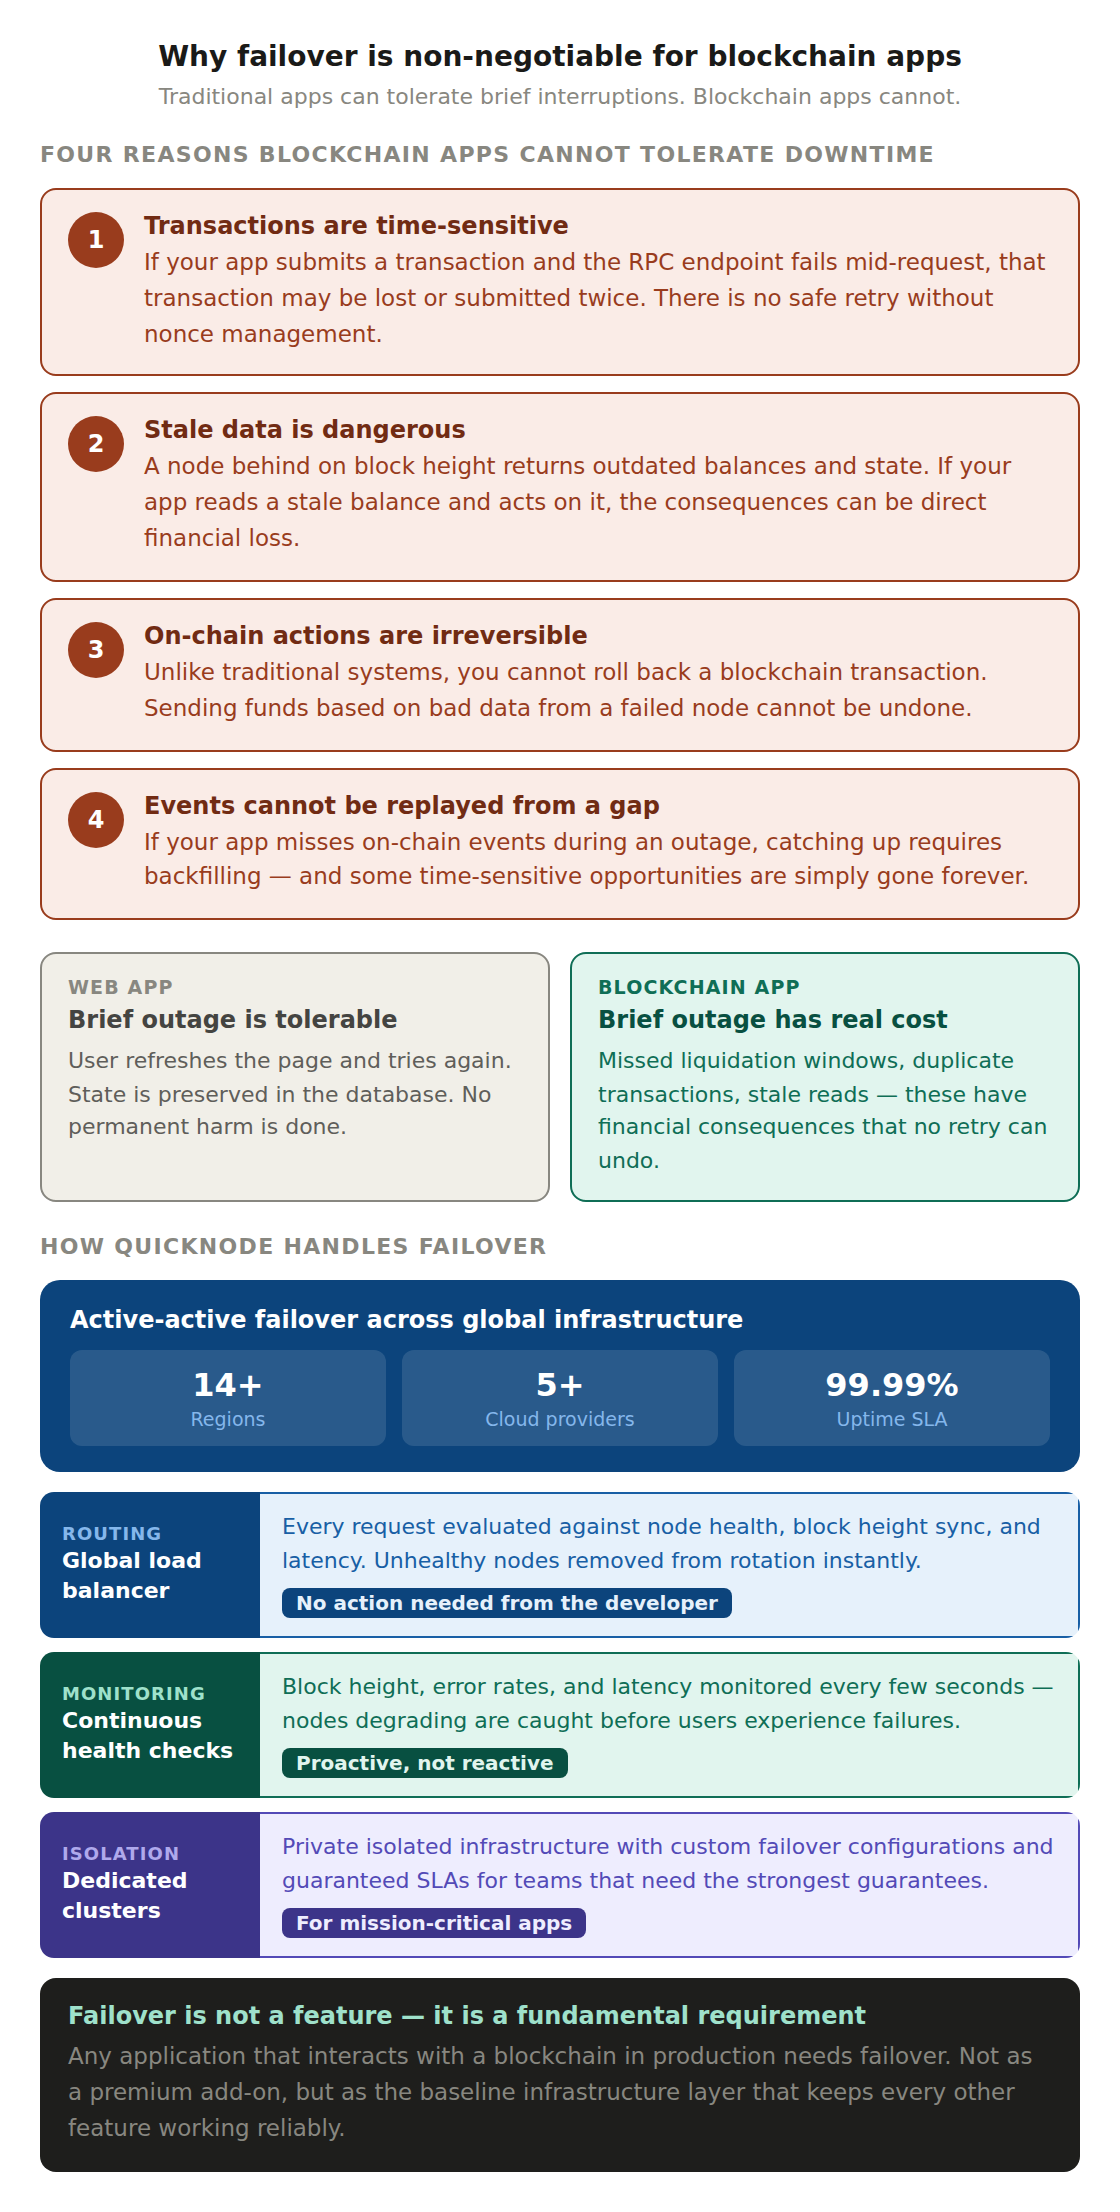
Les applications web traditionnelles peuvent souvent supporter de brèves interruptions. Il suffit à l'utilisateur d'actualiser la page pour que tout fonctionne à nouveau. Les applications blockchain ne disposent pas de ce luxe, et ce pour plusieurs raisons.
Les transactions sont sensibles au temps. Si votre application envoie une transaction et que l'endpoint RPC échoue en cours de requête, cette transaction peut être perdue ou envoyée deux fois. Les données obsolètes sont dangereuses. Un nœud en retard sur la hauteur du bloc renvoie des informations obsolètes. Si votre application lit un solde obsolète et agit en conséquence, cela peut avoir des conséquences financières. Les événements sont irréversibles. Contrairement aux systèmes traditionnels où il est possible de réessayer ou de revenir en arrière, les actions sur la chaîne sont définitives. L'envoi de fonds sur la base de données erronées provenant d'un nœud défaillant ne peut pas être annulé.
C'est pourquoi le basculement n'est pas une fonctionnalité accessoire. Il s'agit d'une exigence fondamentale pour toute application qui interagit avec une blockchain en production.
Comment « Quicknode » gère le basculement
QuicknodeL'infrastructure de [nom] utilise un basculement actif-actif réparti sur plus de 14 régions et plusieurs fournisseurs de cloud. Chaque requête est acheminée via une couche mondiale d'équilibrage de charge qui évalue en permanence l'état de santé des nœuds, notamment le statut de synchronisation de la hauteur des blocs, la latence de réponse et les taux d'erreur. Si un nœud ou une région subit une dégradation, le trafic est automatiquement redirigé vers la meilleure option disponible sans que le développeur n'ait à intervenir.
Pour les équipes qui ont besoin des garanties les plus solides, les services « clusters » dédiés offrent une infrastructure isolée avec des configurations de basculement personnalisées et des accords de niveau de service (SLA) garantissant la disponibilité.
Quelle est la différence entre le basculement et l'équilibrage de charge ?
Le basculement et l'équilibrage de charge sont étroitement liés, mais répondent à des besoins différents. L'équilibrage de charge répartit les requêtes entrantes entre un ensemble de nœuds opérationnels, afin qu'aucun nœud ne soit surchargé. Le basculement intervient lorsqu'un de ces nœuds cesse d'être opérationnel : le trafic est alors détourné du nœud défaillant et redistribué vers les autres. Dans la pratique, ces deux mécanismes fonctionnent de concert, et une infrastructure hautement disponible et robuste nécessite leur fonctionnement conjoint.
Capacité
Équilibrage de charge
Basculement
Emploi principal
Répartir le trafic de manière homogène
Rediriger le trafic pour contourner les pannes
Quand il agit
En continu, à chaque requête
Uniquement lorsqu'un composant se détériore ou tombe en panne
Objectif principal
Performances et uniformité d'utilisation
Continuité et disponibilité
Déclencheur
Volume des demandes
Échec du contrôle de santé
Qu'est-ce qui est considéré comme un point de défaillance unique ?
Un point de défaillance unique est tout composant dont la panne entraîne la mise hors service de l'ensemble du système. Un nœud isolé, une région cloud unique ou une implémentation client peuvent chacun constituer un point de défaillance unique. Le basculement élimine ces maillons faibles en veillant à ce qu'une alternative opérationnelle soit toujours prête à prendre le relais. Passer en revue les modes de défaillance courants des blockchains est le moyen le plus rapide de repérer les points de défaillance uniques qui se cachent dans votre pile.
Comment vérifie-t-on si le basculement fonctionne correctement ?
La bascule de secours se mesure à l'aide de quelques indicateurs concrets. Le temps de disponibilité indique la fréquence à laquelle le service était accessible, le temps de reprise indique le temps nécessaire au basculement du trafic après une panne, et le taux d'erreur pendant un incident indique le nombre de requêtes affectées avant la fin du basculement. C'est la surveillance continue de votre infrastructure blockchain qui permet de mettre en évidence ces chiffres, afin que vous puissiez vous assurer que la bascule de secours fonctionne correctement.
Comment tester le basculement avant une véritable panne ?
La seule façon de s'assurer du bon fonctionnement du basculement est de le tester. Les équipes mettent délibérément un nœud ou une région hors ligne pendant une période contrôlée et vérifient que le trafic est redirigé sans erreur, une approche souvent appelée « tests de chaos ». Si vous gérez vos propres nœuds, vous pouvez arrêter un processus et observer où sont acheminées les requêtes. Si vous faites appel à un fournisseur de services gérés tel quel'API Core d' Quicknode , le basculement est géré pour vous, mais vous pouvez tout de même le valider à l'aide de tests de charge interrégionaux.
Foire aux questions
Qu'est-ce que le basculement, en termes simples ?
Le basculement consiste à passer automatiquement d'un composant défaillant à une solution de secours opérationnelle afin d'assurer la continuité du service. La plupart du temps, l'utilisateur ne se rend même pas compte que ce basculement a eu lieu.
Le basculement est-il la même chose que la redondance ?
Non. La redondance consiste à disposer de composants de secours prêts à l'emploi, tandis que le basculement est le processus qui redirige le trafic vers ces composants de secours en cas de défaillance. Il faut disposer d'une infrastructure redondante pour que le basculement puisse fonctionner.
Combien de temps dure le basculement ?
Avec les systèmes « actif-actif », le basculement est souvent instantané near , car les serveurs de secours traitent déjà le trafic. Avec les systèmes « actif-passif », cela peut prendre de quelques secondes à plusieurs minutes, le temps que le serveur de secours se mette en route et se synchronise.
Le basculement permet-il d'éviter toute interruption de service ?
Le basculement réduit considérablement les temps d'arrêt, mais ne peut garantir une interruption nulle dans toutes les situations. Une infrastructure active-active bien conçue, répartie sur plusieurs régions, s'en approche toutefois de très près, ce qui explique pourquoi elle constitue la norme pour les applications blockchain en production.
Pourquoi le basculement est-il si important pour les applications blockchain ?
Les opérations sur la blockchain sont sensibles au facteur temps et souvent irréversibles ; ainsi, une défaillance de l'endpoint peut entraîner l'abandon d'une transaction ou renvoyer des données obsolètes. Le basculement automatique garantit à la fois la fiabilité du système et la sécurité des fonds des utilisateurs, ce qui est essentiel pour les services reposant sur des données en temps réel streams.