En bref : La surveillance de l’infrastructure blockchain consiste à suivre en permanence l’état de santé, les performances et la précision des nœuds, des points de terminaison RPC et des pipelines de données dont dépend votre application. Contrairement à la surveillance d’un serveur web traditionnel, la surveillance blockchain doit tenir compte de comportements spécifiques à la chaîne, tels que les taux de production de blocs, l’état de synchronisation, les points de contrôle de finalité, la congestion du mempool et la dynamique des prix du gaz. Les indicateurs clés à suivre sont la hauteur du bloc (votre nœud est-il à jour ?), la latence RPC (les requêtes sont-elles rapides ?), les taux d’erreur (les requêtes aboutissent-elles ?) et l’actualité des données (votre application dispose-t-elle de l’état le plus récent ?). Une surveillance efficace combine des alertes automatisées pour les problèmes immédiats et des tableaux de bord permettant l’analyse des tendances et la planification des capacités.
L'explication simple
Si votre application repose sur une blockchain, son bon fonctionnement dépend entièrement de l'endpoint qui la relie à cette blockchain. Un contrat intelligent parfaitement écrit et une interface utilisateur superbement conçue ne servent à rien si l' RPC qui fournit vos données tombe en panne, prend du retard ou commence à renvoyer des erreurs. La surveillance vous permet de détecter les dysfonctionnements avant même que vos utilisateurs ne s'en aperçoivent.
La surveillance traditionnelle des applications web se concentre sur le processeur, la mémoire, le disque et le réseau du serveur. La surveillance de l’infrastructure blockchain inclut tous ces éléments, ainsi qu’un ensemble de métriques spécifiques à la chaîne qui n’existent pas dans les systèmes conventionnels. Le nœud est-il synchronisé avec le dernier bloc ? Se trouve-t-il sur la chaîne canonique ou est-il bloqué sur une bifurcation ? Les réponses RPC renvoient-elles des données provenant de la bonne hauteur de bloc ? Le mempool est-il suffisamment encombré pour affecter les délais de confirmation des transactions ? Ce sont ces signaux spécifiques à la blockchain qui distinguent une configuration de surveillance robuste d’une configuration qui passe à côté de modes de défaillance critiques.
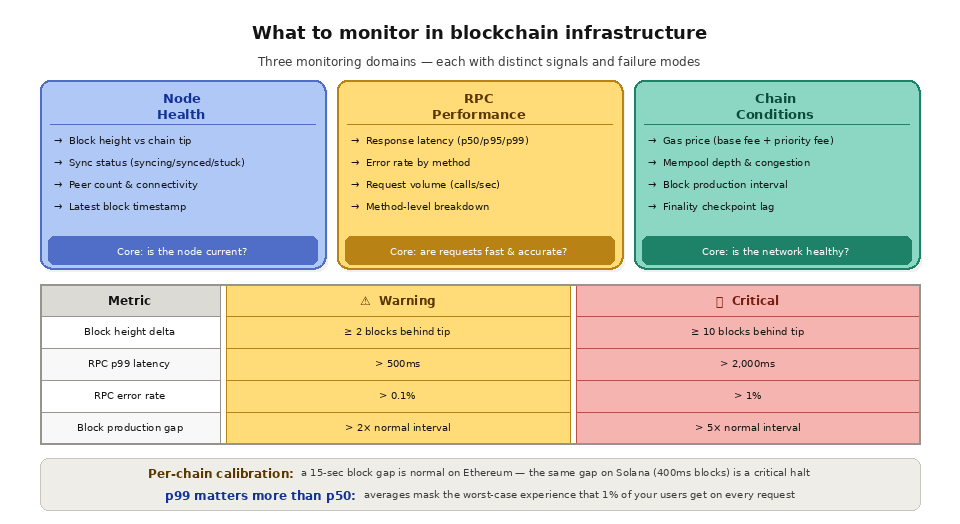
Éléments à surveiller
État du nœud
La métrique la plus fondamentale est la hauteur de bloc : quel est le dernier bloc traité par votre nœud, et où se situe-t-il par rapport à la pointe réelle de la chaîne ? Un nœud qui prend du retard par rapport à la pointe (même de quelques blocs seulement) fournit des données obsolètes. Votre application risque alors d’afficher des soldes périmés, de ne pas prendre en compte les transactions récentes ou de ne pas détecter les événements confirmés. Sur des chaînes rapides comme Solana (temps de bloc de 400 ms), même un léger retard de synchronisation signifie que votre application accuse un retard de plusieurs blocs par rapport à la réalité.
Surveillez l'écart entre la hauteur du bloc de votre nœud et la pointe de la chaîne. Un nœud en bon état de fonctionnement doit se situer à tout moment à une distance comprise entre 0 et 1 bloc de la pointe. Un écart de 2 blocs ou plus constitue un signal d'alerte. Un écart de 10 blocs ou plus signifie que votre nœud présente un problème de synchronisation qui nécessite une analyse immédiate.
L'état de synchronisation indique si votre nœud est en cours de synchronisation, entièrement synchronisé ou bloqué. Un nœud qui est en cours de « synchronisation » mais qui progresse régulièrement est en bon état de fonctionnement. Un nœud qui indique « en cours de synchronisation » mais dont la hauteur de bloc n'a pas évolué depuis plusieurs minutes est bloqué et nécessite une intervention.
Le nombre de pairs indique à combien d'autres nœuds votre nœud est connecté. Un nœud en bon état maintient des connexions avec plusieurs pairs afin d'assurer la propagation des données et de participer au consensus. Une baisse du nombre de pairs peut indiquer des problèmes de connectivité réseau ou des problèmes de configuration.
Performances RPC
La latence de réponse correspond au délai entre l'envoi d'une requête RPC et la réception de la réponse. Suivez cet indicateur sous forme de centiles (p50, p95, p99) plutôt que de moyennes, car les moyennes masquent les performances les plus médiocres rencontrées par vos utilisateurs. Une latence p50 de 50 ms avec un p99 de 2 000 ms signifie que la plupart des requêtes sont rapides, mais qu’une sur 100 prend 2 secondes complètes. Ce sont ces requêtes lentes qui frustrent les utilisateurs.
Le taux d'erreur correspond au pourcentage de requêtes RPC qui renvoient des erreurs (codes d'état HTTP autres que 200, réponses d'erreur JSON-RPC ou délais d'attente dépassés). Une interface endpoint en bon état de fonctionnement devrait présenter un taux d'erreur inférieur à 0,1 %. Les taux supérieurs à 1 % indiquent un problème nécessitant une analyse immédiate. Les types d'erreurs courants incluent les codes 429 (limitation de débit), 502/503 (nœud indisponible) et les erreurs JSON-RPC telles que « nœud trie manquant » (données d'archive indisponibles) ou « nonce trop faible » (conflit lors de la soumission d'une transaction).
La ventilation par méthode classe les indicateurs en fonction de la méthode RPC (eth_call, eth_getBalance, eth_sendRawTransaction, etc.), car chaque méthode présente des profils de performance et des modes de défaillance qui lui sont propres. Un pic de latence au niveau de la méthode eth_getLogs peut indiquer qu’un nœud rencontre des difficultés avec le filtrage des journaux, tandis qu’un pic d’erreurs au niveau de la méthode eth_sendRawTransaction peut signaler une congestion du mempool.
Conditions relatives à la chaîne
Le suivi du prix du gaz est essentiel pour toute application qui effectue des transactions. Surveiller l'évolution des frais de base et des frais de priorité permet à votre application d'estimer des prix de gaz adaptés, d'éviter de payer trop cher pendant les périodes creuses et d'alerter les utilisateurs lorsque la congestion du réseau rendra les transactions coûteuses.
La profondeur du mempool indique le nombre de transactions en attente d'intégration. Une augmentation de la profondeur du mempool est le signe d'une congestion croissante, ce qui se traduit par des frais plus élevés et des délais de confirmation plus longs. Les applications qui ont besoin d'une confirmation prévisible des transactions doivent surveiller la profondeur du mempool et adapter leur comportement en conséquence.
La fréquence de production des blocs varie selon les chaînes et peut fluctuer en cas de problèmes sur le réseau. La surveillance des intervalles de production des blocs permet de détecter les ralentissements ou les blocages de la chaîne avant qu'ils n'affectent le fonctionnement de votre application.
Configuration de la surveillance
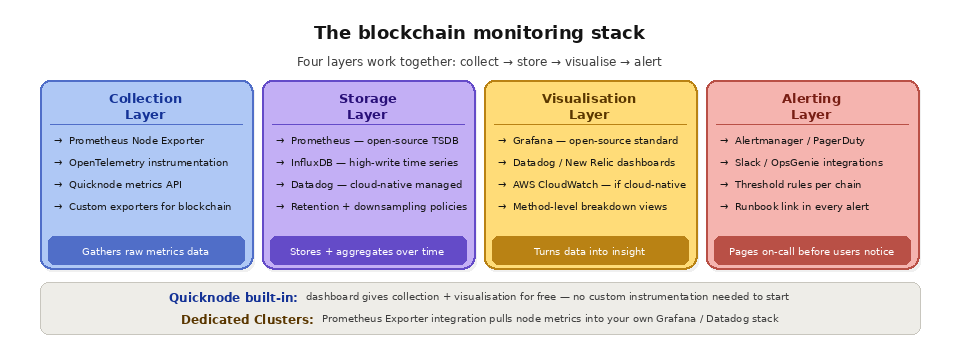
Une pile standard de surveillance d'infrastructure blockchain se compose d'une couche de collecte, d'une couche de stockage, d'une couche de visualisation et d'une couche d'alerte.
La couche de collecte rassemble les métriques provenant de votre infrastructure. Pour les nœuds auto-hébergés, des outils tels que Prometheus Node Exporter et des exportateurs de métriques personnalisés collectent les métriques système et celles spécifiques à la blockchain. Pour les points de terminaison gérés, la plupart des fournisseurs proposent un accès aux métriques via une API ou des webhooks. Les métriques au niveau de l'application peuvent être collectées à l'aide d'OpenTelemetry, de StatsD ou de SDK spécifiques aux fournisseurs.
La couche de stockage est une base de données de séries chronologiques optimisée pour les données de métriques. Prometheus, InfluxDB et Datadog constituent les choix les plus courants. Les bases de données de séries chronologiques sont conçues pour répondre aux caractéristiques des données de métriques, qui se traduisent par un volume d'écriture élevé et un ordre chronologique, et intègrent des fonctionnalités de prise en charge de l'agrégation, du sous-échantillonnage et des politiques de conservation.
La couche de visualisation transforme les métriques brutes en tableaux de bord exploitables. Grafana est la référence du secteur en matière de visualisation open source pour la surveillance, avec une prise en charge native de Prometheus, InfluxDB et de dizaines d’autres sources de données. Datadog, New Relic et AWS CloudWatch proposent des fonctionnalités de visualisation intégrées dans le cadre de leurs plateformes de surveillance.
La couche d'alerte évalue les indicateurs par rapport à des seuils et avertit les personnes concernées lorsqu'un problème nécessite une intervention. Pour être efficaces, les alertes doivent être exploitables (chaque alerte doit correspondre à un guide d'intervention), bien paramétrées (ni trop sensibles au point de se déclencher sans cesse, ni trop laxistes au point de passer à côté de véritables problèmes), acheminées (envoyées à la personne de garde via PagerDuty, Slack ou un outil similaire) et contextuelles (contenant suffisamment d'informations pour commencer à diagnostiquer le problème sans avoir à ouvrir un tableau de bord).
Défis liés à la surveillance spécifique à la blockchain
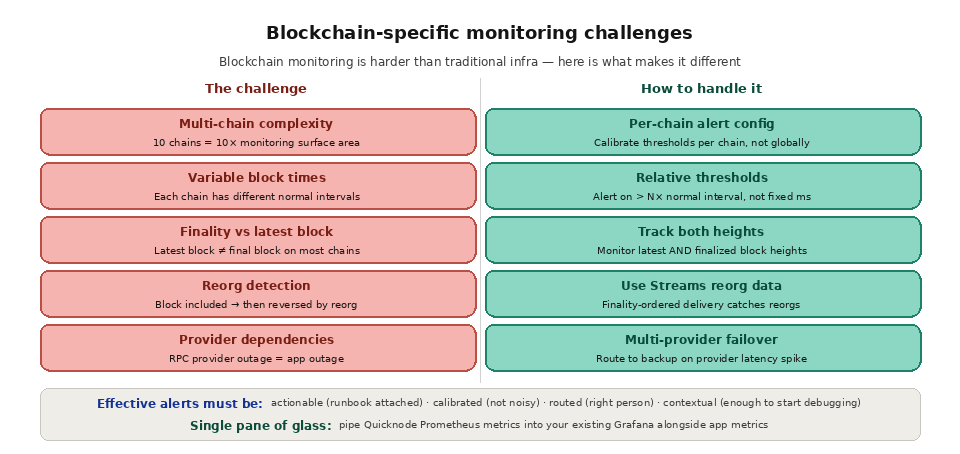
Les environnements multi-chaînes multiplient la complexité de la surveillance. Si votre application prend en charge 10 chaînes, vous devez surveiller l'état de santé des nœuds, les performances RPC et les conditions de chaque chaîne. Chaque chaîne présente des temps de blocage, des modèles de finalité et des modes de défaillance différents. Une configuration de surveillance qui fonctionne parfaitement pour Ethereum peut passer à côté de signaux critiques sur Solana, et inversement.
La variabilité de la durée des blocs complique la définition de seuils d'alerte fixes. Un intervalle de 15 secondes entre deux blocs « Ethereum » est normal. En revanche, un intervalle de 15 secondes sur « Solana » (où les blocs devraient se succéder toutes les 400 ms) constitue un problème grave. Les alertes doivent être calibrées pour chaque chaîne, et non définies de manière universelle.
La prise en compte de la finalité est importante pour la surveillance des pipelines de données. La surveillance ne doit pas se limiter au dernier bloc détecté par votre nœud, mais doit également prendre en compte le dernier bloc finalisé. Les données issues de blocs n’ayant pas encore atteint la finalité peuvent être annulées par une réorganisation ; par conséquent, les applications qui s’appuient sur des données finalisées nécessitent une surveillance permettant de distinguer la hauteur du dernier bloc de celle du bloc finalisé.
Quels sont les indicateurs de surveillance de la blockchain les plus importants à suivre ?
Quelques indicateurs à forte sensibilité permettent de détecter la plupart des problèmes liés à l'infrastructure blockchain. Le tableau ci-dessous résume les informations fournies par chacun d'entre eux, la plage de valeurs indiquant un fonctionnement normal, ainsi que le seuil à partir duquel vous devez contacter un ingénieur de garde.
Système métrique | Ce qu'il mesure | Fourchette normale | Quand donner l'alerte |
|---|---|---|---|
Différentiel de hauteur de bloc | Distance par rapport à l'extrémité de la chaîne | Entre 0 et 1 pâté de maisons | 10 pâtés de maisons ou plus derrière |
Latence RPC (p99) | Les 1 % de réponses les plus lentes | Moins de 500 ms | Plus de 2 secondes |
Suivez ces données sous forme de séries chronologiques plutôt que de mesures ponctuelles afin de pouvoir repérer les tendances avant qu'elles ne se traduisent par des pannes. La latence, en particulier, doit être mesurée en centiles : découvrez-en davantage sur les facteurs qui influencent la latence RPC et sur la manière dont elle s'inscrit dans le cadre plus large de l'observabilité de la blockchain.
En quoi la surveillance de la blockchain diffère-t-elle de la surveillance traditionnelle des infrastructures ?
La surveillance standard des serveurs vous indique si une machine est opérationnelle, mais un nœud de blockchain peut passer tous les contrôles d'infrastructure tout en diffusant discrètement des données obsolètes ou réorganisées. La surveillance de la blockchain ajoute des signaux spécifiques à la chaîne aux métriques habituelles de l'hôte.
Aspect | Surveillance traditionnelle des infrastructures | Surveillance de l'infrastructure blockchain |
|---|---|---|
Signal de santé primaire | Processeur, mémoire, disque dur, réseau | Hauteur du bloc, état de synchronisation, finalité |
Panne courante mode | Serveur hors service ou surchargé | Le nœud est en ligne mais fournit des données obsolètes ou réorganisées |
Risque lié à l'exactitude | Faible dès que le serveur répond | Les données valides peuvent être annulées par une réorganisation |
La principale différence réside dans la validité au fil du temps. Une réponse peut être exacte au moment où elle est renvoyée, puis devenir invalide quelques secondes plus tard ; c’est pourquoi la surveillance doit faire la distinction entre le dernier bloc et le bloc finalisé. Pour comprendre pourquoi cette distinction est importante pour les pipelines de données, consultez la section « Finalité de la blockchain ».
Est-il possible de surveiller l'infrastructure blockchain sans exploiter son propre nœud ?
Oui. Les fournisseurs de RPC gérés mettent à disposition des tableaux de bord et des indicateurs relatifs au volume de requêtes, à la latence et aux taux d’erreur, sans que vous ayez à mettre en place aucune instrumentation de votre côté, ce qui élimine la majeure partie de la charge opérationnelle liée à la surveillance auto-hébergée. C’est souvent le moyen le plus rapide d’atteindre une haute disponibilité, puisque le fournisseur gère pour vous l’état de santé des nœuds, la mise à l’échelle et la redondance. L’API Core de Quicknode intègre d’emblée des analyses parendpoint , ce qui vous permet d’avoir une visibilité sur votre infrastructure dès la première requête.
Comment assure-t-on la surveillance d'une infrastructure blockchain multi-chaînes ?
La surveillance multi-chaînes implique de calibrer les seuils pour chaque chaîne, car un retard considéré comme normal sur Ethereum peut constituer un incident grave sur une chaîne dont le temps de transaction est inférieur à une seconde. Centralisez les métriques de chaque chaîne dans un tableau de bord unique et configurez des alertes en fonction des valeurs de référence propres à chaque chaîne. Pour les pipelines de données, Quicknode Streams les rapports indiquent le taux de réussite de la transmission et la latence de traitement par chaîne, ce qui vous permet de savoir immédiatement dès qu’un réseau prend du retard.
Foire aux questions
À quelle fréquence faut-il surveiller l'infrastructure blockchain ?
En continu. Collectez la hauteur des blocs et la latence toutes les quelques secondes, puis évaluez les règles d’alerte en temps réel near . Les chaînes rapides génèrent plusieurs blocs par seconde ; ainsi, un intervalle d’interrogation d’une minute peut masquer un nœud qui a déjà pris un retard considérable. Associez des intervalles de collecte courts aux trois piliers que sont les métriques, les journaux et les traces pour une couverture complète.
Quel est un bon taux d'erreur RPC ?
Un « endpoint » sain affiche un taux d'erreurs inférieur à 0,1 %. Tout taux supérieur à 1 % indique un véritable problème, tel qu'une limitation de débit, un nœud indisponible ou des données d'archive manquantes. Veillez à toujours ventiler les erreurs par méthode afin de pouvoir identifier les appels qui échouent et en comprendre les causes.
Quelle est la différence entre la surveillance des blocs « les plus récents » et celle des blocs « finalisés » ?
Le dernier bloc est le plus récent que votre nœud ait vu, tandis que le bloc finalisé a atteint un stade où il ne pourra plus être annulé. Les applications qui s'appuient sur des données validées doivent être alertées lorsque la hauteur du bloc est finalisée, car les données issues de blocs non finalisés peuvent disparaître lors d'une réorganisation.
Comment surveillez-vous les temps d'indisponibilité des nœuds de la blockchain ?
Suivez simultanément la variation de hauteur des blocs de piste, le nombre de nœuds homologues et le taux d'erreur, puis transmettez les alertes vers un canal de permanence. En associant la surveillance à des pratiques rigoureuses en matière de fiabilité des nœuds et à un basculement automatique, le trafic continue d'être acheminé vers un nœud opérationnel dès qu'un autre présente une dégradation.
Quels outils sont utilisés pour surveiller l'infrastructure blockchain ?
La pile open source couramment utilisée comprend Prometheus pour la collecte et le stockage des données, Grafana pour les tableaux de bord et Alertmanager pour le routage. Les fournisseurs de services gérés proposent des fonctionnalités d'analyse intégrées, tandis que les instances dédiées Clusters permettent d'exporter des métriques au niveau des nœuds directement vers une installation Prometheus ou Datadog existante.
Comment « Quicknode » assure la surveillance
Quicknode intègre des fonctionnalités de surveillance et d'analyse pour chaque endpoint. Le tableau de bord Quicknode affiche des indicateurs en temps réel et historiques, notamment le volume de requêtes, la latence de réponse, les taux d'erreur et des ventilations par méthode. Ces indicateurs sont disponibles sans aucune instrumentation personnalisée, offrant ainsi aux développeurs une visibilité immédiate sur l'état de santé de leur infrastructure blockchain.
Pour les équipes disposant déjà d’une infrastructure de surveillance, les services « Dedicated Clusters » d’ Quicknode prennent en charge l’intégration de Prometheus Exporter. Cela vous permet d’importer directement des métriques au niveau des nœuds et de l’ endpoint dans votre instance Prometheus, vos tableaux de bord Grafana ou Datadog, offrant ainsi une surveillance unifiée de votre pile applicative et de votre infrastructure blockchain au sein d’une seule et même plateforme. Les services « Dedicated Clusters » incluent également une conservation des journaux pendant 14 jours pour une analyse détaillée au niveau des requêtes.
Quicknode Streams assure la surveillance de l'état des pipelines de données, notamment les taux de réussite des transmissions, la latence de traitement et les journaux d'erreurs. Pour les équipes qui exploitent des pipelines de données multi-chaînes, la surveillance « Streams » vous permet de savoir quand un pipeline prend du retard ou rencontre des problèmes de transmission, avant que les données manquantes n'aient un impact sur votre application.
Pour en savoir plus
Métriques, journaux et traces - Documentation d'Quicknode
Surveillance de l'infrastructure blockchain - Quicknode Glossaire
Quicknode API Core
Quicknode Dédié Clusters
