Réponses>En savoir plus sur la surveillance et l'observabilité>Bonnes pratiques en matière d'alertes
Bonnes pratiques en matière d'alerte
// Tags
bonnes pratiques en matière d'alerteastreinte
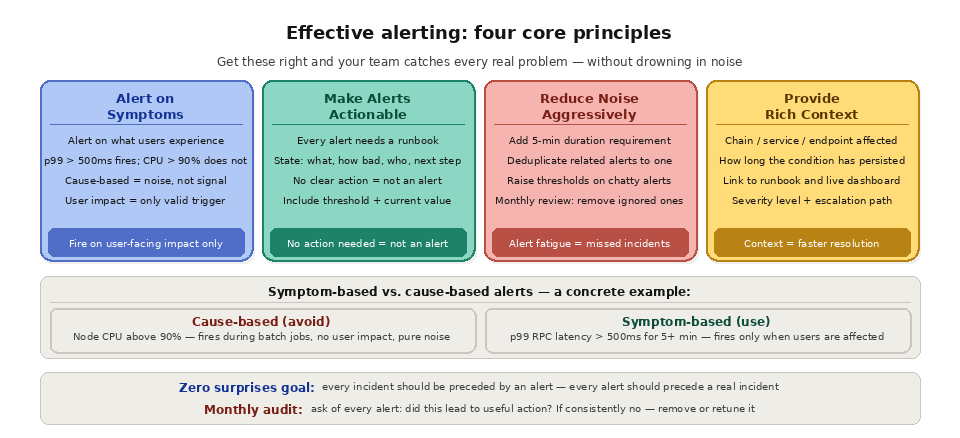
En bref : un système d'alerte efficace informe les bonnes personnes des problèmes réels au bon moment, en leur fournissant suffisamment de contexte pour qu'elles puissent agir immédiatement. Les principes les plus importants sont les suivants : alerter sur les symptômes (impact perçu par l’utilisateur) plutôt que sur les causes (indicateurs internes), s’assurer que chaque alerte donne lieu à une action (s’il n’y a rien à faire, ce n’est pas une alerte), réduire radicalement le bruit (la fatigue liée aux alertes fait passer à la trappe les véritables incidents) et fournir du contexte (quel est le problème, quelle est sa gravité, qui est concerné et que faut-il faire pour y remédier). Pour les applications blockchain, les alertes doivent également couvrir des conditions spécifiques à la chaîne, telles que le décalage de synchronisation des nœuds, les pics de prix du gaz, les retards de confirmation des transactions et les réorganisations de blocs.
L'explication simple
Les alertes constituent le lien entre les données de surveillance et l'intervention humaine. Les systèmes de surveillance collectent des milliers de métriques et des millions d'entrées de journal. Les alertes permettent de déterminer lesquels de ces signaux justifient de réveiller quelqu'un à 3 heures du matin. Si elles sont bien gérées, votre « equipe » détecte les problèmes avant même que les utilisateurs ne s'en aperçoivent. Si elles sont mal gérées, soit les incidents réels se perdent dans un flot de bruit (trop d'alertes), soit les problèmes critiques passent inaperçus jusqu'à ce que les utilisateurs se plaignent (trop peu d'alertes).
L'objectif d'un système d'alerte bien réglé est d'éviter toute surprise : chaque incident en production doit être précédé d'une alerte, et chaque alerte doit précéder un incident réel (ou imminent). Les alertes qui se déclenchent sans qu'il y ait de problème correspondant incitent votre équipe d'equipe à les ignorer. Les problèmes qui surviennent sans alerte préalable indiquent que votre système de surveillance présente une lacune.
Quelle est la différence entre la surveillance et les alertes ?
La surveillance et les alertes sont deux concepts liés mais distincts. La surveillance consiste à collecter en continu des métriques, des journaux et des traces qui décrivent l'état de santé de votre système. Les alertes constituent la couche supérieure qui détermine lesquels de ces signaux méritent une intervention humaine et les achemine vers la personne compétente. Il est possible d'assurer la surveillance sans déclencher d'alertes, mais il est impossible de mettre en place un système d'alertes efficace sans une surveillance de qualité en amont. Pour en savoir plus sur l'aspect « données » de ce sujet, consultez
Se concentrer sur les symptômes, et non sur les causes
Le principe le plus important en matière d'alertes est de se baser sur les symptômes (ce que ressentent les utilisateurs) plutôt que sur les causes (ce qui se passe en interne). Une alerte basée sur les symptômes se déclenche lorsqu'un dysfonctionnement est constaté du point de vue de l'utilisateur. Une alerte basée sur les causes se déclenche lorsqu'un indicateur interne dépasse un seuil, que les utilisateurs soient affectés ou non.
Une alerte basée sur une cause, telle que « Utilisation du processeur du nœud supérieure à 90 % », peut se déclencher lors d’un traitement par lots normal qui sollicite fortement le processeur, mais qui n’altère pas l’expérience utilisateur. Cette alerte génère du bruit et sape la confiance dans le système d’alerte. Une alerte basée sur un symptôme, telle que « Temps de réponse RPC p99 supérieur à 500 ms pendant plus de 5 minutes », ne se déclenche que lorsque les utilisateurs constatent effectivement des réponses lentes, que la cause soit une utilisation élevée du processeur, un problème de synchronisation ou une congestion du réseau.
Cela ne signifie pas pour autant que vous ne deviez jamais surveiller les indicateurs internes. Ces derniers sont utiles pour les tableaux de bord, l'analyse des tendances et les enquêtes menées après un incident. Cependant, ils ne doivent pas déclencher d'alertes, sauf s'ils sont directement liés à un impact sur les utilisateurs. Réservez les alertes aux signaux indiquant qu'un dysfonctionnement est survenu ou est sur le point de se produire pour les utilisateurs réels.
Quelle est la différence entre les alertes basées sur les symptômes et celles basées sur les causes ?
Les alertes basées sur les symptômes se déclenchent en fonction de ce que les utilisateurs constatent, tandis que les alertes basées sur les causes se déclenchent en fonction d'indicateurs internes qui peuvent ou non avoir un impact sur les utilisateurs. Le tableau ci-dessous met en parallèle ces deux types d'alertes afin que vous puissiez déterminer quelles alertes doivent déclencher une notification et lesquelles doivent rester affichées sur un tableau de bord.
Aspect
Alerte basée sur les symptômes
Alerte liée à une cause
Déclencheurs activés
Impact sur les utilisateurs
Seuil métrique interne
Exemple
p99 : latence RPC supérieure à 500 ms pendant 5 minutes
Utilisation du processeur du nœud supérieure à 90 %
Risque de faux positifs
Faible
Élevé
À utiliser de préférence comme
Des pages qui réveillent les esprits
Tableau de bord et contexte de l'enquête
Rendre les alertes exploitables
Chaque alerte doit faire l'objet d'une réponse claire et documentée. Si une alerte se déclenche et que la première réaction de l'ingénieur de garde est « Que suis-je censé faire dans ce cas ? », cela signifie que l'alerte n'est pas exploitable.
Chaque alerte doit inclure la nature du problème (une description claire du symptôme), le contexte quantitatif (le seuil dépassé et la valeur actuelle), la portée (le endpoint, la chaîne ou le service concerné), la durée (depuis combien de temps la situation persiste) et un lien vers un guide d'intervention (instructions étape par étape pour diagnostiquer et résoudre le problème).
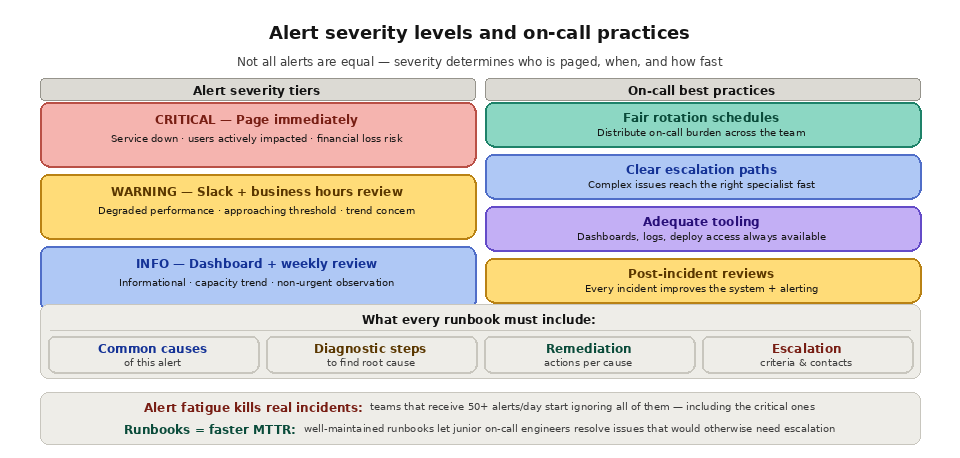
Les guides d'intervention constituent une documentation indispensable pour chaque alerte. Un guide d'intervention doit guider l'intervenant à travers les causes courantes de l'alerte, les étapes de diagnostic permettant d'identifier la cause première, les mesures correctives à prendre pour chaque cause courante, ainsi que les critères d'escalade (quand faire appel à une autre personne). Des guides d'intervention bien tenus réduisent considérablement le temps de réponse aux incidents et permettent aux membres moins expérimentés de l'équipe « equipe » d'assurer efficacement leurs permanences.
Réduire le bruit des alertes
La « fatigue des alertes » constitue la principale menace pour l'efficacité d'un système d'alerte. Lorsque les équipes reçoivent des dizaines d'alertes par jour, dont la plupart sont des faux positifs ou des alertes de faible priorité, elles finissent par ignorer toutes les alertes, y compris celles qui sont critiques.
Des études menées dans le secteur de la santé (où la « fatigue liée aux alarmes » est reconnue comme un problème de sécurité des patients) montrent que jusqu’à 99 % des alarmes peuvent être des faux positifs, ce qui conduit les soignants à les désactiver ou à les ignorer.
Les stratégies visant à réduire le « bruit » consistent notamment à relever les seuils des alertes qui se déclenchent fréquemment et ne nécessitent aucune action, à ajouter des critères de durée (ne déclencher une alerte que si la condition persiste pendant au moins 5 minutes, plutôt que lors d’un pic momentané), à dédupliquer les alertes liées (si cinq terminaux chez le même fournisseur sont tous lents, envoyer une seule alerte, et non cinq), à mettre en place des niveaux de gravité (les alertes critiques doivent être transmises immédiatement ; les alertes d’avertissement sont redirigées vers un canal Slack pour être examinées pendant les heures de bureau), ainsi que de passer régulièrement en revue et de supprimer les alertes qui sont systématiquement ignorées ou résolues sans intervention. Un exercice utile consiste à passer en revue chaque alerte déclenchée au cours du mois écoulé et à se demander : « Cette alerte a-t-elle donné lieu à une action utile ? » Si la réponse est systématiquement « non », supprimez-la ou réajustez-la.
Alertes spécifiques à la blockchain
Les applications blockchain ont besoin d'alertes couvrant les conditions au niveau de la chaîne, en plus des alertes standard relatives aux applications et à l'infrastructure.
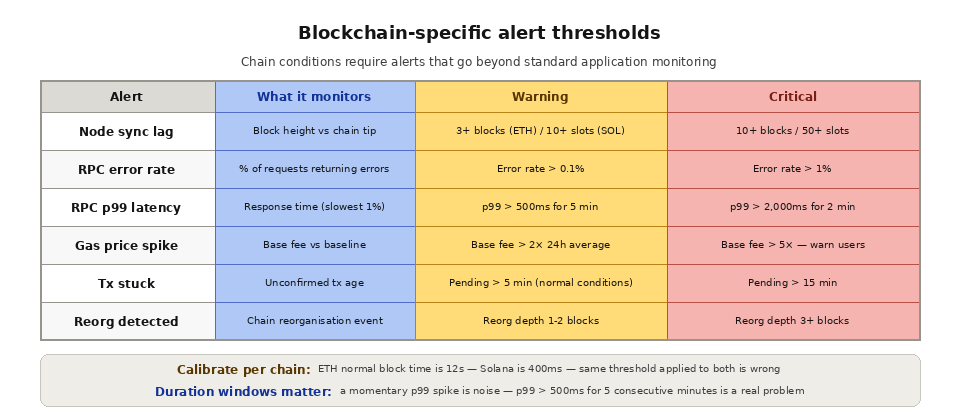
Le retard de synchronisation d'un nœud doit déclencher une alerte lorsque votre nœud (ou celui de votre fournisseur) accuse un retard supérieur à un nombre configurable de blocs par rapport à la pointe de la chaîne. Pour Ethereum, une alerte est déclenchée à partir d'un retard de 3 blocs ou plus. Pour Solana, une alerte est déclenchée à partir d'un retard de 10 slots ou plus. Un retard de synchronisation signifie que votre application fournit des données obsolètes.
Les hausses soudaines du prix du gaz affectent toutes les applications qui effectuent des transactions. Déclenchez une alerte lorsque les frais de base dépassent un seuil au-delà duquel les transactions deviendraient trop coûteuses pour votre cas d'utilisation. Cela permet à votre application d'avertir les utilisateurs, de reporter les transactions non urgentes ou d'ajuster les paramètres de gaz de manière proactive.
Des alertes de transaction bloquée se déclenchent lorsqu'une transaction envoyée n'a pas été confirmée dans le délai prévu. Une transaction en attente depuis plus de 10 minutes sur Ethereum dans des conditions normales présente probablement un prix du gaz insuffisant et doit être renvoyée avec des frais plus élevés.
Les alertes de détection de réorganisation vous informent lorsqu'une réorganisation de blocs se produit sur une chaîne dont dépend votre application. Si votre pipeline de données traite les blocs situés à l'extrémité de la chaîne sans attendre la finalité, une réorganisation signifie que les données récemment traitées peuvent être erronées et doivent être corrigées.
Les alertes de santé des fournisseurs permettent de surveiller l'état général de votre fournisseur RPC. Si les taux d'erreur de votre fournisseur dépassent le seuil que vous avez défini, votre application doit être prête à basculer vers un fournisseur de secours ou à passer en mode de service dégradé mode.
Quelles conditions liées à la blockchain devraient déclencher des alertes ?
Au-delà des alertes d'infrastructure classiques, les applications blockchain nécessitent des alertes adaptées à l'état de la chaîne. Le tableau ci-dessous répertorie les conditions courantes et donne des exemples de seuils. Certaines conditions, telles que les réorganisations, méritent un traitement particulier, que nous abordons dans la section consacrée à la définition d'une réorganisation de blockchain; quant au décalage de synchronisation, il est directement lié à la fiabilité des nœuds.
État
Exemple de seuil
Pourquoi est-ce important ?
Retard de synchronisation des nœuds
3 blocs ou plus (Ethereum) ou 10 emplacements ou plus (Solana)
Vous diffusez des données obsolètes
Flambée des prix de l'essence
Base frais supérieurs à votre plafond économique
Les transactions deviennent trop coûteuses
Transaction bloquée
En attente depuis plus de 10 minutes
Probablement sous-évalué et doit être soumis à nouveau
Réorganisation de la chaîne
Au-delà du nombre de vos confirmations
Les données traitées récemment peuvent être erronées
Taux d'erreur des prestataires
Au-dessus de votre niveau de référence
Il est temps de basculer vers une solution de secours
Bonnes pratiques en matière d'astreinte
Les alertes ne sont efficaces que si quelqu’un y répond rapidement et avec compétence. La mise en place d’un système de permanence efficace passe par des plannings de rotation équitables qui répartissent la charge de travail entre les membres de l’ equipe, des procédures d’escalade claires permettant de transmettre rapidement les problèmes complexes au bon spécialiste, des outils adaptés permettant à l’ingénieur de permanence d’accéder immédiatement aux tableaux de bord, aux journaux et aux outils de déploiement, des analyses post-incident permettant d’apporter des améliorations tant au système qu’à la configuration des alertes, ainsi que des politiques de rémunération ou de compensation en temps libre qui tiennent compte du coût réel de la permanence.
Comment les systèmes d'alerte et la haute disponibilité fonctionnent-ils ensemble ?
Les alertes vous signalent lorsqu'un incident survient, tandis que la haute disponibilité permet au service de continuer à fonctionner pendant que vous intervenez. Ces deux éléments se renforcent mutuellement : les alertes d'état du fournisseur sont particulièrement utiles lorsque vous disposez d'une solution de secours prête à prendre le relais. Associez vos alertes à une architecture de haute disponibilité, à un basculement automatisé et à une infrastructure redondante permettant une intervention rapide.
Comment « Quicknode » permet une gestion efficace des alertes
QuicknodeLes outils d'analyse intégrés fournissent les indicateurs de base nécessaires à la mise en place d'un système d'alertes pour l'infrastructure blockchain. Le volume de requêtes, la latence de réponse, les taux d'erreur et les ventilations par méthode sont disponibles sur le tableau de bord et peuvent être utilisés pour définir des seuils d'alerte. Pour les équipes disposant d'une infrastructure d'alerte personnalisée, l'Clusters dédiée d'Quicknode exporte des indicateurs compatibles avec Prometheus qui s'intègrent directement à Alertmanager, Grafana Alerts, PagerDuty ou à tout autre système d'alerte de votre pile technologique.
Quicknode Streams fournit des indicateurs de santé des livraisons qui permettent de signaler les problèmes liés au pipeline de données : livraisons manquées, retards de traitement et erreurs de destination. Associé au système d'alerte au niveau de la couche RPC, cela offre aux équipes une couverture complète tant pour leur accès en temps réel aux API que pour leur infrastructure de données en flux continu.
Une alerte est exploitable lorsque la personne chargée d'y répondre sait exactement quoi faire. Elle doit indiquer le symptôme, le seuil dépassé et la valeur actuelle, le périmètre concerné, la durée de la situation, ainsi qu'un lien vers un guide d'intervention contenant les étapes de diagnostic et de résolution.
Qu'est-ce que la « fatigue des alertes » ?
On parle de « fatigue aux alertes » lorsqu’un système d’ equipe , submergé par un trop grand nombre d’alertes, notamment de faux positifs, en vient à toutes les ignorer, y compris celles qui sont critiques. Le relèvement des seuils, l’ajout de critères de durée, la déduplication et l’utilisation de niveaux de gravité permettent tous de réduire ce phénomène.
Faut-il mettre en place une alerte concernant l'utilisation du processeur ?
En général, il ne faut pas configurer d'alerte pour cet indicateur. Le CPU est un indicateur basé sur les causes qui présente souvent des pics pendant le fonctionnement normal sans pour autant affecter les utilisateurs. Affichez-le sur un tableau de bord et configurez plutôt des alertes pour les symptômes perceptibles par les utilisateurs, tels qu'une augmentation du taux d'erreurs ou de la latence.
Comment signaler les réorganisations de la blockchain ?
Configurez la détection des réorganisations sur les chaînes dont vous dépendez et activez une alerte lorsqu'une réorganisation dépasse le nombre de confirmations que vous attendez. Si votre pipeline traite les blocs à l'extrémité de la chaîne, une réorganisation signifie que les données récentes doivent être corrigées. Consultez la section « Modes de défaillance courants des blockchains » pour connaître les risques associés.
Quels niveaux de gravité faut-il attribuer aux alertes ?
Un modèle simple et efficace comporte deux niveaux : les alertes critiques déclenchent immédiatement une notification, tandis que les alertes d'avertissement sont acheminées vers un canal destiné à être examiné pendant les heures d'ouverture. Cela permet de réserver les notifications aux problèmes qui nécessitent véritablement une intervention humaine urgente.