Réponses>En savoir plus sur la surveillance et l'observabilité>Qu'est-ce que l'observabilité ?
Qu'est-ce que l'observabilité ?
// Tags
observabilitésurveillance et observabilité
En bref : l’observabilité est la capacité à comprendre ce qui se passe au sein d’un système en examinant ses sorties externes. Dans le cadre d’une infrastructure blockchain, l’observabilité consiste à disposer des métriques, des journaux et des traces nécessaires pour répondre à des questions telles que « pourquoi ma dapp est-elle lente ? », « pourquoi cette transaction a-t-elle échoué ? » et « mon endpoint RPC fonctionne-t-il correctement ? ». Elle va au-delà de la simple surveillance (qui vous indique qu’il y a un problème) en vous fournissant les données permettant de comprendre pourquoi ce problème survient. L’observabilité repose sur trois piliers : les métriques (mesures numériques dans le temps), les journaux (enregistrements d’événements horodatés) et les traces (parcours de requêtes de bout en bout à travers les systèmes distribués).
L'explication simple
La surveillance vous indique que le voyant moteur de votre voiture est allumé. L'observabilité vous précise que ce voyant est allumé parce que la sonde lambda du cylindre 3 signale un mélange pauvre à 2 500 tr/min, un phénomène qui a commencé après le remplacement du filtre à fuel s la semaine dernière, et que ce schéma correspond à un problème connu lié aux filtres du marché secondaire.
En génie logiciel, l’observabilité désigne la pratique consistant à instrumenter vos systèmes de manière si complète que vous puissiez diagnostiquer n’importe quel problème sans avoir à le reproduire ni à ajouter de nouveaux outils d’instrumentation a posteriori. Il n’est pas nécessaire d’anticiper à l’avance toutes les défaillances possibles mode . Il suffit de disposer d’une quantité suffisante de données brutes (métriques, journaux, traces) pour que, lorsqu’un événement inattendu se produit, vous puissiez remonter de la manifestation du symptôme jusqu’à la cause première.
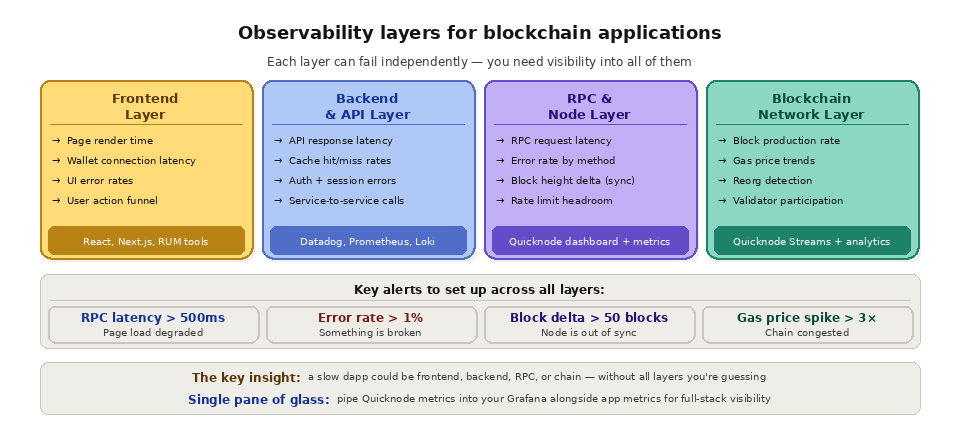
Pour les applications blockchain, l’observabilité revêt une importance cruciale, car les systèmes sont répartis sur plusieurs couches : votre front-end, votre back-end, votre fournisseur RPC, le nœud blockchain, le réseau de consensus et la chaîne elle-même. Si un utilisateur constate une mise à jour lente de son solde, cela peut être dû à un rendu lent du front-end, à un problème de mise en cache du back-end, à une latence de l’ endpoint RPC, à un retard de synchronisation des nœuds ou à une congestion de la chaîne. Sans observabilité à tous les niveaux, le diagnostic de la cause réelle se résume à des conjectures.
Les trois piliers de l'observabilité
Indicateurs
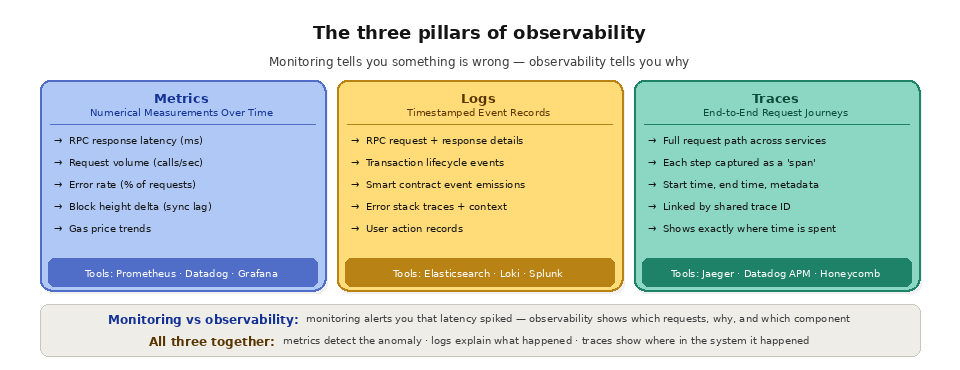
Les indicateurs sont des mesures chiffrées collectées à intervalles réguliers au fil du temps. Ils constituent la base des tableaux de bord et des alertes. Dans une infrastructure blockchain, les indicateurs clés comprennent la latence de réponse RPC (le temps nécessaire à chaque appel d’API), le volume de requêtes (le nombre d’appels par seconde effectués par votre application), le taux d’erreur (le pourcentage de requêtes renvoyant des erreurs), le delta de hauteur de bloc (le retard de votre nœud par rapport à la pointe de la chaîne), les tendances du prix du gaz (les niveaux actuels des frais de réseau) et le temps de confirmation des transactions (le délai entre la soumission et l’inclusion dans un bloc).
Les métriques sont particulièrement adaptées pour comprendre les tendances et détecter les anomalies. Une hausse soudaine de la latence des RPC, une augmentation progressive du taux d'erreur ou une baisse du débit des requêtes sont autant de signes indiquant qu'un changement s'est produit. Les outils de métriques tels que Prometheus, Datadog et Grafana collectent, stockent et visualisent les métriques au fil du temps, permettant ainsi à la fois la création de tableaux de bord en temps réel et l'analyse des tendances historiques.
L'intérêt des métriques réside dans leur légèreté et leur caractère agrégé, ce qui permet de les collecter à haute fréquence sans générer d'énormes volumes de données. Leur limite est qu'elles indiquent ce qui se passe, mais pas pourquoi. Vous savez que la latence a augmenté, mais vous ne savez pas quelles requêtes spécifiques ont été lentes ni ce qui a causé ce ralentissement.
Journaux
Les journaux sont des enregistrements horodatés d’événements distincts. Chaque action importante effectuée par votre système, chaque erreur rencontrée, chaque décision prise peut être consignée sous forme d’entrée de journal. Dans les applications blockchain, les journaux pertinents comprennent les détails des requêtes et réponses RPC (méthode, paramètres, temps de réponse, statut), les événements du cycle de vie des transactions (soumise, en attente, confirmée, échouée), les émissions d'événements des contrats intelligents (données d'événements décodées à partir de vos contrats), les détails des erreurs (traces de pile, codes d'erreur, contexte de la requête) et les actions des utilisateurs (connexions au portefeuille, validations de transactions, navigations entre les pages).
Les journaux sont particulièrement utiles pour fournir les détails nécessaires au diagnostic d'incidents spécifiques. Lorsqu'un indicateur vous alerte d'une hausse soudaine des taux d'erreur, les journaux vous indiquent quelles erreurs spécifiques se produisent, quels terminaux sont affectés et quels étaient les paramètres de la requête. Les outils d'analyse des journaux tels qu'Elasticsearch, Loki, Splunk et CloudWatch Logs permettent de rechercher, filtrer et corréler les entrées de journaux entre différents services et sur différentes plages horaires.
Le revers de la médaille avec les journaux, c'est leur volume. La journalisation détaillée de chaque appel RPC, de chaque événement de transaction et de chaque action de l'utilisateur génère d'énormes quantités de données. Les coûts de stockage des journaux peuvent augmenter rapidement, et la recherche d'un événement spécifique parmi des millions d'entrées de journal nécessite des outils d'indexation et de requête performants.
Traces
Les traces suivent le parcours d'une requête unique au sein d'un système distribué, du début à la fin. Lorsqu'un utilisateur lance un échange de jetons, la trace enregistre chaque étape : le temps de traitement côté front-end, la latence de l'appel à l'API côté back-end, la requête RPC adressée au nœud, le temps de traitement du nœud, la soumission de la transaction et, enfin, la confirmation du bloc. Chaque étape est enregistrée sous la forme d’un « span » comprenant une heure de début, une heure de fin et des métadonnées. Les spans sont reliés entre eux par un identifiant de trace, formant ainsi une vue d’ensemble complète du cheminement de la requête.
Les traces sont indispensables pour diagnostiquer les problèmes de performances dans les systèmes distribués.
architectures optimisées. Si une transaction d'échange prend 8 secondes entre le clic de l'utilisateur et l'affichage de la confirmation, une trace vous montre que 200 ms ont été consacrées au rendu du front-end, 100 ms au traitement du back-end, 500 ms à la latence RPC, 12 secondes à la confirmation sur la chaîne (que votre application a attendue), et le temps restant à la transmission d'événements via WebSocket. Vous savez désormais exactement où ce temps a été passé et quel composant optimiser.
Les outils de traçage distribué tels que Jaeger, Zipkin, Datadog APM et Honeycomb sont conçus pour collecter, stocker et visualiser les traces entre les différents services. Ils s'avèrent particulièrement utiles dans le cadre d'architectures à microservices, où une seule requête utilisateur implique plusieurs services, bases de données et API externes.
Pourquoi l'observabilité est-elle essentielle pour les applications blockchain ?
Les applications blockchain sont, par nature, réparties sur plusieurs systèmes indépendants : votre infrastructure, celle de votre fournisseur RPC et le réseau blockchain lui-même. Cela crée une surface d'exposition aux défaillances et à la dégradation des performances plus étendue que celle d'une application traditionnelle qui ne dépend que de ses propres serveurs et de sa propre base de données.
Les problèmes liés à l'endpoint RPC comptent parmi les difficultés les plus courantes auxquelles sont confrontés les développeurs de blockchain. Une endpoint peut renvoyer des données obsolètes (parce que le nœud sous-jacent a pris du retard dans la synchronisation), répondre lentement (en raison de la distance géographique ou de la charge) ou renvoyer des erreurs (en raison d'une limitation de débit ou de défaillances de nœuds). Sans observabilité au niveau de votre couche RPC, ces problèmes restent invisibles jusqu'à ce que les utilisateurs se plaignent.
Les conditions de la chaîne ont une incidence sur votre application, même si elles échappent à votre contrôle. La congestion de la chaîne entraîne une hausse des prix du gaz et allonge les délais de confirmation. Les réorganisations de blocs peuvent invalider des transactions récemment confirmées. Les pannes de validateurs sur les chaînes de moindre envergure peuvent entraîner des retards dans la production de blocs. Les outils d'observabilité qui suivent les métriques au niveau de la chaîne parallèlement à celles de votre application vous offrent une vue d'ensemble complète des facteurs qui affectent vos utilisateurs.
Quelle est la différence entre l'observabilité et la surveillance ?
La surveillance et l'observabilité sont liées, mais ne sont pas interchangeables. La surveillance consiste à surveiller un ensemble connu de signaux et à vous alerter lorsqu'un d'entre eux dépasse un seuil : elle répond à la question « Y a-t-il un problème ? ». L'observabilité est la capacité plus large de poser des questions ouvertes sur votre système à l'aide de données riches, afin que vous puissiez répondre à la question « Pourquoi y a-t-il un problème ? », même pour des défaillances que vous n'aviez pas anticipées. La surveillance est un sous-ensemble de l'observabilité ; vous avez besoin de la surveillance pour détecter les problèmes et de l'observabilité pour les expliquer.
Comment les métriques, les journaux et les traces fonctionnent-ils ensemble ?
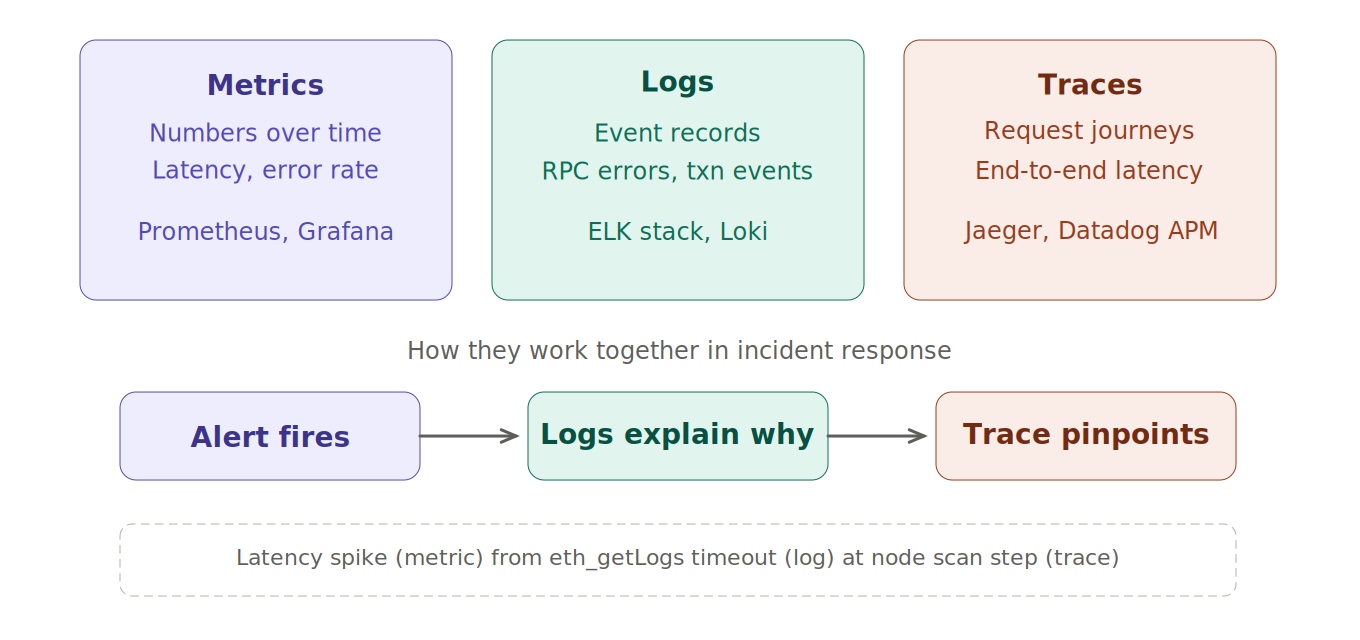
Ces trois piliers sont complémentaires, et non concurrents. Les métriques indiquent qu’un changement s’est produit, les journaux précisent ce qui s’est passé exactement, et les traces permettent de localiser, au sein d’une requête distribuée, l’endroit où le délai ou l’erreur s’est produit. Une bonne pratique d’observabilité utilise ces trois éléments : une alerte se déclenche sur la base d’une métrique, une trace permet de circonscrire le problème à un seul service, et les journaux révèlent l’erreur exacte. Le tableau ci-dessous met en correspondance chaque pilier avec la question à laquelle il répond le mieux.
Pilier
Réponses
Exemple de blockchain
Outils courants
Indicateurs
Qu'est-ce qui a changé et quand ?
La latence RPC a atteint un pic à 14 h 02
Prometheus, Grafana
Journaux
Que s'est-il passé exactement ?
eth_call a renvoyé une erreur de délai d'attente
Loki, Splunk
Traces
Où ce temps a-t-il été passé ?
500 ms dans la durée de la communication RPC
Jaeger, APM de Datadog
Pour une comparaison plus approfondie de ces piliers, consultez l'article « Metrics vs logs vs traces ». Le suivi de la latence RPC en tant que métrique à part entière constitue l'un des indicateurs les plus précieux pour une application blockchain.
Commencez par instrumenter la couche RPC, puisqu’elle se situe entre votre application et la chaîne : enregistrez le volume de requêtes, les centiles de latence et les taux d’erreur par méthode. Ajoutez des contrôles d’intégrité qui comparent la hauteur du bloc de votre nœud à la pointe de la chaîne afin de détecter rapidement tout retard de synchronisation. Associez ensuite des alertes aux signaux qui prédisent réellement les difficultés rencontrées par les utilisateurs, et concevez votre système dans un souci de résilience afin qu’une défaillance isolée ne vous empêche pas de voir la situation dans son ensemble. Associez l’observabilité à des nœuds fiables, à une haute disponibilité et à un chemin de basculement testé, de sorte que lorsqu’un problème survient, vous puissiez à la fois le détecter et le contourner.
Foire aux questions
L'observabilité, c'est la même chose que la surveillance ?
Non. La surveillance analyse des signaux prédéfinis et vous alerte lorsqu'un seuil est dépassé, tandis que l'observabilité vous fournit suffisamment de données pour analyser n'importe quel problème, y compris les défaillances que vous n'aviez pas anticipées. La surveillance ne constitue qu'une partie d'une approche plus large de l'observabilité.
Quels sont les trois piliers de l'observabilité ?
Métriques, journaux et traces. Les métriques sont des mesures chiffrées évoluant dans le temps, les journaux sont des enregistrements horodatés d'événements discrets, et les traces suivent le parcours d'une requête unique au sein d'un système distribué. Ensemble, ils vous permettent de détecter, d'expliquer et de localiser les problèmes.
Pourquoi l'observabilité est-elle plus difficile à mettre en œuvre pour les applications blockchain ?
Les applications blockchain s'étendent à votre propre infrastructure, à un fournisseur RPC tiers et à la chaîne elle-même ; les défaillances peuvent donc provenir de couches que vous ne contrôlez pas. Cette surface d'exposition plus large implique que vous ayez besoin d'une visibilité sur chaque couche, y compris sur les conditions au niveau de la chaîne, telles que la congestion et les réorganisations.
Quels sont les indicateurs les plus importants pour une infrastructure RPC ?
La latence de réponse, le volume de requêtes, le taux d'erreur et la variation de la hauteur des blocs constituent les indicateurs clés. La latence et les erreurs reflètent l'état de santé de l'endpoint , le volume de requêtes indique la charge, et la variation de la hauteur des blocs permet de savoir si le nœud suit le rythme de la pointe de la chaîne.
Ai-je besoin d'outils différents pour chaque pilier ?
Pas nécessairement. De nombreuses plateformes couvrent plusieurs piliers, et les fournisseurs proposent souvent des outils d’analyse RPC et des exportateurs de métriques que vous pouvez intégrer à une infrastructure existante. L’objectif est d’obtenir une visibilité unifiée sur les couches applicatives et blockchain, plutôt que de se limiter à un nombre précis d’outils.
Comment « Quicknode » favorise l'observabilité
Quicknode offre des fonctionnalités d'observabilité intégrées pour la couche d'infrastructure de la blockchain. Le tableau de bord « Quicknode » (Performances des appels RPC) comprend des analyses en temps réel indiquant le volume de requêtes, la latence des réponses, les taux d'erreur et des ventilations par méthode pour chaque endpoint. Cela permet aux développeurs d'avoir une visibilité immédiate sur leurs schémas d'utilisation des appels RPC sans avoir à mettre en place leur propre système de surveillance.
Pour les équipes disposant déjà d’ stacks d’observabilité, les services dédiés Clusters de Quicknode prennent en charge l’intégration de Prometheus Exporter, ce qui vous permet d’importer directement des métriques au niveau des nœuds dans vos tableaux de bord Grafana, Datadog ou tout autre système de surveillance compatible avec Prometheus. Vous bénéficiez ainsi d’une observabilité unifiée de votre infrastructure applicative et de votre infrastructure blockchain depuis un seul et même tableau de bord.
Quicknode Streams il renforce l'observabilité de votre couche de pipeline de données, en fournissant des informations sur l'état de la transmission, des indicateurs de traitement et des rapports d'erreurs pour chaque flux. Associé au tableau de bord d'analyse RPC, cela offre aux développeurs une visibilité complète tant sur leurs accès API en temps réel que sur l'ingestion de leurs données en continu.