Réponses>En savoir plus sur la surveillance et l'observabilité>Métriques, journaux et traces : quelle différence ?
Métriques, journaux et traces
// Tags
indicateurs, journaux, tracespiliers de l'observabilité
En bref : les métriques, les journaux et les traces constituent les trois types de données fondamentaux de l’observabilité, chacun jouant un rôle distinct dans la compréhension du comportement du système. Les métriques sont des mesures numériques agrégées suivies au fil du temps, idéales pour les tableaux de bord, les alertes et l’analyse des tendances. Les journaux sont des enregistrements horodatés d’événements individuels, particulièrement adaptés au débogage d’incidents spécifiques et à la conservation des pistes d’audit. Les traces suivent le parcours complet d’une requête unique à travers un système distribué, révélant où le temps est consommé et où se produisent les goulots d’étranglement. Dans la pratique, ces trois éléments fonctionnent de concert : une métrique déclenche une alerte, les journaux fournissent les détails de l’erreur et une trace montre le contexte complet du chemin de la requête ayant échoué. Une observabilité efficace pour les applications blockchain nécessite ces trois piliers, car la nature distribuée de l’infrastructure blockchain engendre des modes de défaillance qu’aucun type de données ne peut diagnostiquer à lui seul.
L'explication simple
Prenons l'exemple du diagnostic d'une affection médicale. Vos signes vitaux (fréquence cardiaque, tension artérielle, température) sont des indicateurs : ils vous signalent qu'il y a une anomalie. Votre dossier médical et les résultats de vos examens sont des enregistrements : ils fournissent des détails précis sur ce qui se passe. Une IRM ou un scanner est une image : elle montre une vue d'ensemble de l'intérieur de votre corps, ce qui permet au médecin de localiser exactement l'origine du problème.
Dans une infrastructure blockchain, vous êtes confronté au même défi de diagnostic. Votre application est répartie entre votre front-end, votre back-end, vos points de terminaison RPC, vos nœuds de blockchain et la chaîne elle-même. Chaque couche peut tomber en panne ou subir une dégradation de manière indépendante. Les métriques vous indiquent qu’il y a un problème (pic de latence). Les journaux vous indiquent ce qui s’est mal passé (une méthode RPC spécifique renvoie des erreurs). Les traces vous indiquent à quel endroit du chemin de requête le problème a pris naissance (le nœud a mis 3 secondes à traiter un eth_call sur un contrat complexe).
Quelle est la différence entre la surveillance et l'observabilité ?
La surveillance et l'observabilité sont deux concepts liés, mais distincts. La surveillance consiste à surveiller des signaux connus et à vous alerter lorsqu'un seuil prédéfini est dépassé. L'observabilité, quant à elle, désigne la capacité plus large de poser de nouvelles questions sur votre système à partir des données qu'il génère, même pour des problèmes que vous n'aviez pas anticipés. Les métriques, les journaux et les traces constituent les éléments de base de l'observabilité : ensemble, ils vous permettent de passer de « quelque chose ne va pas » à « voici exactement pourquoi ». Pour une introduction plus approfondie, consultez notre présentation de
Quelles sont les différences entre les métriques, les journaux et les traces ?
Chaque pilier répond à une question différente et implique un coût différent. Le tableau ci-dessous résume les situations dans lesquelles il convient de recourir à chacun d'entre eux.
Dimension
Indicateurs
Journaux
Traces
Type de données
Chiffres agrégés
Événements horodatés
Périodes de demande liées
La meilleure question
Il y a un problème ?
Qu'est-ce qui a mal tourné ?
Où est-ce que ça a mal tourné ?
Coût de stockage
Faible
Élevé
Moyen, généralement échantillonné
Idéal pour
Tableaux de bord et alertes
Débogage visant à identifier la cause première
Analyse de la latence et des goulots d'étranglement
Exemples d'outils
Prometheus, Grafana
ELK, Loki, Splunk
OpenTelemetry, Jaeger
Dans le cas des systèmes blockchain, ces piliers s'appuient sur une surveillance plus large de l'infrastructure, qui contrôle l'état de santé des nœuds, leur état de synchronisation et le comportement RPC.
Les indicateurs en détail
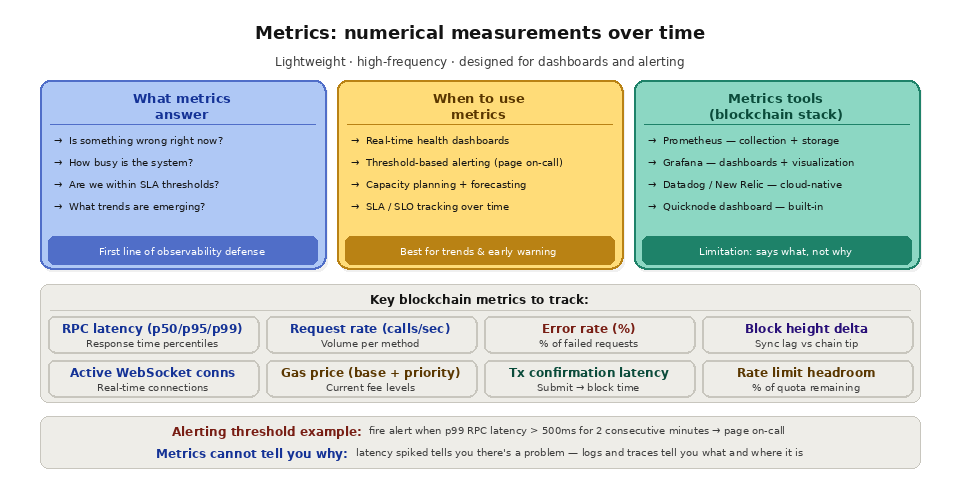
Les métriques sont des valeurs numériques collectées à intervalles réguliers et agrégées au fil du temps. Elles sont légères, faciles à stocker et conçues pour une collecte à haute fréquence. Une application blockchain typique suit des métriques telles que le taux de requêtes RPC (nombre de requêtes par seconde par méthode), la latence de réponse (p50, p95, p99), le taux d’erreur (pourcentage de requêtes renvoyant des codes d’état autres que 200), le delta de hauteur de bloc (différence entre le dernier bloc de votre nœud et la pointe de la chaîne), les connexions WebSocket actives, le prix du gaz (niveaux actuels des frais de base et des frais de priorité) et la latence de confirmation des transactions.
Les métriques constituent la première ligne de défense en matière d'observabilité. Elles alimentent des tableaux de bord en temps réel qui permettent de vérifier d'un seul coup d'œil si vos systèmes fonctionnent correctement. Elles déclenchent des règles d'alerte qui préviennent votre ingénieur de garde lorsqu'un seuil est dépassé. Enfin, elles facilitent la planification des capacités en mettant en évidence les tendances à long terme concernant l'utilisation des ressources et les schémas de trafic.
La pile d'outils de métriques standard dans l'écosystème de la blockchain comprend généralement Prometheus pour la collecte et le stockage, Grafana pour la visualisation et la création de tableaux de bord, ainsi qu'Alertmanager ou PagerDuty pour l'acheminement des alertes. Parmi les alternatives natives du cloud, on peut citer Datadog, New Relic et AWS CloudWatch. Tous ces outils sont conçus pour gérer les données de métriques, qui se caractérisent par un volume élevé et une nature de séries chronologiques.
La limite des métriques réside dans leur nature agrégée. Une métrique vous indique que la latence RPC au 99e centile a dépassé 500 ms, mais elle ne vous précise pas quelles requêtes spécifiques étaient lentes, quels paramètres elles comportaient, ni ce que faisait le nœud au moment où il était lent. Pour obtenir ce niveau de détail, vous avez besoin de journaux et de traces.
Détails des journaux
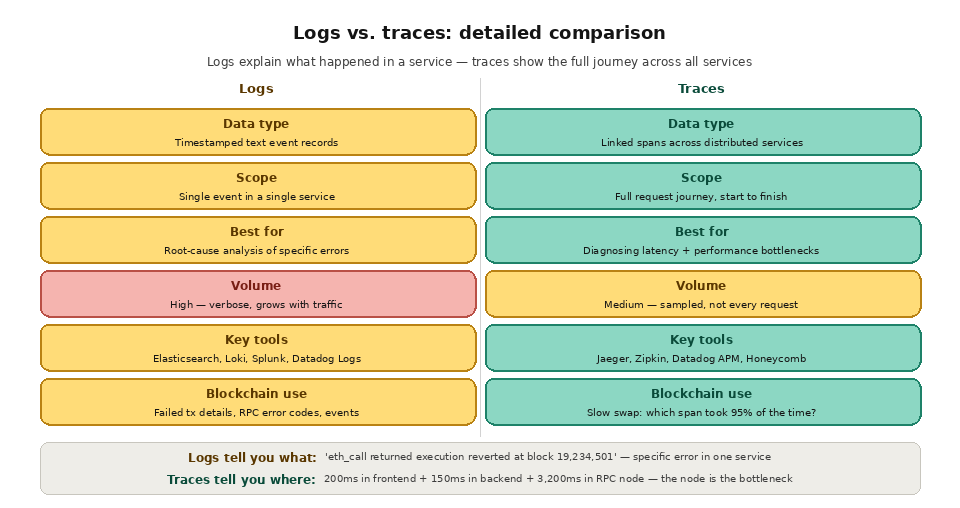
Les journaux sont des enregistrements textuels horodatés correspondant à des événements individuels. Chaque fois que votre application effectue un appel RPC, traite une transaction, rencontre une erreur ou gère une action utilisateur, une entrée de journal en consigne les détails. Contrairement aux métriques (qui sont des chiffres agrégés sur des intervalles), les journaux sont des enregistrements individuels riches en contexte : l’ensemble des paramètres de la requête, le message d’erreur exact, la trace de pile, l’identifiant de l’utilisateur, le hachage de la transaction.
Dans les applications blockchain, les catégories de journaux essentielles comprennent les journaux de requêtes RPC (méthode, paramètres, code de réponse, latence par requête), les journaux du cycle de vie des transactions (hachage, transitions d’état de « en attente » à « confirmée » puis à « finalisée »), les journaux d'événements des contrats intelligents (événements décodés issus de vos contrats avec l'ensemble des données de paramètres), les journaux d'erreurs (erreurs RPC, exceptions de délai d'attente, conflits de nonce, échecs d'estimation du gas) et les journaux d'application (événements d'authentification des utilisateurs, décisions de logique métier, changements d'état).
Les journaux constituent l'outil principal pour l'analyse des causes profondes. Lorsqu'un indicateur vous alerte d'une augmentation des taux d'erreur, vous interrogez vos journaux à la recherche d'entrées d'erreur récentes, vous les filtrez par type d'erreur et vous identifiez la tendance. Il se peut qu'une méthode RPC spécifique ait commencé à renvoyer des erreurs de type « nœud trie manquant » parce que le nœud a élagué les données d'état. Il se peut également que les soumissions de transactions échouent en raison de conflits de nonce liés à un bug de traitement simultané. Les journaux contiennent les détails que les indicateurs ne peuvent pas fournir.
Parmi les outils de gestion des journaux, on peut citer Elasticsearch avec Kibana (la « pile ELK »), Grafana Loki, Splunk, Datadog Logs et AWS CloudWatch Logs. Ces outils stockent, indexent et permettent d'effectuer des recherches dans les entrées de journaux à grande échelle, offrant ainsi des fonctionnalités de recherche en texte intégral, de requêtes structurées et de corrélation entre les services.
Le compromis à prendre avec les journaux concerne le volume de stockage et le coût. L'enregistrement de chaque requête RPC pour une application à fort trafic génère plusieurs gigaoctets de données par jour. La journalisation structurée (où les entrées de journal sont formatées en JSON avec des noms de champs cohérents) permet un indexage et une interrogation plus efficaces que les journaux textuels non structurés, et l'échantillonnage des journaux (qui consiste à n'enregistrer qu'une fraction des événements courants) peut réduire le volume sans pour autant perdre la visibilité sur les erreurs et les anomalies.
Les traces en détail
Les traces permettent de suivre le parcours complet d'une requête au sein d'un système distribué. Une trace est composée de plusieurs segments, chacun représentant une unité de travail au sein d'un service spécifique. Les segments sont imbriqués de manière hiérarchique (un segment parent pour la requête globale, des segments enfants pour chaque sous-opération) et reliés par un identifiant de trace commun.
endpoint Dans le cas d’une application blockchain, une seule trace peut englober les segments suivants : l’utilisateur clique sur « swap » dans le navigateur (segment front-end, 50 ms), le front-end envoie une requête API au back-end (segment réseau, 20 ms), le back-end appelle l’ endpoint RPC pour l’estimation du gas (intervalle RPC, 150 ms), le backend appelle l’ RPC pour la soumission de la transaction (intervalle RPC, 200 ms), le backend interroge le réseau pour obtenir l’accusé de réception de la transaction (plusieurs intervalles RPC, 12 000 ms au total), le backend envoie la confirmation au frontend (intervalle réseau, 15 ms) et le frontend met à jour l’interface utilisateur (intervalle frontend, 30 ms). La trace montre que 95 % du temps total a été consacré à l’attente d’une confirmation sur la chaîne, et non à l’exécution du code propre à l’application.
Le traçage distribué est mis en œuvre en injectant un contexte de traçage (un identifiant de trace et un identifiant de segment) dans chaque requête au fur et à mesure de son parcours dans votre système. Chaque service crée des segments correspondant à ses propres opérations et transmet le contexte de traçage aux services en aval. Les bibliothèques de traçage telles qu’OpenTelemetry fournissent des outils d’instrumentation standardisés pour la plupart des langages de programmation et des frameworks. Les outils de visualisation tels que Jaeger, Zipkin et Datadog APM affichent les traces sous forme de diagrammes en cascade illustrant la durée et l’imbrication de chaque segment.
Les traces sont particulièrement utiles pour diagnostiquer les problèmes de latence dans les architectures distribuées. Lorsqu’un utilisateur signale qu’une transaction a mis 30 secondes à être confirmée, une trace vous montre exactement comment ces 30 secondes ont été réparties : 25 secondes d’attente pour l’inclusion dans un bloc, 3 secondes pour les appels RPC, 1,5 seconde pour le traitement en arrière-plan et 500 ms pour le rendu en avant-plan. Vous savez immédiatement que l'optimisation de votre code backend ne servira à rien ; le goulot d'étranglement réside dans le temps de confirmation au niveau de la chaîne.
Utiliser les trois ensemble
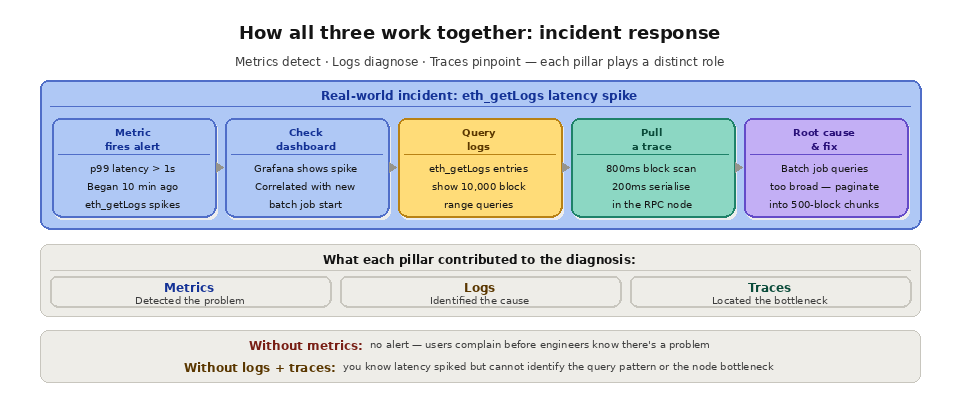
Ces trois piliers sont complémentaires, et non concurrents. Un processus type de gestion des incidents fait appel à ces trois piliers.
Une alerte métrique se déclenche : la latence RPC p99 a dépassé 1 seconde. Vous ouvrez votre tableau de bord Grafana et constatez que le pic de latence a commencé il y a 10 minutes et qu’il est corrélé à un pic des appels eth_getLogs. Vous interrogez vos journaux à la recherche de requêtes eth_getLogs récentes et découvrez qu’un nouveau job par lots a démarré au même moment, effectuant des requêtes de journaux de grande envergure couvrant chacune 10 000 blocs. Vous générez une trace pour l'une de ces requêtes et constatez que le nœud RPC a passé 800 ms à analyser les blocs et 200 ms à sérialiser la réponse. La cause première est claire : les requêtes de journaux trop étendues de la tâche batch consomment de manière disproportionnée les ressources du nœud. La solution consiste à paginer les requêtes en plages de blocs plus petites.
Sans indicateurs, vous ne sauriez pas qu'il y a un problème tant que les utilisateurs ne se plaignent pas. Sans journaux, vous sauriez que la latence a augmenté, mais vous ne sauriez pas quelles requêtes en sont à l'origine. Sans traces, vous sauriez que la fonction `eth_getLogs` est lente, mais vous ne sauriez pas si le goulot d'étranglement se situe au niveau de votre application, du réseau ou de l'analyse des blocs par le nœud.
Par quel pilier faut-il commencer ?
Si vous mettez en place une stratégie d’observabilité à partir de zéro, commencez par les métriques, car elles sont peu coûteuses à collecter et permettent de mettre immédiatement en évidence les problèmes grâce aux tableaux de bord et aux alertes. Ajoutez ensuite des journaux structurés afin de pouvoir analyser les problèmes mis en évidence par vos métriques. Intégrez le traçage distribué dès que votre système s’étend à plusieurs services et que vous avez besoin d’identifier précisément où la latence s’accumule. Pour la blockchain en particulier, associer cette approche au suivi de la latence RPC vous permettra de couvrir la couche la plus susceptible de vous réserver des surprises en production.
Comment « Quicknode » soutient ces trois piliers
QuicknodeLe tableau de bord de [nom] fournit des indicateurs intégrés pour chaque endpoint: volume de requêtes, latence de réponse, taux d'erreur et répartition par méthode. Ces indicateurs offrent aux développeurs une visibilité immédiate sur leur couche d'infrastructure blockchain, sans nécessiter d'instrumentation personnalisée.
QuicknodePour les équipes qui intègrent des métriques blockchain dans leur pile d'observabilité existante, les services dédiés « Clusters » prennent en charge Prometheus Exporter, ce qui permet l'ingestion directe de métriques au niveau des nœuds dans Prometheus, Grafana, Datadog ou tout autre système compatible. Cela permet de disposer d'un tableau de bord unifié regroupant les métriques des applications et celles de l'infrastructure blockchain.
Quicknode Streams offre une observabilité de l'état du pipeline de données, notamment les indicateurs de livraison, l'état du traitement et les rapports d'erreurs. Associé aux analyses RPC et à vos propres systèmes de journalisation et de traçabilité au niveau des applications, Quicknode fournit aux développeurs une vue d'ensemble complète de l'observabilité, indispensable pour diagnostiquer et résoudre les problèmes à tous les niveaux de la pile blockchain.
Foire aux questions
Les métriques, les journaux et les traces correspondent-ils à la surveillance ?
Non. Il s'agit des types de données sous-jacents. La surveillance consiste à surveiller des signaux prédéfinis et à déclencher des alertes en fonction de ceux-ci, tandis que l'observabilité utilise ces trois types de données pour analyser des problèmes que vous n'aviez pas anticipés.
Lequel des trois est le plus coûteux à stocker ?
Les journaux sont généralement les plus coûteux, car ils enregistrent chaque événement individuellement avec un niveau de détail complet. Les métriques sont les moins coûteuses grâce à l'agrégation, tandis que les traces se situent entre les deux, car elles sont généralement échantillonnées plutôt que capturées pour chaque requête.
Ai-je besoin des trois pour une petite application ?
Pas au début. La plupart des équipes commencent par des indicateurs et des journaux de base. Le traçage distribué prend tout son sens lorsque les requêtes traversent plusieurs services et qu'il est difficile d'attribuer la latence à un seul composant.
Qu'est-ce qu'OpenTelemetry ?
OpenTelemetry est une norme ouverte et un ensemble de bibliothèques permettant de générer des métriques, des journaux et des traces de manière indépendante des fournisseurs. Il vous permet d'effectuer un seul instrument et d'exporter les données vers de nombreux backends tels que Prometheus, Jaeger ou Datadog.
En quoi cela s'applique-t-il plus précisément au RPC de la blockchain ?
Les appels RPC constituent une source courante de latence et d'erreurs. C'est pourquoi le suivi du taux de requêtes, des percentiles de latence et des codes d'erreur en tant qu'indicateurs, l'enregistrement des appels ayant échoué dans les journaux et le traçage de bout en bout des requêtes lentes vous offrent une visibilité complète. Une infrastructure Node fiable, abordée dans notre guide sur la fiabilité de Node, réduit d'emblée le nombre d'incidents que vous devez diagnostiquer.