Réponses>En savoir plus sur la fiabilité et la disponibilité>Pourquoi la redondance de l'infrastructure est-elle importante ?
Pourquoi la redondance des infrastructures est-elle importante ?
// Tags
redondance des infrastructures
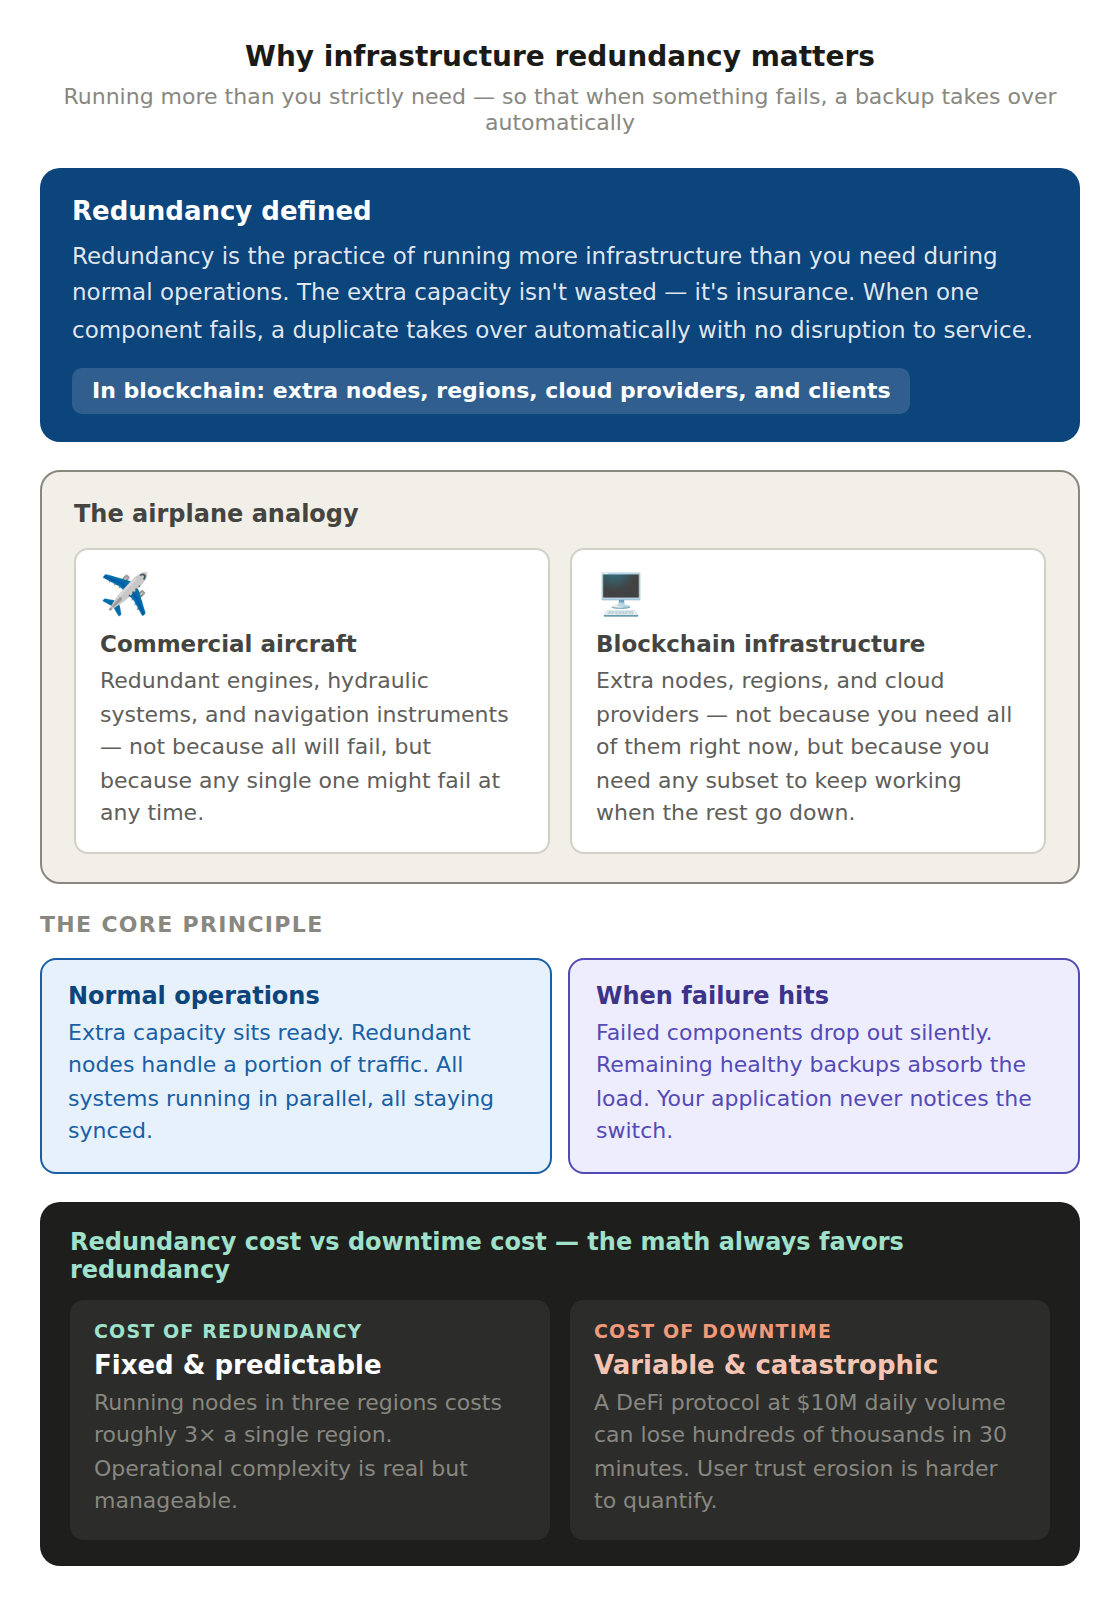
En bref : la redondance consiste à disposer de composants de secours à chaque niveau de votre infrastructure afin que, en cas de défaillance, un double prenne automatiquement le relais. Dans la blockchain, c’est la redondance entre les nœuds, les régions, les fournisseurs de cloud et les implémentations client qui distingue les systèmes de niveau production des systèmes fragiles.
Que signifie réellement le terme « redondance » ?
La redondance consiste à disposer de ressources en plus par rapport à ce qui est strictement nécessaire dans le cadre d'un fonctionnement normal. Cette capacité supplémentaire n'est pas gaspillée : c'est une assurance.
Pensez-y comme à un avion. Les avions commerciaux sont équipés de moteurs redondants, de systèmes hydrauliques redondants et d’instruments de navigation redondants. Non pas parce qu’on s’attend à ce qu’ils tombent tous en panne en même temps, mais parce que n’importe lequel d’entre eux peut tomber en panne à tout moment. Les systèmes redondants garantissent que l’avion continue de voler même en cas de panne.
La redondance des infrastructures repose sur le même principe. Vous exploitez des nœuds supplémentaires, dans des régions supplémentaires, chez des fournisseurs de cloud supplémentaires, non pas parce que vous en avez besoin de tous dès maintenant, mais parce que vous avez besoin qu’un sous-ensemble quelconque de ceux-ci continue de fonctionner lorsque les autres tombent en panne.
Les niveaux de redondance
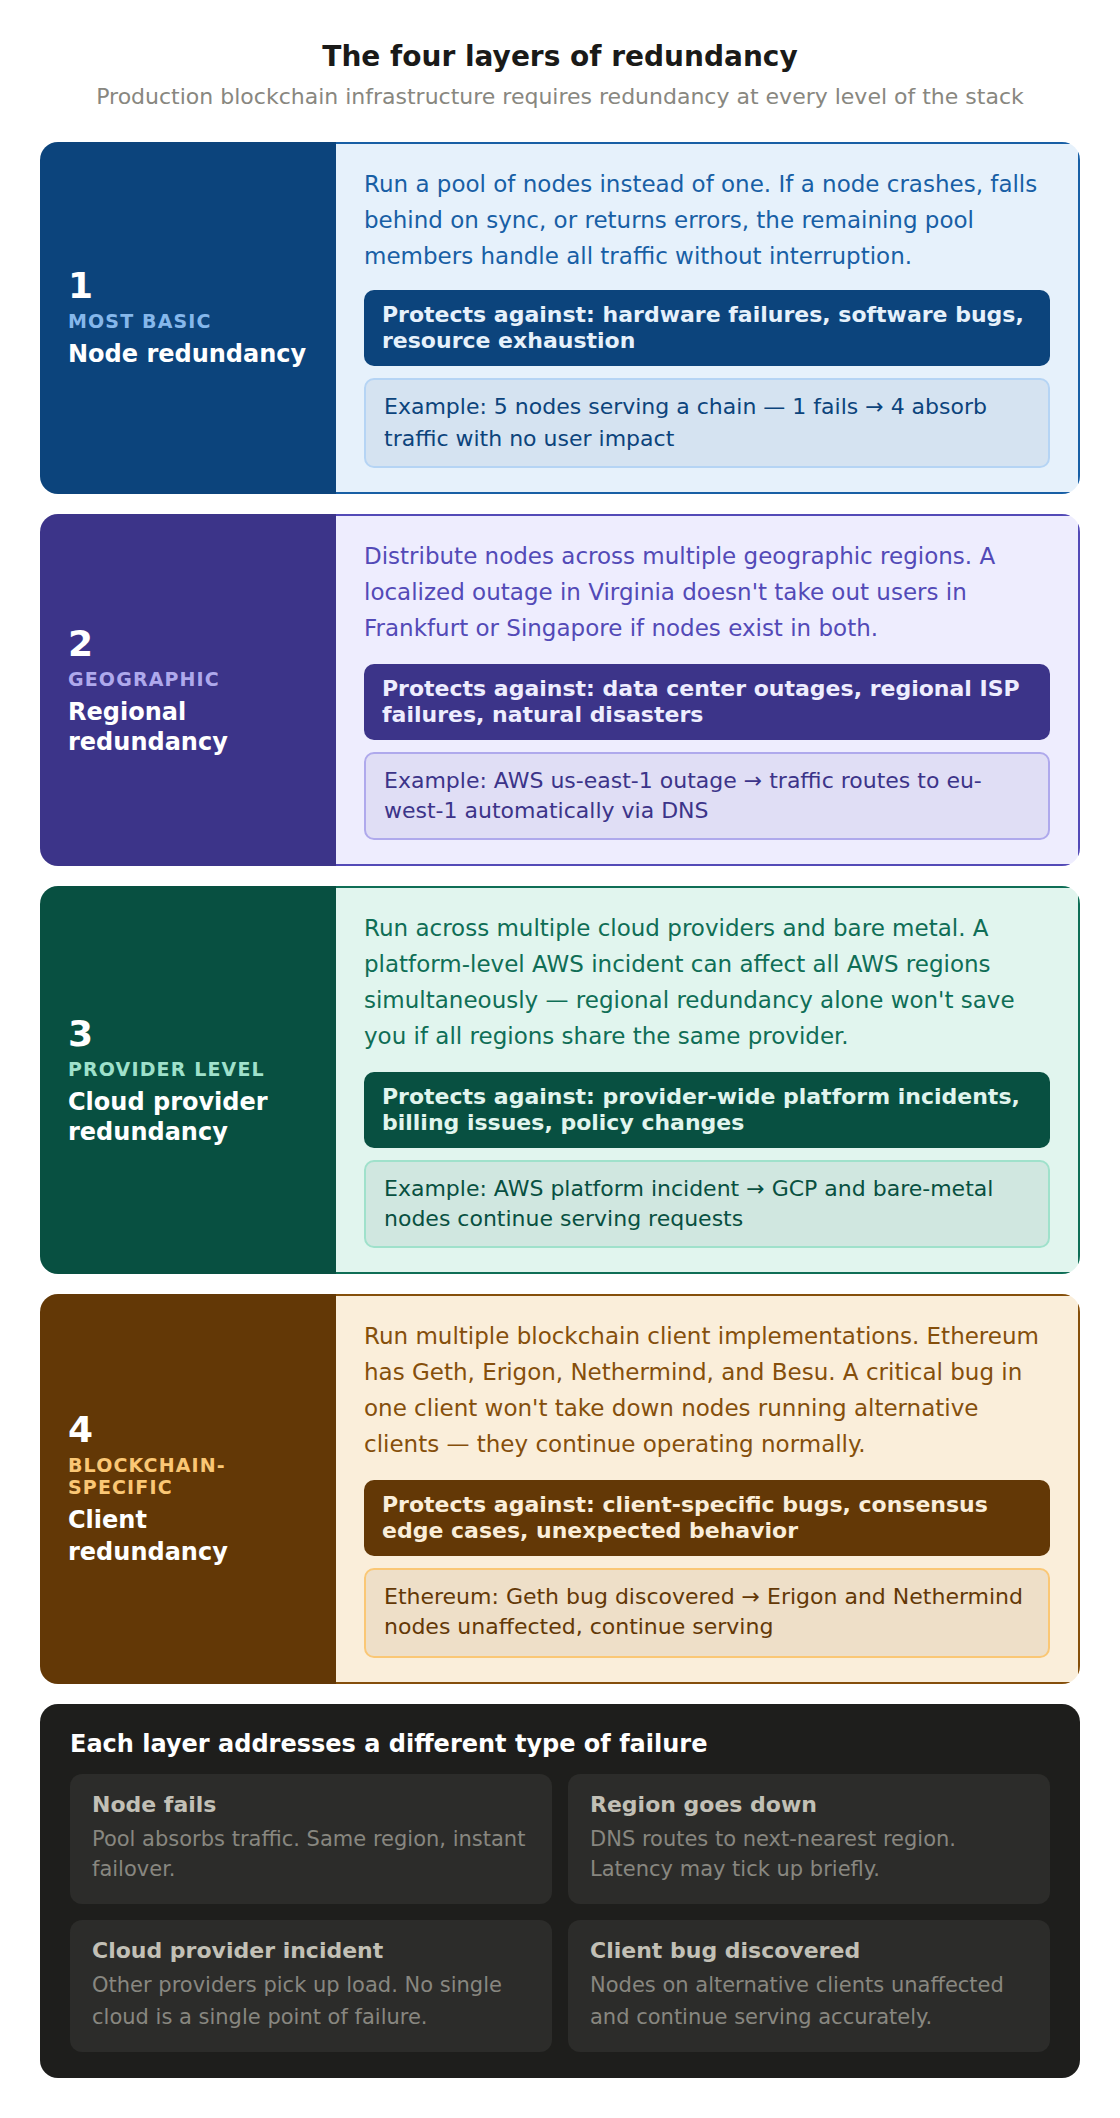
Une infrastructure blockchain de production nécessite une redondance à plusieurs niveaux. Chaque couche permet de faire face à un type de défaillance différent.
La redondance des nœuds est la solution la plus élémentaire. Au lieu de s'appuyer sur un seul nœud pour une blockchain donnée, on exploite un ensemble de nœuds. Si un nœud tombe en panne, prend du retard dans la synchronisation ou commence à renvoyer des erreurs, les nœuds restants de l'ensemble prennent le relais pour gérer le trafic. Cela permet de se prémunir contre les pannes matérielles individuelles, les bogues logiciels dans un processus de nœud spécifique ou l'épuisement des ressources sur une seule machine.
La redondance régionale offre une protection contre les pannes de grande ampleur. Si tous vos nœuds fonctionnent dans une seule région AWS et que cette région subit une panne (ce qui arrive plus souvent que la plupart des gens ne le pensent), tout tombe en panne simultanément. La répartition des nœuds sur plusieurs régions géographiques garantit qu’un incident localisé en Virginie n’affectera pas vos utilisateurs à Francfort ou à Singapour.
La redondance entre fournisseurs de services cloud va encore plus loin. Si l'ensemble de votre infrastructure repose sur un seul fournisseur de services cloud et que celui-ci subit un incident au niveau de sa plateforme, la redondance régionale à elle seule ne suffira pas à vous protéger. Le fait de répartir votre infrastructure entre plusieurs fournisseurs (AWS, GCP, serveurs physiques, etc.) garantit qu’une panne spécifique à un fournisseur ne se répercutera pas sur votre infrastructure.
La redondance des clients est une caractéristique propre à la blockchain. La plupart des principales blockchains disposent de plusieurs implémentations de clients de nœuds. Ethereum propose Geth, Erigon, Nethermind et Besu. Solana propose le client validateur et Firedancer. Si un bug critique apparaît dans un client, les nœuds exécutant d’autres clients continuent de fonctionner normalement. Les fournisseurs qui utilisent un ensemble diversifié de clients sont plus résilients face aux défaillances au niveau logiciel.
Que se passe-t-il en l'absence de redondance ?
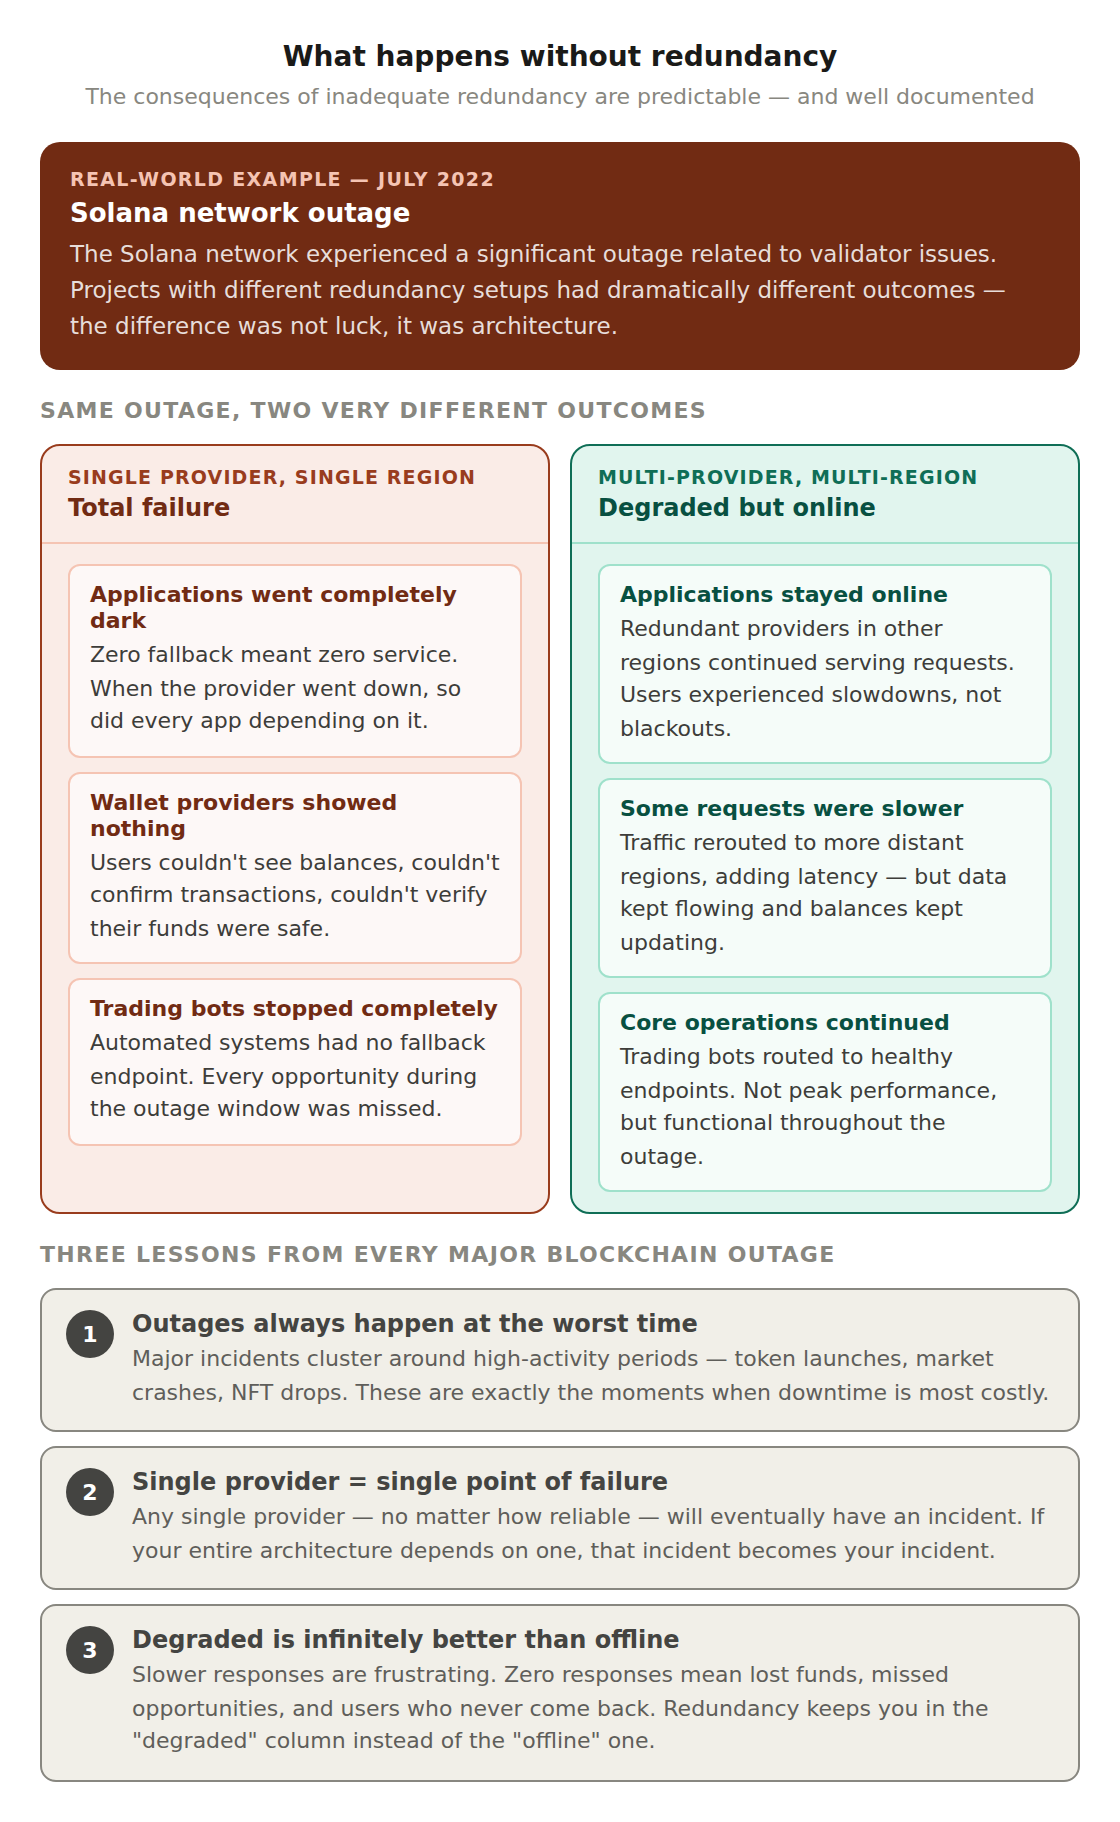
Les conséquences d’une redondance insuffisante sont prévisibles et bien documentées. En juillet 2022, le réseau Solana a subi une panne majeure liée en partie à des problèmes de validateurs. Les projets qui s’appuyaient sur un seul fournisseur RPC dans une seule région n’avaient aucune solution de secours. Leurs applications ont complètement cessé de fonctionner. Les fournisseurs de portefeuilles ne pouvaient plus afficher les soldes. Les bots de trading ont cessé de fonctionner. Les tableaux de bord de surveillance n’affichaient plus rien.
Comparez cela à des projets impliquant plusieurs fournisseurs et plusieurs régions. Ceux-ci ont connu une baisse de performances, mais pas de panne totale. Certaines requêtes étaient plus lentes, mais les applications sont restées en ligne. Cette différence n'était pas due au hasard. Elle tenait à la redondance.
Coût de la redondance vs coût des temps d'arrêt
L'une des objections couramment avancées contre la redondance est son coût. L'exploitation de nœuds dans trois régions coûte environ trois fois plus cher que dans une seule. Le fait de recourir à deux fournisseurs de cloud ajoute une couche supplémentaire de complexité opérationnelle et de coûts.
Mais il faut tenir compte du coût des temps d’arrêt. Pour un protocole DeFi traitant un volume quotidien de 10 millions de dollars, même 30 minutes d’indisponibilité aux heures de pointe peuvent se traduire par des centaines de milliers de transactions manquées, des échecs de liquidation et une érosion de la confiance des utilisateurs. Pour une place de marché NFT lors d’une chute importante des cours, quelques minutes d’indisponibilité peuvent signifier la perte de toute une cohorte d’utilisateurs au profit d’un concurrent resté opérationnel.
D'un point de vue mathématique, la redondance s'avère presque toujours avantageuse pour les applications de production. Le coût de l'infrastructure est fixe et prévisible. Le coût des temps d'arrêt est variable et souvent catastrophique.
Quelle est la différence entre la redondance et le basculement ?
La redondance et le basculement fonctionnent de concert, mais ne sont pas la même chose. La redondance consiste à disposer d’une capacité de réserve : des nœuds, des régions et des fournisseurs supplémentaires prêts à intervenir. Le basculement est le mécanisme qui détecte effectivement une défaillance et redirige le trafic vers cette capacité de réserve. Une redondance sans basculement revient à disposer de solutions de secours vers lesquelles personne ne bascule ; un basculement sans redondance revient à disposer d’un mécanisme de basculement sans destination vers laquelle basculer. Les deux sont indispensables pour garantir une véritable résilience.
Aspect
Redondance
Basculement
De quoi s'agit-il ?
Capacité de réserve, capacité redondante
Le fait de passer à ce système
Question à laquelle elle répond
Avons-nous une sauvegarde ?
À quelle vitesse l'utilisons-nous ?
Sans l'autre
Les sauvegardes vers lesquelles personne ne redirige
Un commutateur sans cible
Mesuré par
Nombre d'exemplaires indépendants
Temps de détection et de commutation
En résumé, la redondance constitue la base, tandis que le basculement en est le mécanisme d'automatisation qui s'y ajoute. Ensemble, ils constituent les éléments fondamentaux de la haute disponibilité.
En quoi la redondance permet-elle d'améliorer la disponibilité ?
Chaque couche de redondance élimine un point de défaillance unique différent ; ainsi, plus vous superposez de couches indépendantes, moins une défaillance isolée est susceptible de vous mettre complètement hors ligne. Le tableau ci-dessous établit une correspondance entre chaque couche de redondance et la défaillance contre laquelle elle offre une protection.
Il n’y a pas de réponse unique ; l’objectif est d’adapter la redondance au coût d’une panne. Un projet amateur peut tolérer des temps d’arrêt occasionnels et n’aura peut-être besoin que d’une solution de secours endpoint, tandis qu’un protocole DeFi ou une plateforme d’échange traitant de la valeur réelle nécessite une couverture multirégionale et multi-fournisseurs avec basculement automatique. Prenez votre décision en mettant en balance le coût fixe et prévisible de la redondance et le coût variable, potentiellement catastrophique, d’une panne. Il s’agit fondamentalement d’un choix entre « construire » et « acheter », qui n’est rentable que si vous êtes en mesure d’anticiper les défaillances ; associez-le donc à une observabilité et une surveillance solides de votre infrastructure.
Foire aux questions
Qu'est-ce que la redondance des infrastructures ?
La redondance des infrastructures consiste à faire fonctionner davantage de composants que ce qui est strictement nécessaire en conditions normales d'exploitation, afin qu'un système de secours puisse prendre le relais en cas de défaillance. Dans le domaine de la blockchain, cela se traduit par la mise en place de nœuds dupliqués répartis sur plusieurs régions, chez différents fournisseurs de services cloud et dans diverses implémentations client.
La redondance, c'est la même chose qu'une sauvegarde ?
Pas tout à fait. Une sauvegarde est généralement une copie des données que l'on restaure après une panne, tandis que la redondance consiste en une capacité de réserve active qui continue à prendre en charge le trafic pendant une panne, avec peu ou pas d'interruption. La redondance vise à rester en ligne, et non à récupérer les données après coup.
Pourquoi utiliser plusieurs clients à nœuds multiples ?
La diversité des clients permet de se prémunir contre les bogues logiciels. Si un bogue critique survient dans l'implémentation d'un client, les nœuds exécutant un client différent continuent de fonctionner normalement ; ainsi, une seule version défectueuse ne met pas hors service l'ensemble de votre parc.
La redondance permet-elle d'éliminer complètement les temps d'arrêt ?
Aucun système n'atteint une disponibilité parfaite, mais la redondance à plusieurs niveaux permet de limiter la plupart des défaillances isolées à une simple dégradation des performances plutôt qu'à des pannes totales. L'objectif est d'éliminer les points de défaillance uniques afin qu'aucun événement isolé ne provoque la mise hors service de l'ensemble du système.
La redondance justifie-t-elle le surcoût ?
Pour les applications de production, c'est presque toujours le cas. La redondance entraîne un coût fixe et prévisible, tandis que les temps d'arrêt génèrent un coût variable pouvant atteindre plusieurs centaines de milliers de dollars en transactions manquées et en perte d'utilisateurs lors d'une seule panne survenant à une heure de pointe.
Comment « Quicknode » met en place la redondance dans
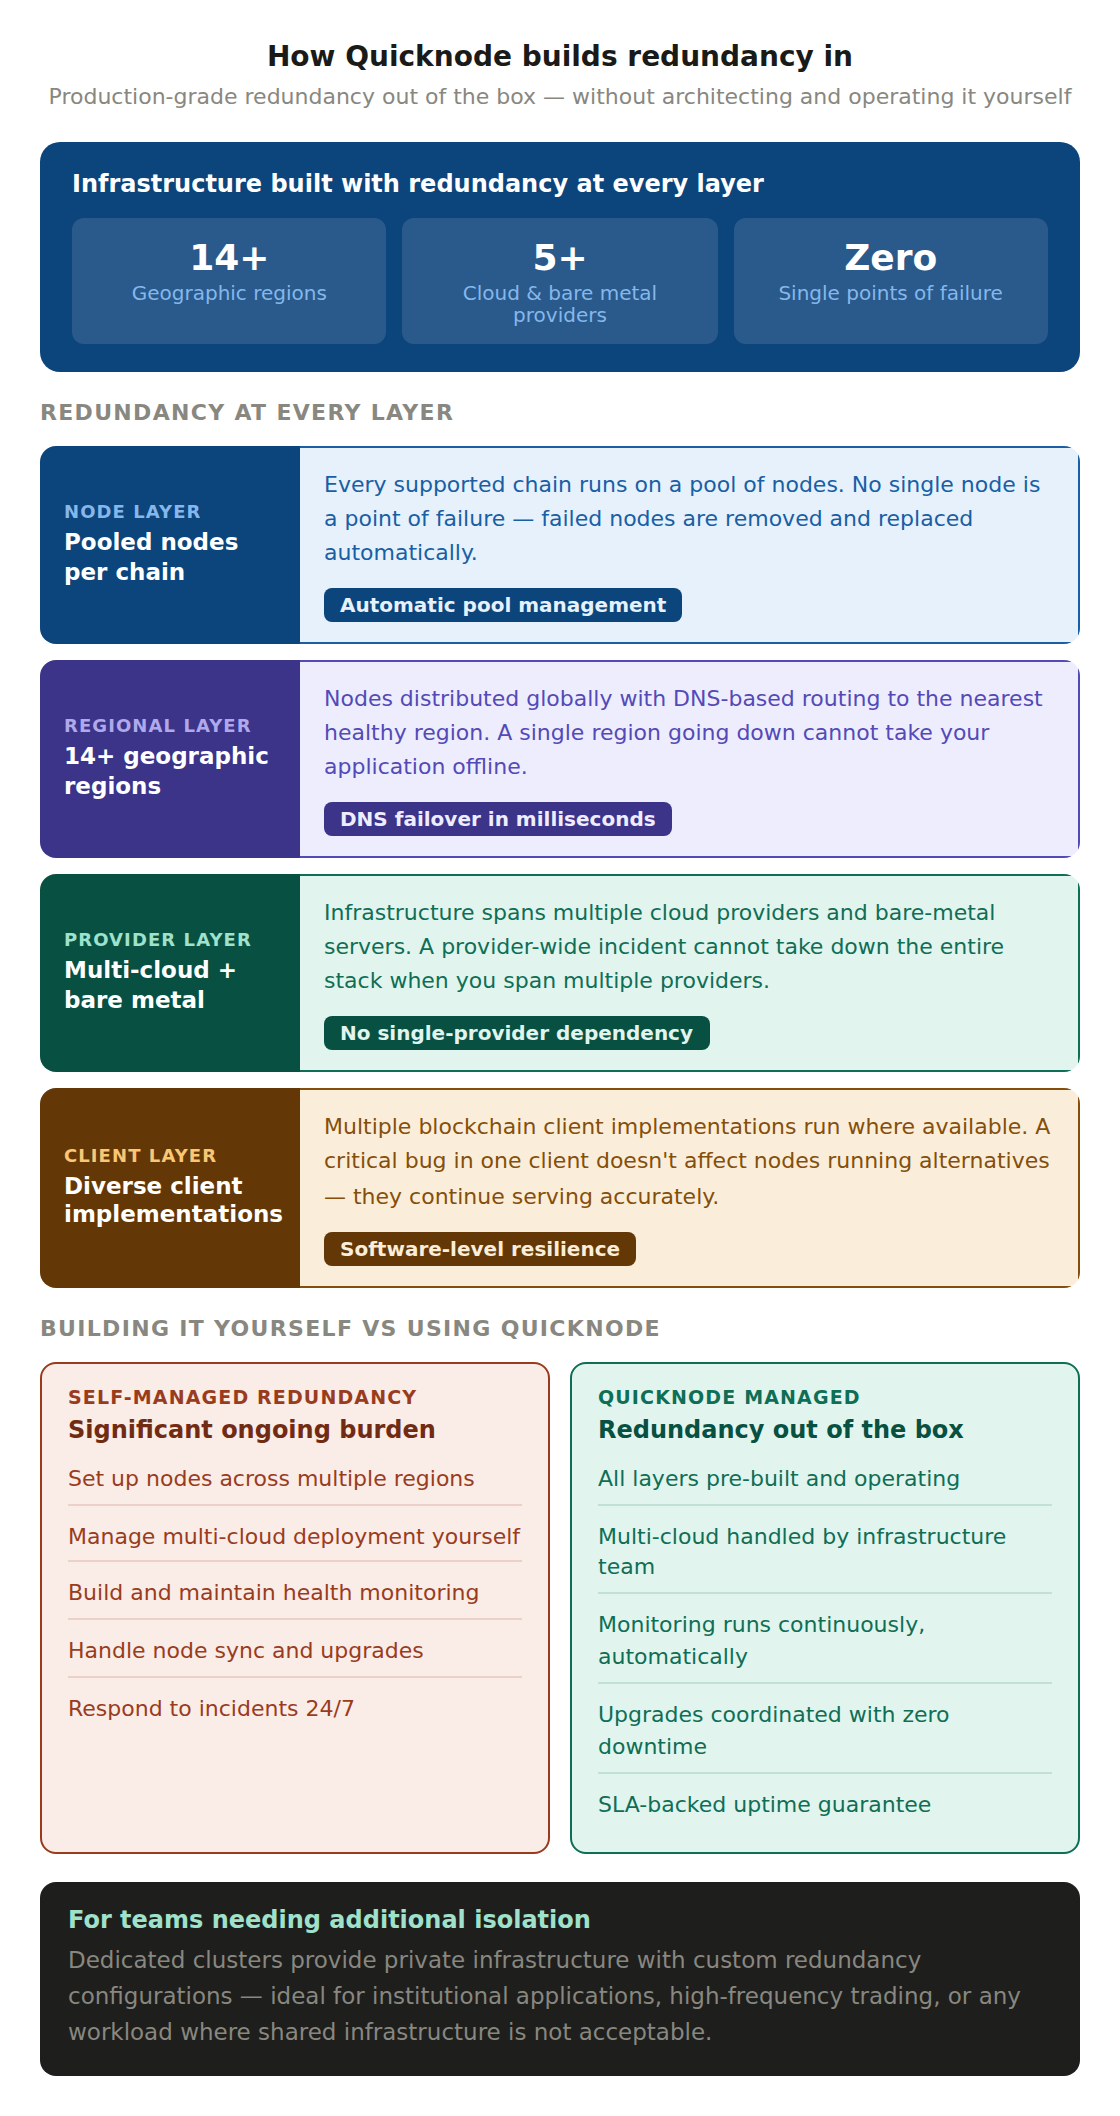
Quicknode exploite une infrastructure blockchain dans plus de 14 régions, auprès de plusieurs fournisseurs de services cloud et de serveurs physiques. Chaque chaîne prise en charge fonctionne sur un ensemble de nœuds utilisant diverses implémentations client, lorsque cela est possible. Le système est conçu de manière à ce qu’aucun nœud, aucune région ni aucun fournisseur de services cloud ne constitue un point de défaillance unique.
Les développeurs bénéficient ainsi d'une redondance de niveau production prête à l'emploi, sans avoir à la concevoir ni à la gérer eux-mêmes. Pour les équipes ayant besoin d'un niveau d'isolation supplémentaire, les services « clusters » dédiés proposent une infrastructure privée avec des configurations de redondance personnalisées.