Réponses>Découvrez les principes fondamentaux de la sécurité de la blockchain>Modes de défaillance courants de la blockchain
Modes de défaillance courants des chaînes de blocs
// Tags
défaillance de la blockchainattaques contre la blockchain
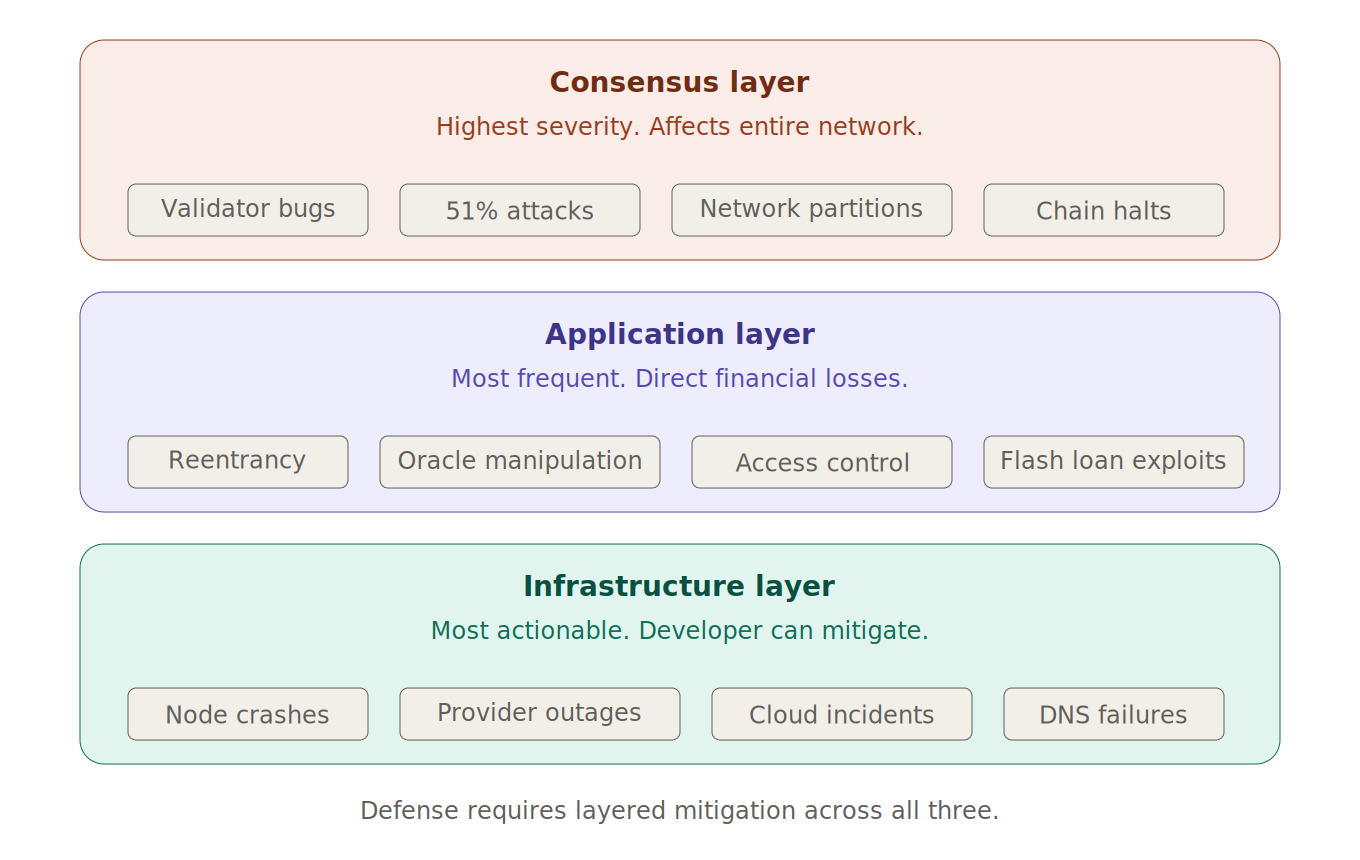
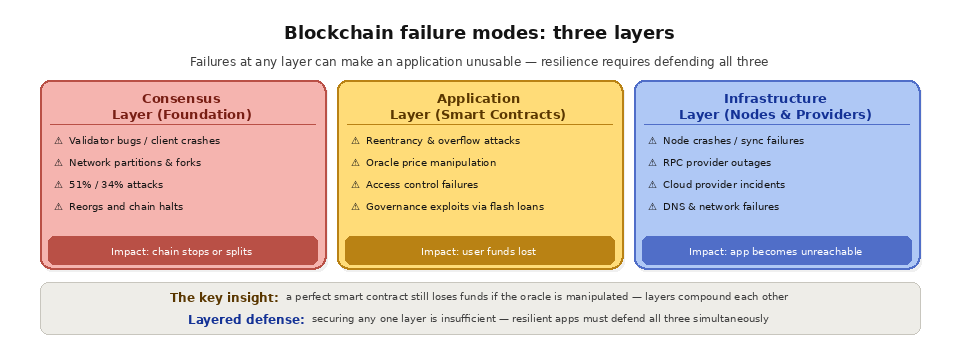
En bref : les blockchains peuvent connaître des défaillances à trois niveaux. Les défaillances au niveau du consensus comprennent les bogues des validateurs, les partitions de réseau et les attaques à 51 %. Les défaillances au niveau de l'application comprennent les bogues des contrats intelligents, la manipulation des oracles et les failles de gouvernance. Les défaillances au niveau de l'infrastructure comprennent les pannes de nœuds, les interruptions de service des fournisseurs et les incidents liés au cloud. Chaque niveau nécessite ses propres mesures de protection. Ces défaillances ont une importance particulière car les applications blockchain gèrent de l'argent réel ; une défaillance coûte donc bien plus cher que dans le cas d'un logiciel classique.
L'explication simple
Les blockchains sont souvent qualifiées de « sans tiers de confiance » et d’« immutable ». Cela ne signifie pas pour autant qu’elles ne peuvent pas tomber en panne. Comme tout système distribué complexe, une blockchain peut présenter des défaillances de multiples façons et à différents niveaux.
Le point essentiel pour les développeurs est que les défaillances s'accumulent par couches successives. Un contrat intelligent sécurisé peut tout de même entraîner la perte des fonds des utilisateurs si quelqu'un manipule l'oracle qui lui fournit des données. Une application bien conçue peut tout de même cesser de fonctionner si les nœuds sur lesquels elle repose tombent en panne.
Imaginez cela comme un immeuble. Les fondations (couche de consensus) pourraient se fissurer. La plomberie et l'électricité (couche applicative) pourraient présenter des fuites ou des courts-circuits. Le gestionnaire immobilier (couche d'infrastructure) pourrait faire faillite. Chaque défaillance nécessite un type de protection différent, et un système résilient offre une protection contre ces trois risques à la fois.
Défaillances de la couche de consensus
La couche de consensus constitue le fondement de toute blockchain. C'est grâce à elle que les validateurs s'accordent sur les transactions valides et sur les blocs à intégrer à la chaîne. En cas d'échec du consensus, les conséquences sont les plus graves de toutes les couches : la chaîne peut s'arrêter, se réorganiser ou produire des blocs contradictoires.
Les bogues des validateurs constituent l'une des causes les plus courantes de défaillance du consensus. Les logiciels clients de blockchain sont complexes. Un bogue dans la production de blocs, la logique d'attestation ou les transitions d'état peut amener les validateurs à produire des blocs invalides, à planter en cours de tour ou à ne pas s'accorder sur l'état correct.
Le risque augmente lorsqu'un client domine le réseau. Si 70 % des validateurs utilisent le même client et que celui-ci comporte un bug, 70 % du réseau tombe en panne d'un seul coup. C'est pourquoi la diversité des clients, c'est-à-dire l'existence de plusieurs implémentations indépendantes d'un même protocole, est si souvent évoquée dans le domaine de la sécurité des blockchains.
On parle de partition du réseau lorsque des groupes de validateurs ne parviennent plus à communiquer entre eux. Les causes les plus courantes sont les coupures d'Internet, les attaques DDoS ciblées et les défaillances de routage.
Si aucune des deux parties issues de la scission ne parvient à atteindre le seuil de consensus (généralement les deux tiers du poids mis en jeu), la production de blocs est interrompue.
Si les deux camps parviennent encore à atteindre le seuil, la chaîne se divise pendant un certain temps, et chaque camp produit ses propres blocs.
Lorsque la connexion au réseau est rétablie, une réorganisation permet de résoudre la bifurcation. Les transactions effectuées sur la branche la plus courte sont annulées.
Les attaques à 51 % (ou les attaques à 34 % sur les chaînes basées sur le protocole BFT) permettent à un attaquant disposant d'une majorité du pouvoir de consensus de réécrire l'historique récent. Voici comment cela fonctionne :
L'attaquant crée une chaîne privée qui se sépare de la chaîne publique.
La chaîne privée recueille davantage de preuves de travail ou d'attestations de validateurs que la chaîne publique.
L'attaquant le diffuse. Comme il a plus de poids, le réseau l'accepte et rejette les derniers blocs de la chaîne publique.
Cela permet la double dépense. L'attaquant envoie des fonds sur la chaîne publique et attend la confirmation. Il publie ensuite une chaîne privée qui ne prend pas en compte cette transaction. Il obtient ainsi les biens et conserve les fonds.
Défaillances au niveau de la couche application
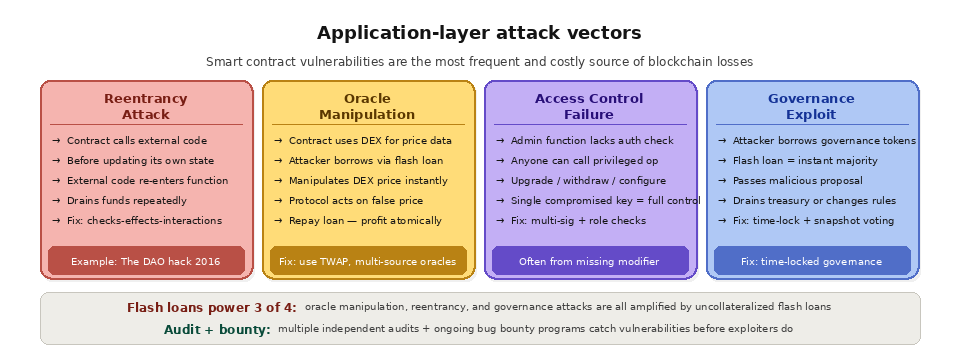
La couche applicative englobe les contrats intelligents, les protocoles DeFi, les oracles et la logique on-chain qui gère des milliards de dollars de fonds appartenant aux utilisateurs. C'est à ce niveau que les défaillances sont les plus fréquentes et les plus coûteuses.
Les attaques par réentrée ciblent un contrat qui appelle un autre contrat avant d'avoir mis à jour son propre état. Le contrat appelé peut « réentrer » dans le contrat d'origine et exécuter à nouveau la même fonction avant que la mise à jour ne soit effective, ce qui peut entraîner un détournement de fonds.
Le piratage du DAO en 2016 était une attaque par réentrance. Il a entraîné environ 60 millions de dollars de pertes et a conduit à la scission entre Ethereum et Ethereum Classic. Cette faille est bien connue depuis des années, mais elle réapparaît encore dans de nouveaux contrats qui ne respectent pas le modèle « vérifications-effets-interactions ».
Un débordement ou un sous-débordement d'entier se produit lorsqu'une opération mathématique génère un nombre dépassant la plage admissible de son type de données, ce qui entraîne un retour à la valeur initiale. Une soustraction qui devrait donner un résultat négatif pourrait au contraire renvoyer un nombre positif extrêmement élevé, permettant ainsi à un attaquant de réclamer plus de jetons qu'il n'en possède. La version 0.8.0 de Solidity a ajouté des vérifications intégrées qui annulent l'opération en cas de débordement. Les contrats créés avec des versions antérieures, ou qui utilisent des blocs mathématiques non vérifiés, restent toutefois exposés à ce risque.
Des failles de contrôle d'accès surviennent lorsque les fonctions d'administration ne vérifient pas l'identité de la personne qui les appelle. N'importe qui peut alors exécuter des fonctions réservées au propriétaire du contrat ou à un rôle spécifique. Exemples courants :
Des fonctions de mise à jour non protégées qui permettent à n'importe qui de modifier la logique du contrat
Fonctions de retrait sans vérification de la propriété
Un accès basé sur les rôles mal configuré
La manipulation des oracles est particulièrement dangereuse, car elle s'attaque au lien entre les données sur la chaîne et hors chaîne. Les contrats qui utilisent des oracles de prix pour les prêts, les liquidations ou les produits dérivés peuvent être amenés à agir sur la base d'un prix falsifié.
Les « flash loans » constituent l'outil le plus couramment utilisé. En une seule transaction atomique, le pirate :
Emprunte un grand nombre de jetons
Les utilise pour faire évoluer le cours sur un DEX dont l'oracle lit les données
Déclenche une action lucrative sur le protocole cible au faux prix
Rembourse le prêt
Le contrat en question a parfaitement rempli la fonction pour laquelle il avait été conçu. La faille résidait dans la conception de l'oracle, qui ne tenait pas compte des fluctuations de prix à court terme.
Les failles de gouvernance ciblent les systèmes de vote des DAO et des protocoles DeFi. Un attaquant se procure suffisamment de jetons de gouvernance, souvent grâce à un « flash loan », pour faire adopter une proposition malveillante. Cette proposition peut vider la trésorerie, modifier les paramètres du protocole afin de créer une faille, ou conférer à l'attaquant des droits d'administration.
Pannes au niveau de la couche d'infrastructure
Les défaillances d'infrastructure ne perturbent pas la blockchain elle-même. Elles empêchent les applications et les utilisateurs d'y accéder. Pour un développeur ou un utilisateur final, le résultat est identique à celui d'une défaillance de la chaîne : l'application cesse de fonctionner.
Les pannes de nœuds et les échecs de synchronisation mettent les nœuds hors ligne ou les amènent à fournir des données obsolètes. Un nœud qui accuse un retard de plusieurs blocs par rapport à la pointe de la chaîne renvoie d'anciens soldes, passe à côté des transactions récentes et peut rejeter des transactions valides qui dépendent de l'état récent du réseau. Une application qui repose sur un seul nœud sans basculement tombe en panne lorsque ce nœud cesse de fonctionner.
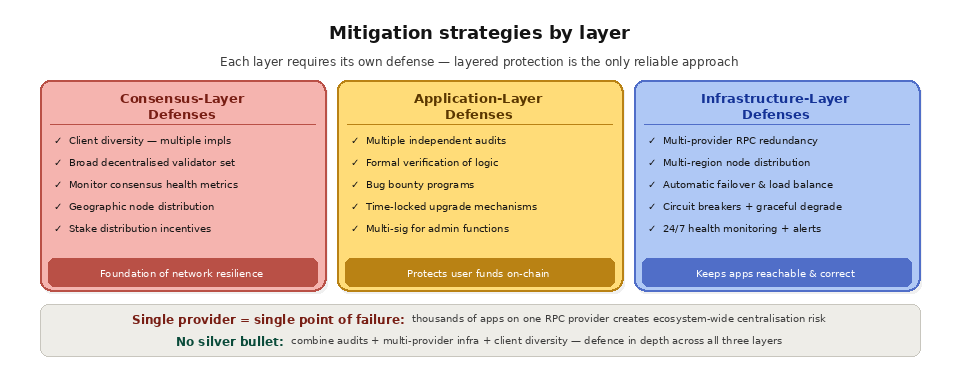
Les pannes d'un fournisseur touchent simultanément tous ses clients. Si un fournisseur RPC majeur tombe en panne, toutes les applications utilisant ses points de terminaison perdent l'accès à la chaîne. Il s'agit là d'un risque de centralisation au sein d'un système censé être décentralisé : lorsque des milliers d'applications partagent un même fournisseur, celui-ci devient un point de défaillance unique.
Les incidents chez les fournisseurs de cloud affectent les nœuds de blockchain comme n'importe quel autre service cloud. Lorsqu'AWS, GCP ou un autre fournisseur de cloud subit une panne régionale, tous les nœuds de cette région se retrouvent hors ligne. Une grande partie des nœuds de blockchain fonctionnant sur quelques fournisseurs de cloud, une seule panne de cloud peut nuire à la santé du réseau et à la disponibilité des applications bien plus que vous ne le pensez.
Les défaillances du DNS et du réseau peuvent empêcher les applications d'accéder à leurs points de terminaison RPC, même lorsque ceux-ci fonctionnent correctement. Le détournement de DNS, les problèmes de routage BGP et les problèmes liés aux certificats TLS peuvent tous interrompre la connexion entre une application et son infrastructure.
Stratégies d'atténuation
Pour se prémunir contre ces défaillances, il faut adopter une approche à plusieurs niveaux qui couvre ces trois aspects.
Au niveau de la couche de consensus, la diversité des clients constitue la défense la plus efficace. Grâce à l'existence de plusieurs implémentations de clients, un bug dans l'une d'entre elles ne met pas tout le réseau hors service. La répartition des participations joue également un rôle important : un ensemble de validateurs large et décentralisé réduit le risque de défaillances coordonnées et d'attaques à 51 %.
Au niveau de la couche applicative, les principaux moyens de défense sont les audits de sécurité, la vérification formelle et les programmes de prime aux bogues :
Faites vérifier les contrats intelligents par plusieurs cabinets indépendants avant leur déploiement.
Utilisez la vérification formelle pour prouver mathématiquement que le code est conforme à son cahier des charges. Elle permet de détecter les bogues que la vérification manuelle pourrait ne pas repérer.
Mettez en place des programmes de prime aux bogues qui rémunèrent les hackers « white hat » pour qu'ils identifient les failles et les signalent de manière responsable.
Les mises à jour sont soumises à un délai de validation afin que la communauté puisse examiner les modifications avant leur entrée en vigueur. Cela empêche les mises à jour malveillantes ou comportant des bogues d'être mises en ligne immédiatement.
Exiger une validation par signatures multiples pour les fonctions d'administration, afin qu'aucune clé volée ne puisse à elle seule exécuter des opérations privilégiées.
Au niveau de l'infrastructure, la redondance entre les fournisseurs, les régions et les clouds constitue la base. Ne vous fiez jamais à un seul fournisseur RPC, centre de données ou cloud.
Les disjoncteurs isolent les composants défaillants avant qu'ils ne provoquent la panne des systèmes qui en dépendent.
La dégradation gracieuse permet aux fonctionnalités essentielles, telles que l'affichage des soldes, de continuer à fonctionner même lorsque certains composants sont hors service.
Comment « Quicknode » renforce la résilience
QuicknodeL'infrastructure est conçue pour faire face aux défaillances au niveau de la couche infrastructure :
Répartition géographique dans plus de 14 régions et auprès de plus de 5 fournisseurs de services cloud et de serveurs physiques
Diversité de la clientèle, le cas échéant
Basculement automatique qui redirige les requêtes vers des nœuds autres que ceux qui présentent des problèmes
Surveillance 24 heures sur 24, 7 jours sur 7, assurée par une équipe dédiée aux opérations blockchain equipe
Quicknode Streams renforce la résilience des pipelines de données grâce à une livraison garantie, un traitement respectant l'ordre de finalité et une gestion automatique des réorganisations. Lorsqu'une réorganisation se produit, Streams détecte et corrige automatiquement les données concernées. Pour la surveillance au niveau de la couche applicative, Streams vous permet de surveiller des événements de contrat spécifiques, des schémas de transaction inhabituels et des changements d'état susceptibles d'indiquer une attaque en cours.
Quicknode Pour les équipes ayant des exigences très strictes en matière de disponibilité, les services Clusters Dedicated offrent une infrastructure isolée avec des accords de niveau de service (SLA) garantissant la disponibilité, distincte du trafic partagé. Les pics de trafic d'un autre client ne peuvent pas ralentir votre système, ce qui offre aux applications critiques l'isolation dont elles ont besoin.
Quels sont les types de défaillances les plus courants liés à la blockchain ?
Les failles ci-dessus sont regroupées en fonction de la couche dans laquelle elles apparaissent. La couche indique également qui est chargé d'assurer la protection contre chacune d'entre elles. Le tableau ci-dessous répertorie les failles les plus courantes, donne un exemple pour chacune d'entre elles et précise où se trouve la solution.
Couche
Panne courante
Exemple
Là où s'incarne la prévention
Consensus
Attaque à 51 % ou réorganisation
La majorité réécrit l'histoire récente
Protocole et ensemble de validateurs
Consensus
Partition du réseau ou arrêt
Les validateurs ne parviennent pas à atteindre le seuil
Protocole et diversité des clients
Demande
Réentrance ou manipulation d'oracle
Un « flash loan » épuise un fonds de prêt
Contrats intelligents et audits
Demande
Exploitation d'une faille de contrôle d'accès ou de gouvernance
Fonction d'administration non protégée
Contrat intelligent et signature multiple
Infrastructures
Panne d'un nœud ou interruption de service du fournisseur
L'endpoint RPC renvoie des données obsolètes
Infrastructure redondante
Comment détecter les défaillances de la blockchain avant qu'elles n'entraînent des pertes ?
La détection fait toute la différence entre un incident maîtrisé et une catastrophe. La surveillance continue de l'infrastructure blockchain permet de détecter en temps réel les retards des nœuds, les pics d'erreurs et les décalages de synchronisation. Une observabilité plus étendue relie ces signaux au comportement des applications, ce qui vous permet de repérer une faille de sécurité ou une panne avant même que les utilisateurs ne s'en rendent compte.
Quelle est la différence entre un « chain halt » et une « chain reorg » ?
Ces deux types de défaillance de consensus peuvent facilement être confondus. Un « chain halt » interrompt complètement la production de blocs, car les validateurs ne parviennent pas à atteindre le seuil de consensus ; aucune nouvelle transaction n’est donc confirmée. Une « réorganisation de la blockchain » continue de produire des blocs, mais remplace les blocs récents par ceux d’une chaîne concurrente. Cela peut annuler des transactions qui semblaient confirmées.
En quoi la redondance des infrastructures permet-elle de réduire le risque de panne ?
La plupart des pannes d'infrastructure sont dues à un point de défaillance unique. Une fois que l'on comprend pourquoi la redondance de l'infrastructure est essentielle, la conception s'impose d'elle-même : plusieurs fournisseurs et plusieurs zones géographiques, ainsi qu'un basculement automatique qui contourne un nœud défaillant avant que les requêtes ne commencent à échouer.
Foire aux questions
Quels sont les trois niveaux de défaillance de la blockchain ?
Les défaillances peuvent provenir de la couche de consensus (bogues des validateurs, partitions, attaques à 51 %), de la couche applicative (bogues des contrats intelligents, manipulation des oracles, failles de gouvernance) ou de la couche d'infrastructure (plantages de nœuds, pannes de fournisseurs et de services cloud). Les systèmes résilients offrent une protection contre ces trois types de défaillances.
Quelle est la cause la plus fréquente des pertes liées à la blockchain ?
Les défaillances au niveau de la couche applicative, notamment les vulnérabilités des contrats intelligents et la manipulation des oracles, sont les plus fréquentes et les plus coûteuses. La chaîne sous-jacente fonctionne souvent exactement comme prévu, tandis que la logique défectueuse d'un contrat ou d'un oracle est exploitée.
Une simple panne d'un fournisseur RPC peut-elle entraîner la mise hors service de mon application ?
Oui. Si votre application dépend d'un seul fournisseur, d'un seul centre de données ou d'une seule région cloud, toute panne survenant à ce niveau vous rendra inaccessible. La répartition du trafic entre plusieurs fournisseurs et régions redondants, associée à un basculement automatique, permet d'éliminer ce point de défaillance unique.
Une attaque à 51 % est-elle la même chose qu'une partition du réseau ?
Non. Une attaque à 51 % consiste en une tentative délibérée, menée par une majorité des participants au consensus, de réécrire l'historique, tandis qu'une partition du réseau correspond à une perte accidentelle de communication entre les validateurs. Ces deux phénomènes peuvent entraîner des réorganisations, mais leurs causes et les moyens de s'en prémunir diffèrent.
Comment se prémunir contre la manipulation d'oracles ?
Utilisez des oracles qui agrègent les prix provenant de différentes sources et sur différentes périodes, évitez de vous fier à un seul cours au comptant d'un DEX, et mettez en place des contrôles de cohérence et des mécanismes de coupure automatique. Ces mesures permettent de contrer les attaques par « flash loan » qui faussent brièvement un flux de prix.