Réponses>Découvrez les principes fondamentaux de la sécurité de la blockchain>Qu'est-ce qu'un « chain halt » ?
Qu'est-ce qu'un « chain halt » ?
// Tags
arrêt de la chaîneinterruption de la blockchain
En bref : un « chain halt » se produit lorsqu’une blockchain cesse complètement de produire de nouveaux blocs. Contrairement à la congestion, où le réseau ralentit mais continue de fonctionner, un « chain halt » signifie qu’aucune nouvelle transaction n’est confirmée et que le réseau est de fait paralysé. Les arrêts de chaîne sont causés par des défaillances du consensus, des bogues critiques au niveau des clients, des attaques DDoS contre les validateurs, l’épuisement des ressources ou des mises à jour qui ont échoué. Ils comptent parmi les incidents les plus graves qu’une blockchain puisse subir, car toutes les applications, tous les portefeuilles et tous les protocoles construits sur cette chaîne deviennent inutilisables jusqu’à ce que le réseau reprenne son fonctionnement. La reprise nécessite une action coordonnée de l’ensemble des validateurs, impliquant généralement l’identification de la cause première, le déploiement d’un correctif et le redémarrage du consensus.
L'explication simple
Un arrêt de la chaîne équivaut, dans le contexte de la blockchain, à une panne totale du serveur. Lorsqu’un serveur d’application web classique tombe en panne, personne ne peut accéder au service. Lorsqu’une blockchain s’arrête, personne ne peut envoyer de transactions, percevoir de rendements, clôturer des positions ni interagir avec aucun contrat intelligent du réseau. La chaîne cesse tout simplement d’avancer.
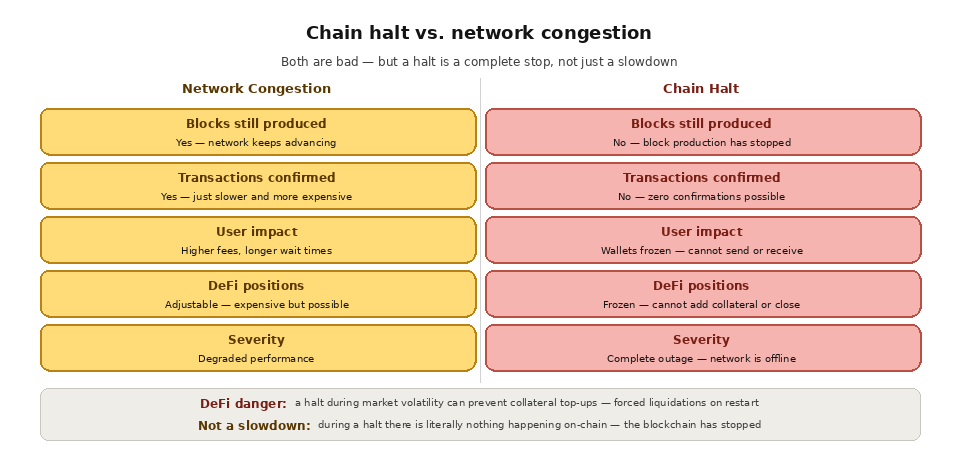
Il est important de faire la distinction entre une congestion et un arrêt. En cas de congestion, les blocs continuent d'être créés et les transactions continuent d'être confirmées, mais plus lentement et à un coût plus élevé. Les utilisateurs se disputent l'espace limité disponible dans les blocs, mais le réseau reste opérationnel. En cas d'arrêt de la chaîne, aucun bloc n'est créé. Le réseau est à l'arrêt. Les transactions restent dans le mempool sans aucune possibilité de confirmation jusqu'à ce que la chaîne reprenne son fonctionnement.
Pour les utilisateurs finaux, un arrêt de la chaîne signifie que les portefeuilles affichent les soldes mais ne permettent ni d'envoyer ni de recevoir de fonds. Les positions DeFi ne peuvent pas être ajustées, ce qui est particulièrement dangereux dans un contexte de volatilité des marchés, lorsque les utilisateurs pourraient avoir besoin d'ajouter des garanties ou de clôturer des positions à effet de levier. Les enchères de NFT sont gelées en cours de route. Les ponts cessent de traiter les transferts. Toutes les applications construites sur la chaîne sont, dans les faits, hors ligne.
Causes courantes des arrêts de chaîne
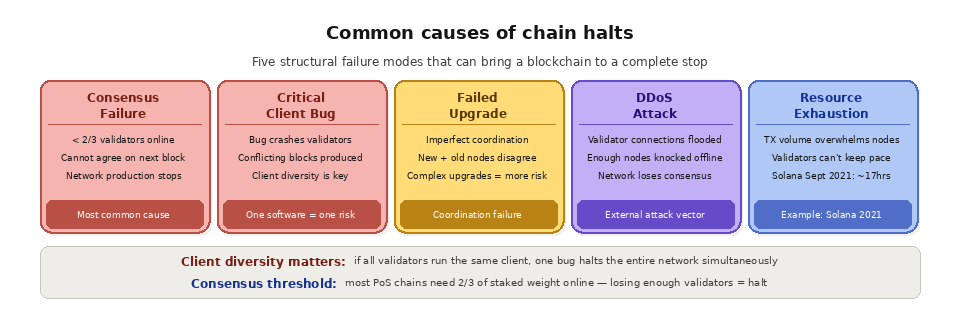
Les échecs de consensus constituent la cause la plus fréquente d'arrêt de la chaîne. Une blockchain produit de nouveaux blocs grâce à son mécanisme de consensus, qui exige qu'un seuil minimum de validateurs s'accorde sur le bloc suivant. Sur de nombreuses chaînes de type « Proof of Stake », ce seuil correspond aux deux tiers du poids des validateurs ayant mis des jetons en jeu. Si un nombre suffisant de validateurs se déconnectent, tombent en panne ou ne parviennent plus à communiquer entre eux, le réseau ne peut pas parvenir à un consensus et la production de blocs s'arrête.
Les bogues critiques au niveau des clients peuvent interrompre une chaîne si ces bogues provoquent le plantage des validateurs, la production de blocs invalides ou des divergences quant à l'état correct du réseau. Si un bogue dans l'implémentation dominante d'un client conduit la plupart des validateurs à produire des blocs contradictoires, le réseau peut entrer dans un état où aucun bloc ne reçoit suffisamment d'attestations pour être finalisé. Ce scénario souligne l'importance de la diversité des clients : si tous les validateurs utilisent le même logiciel, un seul bogue affecte simultanément l'ensemble du réseau.
Les mises à jour ratées constituent un autre facteur déclencheur courant. Les mises à jour du réseau exigent que les validateurs actualisent leur logiciel avant un bloc ou un moment précis. Si la mise à jour comporte un bug, ou si la coordination est imparfaite et que certains validateurs effectuent la mise à jour tandis que d’autres ne le font pas, la chaîne peut se scinder ou se bloquer. Le risque augmente avec la complexité de la mise à jour et le nombre de modifications déployées simultanément.
Les attaques DDoS visant les validateurs peuvent saturer leurs connexions réseau ou leur capacité de traitement, les empêchant ainsi de participer au consensus. Si un nombre suffisant de validateurs est mis hors ligne par une attaque coordonnée, la chaîne s'arrête jusqu'à ce que l'attaque cesse ou que les validateurs mettent en place des contre-mesures.
L'épuisement des ressources survient lorsque le volume des transactions ou la complexité des contrats intelligents dépasse la capacité de traitement du réseau, au point que les validateurs ne parviennent plus à suivre le rythme. C'est ce qu'a connu Solana en septembre 2021, lorsqu'un afflux d'activité générée par des bots a submergé les capacités de traitement des validateurs, entraînant finalement l'arrêt du réseau pendant environ 17 heures.
Le processus de rétablissement
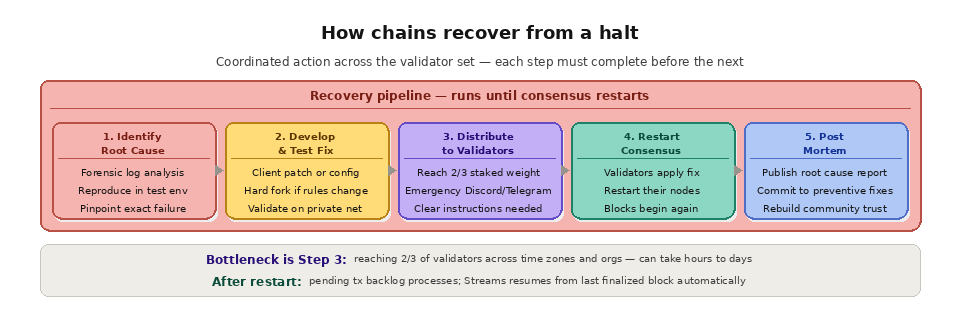
La reprise après un arrêt de la chaîne suit un schéma général, même si les détails varient selon la chaîne et la cause de l'arrêt.
Tout d'abord, l'equipe d'ingénierie permet d'identifier la cause première. Cela nécessite souvent une analyse approfondie des journaux des validateurs, de l'état du consensus et des conditions du réseau au moment de l'arrêt. En cas de bogues, il est essentiel de reproduire le problème dans un environnement de test avant de pouvoir déployer un correctif.
Deuxièmement, une solution est mise au point et testée. Selon la gravité et la nature du bug, cela peut prendre des heures, voire des jours. La solution peut prendre la forme d’un correctif logiciel côté client, d’une modification de configuration ou, dans les cas extrêmes, d’un « hard fork » modifiant les règles de consensus.
Troisièmement, la solution est transmise aux validateurs. C’est là que réside le défi de coordination. Les validateurs sont des opérateurs indépendants répartis dans différents fuseaux horaires et au sein de différentes organisations. Pour atteindre un nombre suffisant de validateurs afin de rétablir le consensus (généralement les deux tiers du poids mis en jeu), il faut disposer de canaux de communication, d’instructions claires et de patience. La plupart des chaînes disposent de canaux de communication d’urgence (Discord, Telegram ou des systèmes d’alerte dédiés) précisément à cette fin.
Quatrièmement, le consensus redémarre. Les validateurs appliquent le correctif, redémarrent leurs nœuds et recommencent à produire et à certifier des blocs. La chaîne reprend à partir du dernier bloc finalisé, et le traitement des transactions en attente commence.
Cinquièmement, une analyse rétrospective est menée. L'equipe d'ingénierie publie une analyse détaillée des défaillances survenues, des causes de celles-ci, des mesures prises pour y remédier et des changements qui seront mis en œuvre pour éviter qu'elles ne se reproduisent. Ces analyses rétrospectives sont essentielles pour préserver la confiance de la communauté et améliorer la résilience du réseau.
Quelle est la différence entre un « chain halt » et une congestion du réseau ?
Ces deux types de défaillance sont souvent confondus, mais leur gravité est très différente. La congestion signifie que le réseau est surchargé mais continue de produire des blocs, tandis qu’un arrêt signifie que la production de blocs a complètement cessé. Le tableau ci-dessous met en parallèle ces deux cas.
Que deviennent mes transactions en cas d'interruption de la chaîne ?
Les transactions en attente restent non confirmées dans le mempool, car aucun validateur ne peut les inclure dans un bloc. Elles ne sont pas perdues : une fois que la chaîne reprend son fonctionnement, le retard accumulé est traité, même si certaines transactions peuvent expirer ou devoir être soumises à nouveau avec des paramètres mis à jour. Comme aucun nouveau bloc n'est produit, aucune transaction n'atteint la finalité pendant l'arrêt ; les soldes semblent donc stables, même si une transaction apparaît comme étant en attente.
Lorsque le réseau redémarre, les validateurs convergent vers le dernier état canonique, ce qui peut impliquer une brève réorganisation le temps que les blocs concurrents soient résolus. Les applications doivent faire preuve de prudence pendant la période suivant immédiatement le redémarrage et attendre la finalité avant d'agir sur les transactions qui viennent d'être confirmées.
Combien de temps durent les arrêts de chaîne ?
La durée des interruptions de la chaîne a varié de moins d'une heure à presque une journée entière, selon la cause et la rapidité avec laquelle les validateurs ont pu coordonner une solution. Le tableau ci-dessous répertorie plusieurs interruptions largement médiatisées. Les durées sont approximatives et s'appuient sur les analyses rétrospectives rendues publiques.
Réseau
Quand
Durée approximative
Cause signalée
Solana
Septembre 2021
Environ 17 heures
Épuisement des ressources provoqué par les bots
Solana
Février 2024
Environ 5 heures
Bug dans un chargeur hérité
BNB Smart Chain
Octobre 2022
Environ 8 heures
Pause du validateur suite à une faille de sécurité dans le pont
Arbitrum
Janvier 2024
Environ 1 à 2 heures
Panne du séquenceur
Les interruptions dues à un bug clair et reproductible ont tendance à être résolues plus rapidement que celles qui nécessitent une analyse approfondie. Les réseaux dotés d'une planification rigoureuse en matière de gestion des pannes (mode ) et de procédures de redémarrage bien rodées se remettent le plus rapidement.
Comment les développeurs peuvent-ils protéger leurs applications contre les blocages en chaîne ?
Il est impossible d'empêcher un arrêt en chaîne, mais vous pouvez concevoir des applications capables de se dégrader en douceur et de se rétablir correctement. La base réside dans une conception axée sur la haute disponibilité. Le tableau ci-dessous résume les mesures de protection les plus efficaces.
Entraînement
Fonctionnalités
Avantage
Dégradation gracieuse
Afficher l'état mis en cache, les écritures en file d'attente
Les utilisateurs conservent une interface utilisateur fonctionnelle
Prise en charge multi-chaînes
Acheminer l'activité vers une chaîne active
Réduit la dépendance à une seule chaîne
Suivi de la santé
Suivre l'évolution de la hauteur des blocs de voie
Détecter un arrêt en quelques secondes
Redondance des fournisseurs
Basculement entre les points d'extrémité
Résiste aux problèmes liés aux nœuds et aux fournisseurs
Le basculement automatique garantit le bon fonctionnement du chemin de lecture lorsqu'un nœud ou un fournisseur subit une dégradation, tandis que Quicknode Streams resynchronise automatiquement votre pipeline de données dès que la production de blocs reprend.
Foire aux questions
Une interruption de la chaîne équivaut-elle à une panne de la blockchain ?
En effet, oui. Un « chain halt » signifie que le réseau a cessé de produire des blocs ; par conséquent, aucune transaction n'est validée et toutes les applications de cette chaîne deviennent inutilisables jusqu'à ce que les validateurs rétablissent le consensus. Les données sont intactes, mais le réseau est figé.
Peut-on perdre de l'argent lors d'un arrêt de la chaîne de blocs ?
Les fonds présents sur la chaîne ne sont pas perdus, mais vous pouvez subir des pertes indirectes, notamment dans le domaine de la DeFi. Si vous ne parvenez pas à ajouter des garanties ou à clôturer une position à effet de levier pendant une interruption, vous risquez une liquidation ou une évolution défavorable des cours dès la reprise de la chaîne et la mise à jour des cours.
Quelles chaînes de blocs ont connu des interruptions de fonctionnement ?
Plusieurs réseaux à haut débit ont connu au moins un arrêt, notamment Solana, BNB Smart Chain, Polygon, ainsi que certains rollups de couche 2 en raison de pannes de séquenceurs. Les arrêts sont plus fréquents sur les chaînes récentes ou hautement optimisées qui repoussent les limites de performance.
Comment répare-t-on une rupture de chaîne ?
Les ingénieurs identifient la cause première, développent et testent une solution, la diffusent aux validateurs, puis coordonnent un redémarrage dès qu'une part suffisante de la mise en jeu est à nouveau en ligne. La chaîne reprend alors à partir du dernier bloc finalisé et traite le retard accumulé.
Un arrêt de chaîne entraîne-t-il une réorganisation ?
C'est possible. Lorsque les validateurs redémarrent, ils doivent converger vers une seule chaîne canonique, ce qui entraîne parfois la suppression des blocs concurrents générés near l'arrêt du système. Attendre la finalité après un redémarrage protège votre application contre toute utilisation de données qui seraient supprimées lors de la réorganisation de la chaîne.
Comment « Quicknode » gère les arrêts en chaîne
QuicknodeL'equipe d'infrastructure de Quicknode surveille 24 heures sur 24 et 7 jours sur 7 l'état de santé et le statut de production des blocs de chaque chaîne prise en charge. En cas d'arrêt d'une chaîne, les systèmes de le détectent immédiatement et communiquent des mises à jour de statut aux clients concernés. L' de surveillance suit l'évolution de la hauteur des blocs, les taux de participation des validateurs et les indicateurs de santé du consensus, fournissant ainsi une alerte précoce en cas d'arrêts potentiels avant qu'ils n'aient un impact sur la production des blocs.
Lors d'un arrêt de la chaîne, les points de terminaison RPC de Quicknode continuent de fournir des données historiques et de répondre aux requêtes de lecture portant sur le dernier état confirmé. Les opérations d'écriture (soumissions de transactions) échoueront naturellement ou seront mises en file d'attente jusqu'à la reprise de la chaîne, mais les applications peuvent toujours consulter les soldes, l'état des contrats et les données historiques antérieures à l'arrêt. Lorsque la chaîne reprend, Quicknode Streams reprend automatiquement à partir du dernier bloc traité et transmet tous les nouveaux blocs produits pendant et après la reprise, garantissant ainsi que votre pipeline de données reste synchronisé avec la chaîne canonique sans intervention manuelle. La gestion intégrée des réorganisations dans Streams est particulièrement utile lors des redémarrages de la chaîne, qui peuvent impliquer des bifurcations temporaires pendant que les validateurs convergent vers l’état correct de la chaîne.