🤖 新着:Quicknode AIクックブック AIプログラミングの10の実証済みレシピ エージェント.
レシピを見る SOC 2 タイプ II 認証取得・ISO 27001
回答>スケーラビリティとパフォーマンスについて学ぶ>ブロックチェーン の動作が遅くなる理由 // Tags
ブロックチェーン 遅いブロックチェーン パフォーマンスの低下
要約: ブロックチェーン は、ブロックスペースへの需要がネットワークの処理能力を上回ると、処理速度が低下します。最も一般的な原因としては、ネットワークの輻輳(限られたブロック容量を争うトランザクションが多すぎる)、ステート肥大化(各ブロックの処理にかかる計算コストを増大させるストレージ要件の増加)、コンセンサスのオーバーヘッド(バリデーター数に比例して増加する通信コスト)、およびインフラの制限(低速なノード、高遅延のRPCエンドポイント、非効率なデータパイプライン)が挙げられます。 処理速度の低下は、確認時間の長期化、手数料の高騰、アプリケーション内のデータの古さ、ユーザー 体験の低下といった形で現れます。原因の中にはブロックチェーン の設計に内在するものもありますが、インフラの改善によって軽減できるものもあります。
わかりやすい説明
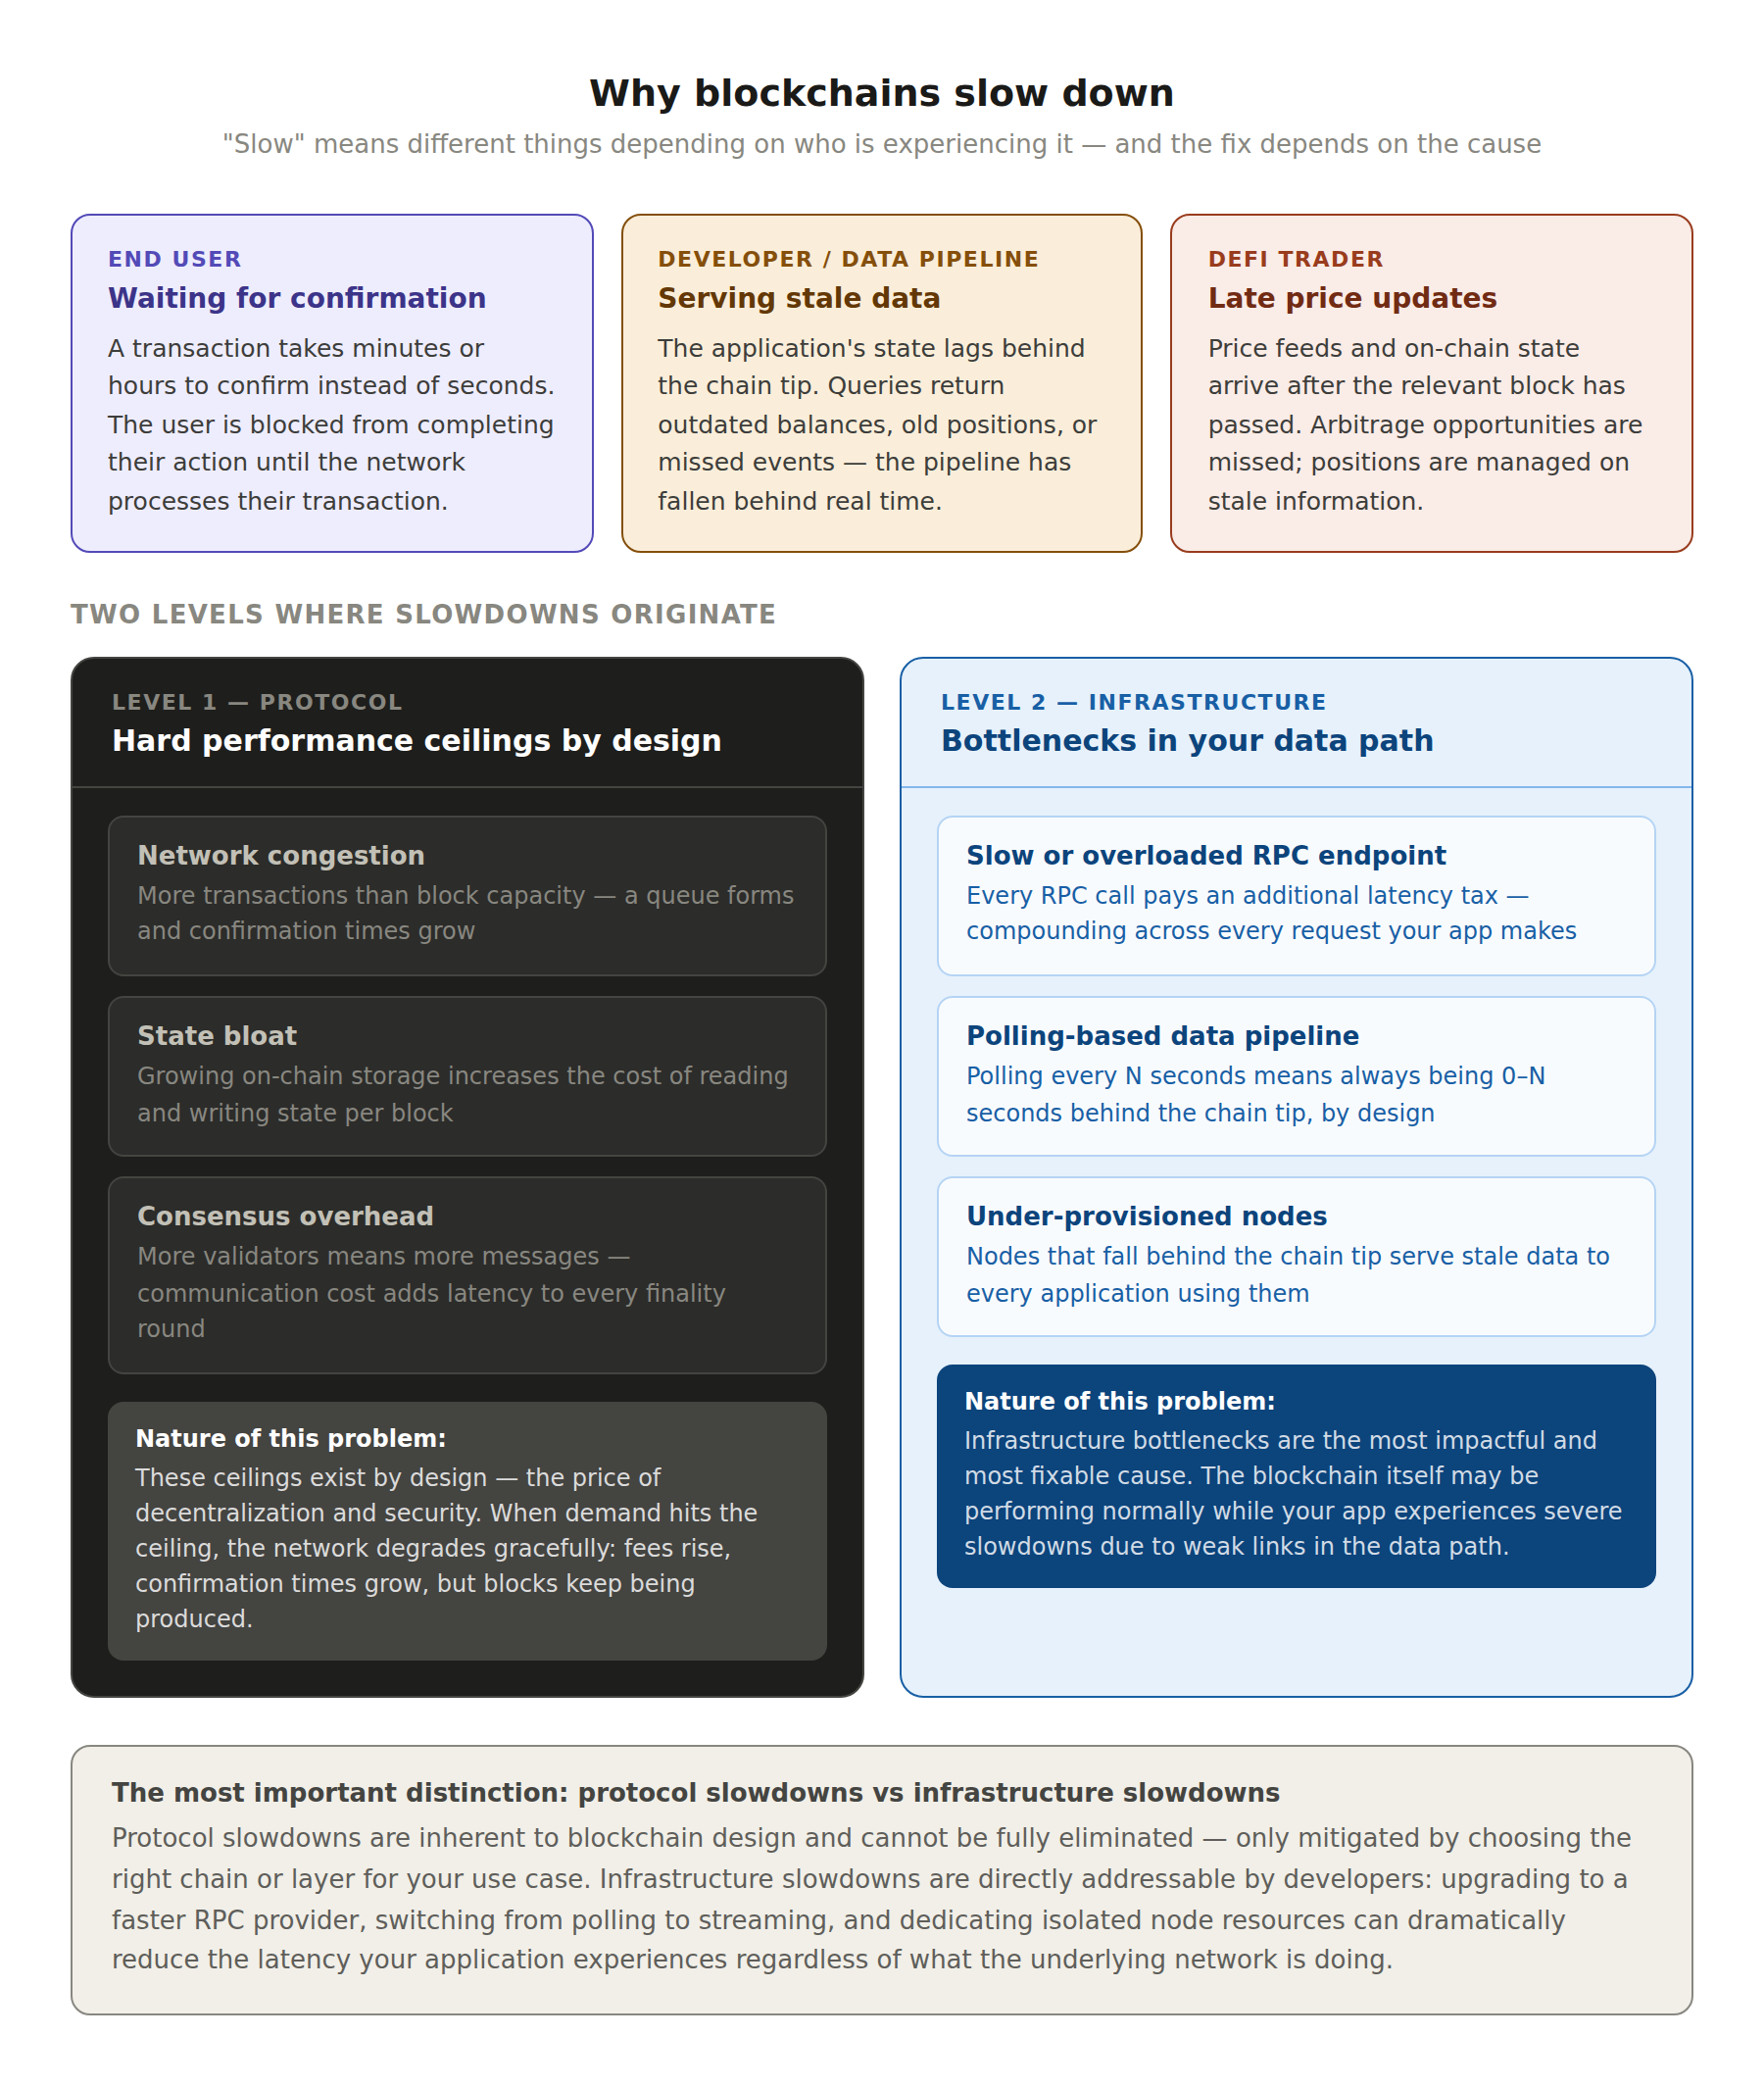
「遅い」という言葉の意味は、誰が問うかによって異なります。トランザクションを送信するエンドユーザー にとっては、「遅い」とは、確認に数秒ではなく数分あるいは数時間待たされることを意味します。データパイプラインを運用する開発者にとっては、「遅い」とは、チェーンの先端に追いつけず、古いデータを提供してしまうことを意味します。DeFiトレーダーにとっては、「遅い」とは、価格の更新情報が遅れて届き、裁定取引の機会を逃してしまうことを意味します。遅延の種類ごとに、根本的な原因も解決策も異なります。
プロトコルレベルにおいて、ブロックチェーン には、by のコンセンサスメカニズム、ブロックパラメータ、および実行環境によって決定される、厳格なパフォーマンスの上限が存在します。これらの上限はby 設計上のものであり、by 偶然に生じたものではありません。これらは分散化とセキュリティの代償なのです。需要がこれらの上限に達しても、ネットワークはダウンすることはありません。代わりに、by 手数料の引き上げ(価値の低い取引を排除)や確認時間の延長(ユーザー 待ち時間の増加)を通じて、段階的にパフォーマンスが低下していきます。しかし、ユーザー の視点から見れば、「段階的なパフォーマンス低下」であっても、やはり遅く感じられるものです。
インフラストラクチャのレベルでは、ブロックチェーン 自体は正常に動作しているかもしれませんが、アプリケーションが とやり取りするために使用しているツールがボトルネックになっている可能性があります。処理が遅い、あるいは過負荷状態のRPCは エンドポイント は、すべてのリクエストにレイテンシをもたらします。ポーリングベースのデータパイプラインは、ブロックの生成とデータの利用可能になるまでの間に遅延を生じさせます。リソースが不足しているノードは、チェーンの末端に遅れをとってしまいます。こうしたインフラストラクチャレベルの速度低下は、プロトコルレベルのそれよりも影響が大きく(かつ修正しやすい)場合がしばしばあります。
ネットワークの輻輳 | 需要がブロック容量を上回っているため、手数料と待ち時間が上昇している | ユーザー (料金)およびアプリのデザイン |
国家の肥大化 | ブロック数が増えるにつれて、各ブロックの処理コストが上昇する | プロトコルとコア開発者 |
コンセンサスにかかるオーバーヘッド | バリデーターとの通信には、避けられない遅延が生じます | プロトコルの設計 |
インフラのボトルネック | RPCの処理速度の遅さ、ポーリング、および遠隔ノードが遅延の原因となる | 開発者, 直接 |
ネットワークの輻輳
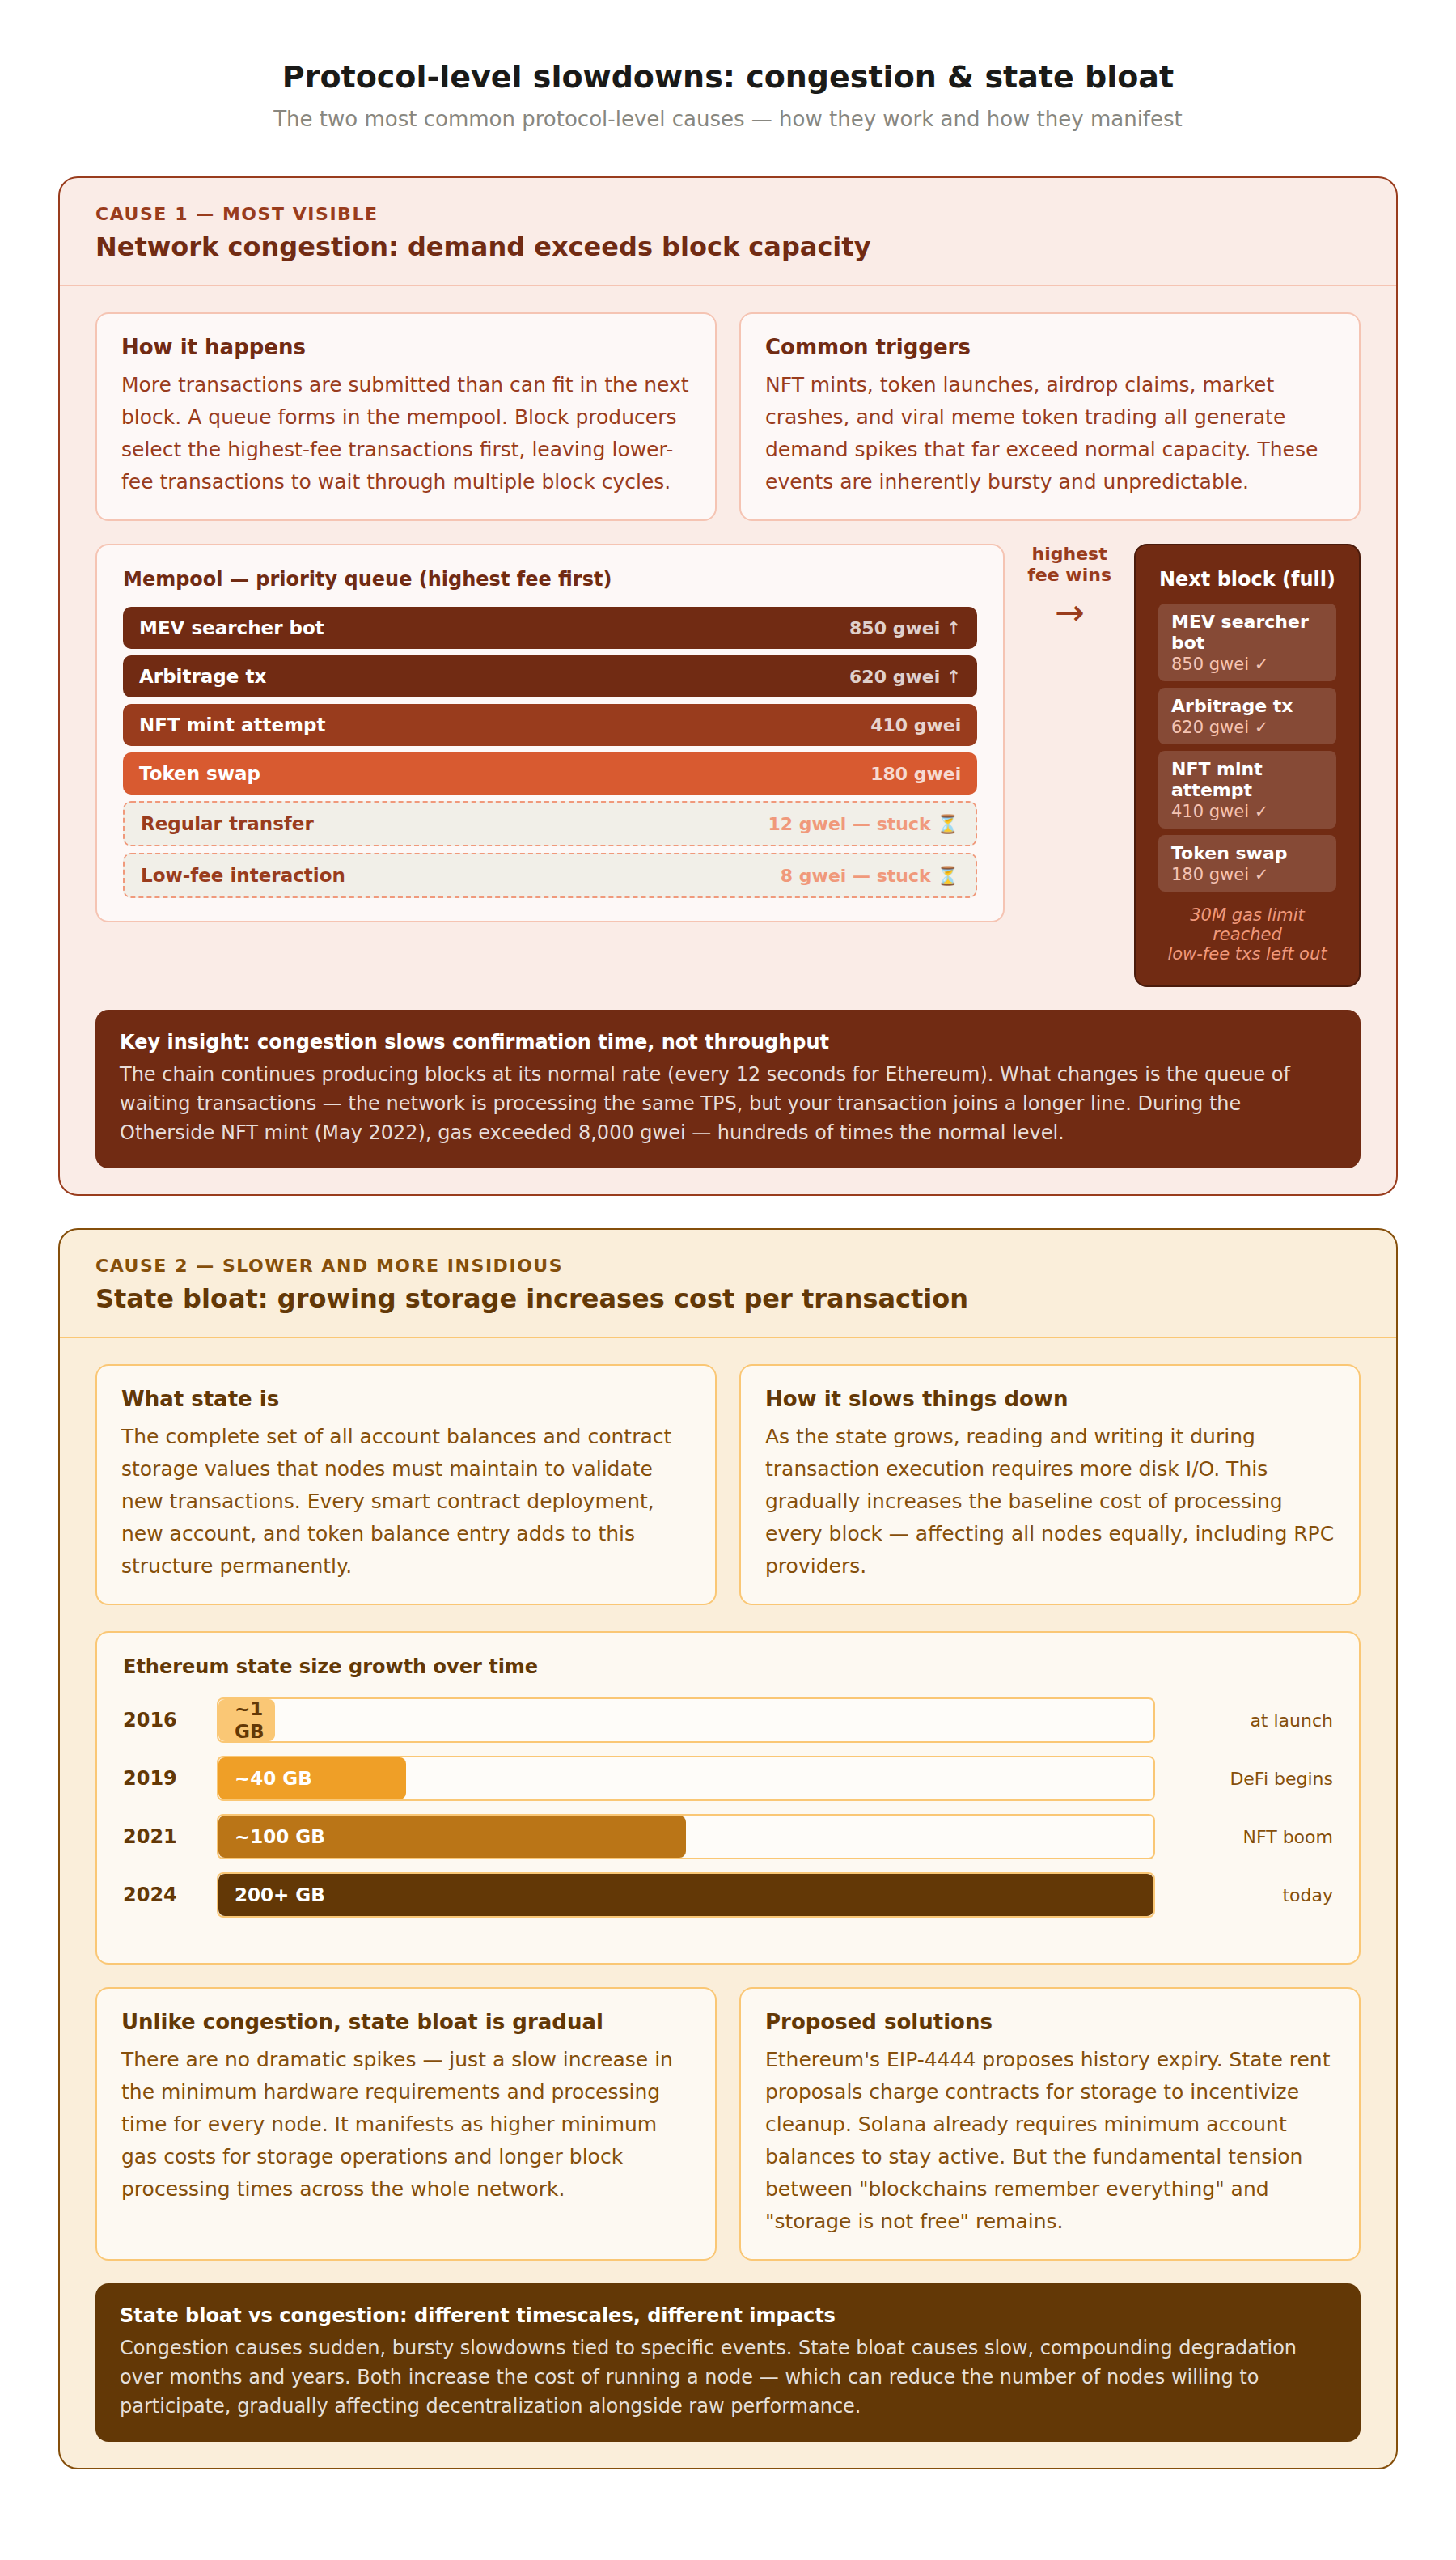
ネットワークの混雑は、ブロックチェーン の処理速度低下の最も一般的かつ顕著な原因です。次のブロックに収まりきらないほどの取引が送信されると、メンプールに未処理の取引が蓄積されます。ブロック生成者は手数料の高い取引を優先して選択するため、手数料の低い取引は待機状態となります。深刻な混雑時には、メンプールに数十万件もの未処理取引が蓄積され、確認にかかる時間が数秒から数時間に及ぶこともあります。
ネットワークの混雑は本質的にバースト性を持っています。 通常、人気のあるブロックチェーン は処理能力の限界をはるかに下回る水準で稼働しており、トランザクションは低コストで迅速に確定します。しかし、特定のイベントが発生すると需要が急増し、ネットワークがパンクしてしまうことがあります。NFTのミント、トークンのローンチ、エアドロップの受け取り、市場の暴落、そしてバイラルなミームトークン取引 などはすべて、通常レベルをはるかに超えるトランザクションの急増を引き起こします。2022年5月のYuga Labsによる「Otherside」ミントの際、Ethereum のガス価格は8,000 gweiを超え、通常レベルの数百倍に達しました。
重要なポイントは、輻輳によって個々のトランザクションの確認に時間がかかるようになるものの、ネットワークのスループット自体は低下しないということです。チェーンは通常通りのレート(Ethereum では12秒ごと、Solana では400ミリ秒ごと)でブロックを生成し続けます。変化するのは、トランザクションがブロックに組み込まれるまでの待ち時間です。ネットワークが1秒あたりに処理するトランザクションの数は変わらず、増加するのは待機中のトランザクションのキューの長さだけです。
国家の肥大化
ステートの肥大化は、ブロックチェーン の性能低下を引き起こす、より緩やかで、より潜行的な要因です。スマートコントラクトのデプロイ、新規アカウントの作成、トークン残高の登録が行われるたびに、ブロックチェーン のステートが増加します。このステートとは、ノードが新しいトランザクションを検証するためにメモリまたはディスク上で維持しなければならない、現在のすべてのアカウント残高およびコントラクトのストレージ値の集合のことです。ステートが大きくなるにつれて、トランザクションの実行中にステートを読み書きするための計算コストが増加します。
Ethereum では、ステートトライがリリース当初のほぼゼロから、数百ギガバイトにまで膨れ上がりました。 ステートを読み書きするすべてのトランザクションは、このデータ構造を通過する必要があり、そのサイズが大きくなるほど、各操作に必要なディスクI/Oも増えます。これは、by のRPCプロバイダーによって操作されるノードを含め、すべてのノードに等しく影響を及ぼします。ステートの肥大化は、輻輳のように劇的で突然の速度低下を引き起こすことはありません。その代わりに、すべてのブロックを処理するための基本コストを徐々に増加させ、その結果、ブロック処理時間のわずかな延長、ステートアクセス操作の最低ガスコストの上昇、およびノードを実行するためのハードウェア要件の増加として現れる可能性があります。
いくつかのチェーンでは、ステート管理ソリューションが導入されたり、提案されたりしています。Ethereum の EIP-4444 では、履歴の有効期限設定(フルノードから古いブロックデータを削除すること)が提案されています。ステートレンタル案では、契約が消費するストレージに対して料金を課すことで、クリーンアップを促進しようとしています。Solana のアカウントレンタルシステムでは、アカウントを有効に維持するためにすでに最低残高が求められています。これらのアプローチはステートの肥大化を管理しようとするものですが、「ブロックチェーン はすべてを記憶する」という考え方と「ストレージは無料ではない」という現実との間の根本的な矛盾は依然として残っています。
コンセンサス・オーバーヘッド
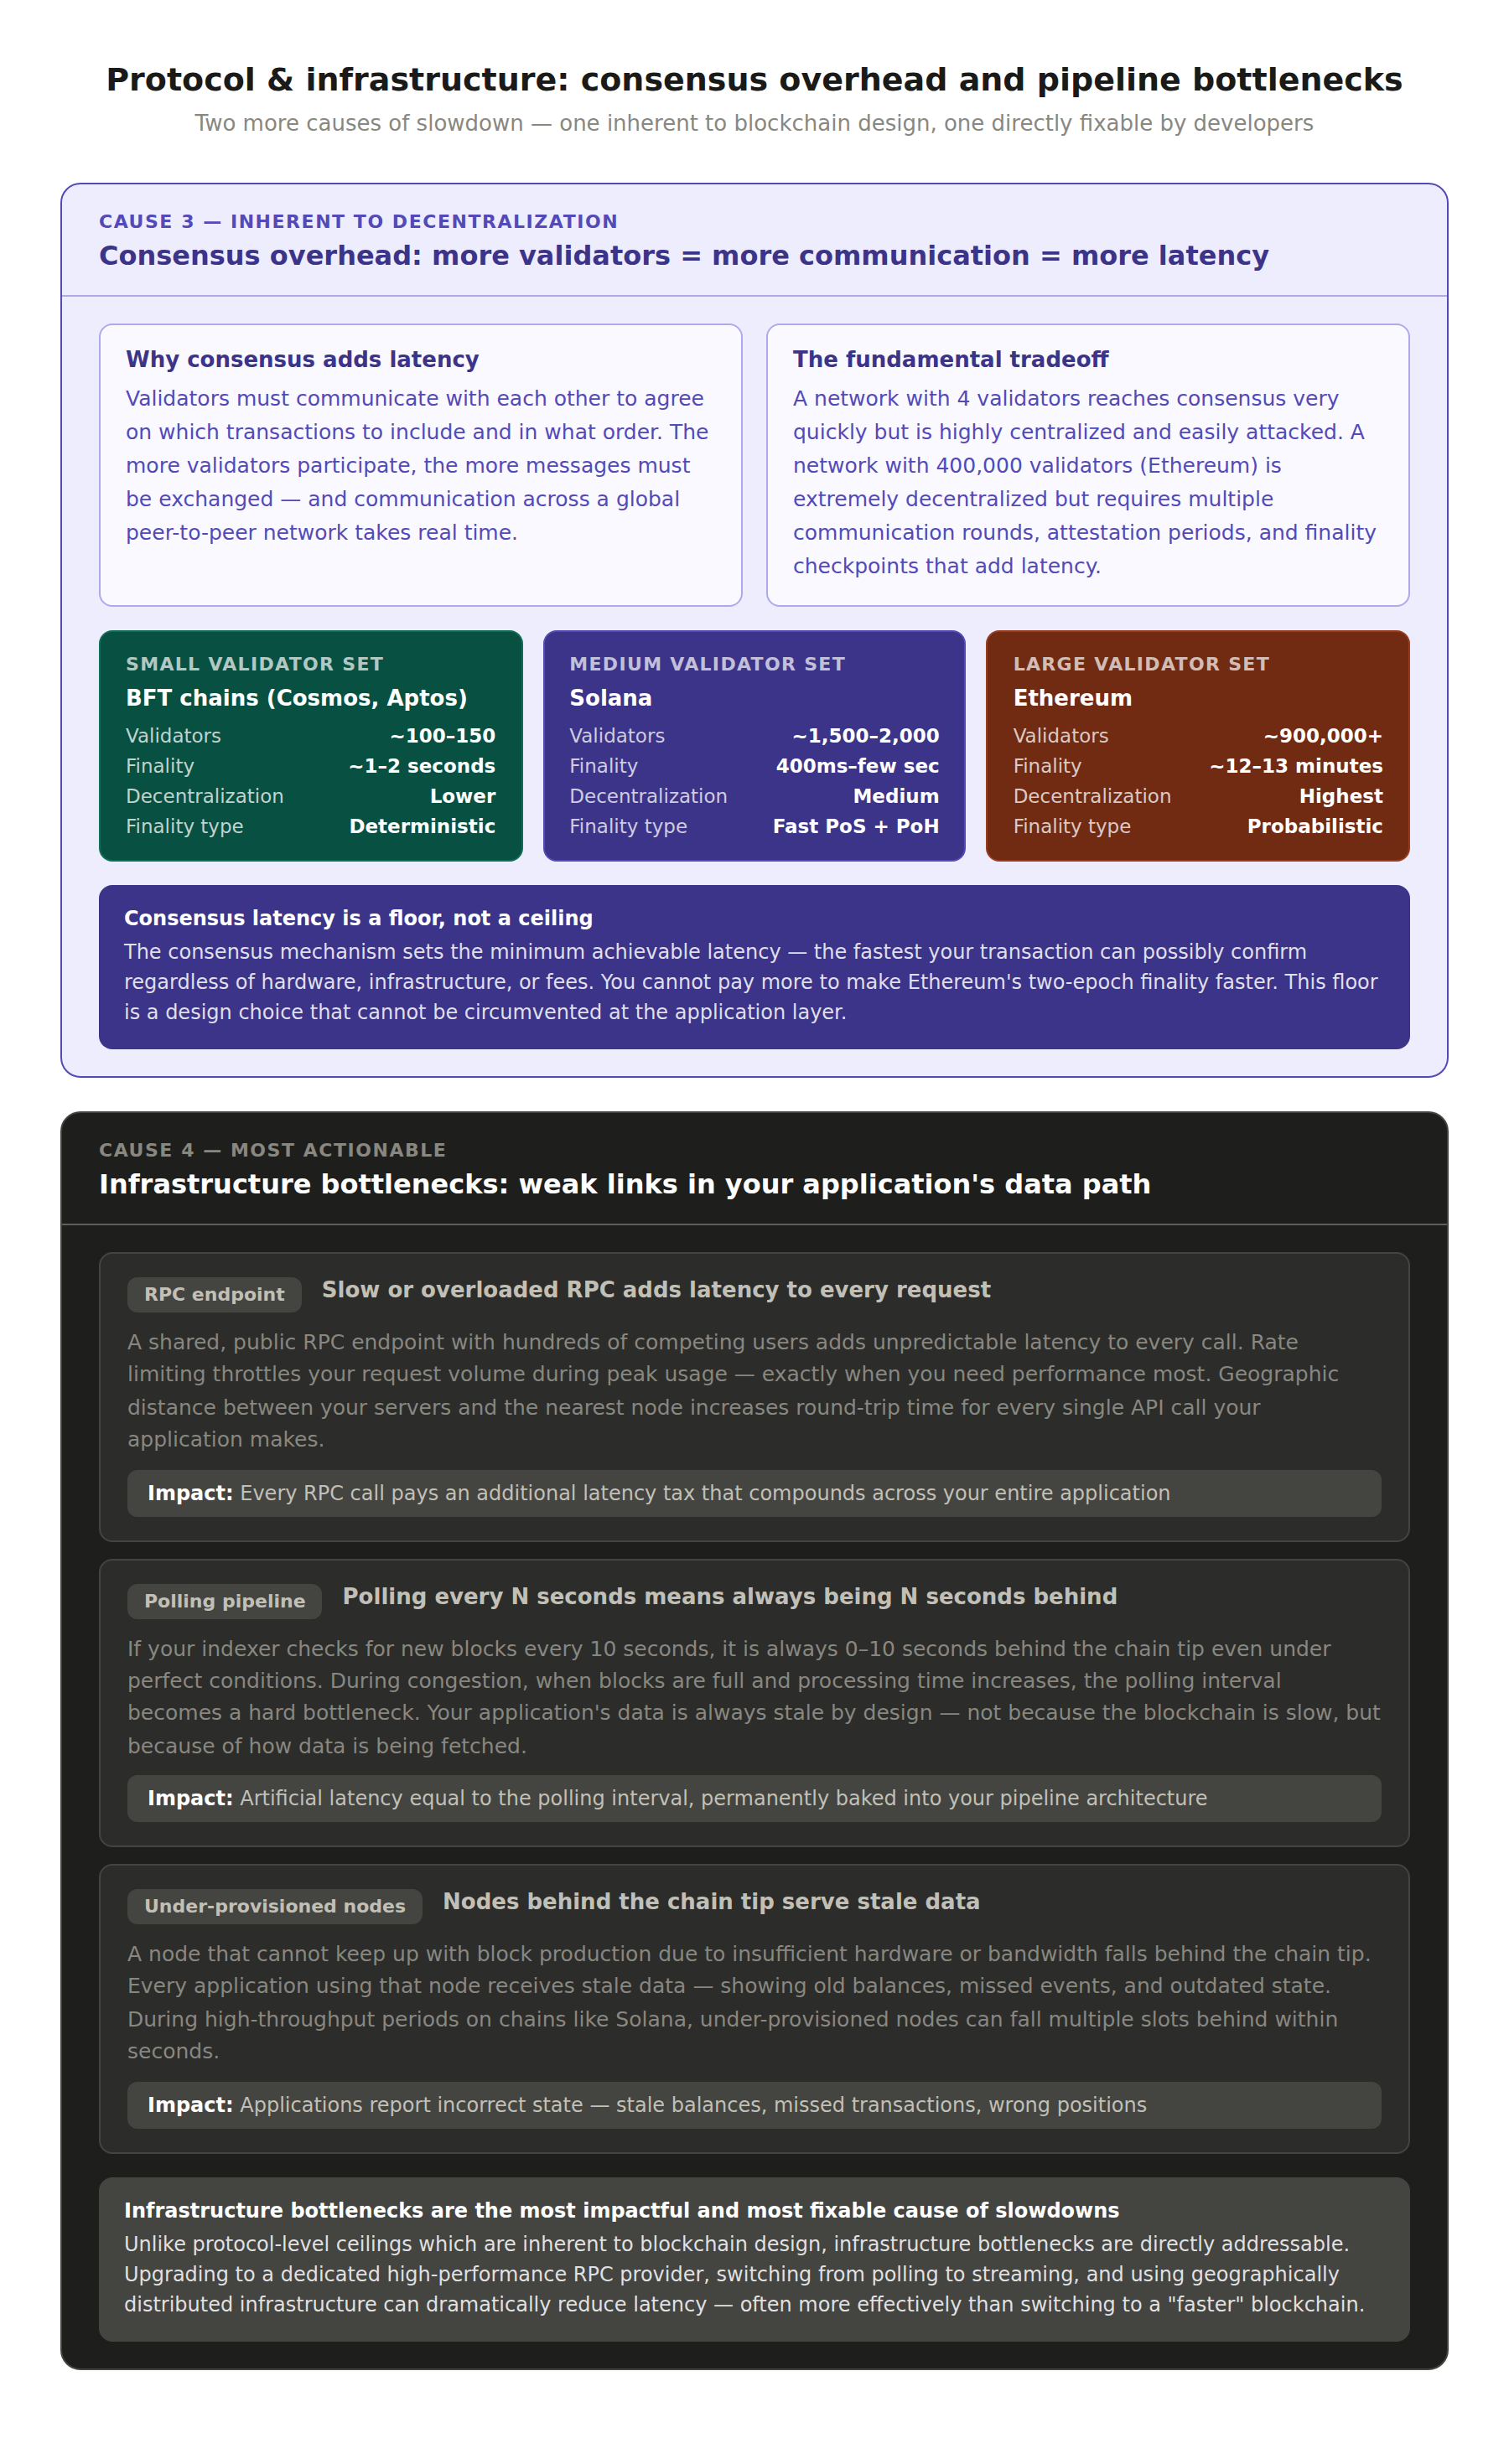
コンセンサスメカニズムとは、by に示されているように、バリデーターが次のブロックにどのトランザクションをどの順序で含めるかについて合意するプロセスです。このプロセスでは、バリデーター同士が通信を行う必要があり、通信には時間がかかるため、本質的に遅延が生じます。コンセンサスに参加するバリデーターの数が増えるほど、交換されるメッセージの量も増え、コンセンサスに要する時間も長くなります。
これは、「ブロックチェーン 」の三難題の一側面です。バリデーターが4人しかいないネットワークは、非常に迅速にコンセンサスに達することができます(レイテンシが低い)が、高度に中央集権化されています。一方、バリデーターが40万人いるネットワーク(Ethereum など)は、強力な分散性を備えていますが、複数の通信ラウンド、アテステーション期間、ファイナリティチェックポイントを含む高度なコンセンサスプロトコルを必要とし、ブロックの組み込みからファイナリティに至るまでに数分のレイテンシが発生します。
一部のブロックチェーンでは、リーダーベースのコンセンサスを採用しています。これは、1人のバリデーターがブロックを提案し、他のバリデーターがそれを検証する仕組みで、通信のオーバーヘッドを削減できる反面、遅延の単一障害点(リーダー)が生じます。 一方、他のブロックチェーンでは、ランダムに選ばれたバリデーターのサブセットが各スロットのコンセンサスを処理する「委員会型コンセンサス」を採用しており、分散性と処理速度のバランスを取っています。コンセンサスメカニズムの選択は、ネットワークの「ベースライン遅延の下限」を直接決定します。これは、基盤となるハードウェアがどれほど高速であっても短縮できない、トランザクションの送信からファイナリティに至るまでの最短時間を指します。
インフラのボトルネック
開発者 のほとんどにとって、日常的に経験する処理の遅延は、プロトコルレベルの問題ではなく、インフラストラクチャレベルの問題です。アプリケーションの体感速度(ブロックチェーン )は、データパスにおける最も弱い部分、つまりRPCby エンドポイント 、データベースにデータを供給するデータパイプライン、そして生のブロックチェーン データをアプリケーションの状態に変換する処理ロジックなど、データパスにおける最も弱い部分によって決定されます。
共有のパブリック RPC エンドポイント では、他の何百ものユーザー が処理能力を奪い合うため、すべてのリクエストに予測不可能な遅延が生じます。レート制限により、利用がピークに達した際、つまり最も必要とされるまさにその瞬間に、リクエスト量が抑制されてしまいます。アプリケーションサーバーと最寄りのノードとの地理的な距離が離れていると、すべての呼び出しにおける往復時間が長くなります。リソースが不足しているノードがチェーンの末端に遅れをとると、古いデータが提供され、アプリケーションの状態が実際の状況より遅れてしまいます。
ポーリングベースのデータパイプラインでは、ポーリング間隔に相当する人為的な遅延が生じます。インデクサーが10秒ごとに新しいブロックの有無を確認する場合、たとえ理想的な条件下であっても、常にチェーンの先端から0~10秒遅れてしまいます。混雑時、つまりブロックが満杯になり処理時間が長引く状況では、このポーリング間隔がボトルネックとなり、アプリケーションが処理に追いつけなくなる原因となります。
こうしたインフラのボトルネックは、ブロックチェーン の動作遅延の最も具体的な原因です。なぜなら、これらは開発者 が直接対処できる問題だからです。専用の高性能RPCプロバイダーにアップグレードすることで、 エンドポイント レイテンシを低減します。ポーリングからストリーミングへの切り替えにより、人為的なパイプラインの遅延が解消されます。地理的に分散されたインフラストラクチャを使用することで、往復時間が短縮されます。隔離されたノードリソースを専用化することで、ノイジーネイバー効果を排除できます。
Quicknode がブロックチェーン の動作遅延にどう対処するか
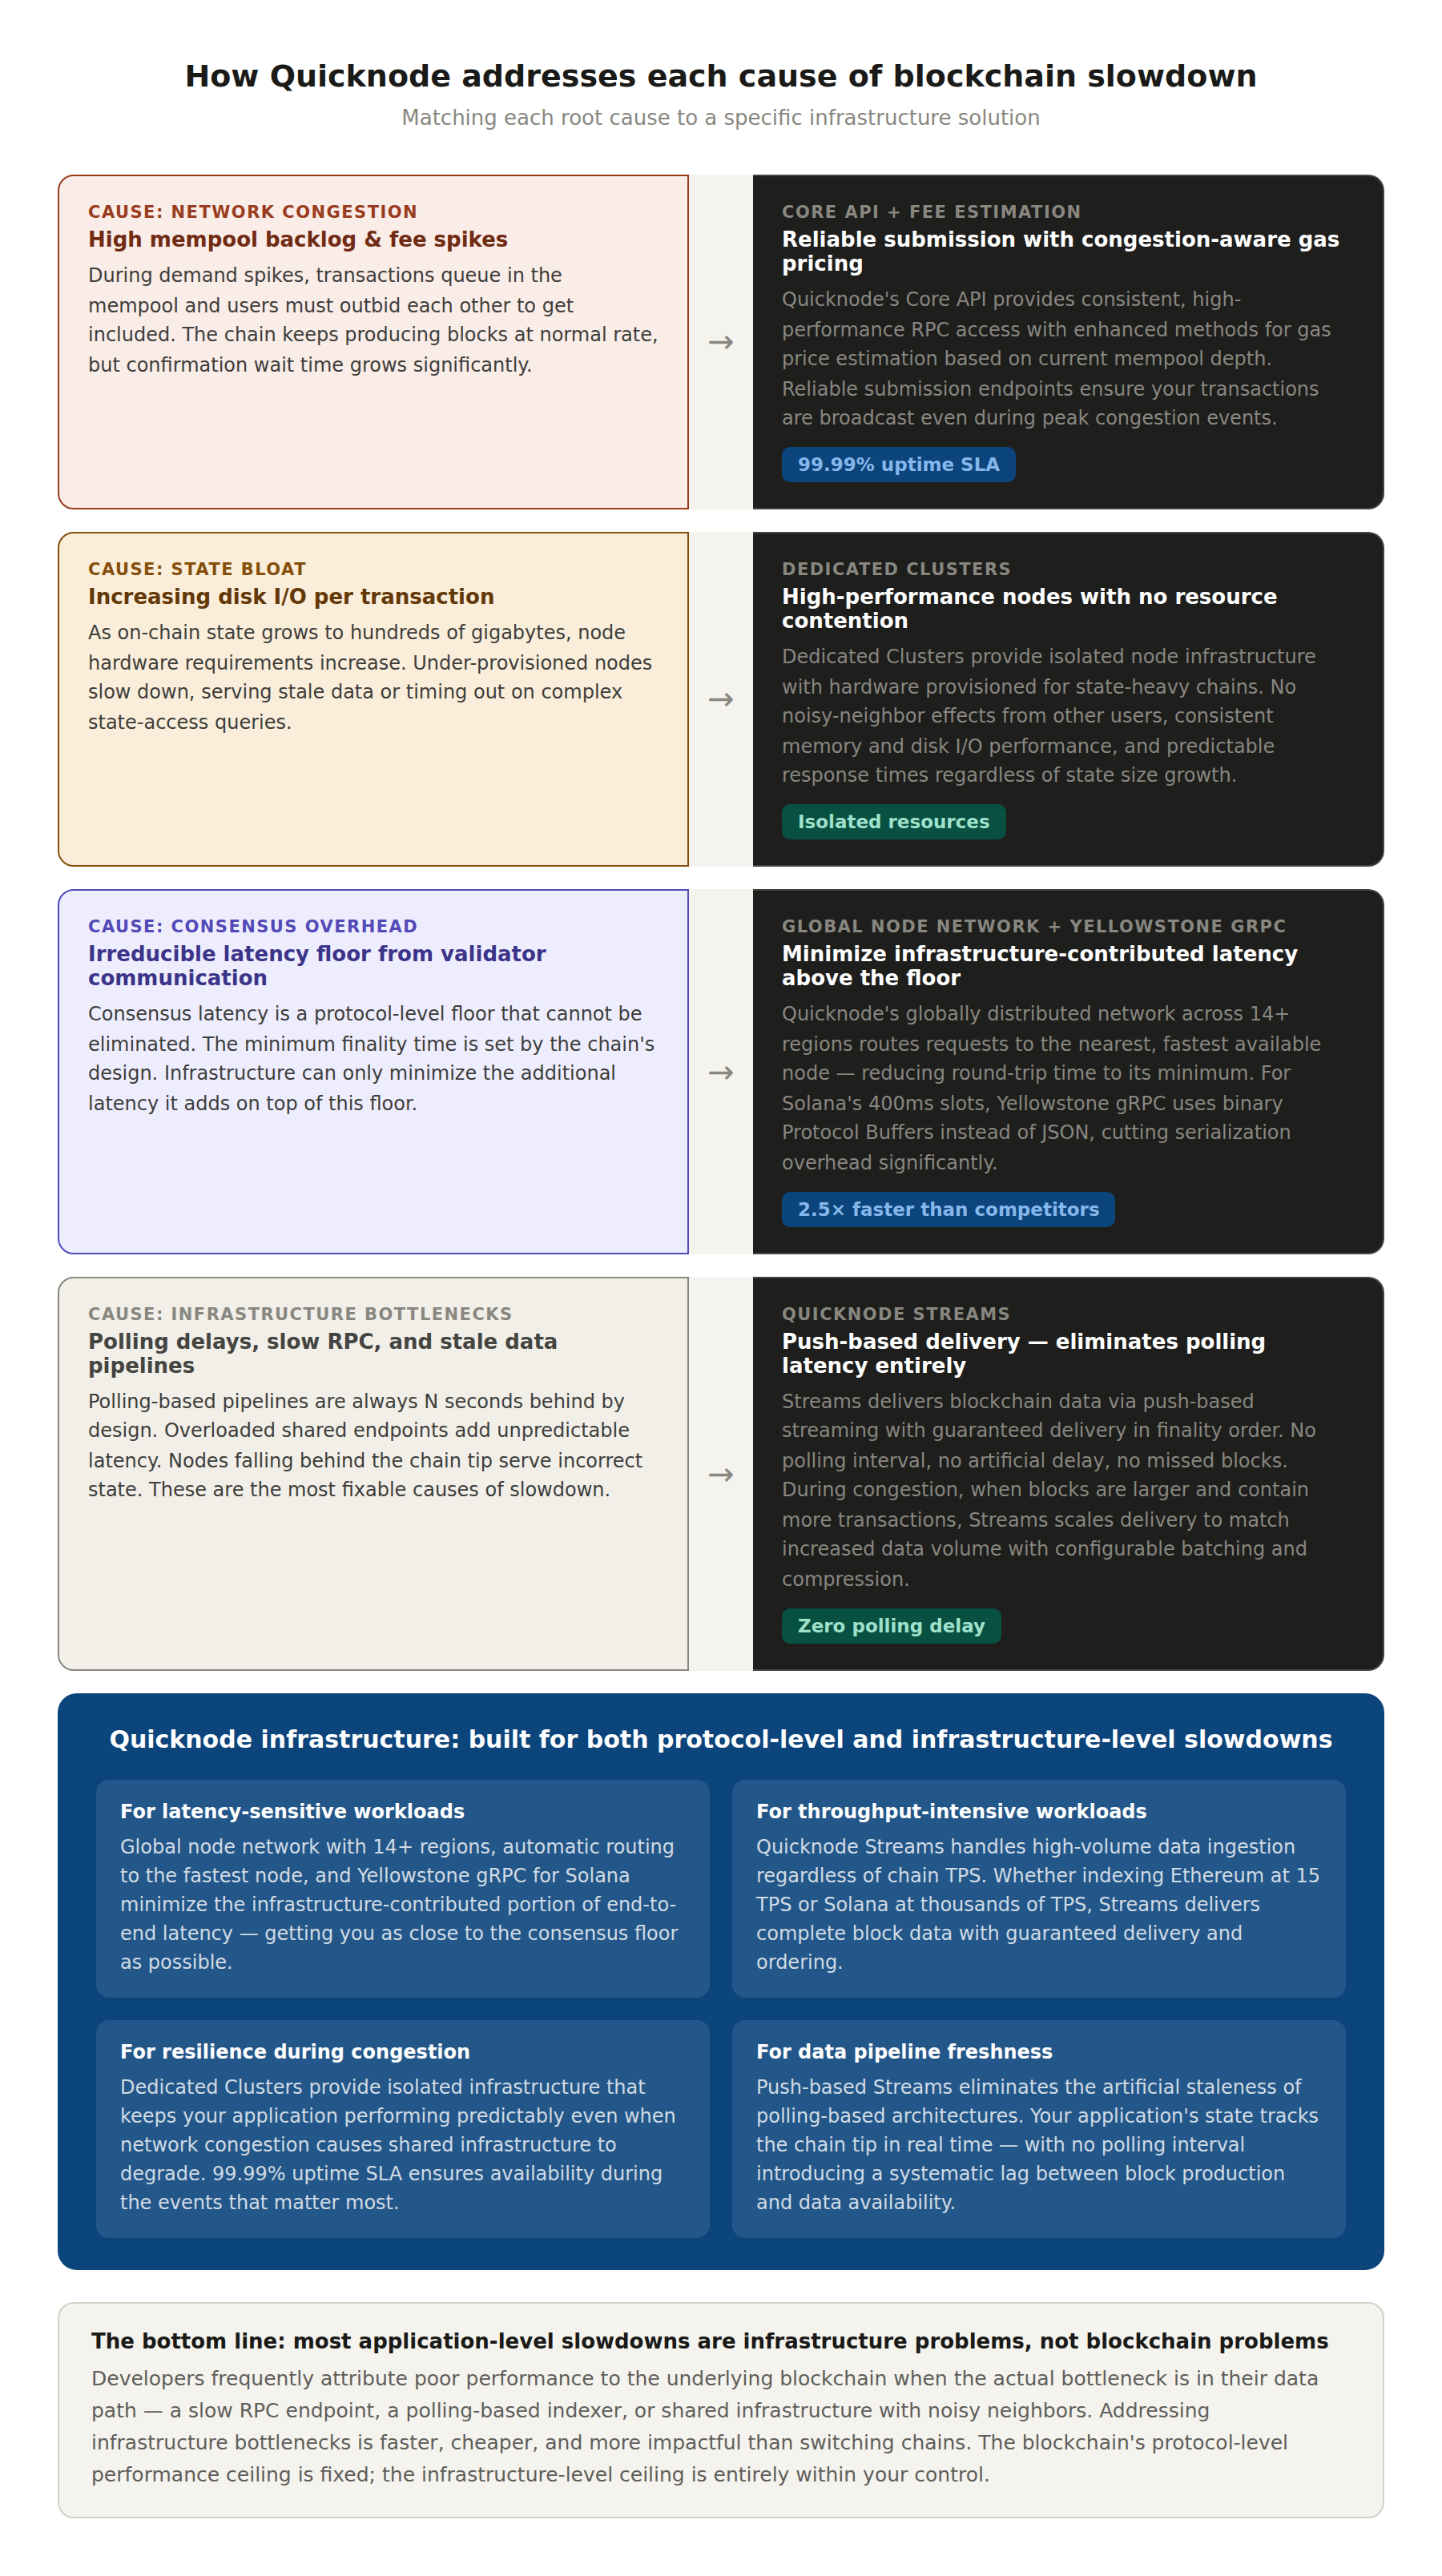
Quicknodeのインフラストラクチャは、アプリケーションのブロックチェーン の動作遅延を引き起こすインフラストラクチャレベルのボトルネックを最小限に抑える、あるいは解消するように設計されています。 Core APIは、14以上のリージョンと5以上のクラウドプロバイダーにまたがるグローバルに分散されたネットワーク上で動作し、リクエストを最も近く、かつ利用可能な最速のノードへ自動的にルーティングします。応答時間は競合他社よりも平均で2.5倍高速であり、99.99%の稼働率を保証するSLAにより、ネットワークの輻輳時でも一貫した可用性を確保します。専用のClusters は、ノイズの多い隣接ノードの影響を排除する分離されたインフラストラクチャを提供し、他のユーザー の動作状態にかかわらず、レイテンシに敏感なアプリケーションに予測可能なパフォーマンスをもたらします。
Quicknode Streams ポーリングによるボトルネックを完全に解消し(by )、ブロックチェーン のデータをプッシュ型ストリーミングで配信し、ファイナリティ順での配信を保証します。ポーリング間隔や人為的な遅延はなく、ブロックを見逃すリスクもありません。ネットワークが混雑し、ブロックのサイズが大きくなり、より多くのトランザクションが含まれる場合、Streams はデータ量の増加に合わせて配信をスケールさせます。設定可能なバッチ処理と圧縮機能により、履歴データのバックフィルやデータ量の多いチェーンにおけるスループットを最適化します。Solana において、Quicknode の Yellowstone gRPC は、JSONの代わりにバイナリ形式のProtocol Buffersを使用することで、1ミリ秒単位の遅延が許されないチェーンにおいてシリアライゼーションのオーバーヘッドを最小限に抑え、利用可能な中で最も低遅延なデータアクセスを提供します。
動作の遅いブロックチェーン と、動作の遅いdappとの違いは何ですか?
これらはユーザー と似たような感覚ですが、原因は異なります。ブロックチェーン の処理が遅いのはプロトコル上の問題です。つまり、輻輳、コンセンサスのタイミング、または状態サイズの大きさなどが、ネットワークによるトランザクションの承認速度を制限しています。一方、dappの処理が遅いのは通常、インフラ上の問題です。チェーン自体に問題はないものの、遠隔地にある、あるいは過負荷状態の エンドポイント が、さらに遅延を加えています。スループットとレイテンシを比較することが、実際にどちらの問題に直面しているかを判断する最も明確な方法です。
アスペクト | プロトコルレベル | インフラストラクチャレベル |
|---|
出典 | コンセンサス、ブロック上限、ステートサイズ | RPC エンドポイント、データパイプライン、ノードの位置 |
誰がそれを管理しているのか | ネットワークとコア開発者 | 開発者の皆さん |
どの程度修正可能か | 難しい。プロトコルのアップグレードが必要だ。 | 簡単です。プロバイダーかパターンを変更するだけです。 |
例 | NFTのミント中にガス代が高騰 | 遅いパブリック エンドポイント 追加の遅延 |
ブロックチェーン のトラフィックが急増する原因は何ですか?
ネットワークの混雑は、一定したものではなく、突発的に発生するものです。トークンのローンチ、NFTのミント、エアドロップの受け取り、市場の暴落、そして取引 のようなバズったイベントなどが、短期間のうちにネットワークに大量のトランザクションを殺到させ、ユーザー 限られたブロックスペースを巡って入札が行われるため、手数料が急騰します。 ブロックチェーン ネットワークの混雑の原因を理解しておけば、by こうした事態に不意を突かれることなく、事前の対策を講じることができます。
レイヤー2やスケーリングは、どのようにして処理の遅延を軽減するのでしょうか?
レイヤー2ネットワークは、ほとんどのトランザクションをベースチェーンから切り離し、バッチ処理で決済を行うため、スループットが劇的に向上し、日常的な取引の手数料が削減されます。レイヤー2のブロックチェーン上でアプリを稼働させることは、基盤となるネットワークのセキュリティを維持しつつ、ベースレイヤーの混雑を回避するための最も効果的な方法の一つです。
開発者 は、実際にはどのような動作の遅延を解消できるのでしょうか?
プロトコルレベルの制限については、ほとんどの場合、ユーザー側でどうすることもできませんが、インフラの速度低下についてはそうではありません。より高速なプロバイダーに移行したり、ユーザー の近くにノードを配置したり、ポーリング方式をプッシュ方式の配信に置き換えたりすることができます。ポーリングからストリーミングに切り替えるだけで、間隔ベースのパイプラインに組み込まれている人為的な遅延を取り除くことができます。
よくある質問
トラフィックの混雑は、ブロックチェーン が処理するトランザクション数が減少していることを意味するのでしょうか?
いいえ。ブロックチェーンは通常通りのペースでブロックを生成し続け、同じ処理能力を維持しています。混雑時に増加するのは、処理待ちのトランザクションのキューです。そのため、個々のトランザクションの確認に時間がかかり、手数料が上昇するのです。
分散化によって、ブロックチェーン の処理速度は低下するのでしょうか?
その可能性はあります。バリデーターの数が増えれば、合意形成に必要な通信量も増え、その結果、ベースラインのレイテンシが上昇します。この速度と分散化の間のトレードオフについては、「分散化とパフォーマンス」で詳しく解説されています。
RPCプロバイダーの処理速度を向上させれば、動作の遅いアプリケーションの問題は解決できるのでしょうか?
多くの場合、そうです。チェーンの状態は良好なのにDappの動作が遅く感じられる場合、ボトルネックとなっているのは通常、 エンドポイントにあります。より近い場所に位置する専用プロバイダーを利用してRPCの遅延を低減することで、ユーザー で感じる遅延の大部分を解消できます。
「ステートの肥大化」は、開発者として解決できる問題なのでしょうか?
直接的にはそうではありません。ステート肥大化は、履歴の有効期限やアカウントレンタルといったアップグレードを通じて管理されるプロトコルレベルの問題です。by に記載されているように、読み取り頻度の高いデータをキャッシュし、コントラクト内での不要なオンチェーン保存を避けることで、その影響を軽減することができます。
ブロックチェーン の動作が遅くなると、なぜ料金が高くなるのですか?
ブロックの容量には限りがあるため、需要が急増すると、ユーザー のようなユーザーは、より早く取引をブロックに組み込んでもらうために、より高い手数料を提示します。手数料の高低は、どの取引が次のブロックに組み込まれるかを決定する市場の調整メカニズムとなっています。
参考資料